目录 · 8 节
1一、问题:同一个价格字段,可以有好几种编法2二、怎么比:先把能变的都固定住3三、结果一:DEER 最稳,但没有通吃4四、结果二:换个输入尺度,冠军就可能换人5五、结果三:精度和成本不同步6六、我认为它的局限7七、推荐团队可以怎么试8评价
CTR 模型里把价格、次数这类数值特征变成向量的方法有十几种,放到同一个公平的比较里看,并没有一种能通吃。以前很难比清楚,因为各家论文的预处理和训练流程都不一样。这篇论文把 18 种做法放进同一套代码,给同样的调参预算,在 3 个数据集、9 种主干模型上逐一比较。综合排名最好的是 DEER(论文表 1 里的“自适应坐标”家族),但换个数据集或主干,领先者就可能换人。把输入从标准化后的数值换回原始尺度,27 组设置里有 11 组冠军变了。精度和推理耗时也不一定同涨同跌。
这篇论文的价值在比较方法本身,而不是某个新编码器。单篇论文里的“我的编码器更好”,可能只是预处理或主干不同带来的,作者用同一接口、同一预算把这些因素固定住,结论才可信。它的局限也清楚:只有 3 个公开数据集,其中两个来自同一来源,离工业规模的特征体系还有距离。
一、问题:同一个价格字段,可以有好几种编法
先说清楚“数值特征编码”是什么。类别特征(用户 ID、商品 ID)直接查表拿向量。数值特征不一样,它有大小和顺序,99 元和 100 元应该得到相近的表示。数值编码器就是一个把单个数字变成固定长度向量的小模块。在这篇论文里,每个数值字段的取值都经过编码器变成一个 16 维向量,主干模型(DNN、DCNv2、DeepFM 等)拿到的是这个向量,而不是原始数字。编码器自带参数,从 Field 的约 0.2k 到 DAES-Tran 的约 60.9k 不等(见后文论文表 3),这些参数和主干一起按点击预估的目标训练。
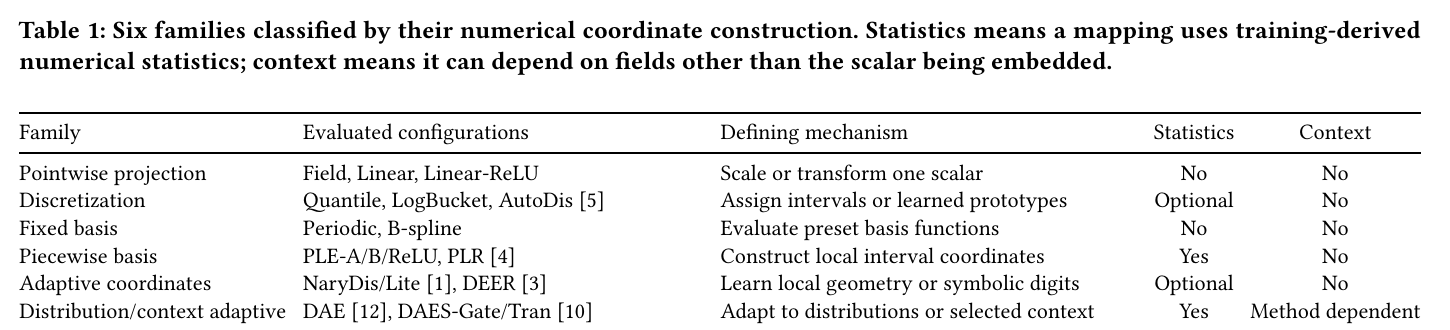
论文按“数字先被变成什么样的中间坐标”把 18 种配置分成 6 个家族,而不是按效果分。下面用一个价格字段把几类做法的区别讲清楚。假设价格按 0–50、50–100、100–200 元分成三个区间(示意):
| 做法 | 99 元和 101 元会得到什么(示意) | 相邻的数是否平滑 |
|---|---|---|
| 逐点投影(Field、Linear) | Field 用同一个字段向量分别乘 99 和 101;Linear 先对数值做一个小的可学习变换 | 平滑,但表达能力有限 |
| 硬分桶(Quantile、LogBucket) | 99 落进第二个桶,101 落进第三个桶,各查一个桶向量 | 不平滑,跨过 100 这条边界时向量突然跳变 |
| 软分配(AutoDis) | 不只选一个桶,而是准备一组可学习的参考向量,一个只读这个数字的小网络给每个参考向量打分,归一化成权重后加权求和(见下文) | 权重随数值渐变,向量也渐变 |
| 分段坐标(PLE) | 每个区间给一个坐标,见下文例子 | 平滑,而且只在数值所在的区间里变化 |
AutoDis 里的参考向量(AutoDis 原文叫 meta-embedding,这篇论文叫 prototype,即原型),每个代表数值的一段典型取值。按 AutoDis 原论文(Guo et al., 2021)的做法,一个数先经过一个只读这个数的小网络,直接给每个参考向量打一个分,参考向量本身不参与打分;这些分数再归一化成加起来为 1 的权重,输出就是这些参考向量的加权和。
分段坐标的“局部坐标”可以用 PLE 原论文(Gorishniy et al., 2022)的定义来看:每个区间对应一个坐标,数值已经超过的区间记 1,还没到的区间记 0,数值所在的区间记它在区间里走了多远。99 元在第二个区间里走了 (99−50)/(100−50)=0.98,坐标是 (1, 0.98, 0);101 元在第三个区间里走了 (101−100)/(200−100)=0.01,坐标是 (1, 1, 0.01)。所以跨过 100 元这条边界,坐标只变了一点,不会像硬分桶那样跳变。区间边界用训练集的统计量定(表 1 里这一家族的 Statistics 是 Yes)。这串坐标再经过一个可学习的线性层,变成 16 维向量。论文测了 PLE-A、PLE-B、PLE-ReLU 三个配置。论文把 PLR(PLE 原论文里的另一种编码)也归入这一家族;在 Gorishniy et al. (2022) 原文里,PLR 是先算周期函数特征,再接线性层和 ReLU。 Hoot 说

- 99 元在第二个区间(50–100)里走了 (99−50)/(100−50)=0.98,第一个区间已走完记 1,第三个区间没到记 0。
- 101 元在第三个区间(100–200)里走了 (101−100)/(200−100)=0.01,前两个区间都记 1。
- 变化有多大:第二位从 0.98 变到 1,只差 0.02;第三位从 0 变到 0.01。硬分桶却直接换了一个桶向量。
示意:区间按 0–50、50–100、100–200 元划分,和正文同一个例子。坐标定义按 PLE 原论文(Gorishniy et al., 2022):已超过的区间记 1,还没到的记 0,所在区间记走了多远。 出处: 正文第一节的价格例子;区间边界和价格都是示意数字。
剩下三个家族里,固定基函数家族(Periodic、B-spline)用一组形状固定的函数(比如正弦、样条)在这个数上取值,得到一串坐标,这串坐标再经过一个可学习的映射变成 16 维向量。
自适应坐标家族里最重要的是 DEER(Cheng, 2022),它是这次的综合第一,下面按这篇基准公开的 DEER 实现讲它怎么编码一个数。DEER 也先把取值范围切成若干个桶,初始边界取训练集上的分位点。不同的是,每个桶占整个取值范围的比例是可学习的。这些比例经过 softmax 归一,总和始终为 1,所以取值范围的两端固定不动,中间的边界会随训练移动。每个边界点还各有一个可学习的 16 维向量。编码一个数时,先找到它落在哪两个相邻边界之间,算出它在这一段里走了多远(0 到 1 之间),再按这个比例把两端边界点的向量加权平均,得到它的 16 维向量。比如一个数正好走到这一段的 30%,结果就是左端向量占 0.7、右端向量占 0.3(示意)。训练时,点击预估的损失直接更新这两个边界点向量。桶的比例则通过这个位置比例拿到梯度,因为挪动边界会改变这个比例。这个家族里还有 NaryDis(Chen et al., 2022)。分布/上下文自适应家族有 DAE(Shen et al., 2023)和 DAES(Liu et al., 2026),下面同样按公开实现说明。DAE 在训练中按批次统计这个字段的 32 个分位点,并不断取平均,评估时用攒下的结果。编码一个数时,先算它到这 32 个分位点各自的距离,交给一个小网络打分,再归一化成权重,对 32 个可学习向量加权求和。DAES 用水库抽样边训练边估计分位点,再像 PLE 那样给出一串局部坐标,只是区间边界换成了这些分位点。它还会把选定的几个类别字段的向量取平均,作为上下文。Gate 配置给每个坐标配一个可学习向量,它和上下文向量做点积,再过 sigmoid,得到一个 0 到 1 的系数,乘到这个坐标上。Tran 配置给一个方阵的每个格子各配一个可学习向量,格子的值就是它和上下文向量的点积。用这个方阵乘坐标串,再过 sigmoid,得到新的坐标。调节后的坐标再和原坐标按配置里设定的固定比例混合,作为权重对一组可学习向量加权求和。这两个家族的方法和其他方法一样,都通过同一个 FuxiCTR 插件接口接入。NaryDis 在本文结果里排名靠后(NaryDis-Lite 平均排第 13.44),推理也最慢,后文只在成本部分提到它。
这一节的分类后面很重要:同一个家族里的方法,效果可能差得很远。同一家族、同样用训练集统计量的方法,对输入尺度的敏感程度也可能完全不同,第四节会讲到。
二、怎么比:先把能变的都固定住
作者在 FuxiCTR 上做了一个统一的插件接口。所有编码器都从这个接口拿各数值字段的取值,输出统一为每个字段一个 16 维向量。这样换编码器时,主干模型一行都不用改。
整个比较分四步:
- 统一预处理。主榜单上,所有编码器都先对数值做同一种 z-score 标准化。统计量只用训练集算,防止偷看验证集和测试集。
- 统一调参预算。每种方法的候选配置事先列好,调参预算也都一样。选配置只看验证集,测试集从不参与。配置选定后就冻结,换主干时不再重新调参。
- 跑完整矩阵。冻结的配置在 3 个数据集、9 个主干、5 个随机种子上全部跑一遍,共 2,430 次训练。用 5 个种子是为了让结论不被一次训练的随机波动左右。
- 做两项附加测试。一是把输入换回原始尺度(比如点击次数就是几千、几万的原值),配置不重新调,看排名会不会变;二是在同一张空闲 GPU 上测训练和推理耗时。
第 4 步的原始尺度测试,问的是一个很实际的问题:如果线上特征管线没有做标准化,主榜单的结论还成立吗?调参预算统一也很关键。如果某个方法在每组设置上单独调参,它天然占便宜,作者因此只给每种方法选一个全局配置。
三、结果一:DEER 最稳,但没有通吃
在标准化后的 27 组“数据集 × 主干”设置里,DEER 的平均名次是 3.41(18 种方法在每组里按 AUC 排名,再对 27 组取平均,越小越好),拿下 14 组第一,第二名 PLE-B 的平均名次是 5.30。统计检验也确认各方法之间确实有差别。所以如果只能选一个默认方案,DEER 是合理的起点。
但细看就会发现它并不通吃。在 Criteo 上,DEER 在 9 个主干里赢了 8 个;到了 AutoML-E,只赢了 1 个。全部 27 组里,有 6 种不同的方法至少拿过一次第一,连最简单的 Field 都赢了 3 组,说明数据集本身对结论的影响很大。
连两两之间的先后都不稳定。在 AutoML-A 上,用 DeepFM 做主干时 DEER 的 AUC 是 0.7103,高于 Periodic 的 0.6982;换成 FiBiNET,DEER 是 0.7063,反而低于 Periodic 的 0.7110。这只是 5 个种子的均值,单看这两组差距不足以说明谁更好。但它提醒我们,只看一个主干上的排行榜,很容易把偶然的领先当成普遍规律。
家族标签也不能代表效果。同属分段基函数的 PLE-B 平均排第 5.30,PLE-ReLU 却排到 12.48。同属自适应坐标,DEER 排 3.41,NaryDis-Lite 排 13.44。选编码器时要看具体方法和具体主干,不能按家族选。
四、结果二:换个输入尺度,冠军就可能换人
把输入换回原始尺度、其他一概不变之后,27 组设置里有 11 组的第一名换了人。换人的设置大多在 AutoML-E 上(7 组),所以尺度的影响要看数据集,不是所有结果一起涨跌。
名次的先后顺序也只保留了一部分。同一组设置里,把两种尺度下 18 种方法的名次做相关,平均只有 0.369,而两种尺度下名次完全一致时这个值是 1。
有的方法对尺度非常敏感。在 AutoML-E 加 AutoInt 这组上,PLE-B 的 AUC 从 0.8411 掉到 0.5000,相当于退化成随机猜;B-spline 则几乎不受影响。原始尺度的 486 个结果里有 57 个 AUC 低于 0.55,其中 AutoML-E 43 个、AutoML-A 14 个、Criteo 一个没有;标准化后一个都没有。
这说明预处理和编码器是绑在一起的,比较编码器时必须写明用了什么预处理。对工程团队,这意味着换特征管线时,编码器的选择也要跟着重新验证。需要注意,这是“不重新调参直接迁移”的测试,在原始尺度上单独调参也许能救回一部分。
五、结果三:精度和成本不同步
论文在同一张 GPU 上测了训练和推理耗时,都换算成 Field 的倍数。DEER 训练只要 Field 的 0.76 倍时间,推理却要 1.20 倍。NaryDis 系列的推理时间超过 Field 的 2 倍。
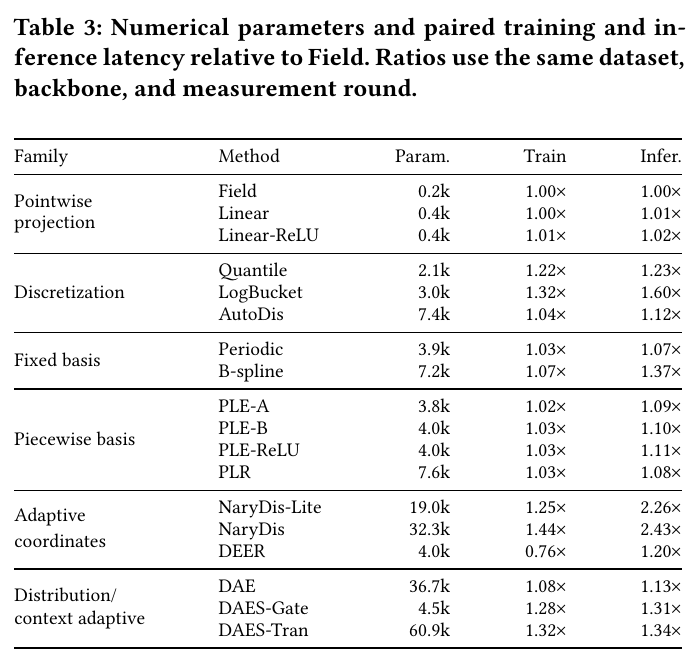
参数量也不能代表耗时。DAE 有 3.67 万个参数,推理只慢 13%;NaryDis-Lite 参数只有 1.9 万,推理却是 2.26 倍。所以评估成本要直接测耗时,不能拿参数量代替。排名第二的 PLE-B 推理只慢 10%,延迟预算紧时值得比较。但它选定的配置换到原始尺度后,在 AutoML-E 的 9 组设置里全部退化到约 0.50,如果线上特征不做标准化,要在原始尺度上单独调参验证后再判断。
六、我认为它的局限
- 数据集少且不独立。 只有 3 个数据集,AutoML-A 和 AutoML-E 来自同一来源,实际上不算两个独立领域。数值字段最多 23 个,和工业模型里成百上千个数值特征差很远。
- 原始尺度没有单独调参。 11 组冠军换人、57 个结果低于 0.55,都是“沿用标准化时的配置”得出的,不能据此说某方法在原始尺度上一定不行。
- 耗时只代表现有实现。 测的是 eager 模式下的 FP32 实现,算子融合或专门优化后,倍数可能改变。
七、推荐团队可以怎么试
- 盘点现有数值特征的预处理方式,确认线上和训练是否一致。
- 把编码器做成可替换模块,输入输出接口固定,主干不动。
- 先用 DEER 和 PLE-B 两个候选,加上现有做法作为基线,在同样的调参预算下离线比较。如果线上特征不做标准化,PLE-B 要在原始尺度上单独调参再比较。
- 同时记录 AUC、训练耗时和推理耗时,按延迟预算挑选。
- 把结果按数据切片看,而不是只看总体 AUC。论文里同一方法在不同数据集上排名差别很大,自己业务里不同场景的数值分布也可能差别很大。
- 如果线上特征不做标准化,单独在原始尺度上再比一次,避免出现 AUC 退化到 0.5 的情况。
评价
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高:数值特征无处不在,编码方式常被随手决定 |
| 方法创新性 | 中:贡献在公平的比较框架和开源插件,不在新方法 |
| 实验证据 | 较强:2,430 次训练加原始尺度测试,但数据集偏少 |
| 工程成本 | 低:插件接口可直接复用 |
| 是否值得尝试 | 值得:至少用它的协议重新比一遍自己的编码器 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
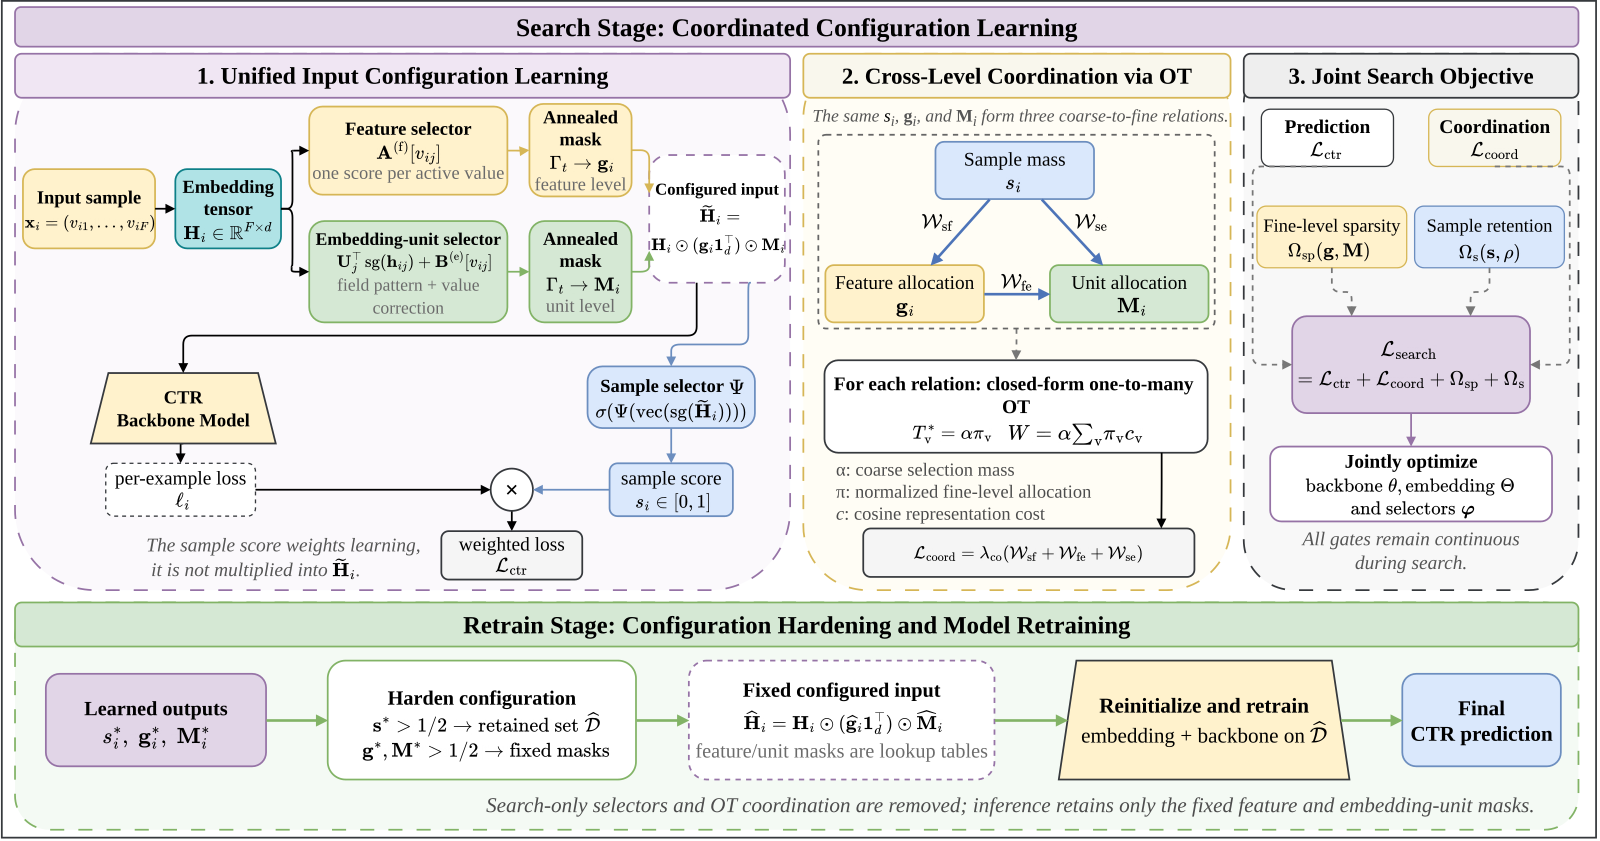 Personalization · 2026-10-28Towards a Unified Framework of Optimal Input-Side Dimensional Configuration for Deep CTR PredictionCTR 模型的输入端有三种常见删减,即丢掉质量差的训练样本、关掉没用的特征、剪掉 embedding 里没用的维度,以往的方法一次只做其中一种。深圳大学等单位的这篇论文指出,三者其实是同一个动作,都是给同一个 embedding 张量乘一个掩码,只是粒度不同。它们还互相牵连,一个特征被整个关掉之后,它内部的维度怎么剪都不再起作用。在 Avazu 上用 DNN(多层全连接网络),单独做任何一种选择只把 AUC 提高约 0.001;把三种放进一个模型一起学,并加惩罚让各层决定互相配合后,AUC 从 0.7893 提到 0.7930。以样本和特征这一层为例,惩罚把每个特征 embedding 到样本平均 embedding 的余弦距离按特征门控加权求和,再乘以样本权重,高权重样本若给离群特征开大门控就会被重罚。
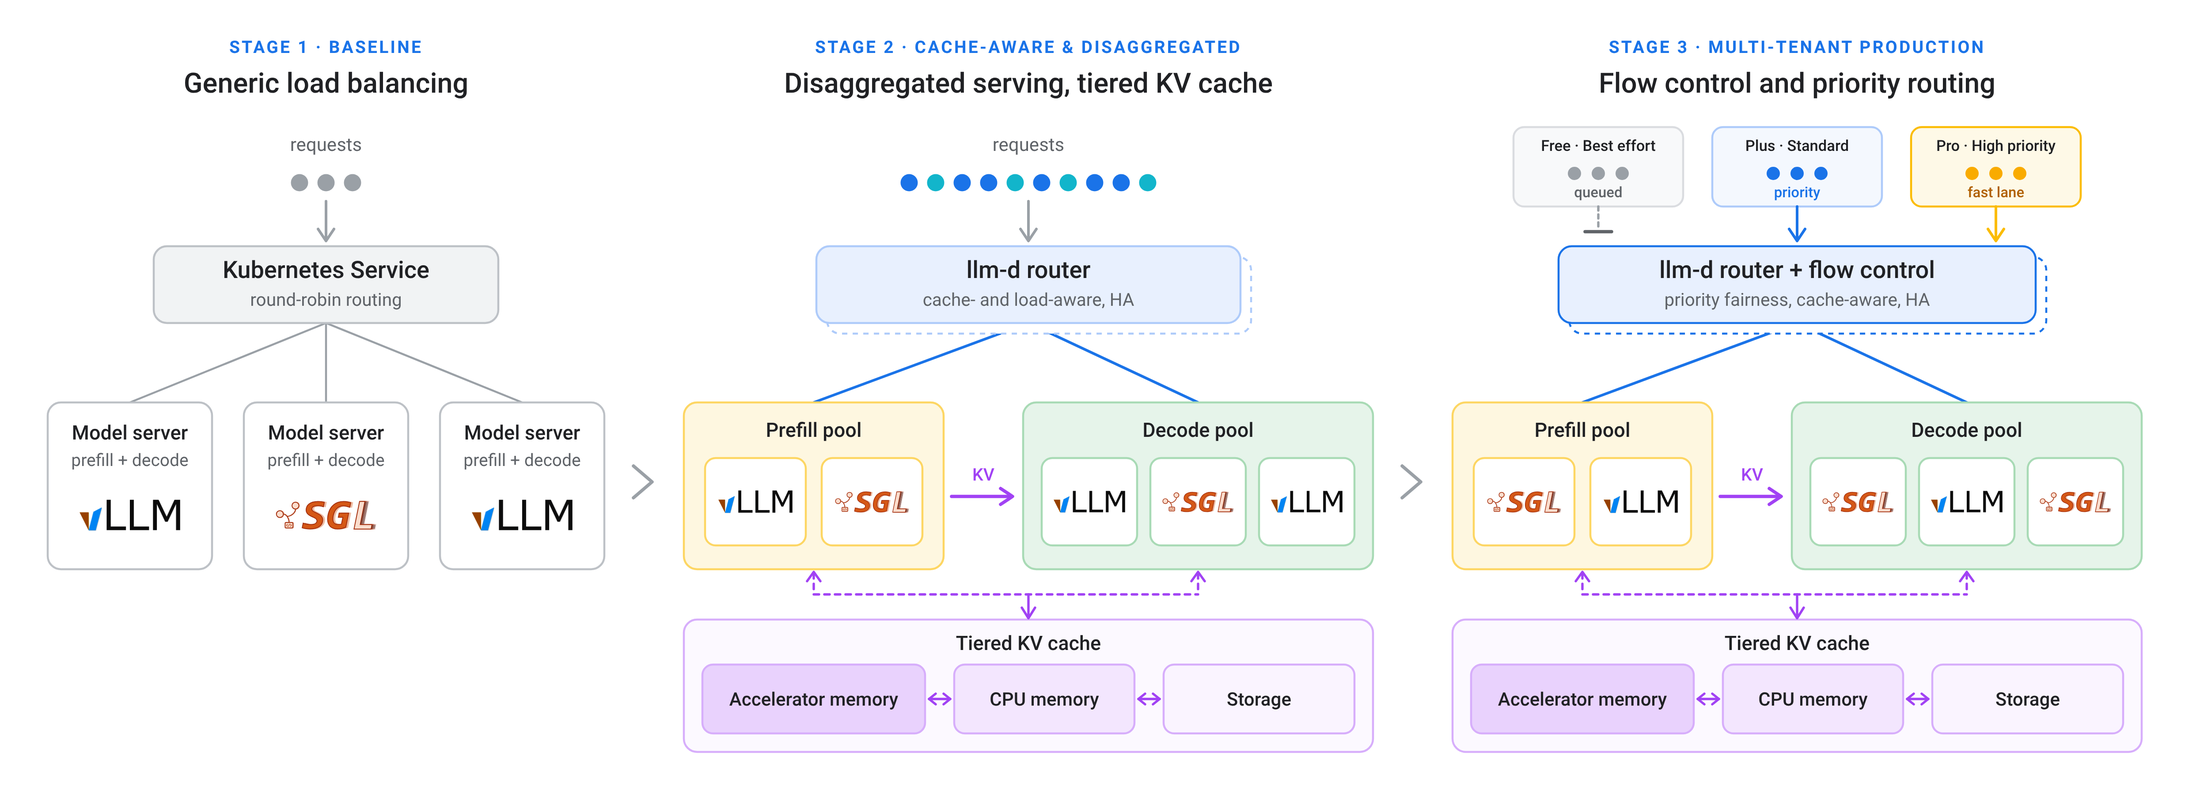 Infra · 2026-10-24llm-d 1.0, an open source stack for distributed inference现在越来越多的推理请求来自多步智能体和强化学习的 rollout,它们会共享很长的前缀、成批突发到达。把这类流量放在普通的轮询负载均衡后面,各个副本会重复计算同样的提示,显存里堆满重复的 KV cache。llm-d 1.0 是一个跑在 Kubernetes 上的开源分布式推理栈,它把一组模型服务器组织成一个统一的服务池。路由器知道每段缓存前缀在哪些副本上,会把同一会话的请求送回去;显存不够时,KV cache 会被挪到主机内存和存储。在 Ironwood TPU 的编码智能体负载上,首 token 延迟中位数下降 85% 以上,总吞吐是普通 Kubernetes Service 的 2.4 倍。这些收益大多不靠更快的算子,靠的是不再重复计算已经算过的前缀。
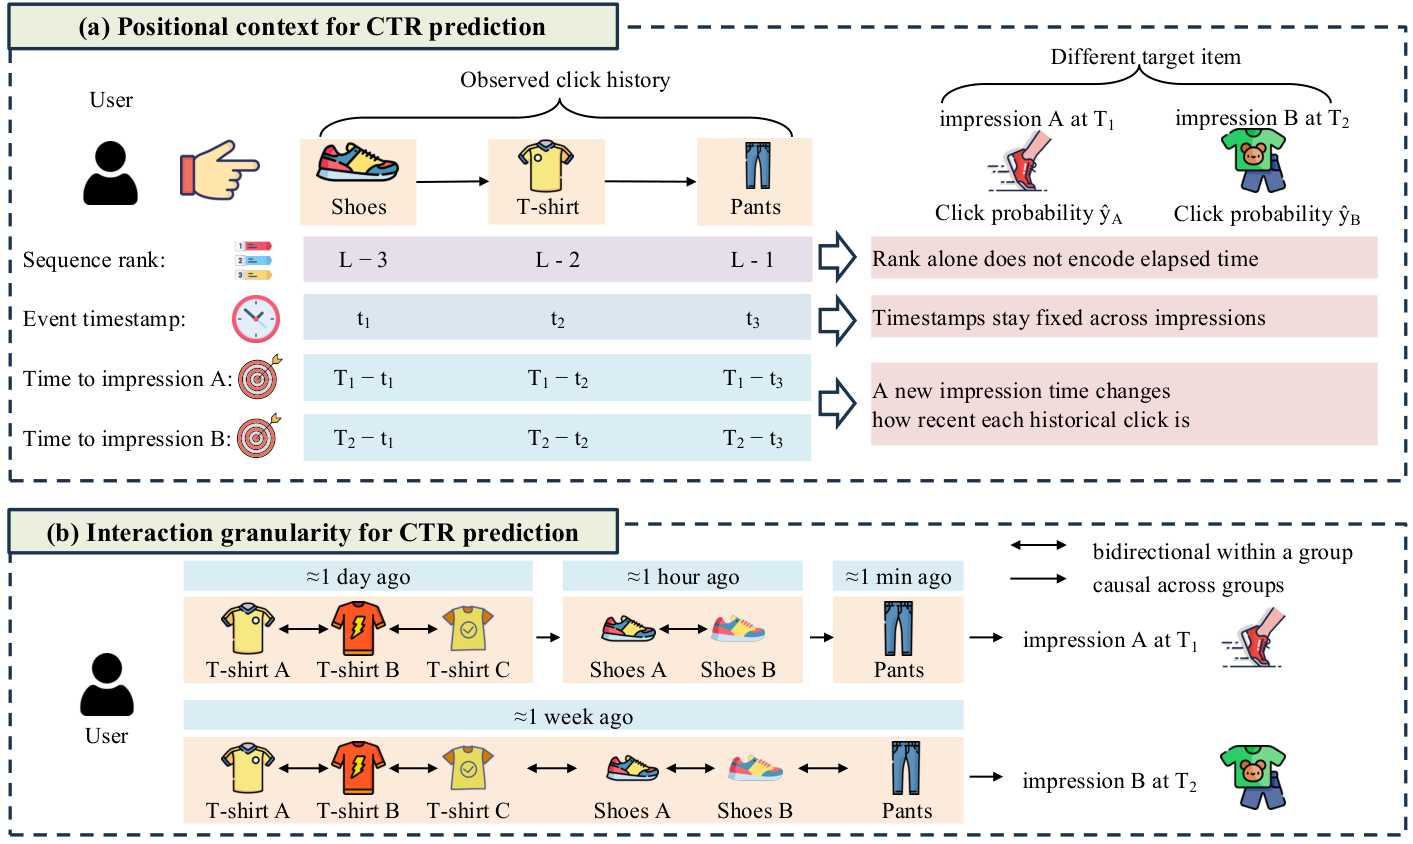 Personalization · 2026-10-29Rethinking Positional Encoding and Interaction Granularity for CTR Prediction在 OneTrans 这类统一 Transformer 的 CTR 模型里,作者在快手 KuaiRand 数据上试了六种位置编码,没有一种比完全不加位置编码更好。武汉大学和腾讯的这篇论文据此提出 TRIP(作者给整套方法起的名字):每个行为同时编码它在序列里排第几,以及它离这次预测过去了多久,并按这个时间距离分组:把离这次预测的秒数取以 2 为底的对数再取整,每组覆盖的时间是前一组的两倍;同组的行为互相可见,不同组之间只能看更早的组。同一段历史,换一个曝光时间,每个行为离现在多远就全变了,语言模型的位置编码没考虑过这点。在四个公开数据集上,AUC 比最强基线平均相对提升 1.47%,在腾讯广告数据集 TAAC(腾讯公开的广告点击数据)上最高提升 4.45%。
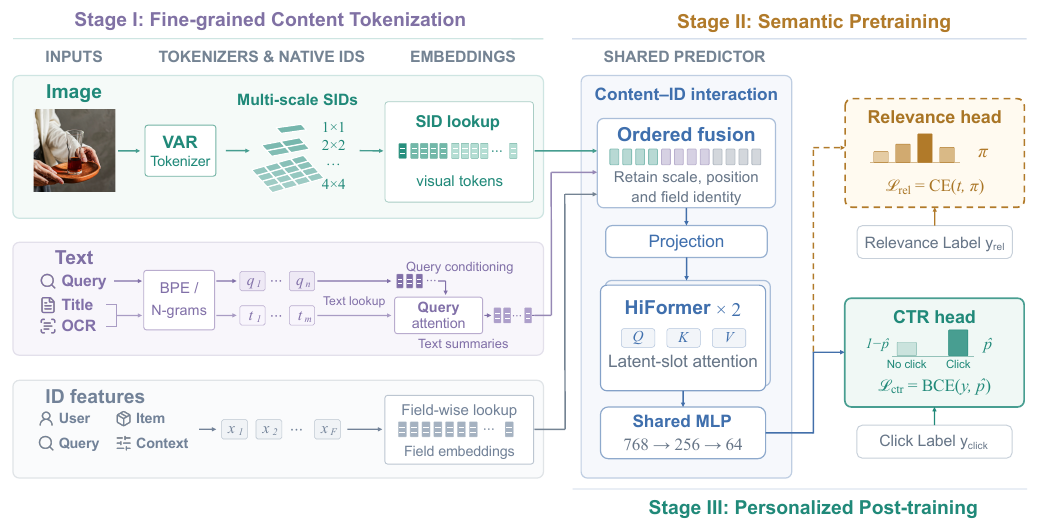 Personalization · 2026-10-23Progressive Learning from Content to Relevance to Personalization for CTR Prediction淘宝搜索的 CTR 模型主要靠商品 ID 记忆历史点击,同一件商品换一张主图,模型几乎分不出差别。FineSID 把商品图用 VAR 图像分词器编成 1×1 到 4×4 四个尺度、共 30 个离散编码,标题和 OCR 文字按字段分词,全部像普通 ID 特征一样查表输入;整个网络先用 Qwen3.5 教师标注的“搜索词—商品”相关性训练,再换上点击预测头,用点击日志微调。离线 AUC 比 HiFormer 基线高 0.25 个百分点,冷门商品上高 0.38 个百分点;淘宝主搜七天 A/B 中 GMV 提升 0.85%。
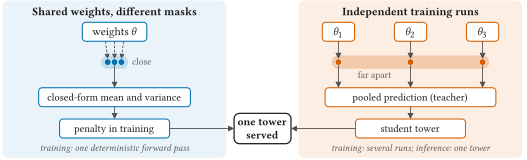 Personalization · 2026-10-21FLMNet: Self-Ensemble Distillation from Masks to Seeds for Single-Tower CTR Prediction点击率模型常靠多次随机预测教自己,本文把这种训练改成可计算的分歧惩罚。门控只读取未遮挡的原始特征,让随机遮挡造成的预测差异可以直接估算。五个基准中,蒸馏版在 Criteo 的 AUC 达到 0.8169。
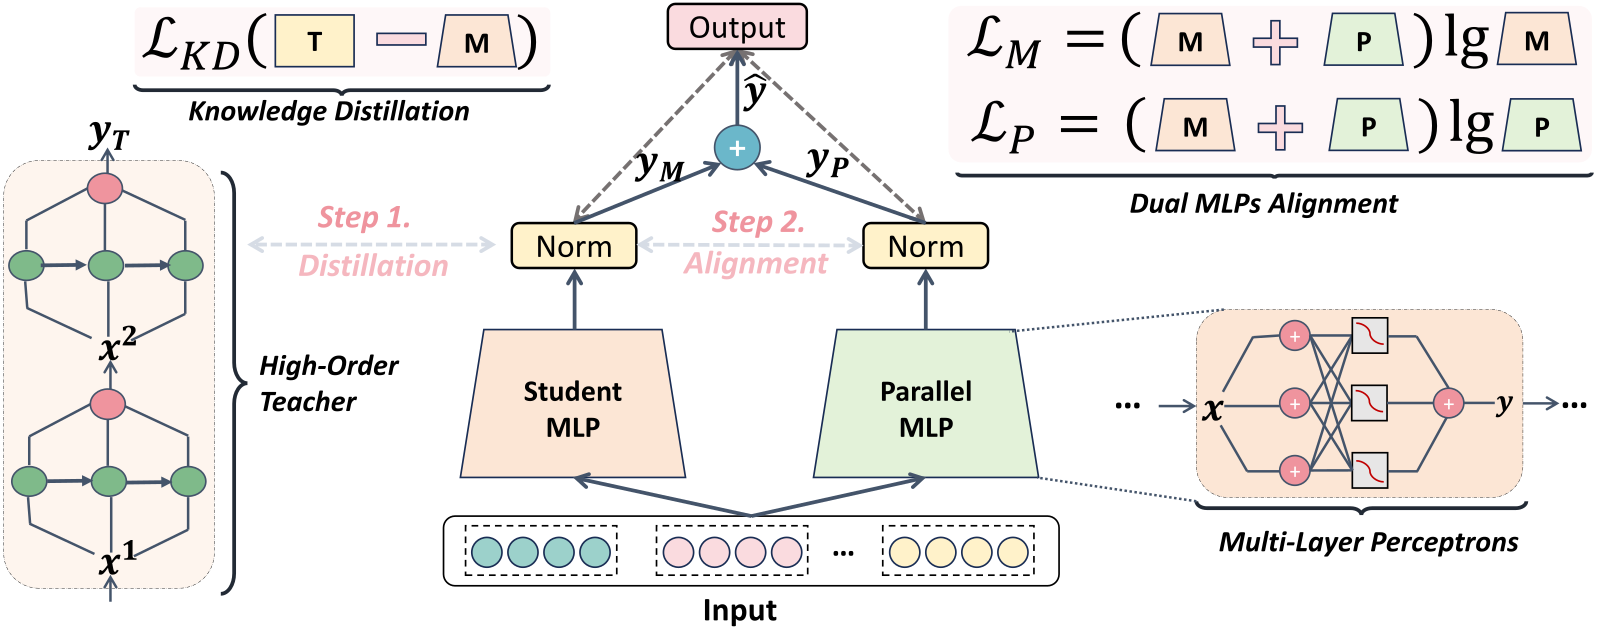 Personalization · 2026-06-05Dual-Stream MLP is All You Need for CTR Prediction主流 CTR 模型都是双流结构:一路用乘法显式构造特征交叉,一路用 MLP 隐式学习,两路输出直接相加。结构越复杂越难调,乘法那一路的输出还会随交叉阶数变大,相加时容易压过 MLP 那一路。DS-MLP 让最终模型只剩两个普通 MLP:一个通过知识蒸馏学会老师模型的显式交叉,另一个从零学习、补上老师漏掉的模式,两路先做批归一化,再各自用点击标签监督。先把老师变成同构的 MLP,再对齐融合。三个公开数据集上 AUC 都排第一,但 Criteo、Avazu 上只领先最强基线 0.0003 和 0.0006,只有 MovieLens 领先 0.0035。
 Personalization · 2026-03-01CADET: Context-Conditioned Ads CTR Prediction With a Decoder-Only TransformerLinkedIn 用一个 decoder-only Transformer 换掉了原来由 DCNv2 和序列编码器组成的广告 CTR 模型。难点不在模型容量,而在广告系统的现实约束:位置要等打完分才知道,线上序列有延迟,几百个候选要在 50 ms 内打完分。CADET 把用户历史按曝光和动作交替排成一条序列,逐条预测点击;位置不当输入,而是每个位置档配一个输出头,拍卖按最终位置取用。位置只决定用哪个头的预测,从不作为当前曝光的输入。线上 CTR 提升 11.04%,CPC 下降 10.9%。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…