目录 · 9 节
1它到底在解决什么问题?2全景:一次查询分几步3为什么要投影、为什么要 E8 格子?4为什么预存列表,而不是只存格子里的成员?5为什么还要走几轮邻居表?6实验:快多少、为什么在十亿条上变小7我认为它的局限8一个检索团队可以怎么试9结论
做 GPU 向量检索的团队值得读。它指出高召回时图检索慢,卡在一轮等一轮的串行链上,而不是算距离本身。作者的做法是把 GPU 显存花在建库时预先算好的近邻列表上:查询一步并行读几百张预存表(每份随机投影一张)就拿到候选,之后只再走固定的几轮。核心思想一句话:图检索每走一步都要等上一步排完序,OctEx 让查询自己算出该读哪张表,一步读完,再沿预存的邻居表补几轮。在 4 张 H100 上、召回 0.95 到 0.995 之间,它在一亿条以内的七个数据集上比 CAGRA(cuVS 里的 GPU 图检索索引,GPU 上的标准基线)快 2.0 到 46.4 倍;到了十亿条的 Deep1B 和 SIFT1B(两个十亿条的公开向量数据集),优势缩小到 1.46 到 2.05 倍。
它到底在解决什么问题?
先看图检索怎么走。CAGRA 这类方法给每条向量连几十个邻居,查询从入口点出发,每一轮展开当前最好的几个点,算它们邻居的距离,排序,再决定下一轮展开谁。下一轮展开谁取决于上一轮的排序结果,所以轮与轮之间只能串行。一轮里的距离可以并行算,但一个线程块要等最慢的那个距离算完、排好序,才能进下一轮。
召回目标越高,候选列表越长,轮数越多。一个示意场景:一个 RAG 服务要从 MS MARCO 的 880 万段文本里给每个问题找最近的 10 段。召回 0.95 时,图检索走较少的轮就够;论文测到,在这份语料上 CAGRA 要把候选列表放大四倍,召回才能从 0.987 升到 0.996。在十亿条的 Deep1B 上也一样:CAGRA 从召回 0.992 的 15.6 万 QPS 掉到 0.995 的 8.7 万 QPS。
| 召回目标(示意) | 图检索需要的串行轮数 | OctEx 需要的串行步数(W 取 1 到 6,按配置定) |
|---|---|---|
| 0.95 | 较少 | W+1 |
| 0.99 | 更多 | W+1,主要靠多选出发点 |
| 0.995 | 再多一截 | W+1,W 最多多加一两轮 |
这条串行链还限制了显存的用处:显存再多也缩短不了它,因为每一轮仍然要等上一轮。论文算过,十亿条向量的 CAGRA 图加上半精度向量,共占去 4 张 H100 合计 372 GiB 显存里的 298 GiB,多出来的显存派不上用场。
IVF 类索引(IVF-PQ、IVF-RaBitQ)没有串行链,一次探查固定几个簇。但它要扫描被探查簇里的每一个压缩向量,作者测到它在 4 张 H100 上的吞吐比 CAGRA 低一到两个数量级。
全景:一次查询分几步
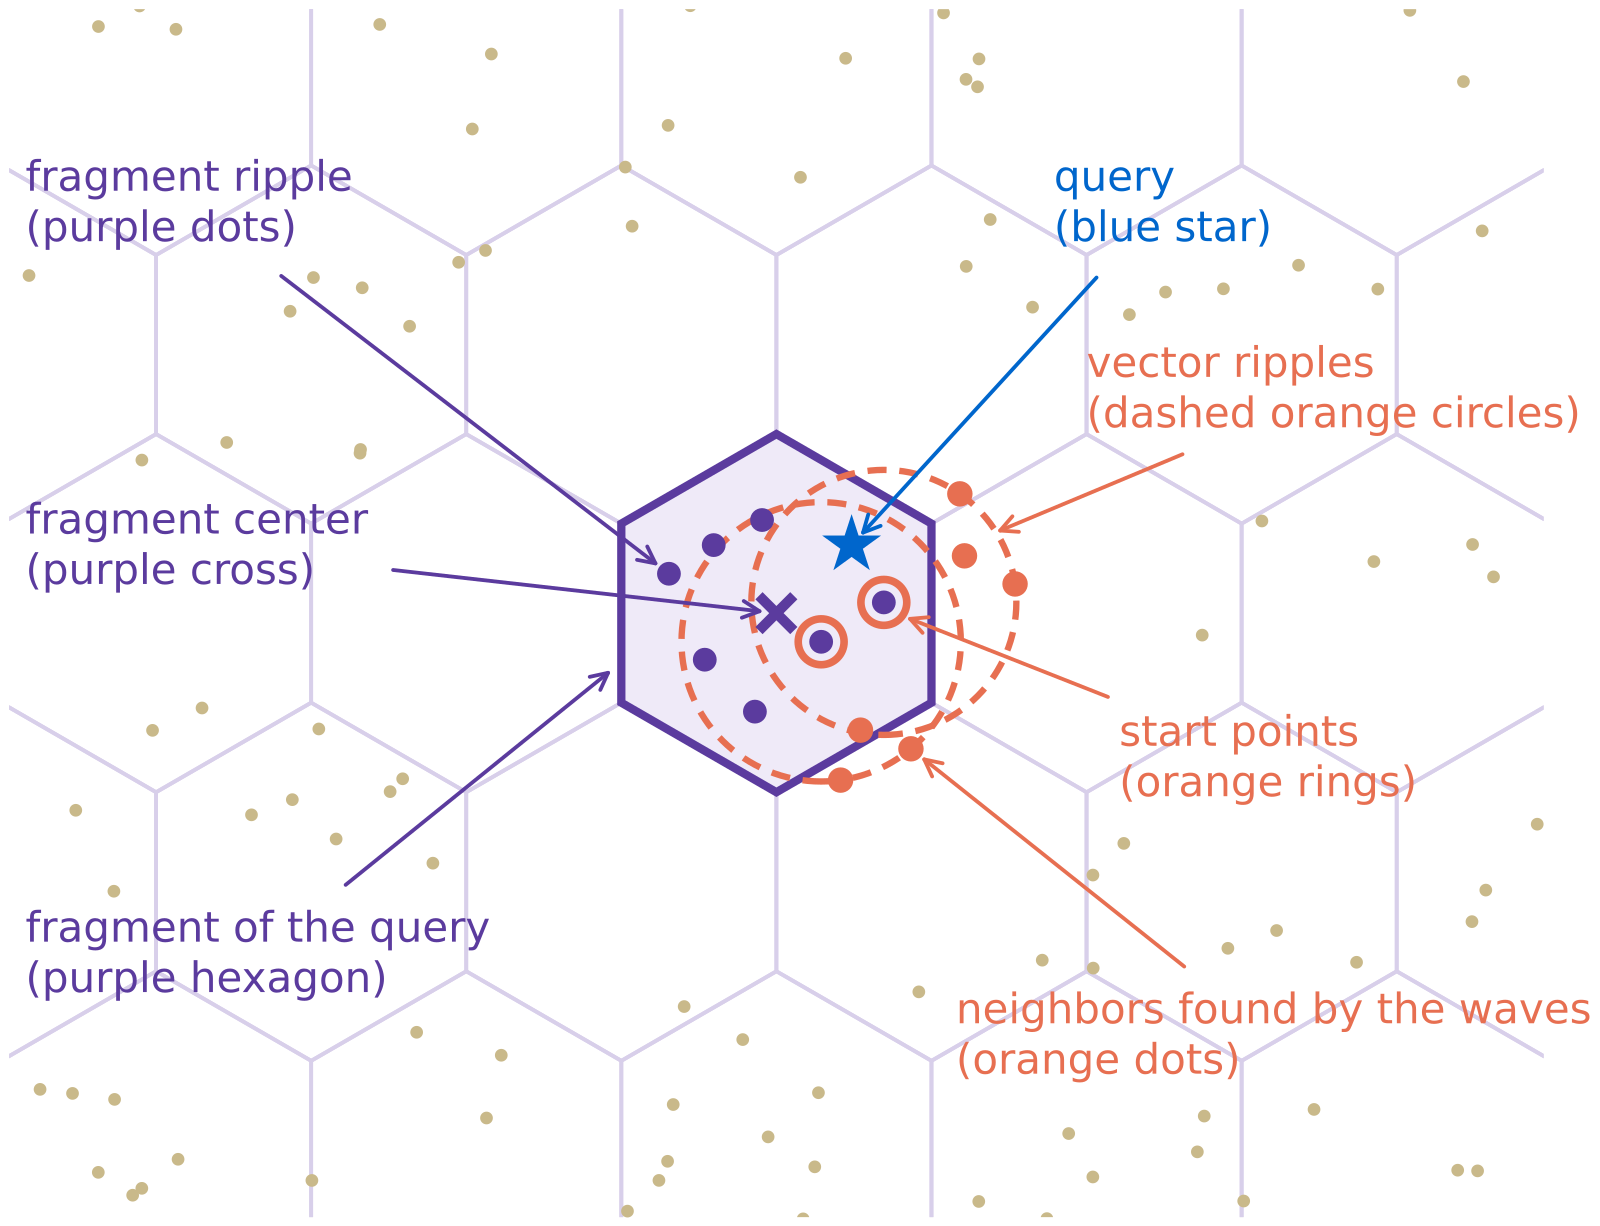
OctEx 的一次查询分五步。前三步合起来是一个并行步,之后每走一轮加一步,总共 W+1 个串行步:
- 把查询一次矩阵乘投到几百份随机投影里,每份算出查询落在哪个格子。
- 每份投影读出这个格子预存的近邻列表前 r 条,合并去重,得到第一批候选。
- 用小指纹给候选粗排:只在前几十个主成分坐标上算查询和候选的近似距离,取最近的 S 个作为“出发点”。
- 走固定 W 轮:每个出发点读自己预存的邻居表。新候选和之前保留的候选合在一起按小指纹排序,只留排在最前面的一批;展开过的候选也留在这批里,只是不再展开。这批里还没展开过的前 S 个成为下一轮的出发点。
- 最后一轮结束后,从这批保留的候选里取小指纹最好的 R 个,读完整的半精度向量算精确距离,返回前 10。十亿条时完整向量放在主机内存,只在最后精排 32 个。
每一步的任务形状都是固定的,所以整批查询可以录成 CUDA graph 在四张卡上一口气跑完,中间不用主机同步。论文把这一点也算作主要贡献:SIFT1M(一百万条 SIFT 图像特征)上从一张卡加到四张卡,OctEx 吞吐涨 3.4 倍,CAGRA 只涨 1.8 倍。
关键分工是:先用建库时的预计算替掉查询时的搜索,再用固定几轮补上第一轮漏掉的近邻。下面拆开讲。
为什么要投影、为什么要 E8 格子?
想“一步读完候选”,查询得只凭自己算出该读哪张表。最直接的做法是把空间切成格子,每个格子存一张“离格子中心最近的向量”列表。问题是原始空间有几百维,查询周围一个小球在找到第 10 个近邻之前,就已经和几乎所有分区相交了,按原始空间切格子行不通。
所以 OctEx 先把向量降到低维,再在低维里切格子。它先求出数据主成分最大的 64 个方向;每份“副本”在这 64 维里随机取一个 32 维的正交投影,加一个随机平移,再除以格子大小 f。查询用的是建库时同一份投影。投影后的 32 维分成 4 块,每块 8 维。每一块取离它最近的 E8 格点。E8 是 8 维里一种规则排列的格点,它的格子是 8 维里已知最接近球形的。这样“落在同一个格子里”的向量大多真的离得近。4 块各自对应的格点合起来,就是这条向量在这份副本里的“格子编号”(论文叫 fragment)。
一份副本里同格子的向量当然会漏掉近邻,因为一个近邻可能恰好被格子边界切开。办法是做几百份副本,每份投影方向和平移都不一样。离查询近的向量多半和查询同格子,也就离格子中心近,所以容易进这个格子的预存列表。一个示意:一个真近邻在某一份副本里进入查询所读列表的概率是 30%,那么 200 份副本里它平均会被读到 60 次,在所有副本里一次都读不到的可能就非常小。
格子大小也有取舍。格子小,近的远的分得清,但大部分查询落进的格子里一条数据都没有;格子大,总有数据,但远近混在一起。OctEx 同时用 5 种格子大小(投影后标准差的 2.0 到 5.0 倍),查询在每份副本里用最细、而且存了列表的那一档。
为什么预存列表,而不是只存格子里的成员?
早期 CPU 上的方法(C2LSH、SuCo 等)在查询时把格子里的成员枚举出来再计数。但每个格子里的向量数差别很大,GPU 要的是形状固定的并行任务。
OctEx 在建库时,对每个至少有 条向量的格子,按投影后的距离存一张离格子中心最近的 l 条向量的列表。十亿条时每个存下的格子至少有 100 个成员,远多于列表的 16 条,所以直接把格子成员按到中心的距离排序取前 l 条;小数据集的格子成员少,改用 cuVS 的 IVF-Flat 索引在整个数据集里搜出离中心最近的向量。查询只读前 r 条。这张预存列表近似于“离查询最近的列表”,前提是查询落在格子中心附近。格子越细,查询离中心最远也偏不了多少,近似就越好;列表越长,覆盖的范围越大,但占的显存也越多。
向量数太少的格子不存,查询就退到下一档更粗的格子。只要查询分布和数据分布相近,冷清的格子本来也很少有查询落进去,这样省显存、损失的召回很小。
为什么还要走几轮邻居表?
第一轮能找到大部分近邻,但总有一些近邻在几乎每份副本里都和查询不同格子。为了补上它们,每条向量还预存一张“邻居表”:它在原始空间里最近的若干条向量。每一轮里,当前最好的 S 个候选并行读自己的邻居表。
这和图检索看起来很像,区别在于轮数。OctEx 的轮数 W 在每套配置里是定好的(论文里取 1 到 6),查询总共只有 W+1 个串行步骤,候选池再大也不会变长。要更高召回时,主要是多选出发点,最多再加一两轮。图检索则要一直走到候选列表收敛,召回越高走得越久。
邻居表里还加了“反向边”:如果向量 v 把 u 列为自己最近的前几位,u 的表里也记上 v。这样即使没有任何向量把 v 列为近邻,只要 v 把 u 列为近邻,u 的表里就有 v,某一轮展开 u 时就能找到 v。 Hoot 说

示意:向量 u、v 和各张表的内容都是编的,只演示反向边的方向。 出处: 论文 §3.4(邻居表由前向近邻和反向条目组成:若 v 把 u 列在自己前 k_s 个前向近邻里,v 就是 u 的反向条目)。
候选可能有几千个,全读完整向量太贵。所以每条向量另存一个小指纹:前几十个主成分坐标各压成 8 位整数,每条 64 到 128 字节。粗排的距离只在这几十个坐标上算,所以是近似的,但只需读一行指纹。粗排和选出发点只用小指纹,完整向量只给少数候选读。这个分工也决定了十亿条时数据放在哪:小指纹和邻居表每轮都要读,必须在显存;完整向量每个查询只在最后读 32 次,可以放主机内存。
实验:快多少、为什么在十亿条上变小
实验在一台 4 张 H100(每张 93 GiB)的服务器上,九个数据集从 100 万到 10 亿条,指标是 recall@10 和 QPS。每个系统都扫自己的参数,取召回-吞吐的帕累托前沿,同一召回目标下比最高吞吐。
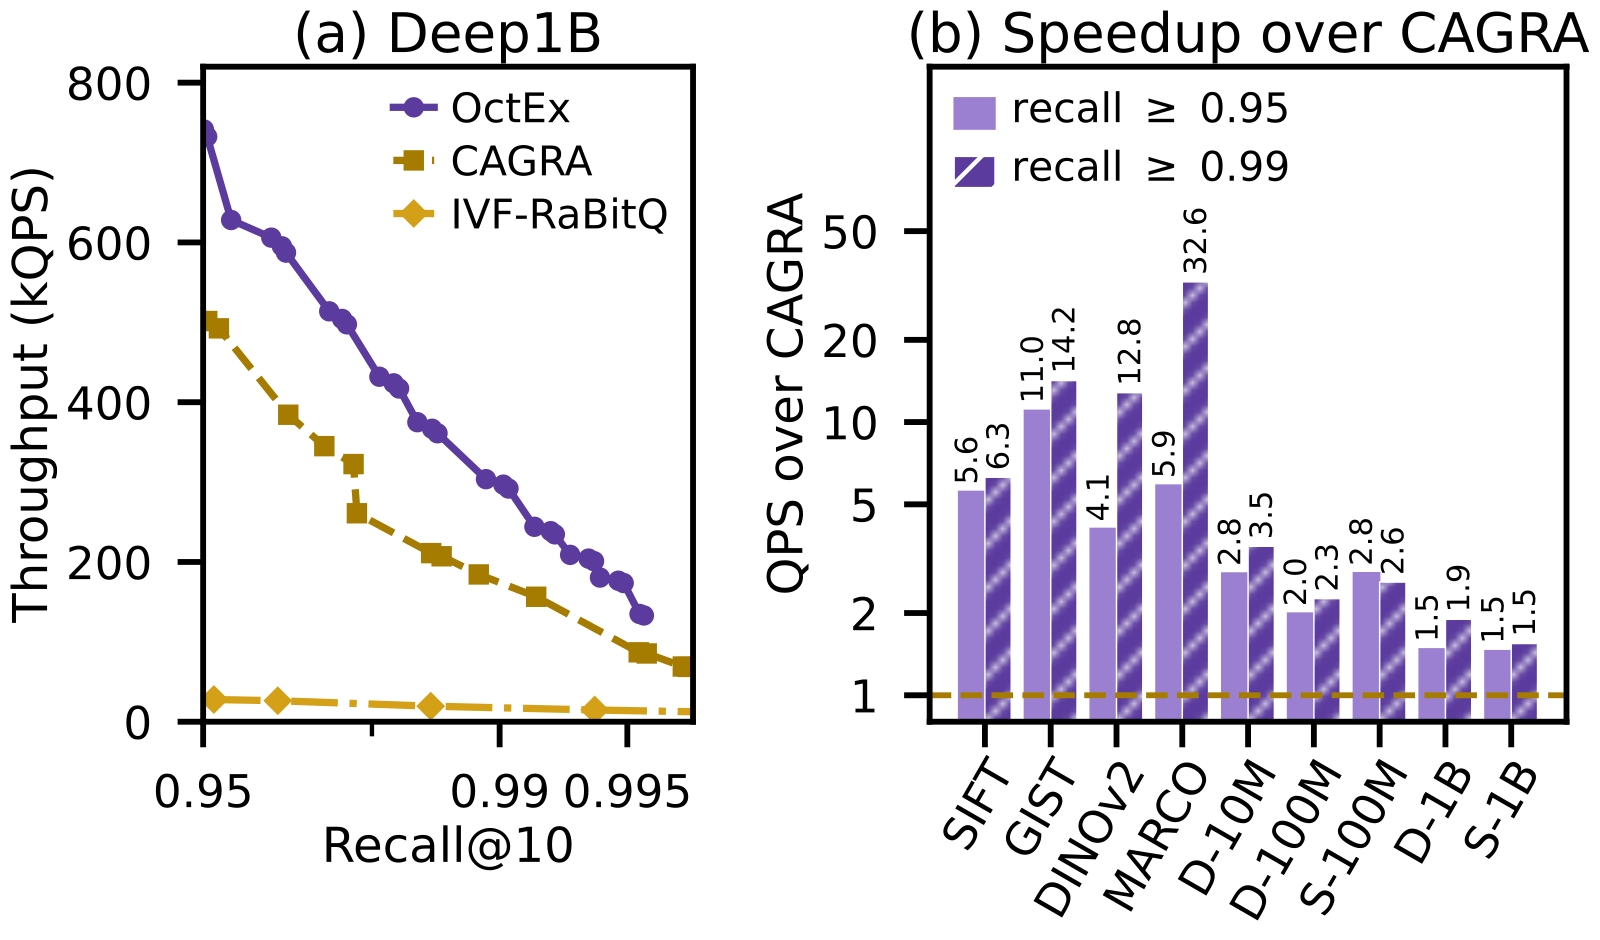
| 数据集 | 召回范围 | 相对 CAGRA 的加速 |
|---|---|---|
| MS MARCO(880 万段文本 embedding) | 0.95 → 0.995 | 5.9× → 46.4× |
| GIST1M(960 维) | 0.95 / 0.99 | 11.0× / 14.2× |
| Deep100M | 0.95–0.995 | 2.0×–2.5× |
| Deep1B | 0.95–0.995 | 1.48×–2.05× |
| SIFT1B | 0.95–0.995 | 1.46×–1.85× |
MS MARCO 上召回越高优势越大,因为 CAGRA 要把候选列表放大四倍才能从 0.987 升到 0.996,而 OctEx 的串行步数不变。这说明它真正赢在高召回这一端。
数据越大,优势越小:Deep100M 只剩 2.0 到 2.5 倍。原因是数据越大,要更多副本和更多轮才能找到同样的近邻。在 Deep1B 上,走邻居表的几轮(含最后精排)占了一个批次 88% 的时间,而一亿条以内只占 12% 到 48%。所以十亿条时,每一轮的成本决定了吞吐。
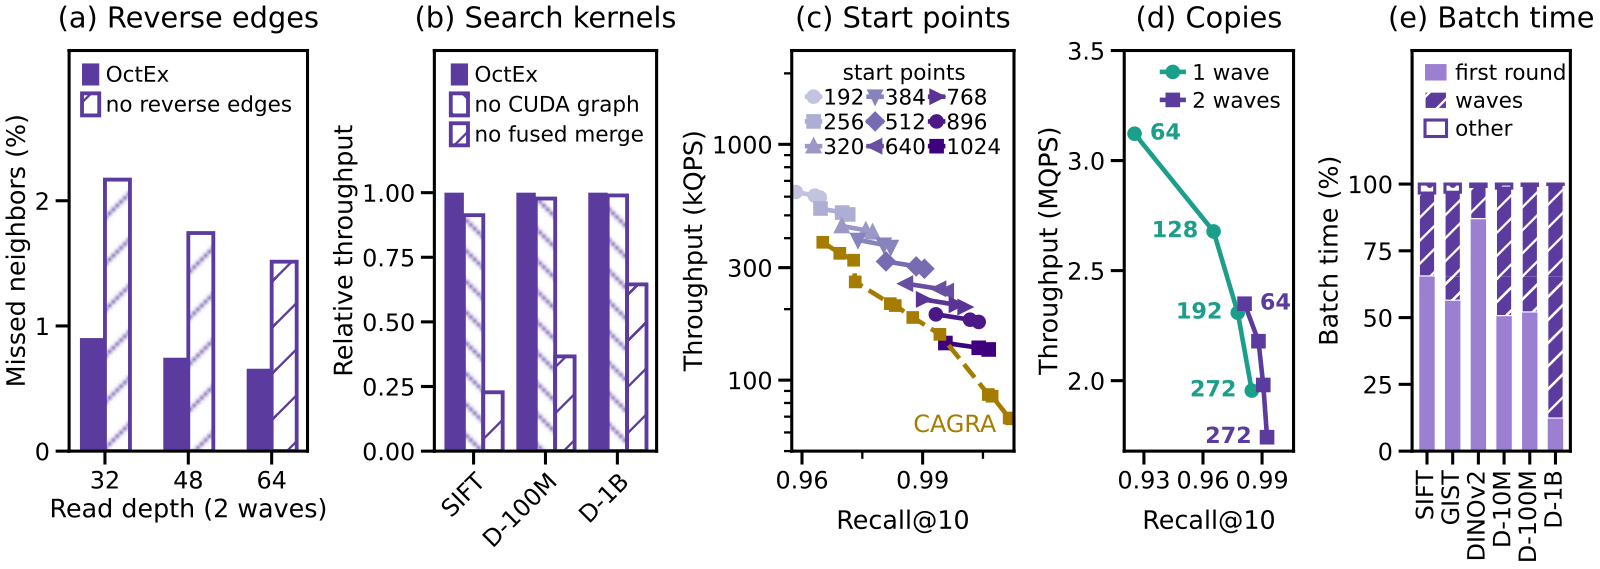
消融说明了几个部件各自的作用。反向边在 Deep100M 上把漏掉的近邻从 2.2% 降到 0.9%,吞吐只降 2.6% 到 3.7%。合并内核在共享内存里选出发点;去掉它,就得在全局内存里给全部候选排序,吞吐在 SIFT1M、Deep100M、Deep1B 上分别只剩 23%、37%、65%。去掉 CUDA graph 的代价小得多,SIFT1M 上 9%,更大的数据集上最多 2.3%。副本和轮数可以互换:Deep100M 上 64 份副本走两轮,比 192 份副本走一轮召回更高、也更快。把邻居表挪到主机内存,吞吐掉 2.6 到 3.9 倍,因为 GPU 从主机内存随机读行比从显存慢两个数量级。这说明邻居表必须留在显存,是十亿规模的硬约束。
建库比 CAGRA 慢约三倍,但仍在一小时内:十亿条在 4 张 H100 上 44 到 47 分钟建完。格子列表靠排序得到,所以只占十几分钟;大头是建邻居表:拿每条向量自己当查询跑 OctEx 的搜索。第一遍只读格子列表,得到初版邻居表;第二遍在初版表上再走两轮,表就更准。两遍共 28 分钟。
我认为它的局限
第一,十亿规模上优势有限。同一个 Deep 数据族,一亿条时快 2.0 到 2.5 倍,十亿条时是 1.48 到 2.05 倍。十倍以上的加速出现在 GIST1M(一百万条 960 维图像特征)、MS MARCO 这类高维数据上。这说明大倍数主要来自高维,在低维的十亿条数据集上没有延续。
第二,它是用显存换速度。Deep1B 的索引在显存里占 316 GiB,另有 179 GiB 半精度向量放主机内存。每张列表留 32 条就和小指纹、邻居表挤不下,所以只留 16 条;即使这样,每张卡也用掉 93 GiB 里的 80.2 GiB。显存紧的团队很难照搬。
第三,它适合建一次、查很多次的库。所有列表都在建库时算好,作者自己也说,它适合建一次、之后经常查询的数据集。
一个检索团队可以怎么试
- 先在自己的一亿条以内的语料上,用论文开源的 Python 包(一行替换 cuVS 或 Faiss 的调用)跑召回 0.99 以上的吞吐,看是否接近论文里的倍数。
- 再看批大小:论文在 Deep1B 上批从 1 万降到 100,相对 CAGRA 的优势从 1.6 倍升到 3.4 倍。在线小批量的服务更该测这一点。
- 最后评估显存账:算清楚自己的数据量下,小指纹和邻居表能不能放进显存。它们放不下、挪到主机内存,吞吐会掉 2.6 到 3.9 倍;只是列表紧张的话,缩短列表或减少副本只损失一点召回。
结论
当召回目标高到图检索要走很长的串行链时,用显存预存列表把串行步数固定住,这是这篇最值得带走的思路。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。RAG 和去重都要高召回,图检索在这一端掉速最快 |
| 方法创新性 | 中高。投影加格子不新,新的是预存列表加固定轮数,让它适合 GPU |
| 实验证据 | 高。九个数据集、六个基线,取中位数吞吐,有消融和十亿规模 |
| 工程成本 | 中高。显存占用大,建库要近一小时,适合不常更新的库 |
| 是否值得尝试 | 值得。高召回、数据在一亿以内、显存富余的服务最该试 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…