
在 LinkedIn 上,一个开始找工作的软件工程师,想点开的往往不是另一位工程师,而是招聘官、招聘经理和 HR。职业社交里“该推荐谁”常常是互补的,而不是相似的。可大多数推荐系统用的是“资料越像,越该推荐”的思路,于是总把同行推给他。LinkedIn 团队的 PAIR(Preference-Aligned Intent Retrieval,按偏好对齐的意图检索)换了一个训练目标:不再学“谁和谁像”,而是从真实日志里学“用户在看到的几个人里点了谁”。离线测试里,PAIR 找回用户真正会点的人的能力,比 LinkedIn 线上正在用的模型高 56%。上线做对比实验后,推荐的点击率提高 7.5%,付费会员的续订率提高 2.1%,页面速度没有变慢。
1. 问题:职业社交的推荐不是找“相似的人”
论文针对的是 Premium Browsemaps,这是 LinkedIn 给付费会员(Premium)看的一个“你可能想认识的人”模块,出现在别人的资料页旁边。这个模块带来的访问会变成“谁看过你的资料”之类的通知,用户会据此判断付费值不值,进而影响续订。
这个模块的推荐分两步走:第一步叫“召回”:先按地区、行业、职级、语言把候选范围缩小,再从里面快速找出大约 100 个可能合适的人。第二步叫“排序”:用一个更细的模型从这 100 人里挑出最终展示的 4 个。召回漏掉的人,排序再好也补不回来,所以召回这一步决定了上限。
召回靠的是“向量”。系统把每个人的资料变成一串数字,资料内容相近的人,这串数字也相近,检索时找离查询用户最近的那些人。这种做法默认“像就是相关”。但职业社交里,求职者想找招聘的人,做商务拓展的想找潜在客户,招聘的人想找技能能补上空缺的候选人,都不是找和自己一样的人。
要在 LinkedIn 的规模上改,还有两个工程上的限制。第一,用户想找什么人会变:这周在积极求职,下个月可能只是一般社交。如果每次用户行为变了,都用大模型把几亿份资料重新算一遍,线上根本跑不动。第二,不同推荐场景对速度、内存和存储的要求不同,最好一个模型就能输出长短不同的向量。
2. 方法一:用“看到了却没点”的人来教模型
训练数据来自 Premium Browsemaps 过去的线上日志。每次推荐展示了几个人,用户点了的那个就是“正例”,也就是模型应该排在前面的人。每个正例配 3 个“负例”,即应该排在后面的人。负例优先从同一次展示里看到了却没点的人里取。不够 3 个时,再从没展示过的活跃付费会员里随机补。
这样选负例是这篇论文的关键。用户在同一屏里看到了 A 和 B、只点了 A,这直接说明了在相近的条件下他更想要谁。随机抽来的陌生人就没有这层信息,模型很容易就能把他们和正例分开,学不到什么。
训练目标很简单:让查询用户的向量离点过的人更近,离那 3 个没点的人更远。作者提到,起初他们只用常规方法微调,效果比现成模型好,但模型还是在学“像不像”:求职的工程师依然被推荐给其他工程师。改用“看到了没点”的负例之后,这个问题才明显改善。
这种做法也有代价,作者自己也说了。模型只能从“曾经被展示过的人”里学偏好,没被老系统展示过的人,它学不到。于是老系统的偏向会被带进新模型。作者认为以后可以有意识地展示一些新候选,用来收集更全面的反馈。
3. 方法二:把“这个人是谁”和“他现在想找谁”分开
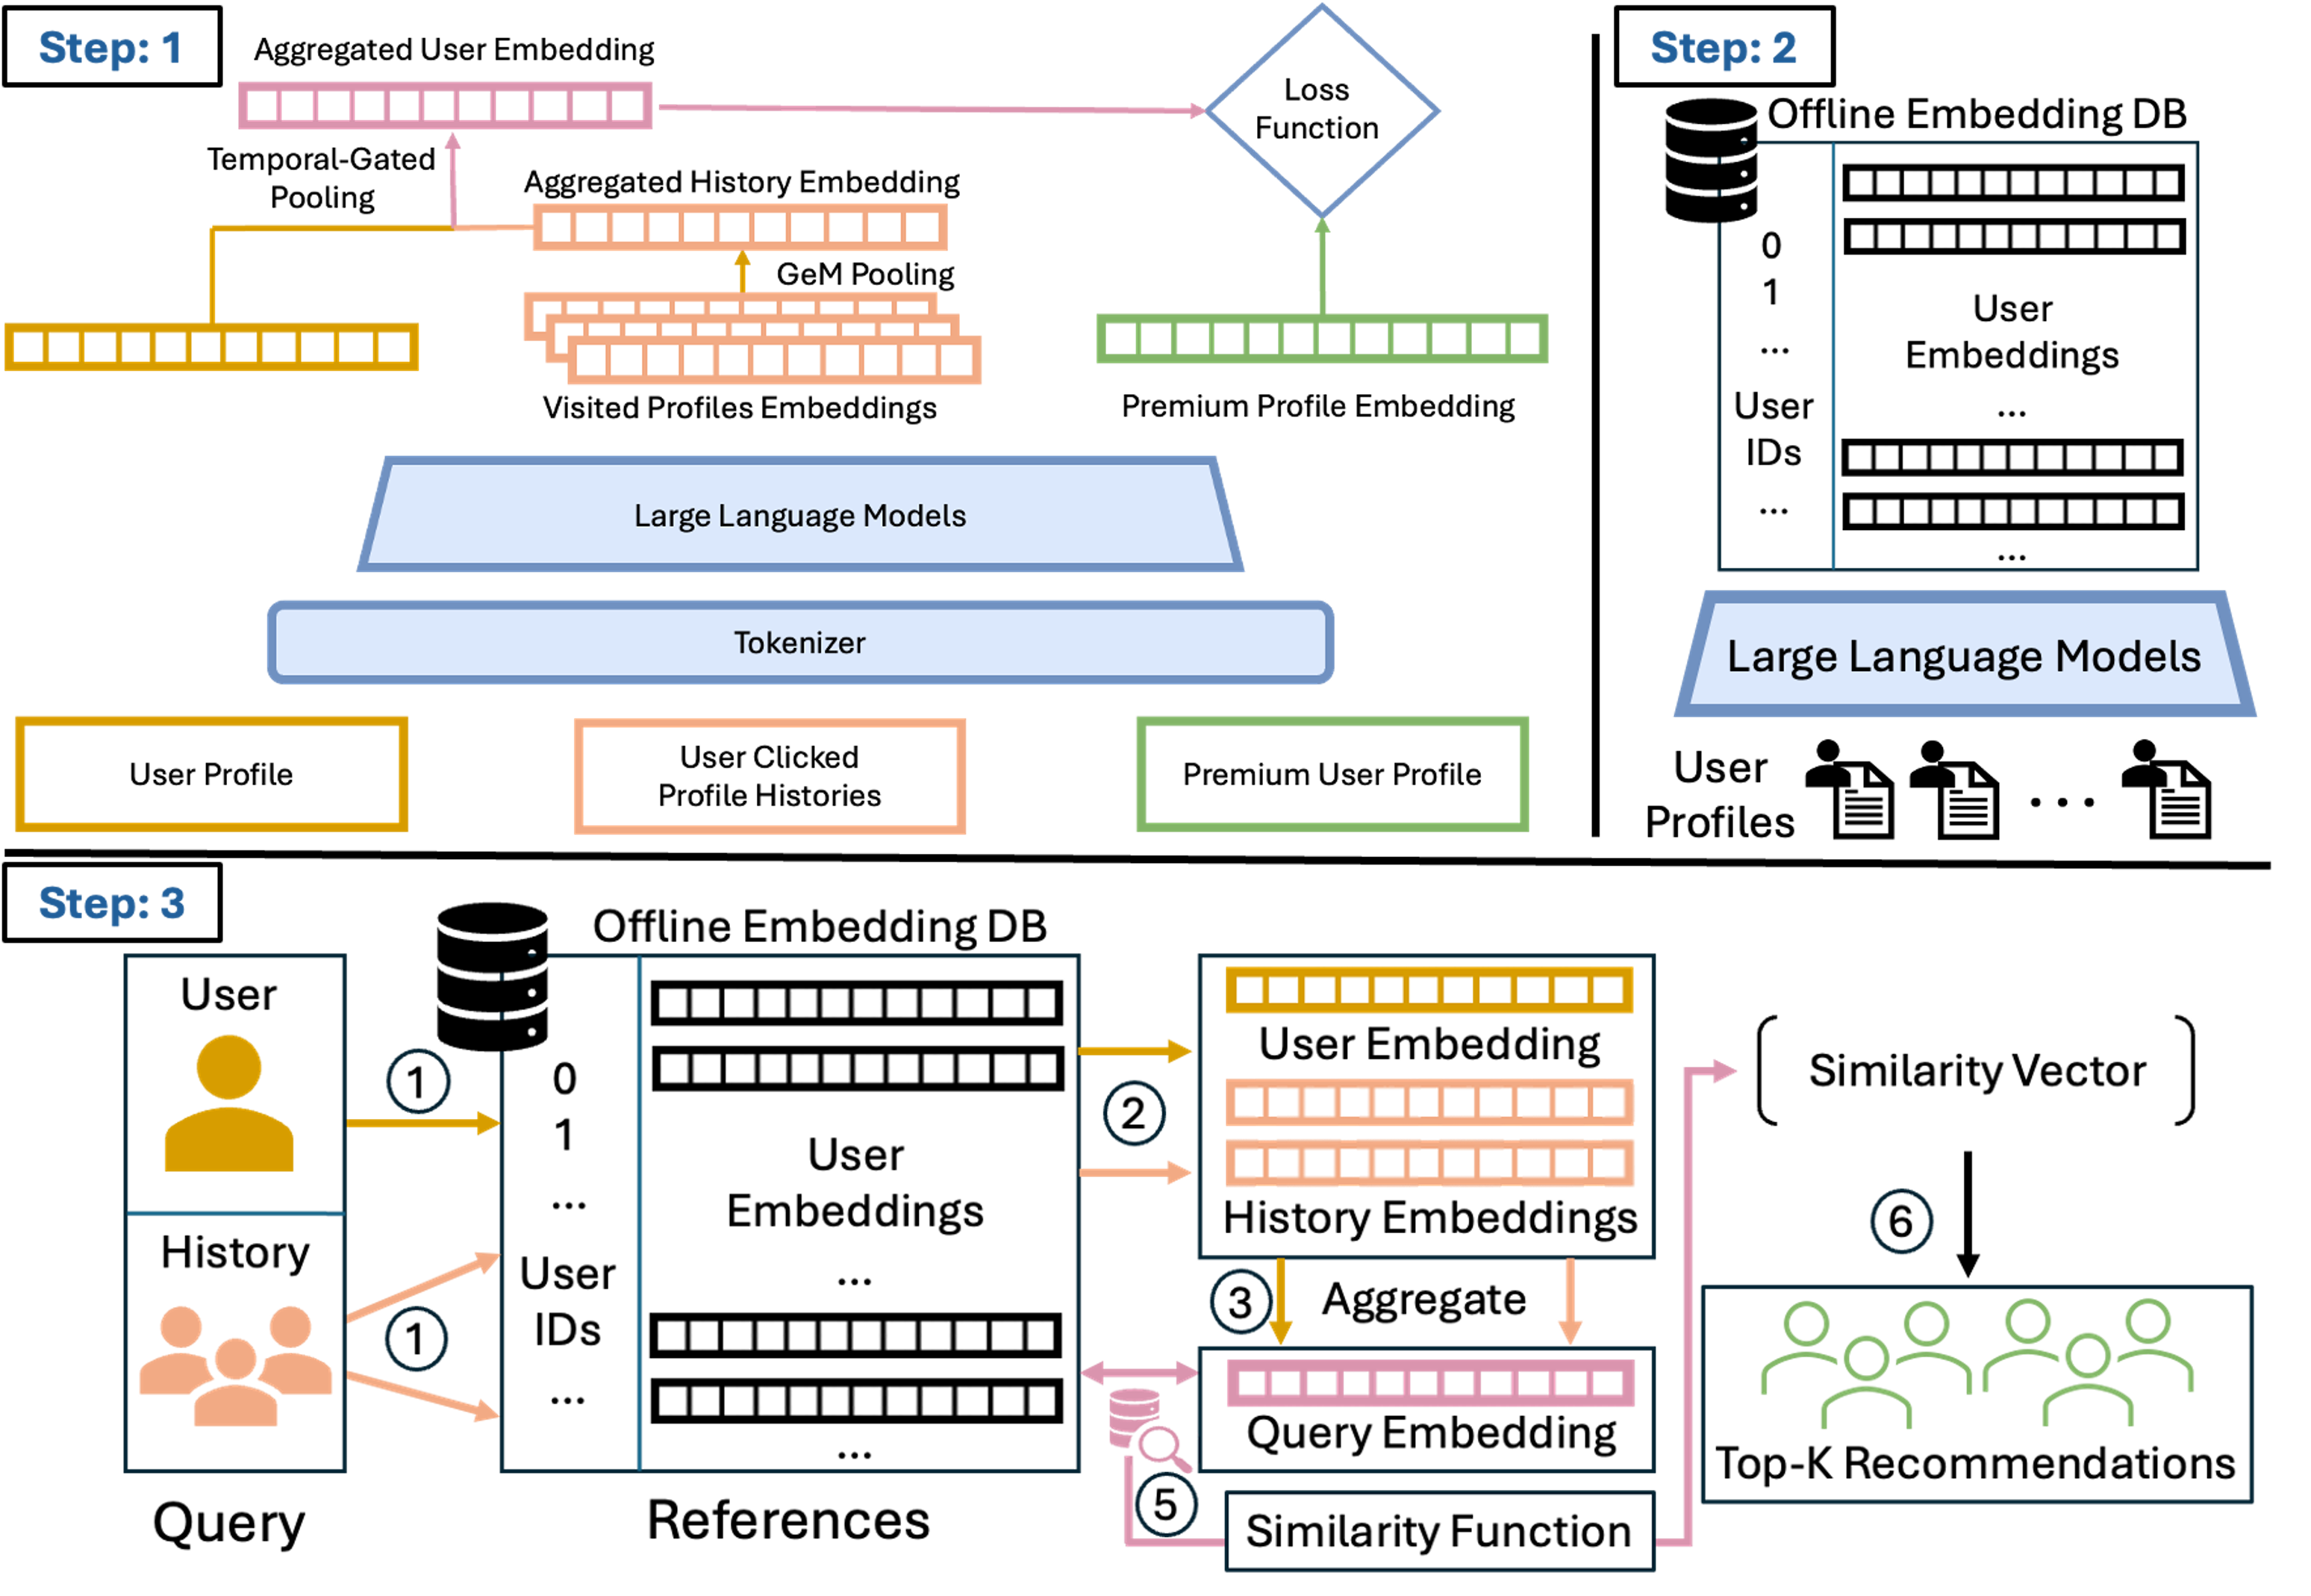
为了既反映用户眼下的意图,又不用反复跑大模型,PAIR 把查询向量拆成两部分。
第一部分代表“这个人是谁”。资料包括头衔、简介、工作经历、教育、技能、证书等,被整理成一段文字,交给一个 6 亿参数的文本向量模型(Qwen3-Embedding-0.6B)变成向量。候选人的资料也用同一个模型来算,每份资料都在后台离线批量算好,不用等用户来了再算。
第二部分代表“他现在想找谁”,由用户最近点过的 10 个人决定。这 10 个人的向量早就离线算好了,只要把它们加权平均。权重怎么分是训练时学出来的,主要看两点:点得越近的分量越大,有些资料天然更能说明意图。作者有意让权重不依赖查询用户本人的资料。这样用户每多点一个人,只需要在普通 CPU 上重算这 10 个向量的加权平均,不用再跑大模型。权重如果随查询用户而变,表达能力会强一点,但线上就得把两部分一起算,服务会复杂很多。
两部分相加之前,各自先缩放到相同长度,否则数值大的一方会压过另一方。历史部分的分量还乘了一个训练出来的系数,由模型自己决定该听多少“最近行为”的。
最后一个设计是让一个模型输出长短不同的向量。训练时同时要求向量的前 200、256、512、1024 个数都能单独拿来用,这就是 Matryoshka 训练。上线时按场景截取需要的长度即可,不必为每个场景另训一个模型。200 这个长度,是为了和线上现用模型的存储占用(171 个数)差不多。
4. 实验怎么做
数据按时间切分:较早的日志用来训练,共 20.9 万条查询,涉及 440 万份不同资料;较晚的用来测试,共 1.18 万条查询,涉及 9.3 万份资料。按时间切分是为了模拟真实情况:模型只能用过去学,再去预测将来。
主要看的指标叫 MAR@k(平均召回率,k 表示看前几名)。做法是给每个查询用户准备一个固定的 100 人候选池,里面混着他真正点过的人和其他人,看模型把这 100 人排完序后,点过的人有多少落进了前 k 名。要注意,论文对 MAR@k 只有这一句定义。候选池正好 100 人时,前 100 名必然包含所有点过的人,简单的“前 100 名召回率”应当是 1,所以 0.45 不会是这个意思;从名字(Mean Average Recall)看,更可能是把 1 到 k 各个截断位置上的召回率再取平均,排得越靠前分越高,但论文没有写明。因此下文的 MAR@k 只适合比较模型之间的高低,不宜换算成“找回了百分之几”。作者还报告了一个更容易的指标:从 1 个点过的、3 个没点的共 4 人里,模型能不能把点过的排第一。随便猜也有 25% 的命中率。这个指标所有改进版本都超过 96%,已经区分不出好坏,所以主要看 MAR@k。
对比的对象有三个:LinkedIn 线上正在用的通用成员向量 Holistic-171(171 个数,为多个业务目标一起训练)、没有经过任何微调的同一个 6 亿参数模型,以及 PAIR 的各种变体。
5. 结果
| 模型 | MAR@25 | MAR@100 |
|---|---|---|
| 线上现用的 Holistic-171 | 0.169 | 0.288 |
| 未微调的 6 亿参数模型 | 0.100 | 0.192 |
| PAIR,不用最近点击 | 0.255 | 0.436 |
| PAIR,最近点击取简单平均 | 0.253 | 0.430 |
| PAIR,最近点击用学出来的权重 | 0.265 | 0.450 |
这张表能看出三点。
第一,大部分提升来自“看到了没点”的训练方式。不加最近点击的 PAIR 已经从 0.288 提到 0.436,提升约 51%。而未微调的同一个模型只有 0.192,比线上现用的还差,说明模型本身大一点没用,关键是学对了目标。
第二,加入最近点击只带来小幅额外提升,从 0.436 到 0.450,相对多了 3.2%。而且加法有讲究:简单平均反而比不加还差一点(0.430)。论文里取最大值、不考虑先后顺序的加权等几种常见做法也都不如不加。作者因此把历史部分的价值主要定位为“上线后能低成本地跟上用户意图”,而不是精度上的大幅提升。
第三,效果不是靠向量更长换来的。同一个模型截成 256 个数时,MAR@100 是 0.432,存储只要完整长度的四分之一,检索时间约为 0.4 倍,仍远高于线上的 0.288。所以 PAIR 的优势不是靠多占存储换来的。截成 200 个数时也有 0.421。作者打算按场景用不同长度:200 个数做初筛,256 个数给对速度敏感的场景,1024 个数用在 Premium Browsemaps 本身。
线上实验是这样做的:一部分用户由 PAIR(1024 个数,带最近点击)做召回,另一部分仍用 Holistic-171。两组后面的排序模型完全相同,所以差别只来自召回这一步。用户按付费等级和活跃度分层后随机分组。
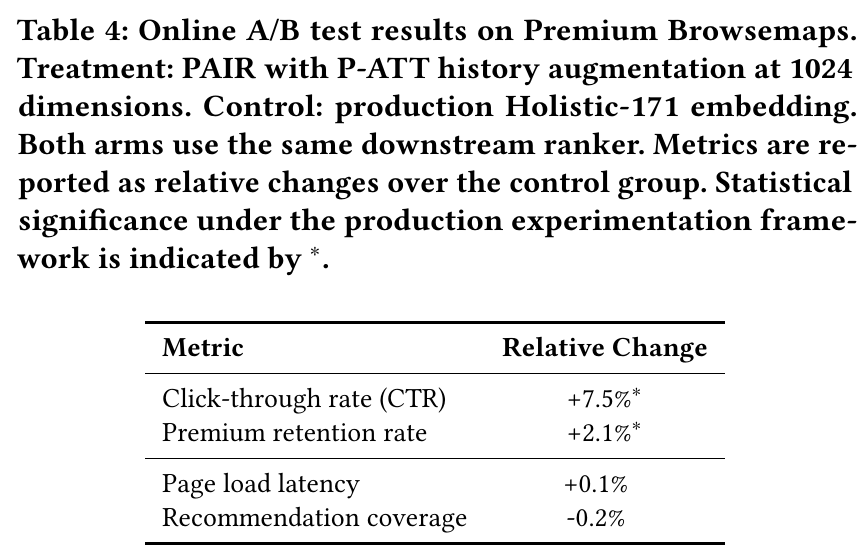
离线提升了 56%,线上点击率只涨了 7.5%,作者解释了这个落差。召回改善的只是“候选名单”,最终用户点不点,还取决于排序、页面展示和用户当时的情境。这在多步骤的推荐系统里是常见现象。
6. 局限与实践意义
作者列出的局限有四点。线上实验固定了后面的排序模型,召回和排序一起调可能还有空间。实验看的主要是短期点击和续订,更长期的订阅效果需要更长时间观察。负例怎么选是工程上的折中,“只用随机的”“只用看到没点的”“用相似度挖出来的”三种做法还没系统比较。测试只在 Premium Browsemaps 上做,能不能用到邮件推荐、职位匹配等其他场景还没验证。再加上前面说的,日志里的负例会把老系统的偏向带进新模型。
对做推荐召回的团队,这篇论文有三条可以直接借鉴的经验。第一,如果你的场景是双边或互补匹配,比如招聘、婚恋、企业间撮合、导师匹配,“像就是相关”这个假设可能不成立。用“看到了却没点”的样本来训练,成本低,论文里大部分提升都来自这一步。第二,想跟上用户的实时意图又不想在线跑大模型,可以学 PAIR 把最近行为做成预先算好的向量的加权平均,更新只要一次很小的计算。但先确认加了最近行为之后效果真的比不加更好,论文里几种常见的平均方法都比不加还差。第三,多个场景共用一个模型时,“套娃”式训练能让一个模型满足不同的存储和速度要求,不必维护好几套模型。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…