
支付平台每天有海量交易,反欺诈、风控、营销都想“读懂”一个用户的消费习惯,但带标签的欺诈样本极少,纯靠监督学习的模型很容易记住偶然的特征组合。微信支付和上海交大等机构的这篇论文把大模型“先在无标签数据上学预测下一个词”的做法搬到交易序列上:先离线用 53 亿笔交易训练一个预测下一笔交易的模型 PANTHER(Pattern AttentioN Transformer with Hybrid User ProfilER),得到每个用户的表示向量;线上再用一个轻量分类器把这些预先算好的向量和当前交易拼在一起打分。线上 10 天全量 A/B 测试中,在风险最高的 0.1% 交易里抓到的欺诈多了 38.6%,在最高的 0.01% 里多了 109.5%;只多花 5 毫秒。
值得读的人:做交易风控、用户序列建模或者想把“预训练 + 轻量下游头”放进低延迟线上系统的团队。它的大部分证据来自微信支付内部数据,公开数据集上的提升幅度小得多,读的时候要把两部分分开看。
它到底在解决什么问题?
论文认为监督式风控模型在十亿级用户上有四个老问题:正样本太少,覆盖不了特征组合;类别特征维数很高,模型容易记住虚假的共现;线上延迟要求把长历史截短;用户向量是静态的,新用户上效果差。
交易序列和文本也不一样。文本有语法,交易没有,但有很强的周期:每天早上的通勤、每周末的娱乐、每季度的固定支出。标准 Transformer 的自注意力逐个看事件,作者认为它不擅长抓这种局部的、重复出现的规律,长序列里还会把这些信号冲淡。
方法
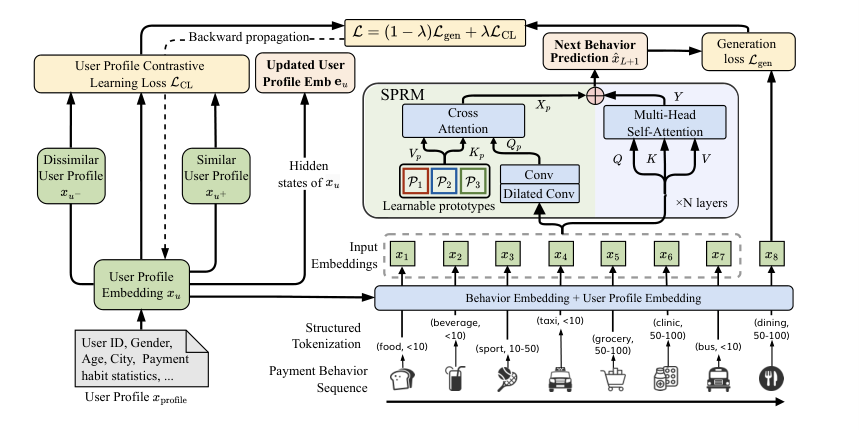
PANTHER 把计算分成离线和线上两段,为的是让重的部分不占线上延迟。离线阶段,给每个用户的交易序列前面加一个画像 token,用“预测下一笔交易”的目标训练,得到用户画像向量和“下一笔大概是什么”的预测分布。线上阶段,分类器的输入有四部分:当前交易的上下文、最近 100 笔交易(用 TextCNN 编码)、离线算好的用户画像向量、以及“这笔交易和模型预测的有多大偏差”。偏差的算法是:取模型给这笔实际交易的预测概率,减去模型对这个用户所有可能交易的预测概率的平均值,再除以标准差;平时消费就很分散的用户标准差大,偏差分数不会因此虚高。
交易先要变成模型能读的词。一笔交易由支付渠道、金额区间、商户类别、商户风险等级几个属性组合成一个 token,例如“信用卡、50 到 100 元、加油、低风险”。全部组合约 200 万种,太稀疏,所以作者只保留出现最多的 6 万种;它们覆盖了 96% 以上的历史交易,说明截断损失很小,其余组合统一记成“未知”。
为了识别重复的消费模式,作者在自注意力旁边并联了一个模块(论文叫 SPRM,Sequence Pattern Recognition Module),输出和自注意力的输出相加。模块里有两层:
- 先用几种间隔不同的卷积扫一遍序列:间隔 1 看相邻几笔交易,间隔 2 跳着看,可以抓到隔几笔重复一次的规律,即使中间夹着偶然的交易也不受影响。
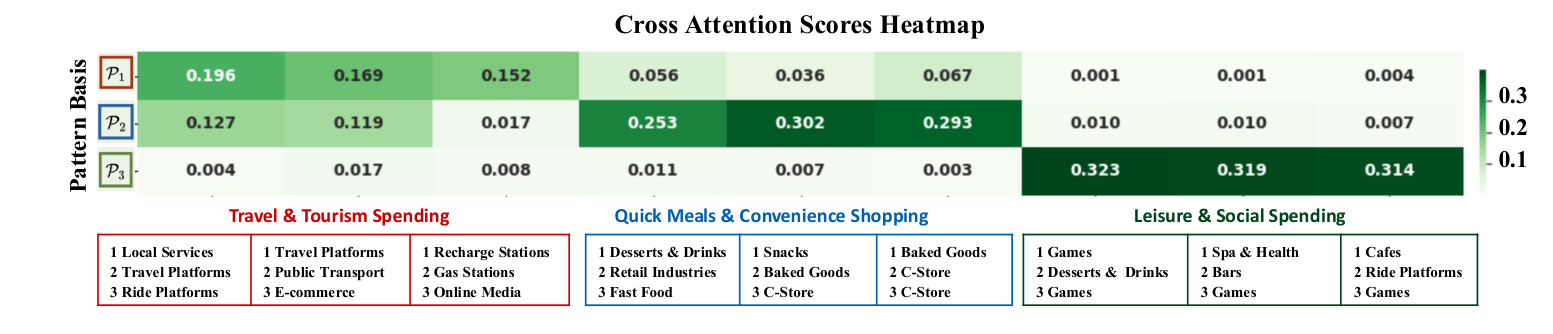
- 再准备 m 个可学习的向量,每个代表一种典型的消费模式,比如“周末休闲”“工作日通勤”,论文把它们叫原型(prototype),实际取 m=64。每一小段交易拿卷积的结果去和这 64 个向量做注意力,看最像哪几种模式,再用这些模式的组合来表示这一段。
因为原型数量固定且远小于序列长度,这一步的计算量随序列长度线性增长,不像自注意力那样按平方增长。
最后是用户画像向量:把用户的静态属性和交易历史合成一个向量。作者试了两种用法:一种是把它当作序列的第一个 token;另一种是把它当作这个用户专属的位置编码,让序列里每一笔交易都带上用户背景。论文只给出这个用法的名字和效果,具体怎么和每笔交易的表示结合,复现时要自己定。在此基础上再用对比学习训练它:年龄相差 2 岁以内、同一地区等属性相近的用户,向量要靠近,其余用户要远离。最终目标是“预测下一笔”和“对比学习”两个损失按比例加权。
实验结果
预训练数据是 3800 万用户 6 个月的 53 亿笔交易。预测下一笔交易时,以普通 Transformer 为基准,各部件的累计效果如下:
| 配置 | HR@1 | 相对 Transformer |
|---|---|---|
| 只加识别模式的模块 | 0.2243 | +14.9% |
| 再加画像向量,放在序列首位 | 0.2301 | +17.9% |
| 画像向量改当位置编码(代替上一行的用法) | 0.2351 | +20.4% |
| 在位置编码用法上再加对比学习 | 0.2452 | +25.6% |
模式识别模块单独贡献最大。论文正文说,画像向量当位置编码比只加模式模块多出 5.5 个百分点,所以这一行是在第一行基础上换了用法,而不是两种用法叠加;当位置编码比放在开头更有用。
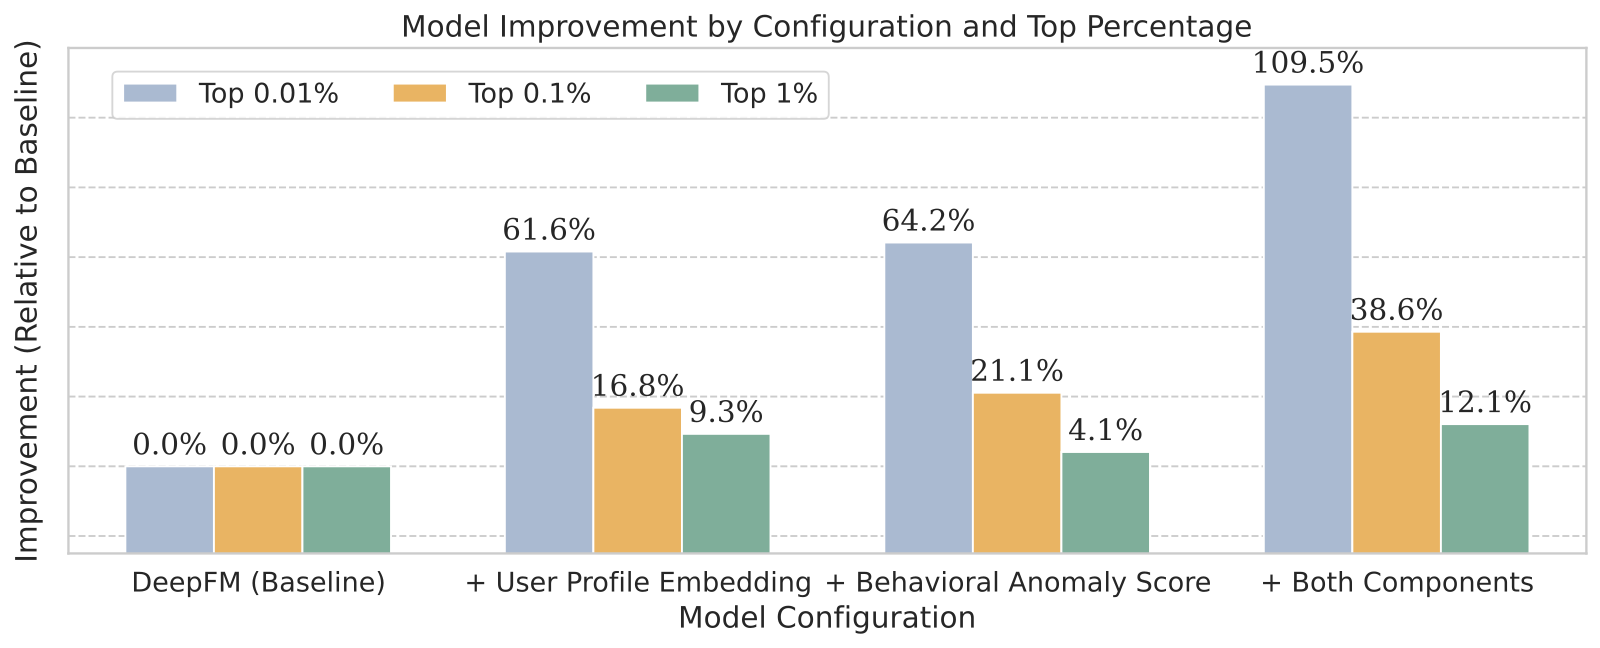
线上反欺诈的对照是使用人工特征加 TextCNN 的 DeepFM。召回提升随阈值放宽而变小:最严的 0.01% 上 +109.5%,0.1% 上 +38.6%,1% 上 +12.1%。所以它的优势集中在最少见、风险最高的那批交易上,这正是靠个性化向量和偏差分数才看得出来的情况。
公开数据集上的提升明显更小。所有方法用同样的层数、学习率和批大小:
| 数据集 | 类型 | PANTHER 相对 Transformer 的 HR@1 |
|---|---|---|
| MBD-mini | 银行交易 | +2.95% |
| CCT(Credit Card Transactions) | 合成信用卡交易 | +15.2% |
| MovieLens-1M | 电影推荐 | +21.8% |
| Yelp | 商户推荐 | +9.17% |
另外两个下游结果:在 Yelp 上把预训练向量加进 DCN 推荐模型,NDCG@5 提升 29.6%;在合成信用卡交易数据 CCT(Credit Card Transactions)上加进 TabBERT-MLP 风控模型,召回提升 19.9%。商户风险评估中,对每个商户,逐个看和它交易过的用户,用上面的方法算出“这个用户来这家商户消费”的偏差分数;把这些分数排序后取一个固定分位点上的值作为商户的风险分(分位点是可调的超参数,复现时按自己的数据选),再从这批分数里算一些统计特征,一起交给 XGBoost 判断,被标为高风险的商户里有 76% 确实有问题,原方法是 50%。
局限
- 最有说服力的数字(25.6%、38.6%、109.5%)都来自内部数据,外部无法复现;公开数据上 MBD-mini 只提升约 3%。
- CCT 是合成数据,2000 个用户,规模和真实支付差距很大。
- 线上对照是 DeepFM,不是同样用了长序列的强模型,提升里有多少来自“用了更长的历史”难以分开。
- 只保留最常见的 6 万种交易组合,罕见组合都被合并成“未知”,而欺诈恰恰常发生在罕见组合上。
怎么借鉴
最容易复制的是两段式:离线训练一个预测下一个行为的序列模型,把用户向量和“下一步预测”存下来;线上只加一个轻量分类器,延迟增加很少。交易这类多属性事件可以先按属性组合成 token,再按频率截断词表。周期明显的行为序列,可以在自注意力旁边并联一个带间隔的卷积加少量可学习模式向量的模块,代价是线性的。“预测分布和实际行为的偏差”本身就是一个很好用的异常特征,可以单独加进现有风控模型试效果。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…