 已录用 EMNLP 2026
目录 · 8 节
1关键概念:MRL 的前缀为什么可能对应类目粗细2发现:分类信号集中在靠前的维度3PEEL 怎么把信号变成分类图4结果5前缀选多长影响有多大6我认为它的局限7一个搜索团队可以怎么试8评价
这篇论文的贡献是一个发现加一个用法。发现是:用 Matryoshka 训练(MRL)得到的现成检索 embedding,分类树信息主要集中在靠前的维度,只取前面一小段维度时,按原顺序截取比打乱后截取、或截取末尾维度,都更能把同一类的概念聚到一起(图 1)。用法是 PEEL(从 embedding 前缀里“剥”出分类树的方法):在冻结的 embedding 上只训一个 9.8 万参数的小投影,学会从两个概念的向量判断谁是上位,再从一份概念词表拼成分类图。按节点及其邻居的相似度比较整张图和标准分类图(Graph F1),它在 Wikipedia 和 arXiv 两个基准上分别达到 0.885 和 0.931(表 2)。我认为这个发现对做检索和内容理解的团队有实际意义:手里现成的 MRL embedding 里可能已经带着能读出来的类目结构。但 PEEL 的成绩要放在两个前提下看:它拿到的是完整的标准概念词表,还需要一份源领域的标准上下位边来训练投影。
关键概念:MRL 的前缀为什么可能对应类目粗细
MRL 向量越靠前的维度承担越粗的语义(§2.4)。作者的问题是:这种“由粗到细”的排列,是否刚好对应分类树里“由大类到小类”的层级。
论文用的基准来自 OLLM(用微调大模型从文档生成分类树的方法)的工作:Wikipedia 版有 8,033 个概念、14,673 条边、三层深;arXiv 版有 61 个类别、两层深(§5.1)。
发现:分类信号集中在靠前的维度
作者在三个结构不同的 MRL 模型上检验这一点:Nomic-embed-text-v1.5(1.37 亿参数,BERT 结构)、jina-embeddings-v3(5.72 亿,XLM-R 结构)和 Qwen3-Embedding(6 亿,decoder 结构)(§3)。做法是只保留前 d 维,看每个概念最近的 10 个邻居里有多少和它属于同一类(kNN 纯度),“同一类”按分类树最深一层的标签判定(图 1 说明)。
为了确认起作用的是“前面的维度”,而不是“维度少了”,作者设了两个对照:一是先把所有维度随机打乱再截断,信息总量不变但顺序被破坏;二是截取最后 d 维。三个模型上,按原顺序截取前缀都明显好于两个对照,优势集中在前面较短的前缀上(图 1)。到全部维度时三种做法取的是同一个向量,结果自然一样。
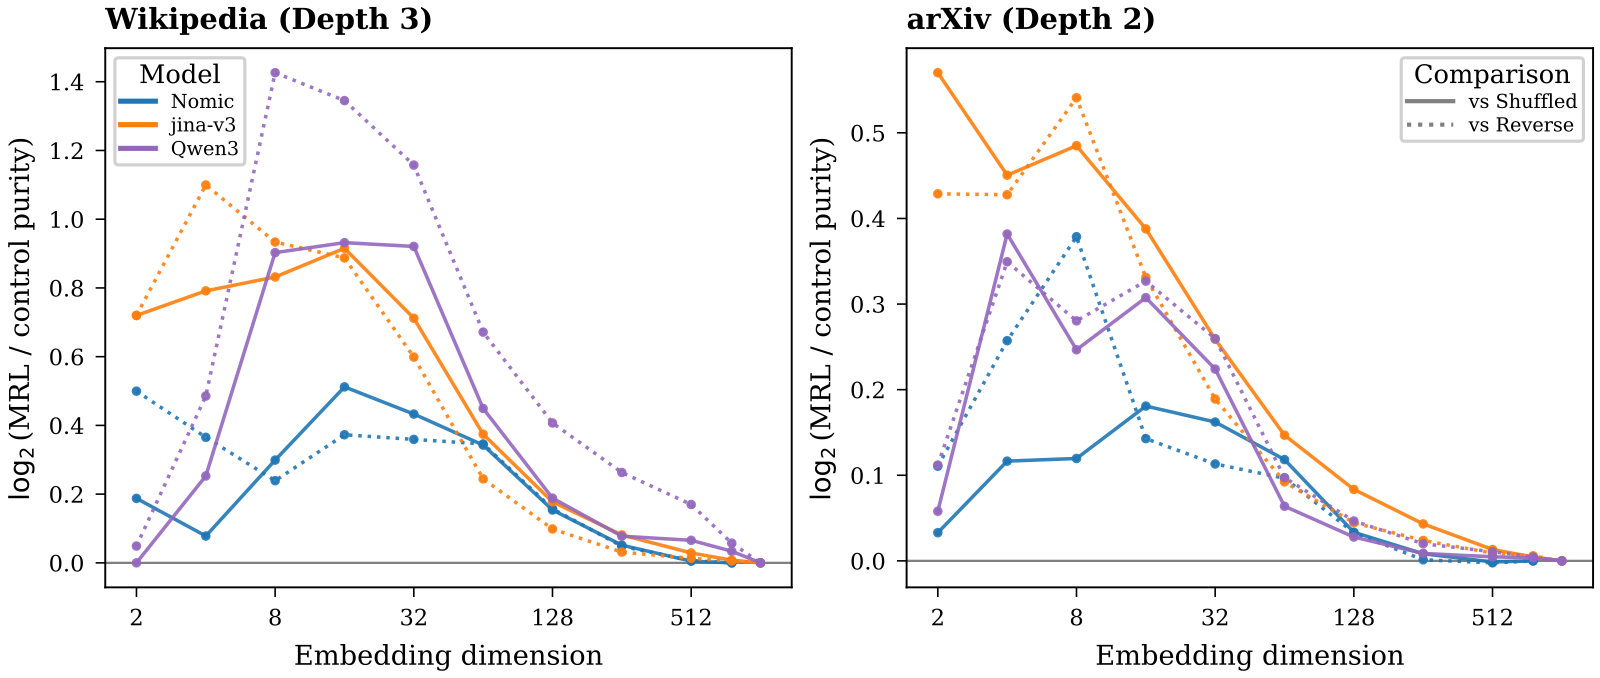
这里要分清两件事。图 1 证明的是:靠前的维度比打乱或末尾的维度带着更多分类信息。它没有把某个前缀长度对到某一层类目,因为纯度只按最深一层算。“越短的前缀对应越粗的类别”是作者在此基础上的解读,最直接的支持是一个例子:在“数学”这棵子树下,用前 64 维解出的树只有 1 个子节点,用前 256 维有 19 个,用全部 768 维有 68 个(§5.4,图 3)。同一节还有一个和“一棵逐级展开的类目树”相反的结果:不同前缀长度解出的树并不是一层套一层。任取两个前缀长度,两棵树边集合的 Jaccard 都低于 0.18,99% 的节点换了父节点(§5.4)。所以更准确的理解是:每个前缀长度各自给出一种不同的层级划分,而不是同一棵树的粗版和细版。
作为辅助的一致性检查,作者对每个维度做单因素方差分析,看按某一层的类别标签分组后,组间差异能解释这个维度多少比例的变化(η²,越大说明这一层的类别在该维度上分得越开),再对所有维度取平均。在 Wikipedia 上,第一层的 η² 是 0.04–0.07,第二层 0.13–0.18,第三层 0.34–0.40(表 1),六组“模型 × 数据集”组合全都由浅到深递增。不过三层的类别数相差很大(33、875、7,124 类),类别分得越细,η² 本来就越容易变大,作者也说明这些数只表示各模型的趋势一致,不能拿来比较各层的绝对强弱(表 1 说明)。这个检查也没有改变前缀长度,所以不能单独支持“短前缀对粗类目”。
PEEL 怎么把信号变成分类图
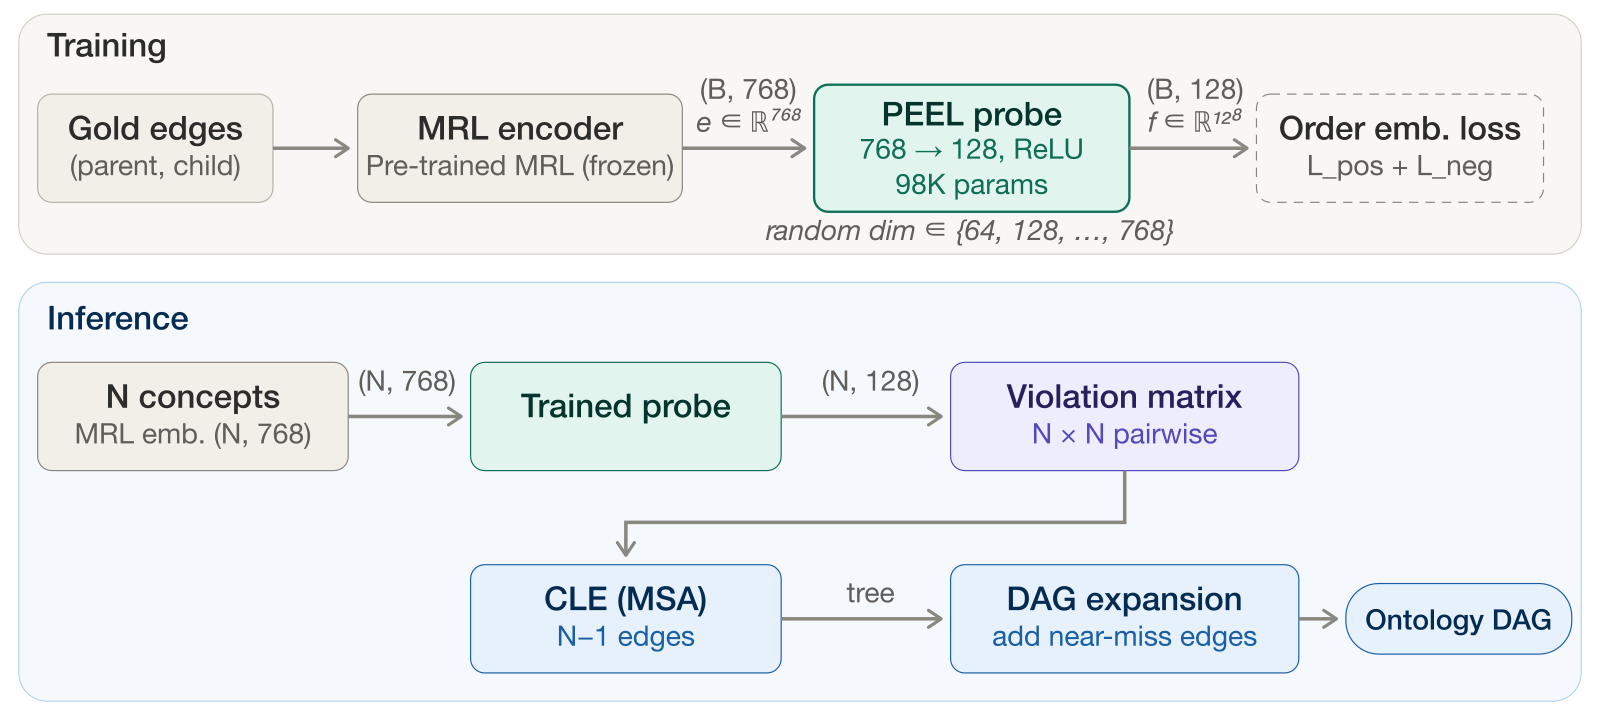
PEEL 分三步(§4,图 2):
- 小投影。把 Nomic-embed-text-v1.5 输出的 768 维冻结向量(§5.1)经过一个线性层和 ReLU 投到 128 维,共 9.8 万个参数。这样设计是为了只读出 embedding 里已有的结构,而不是重新学一套表示。训练目标是顺序嵌入损失:如果 A 是 B 的上位概念,就要求 A 的每一维都不大于 B 的对应维度,相当于用“坐标逐维不大于”来表示“A 包含 B”。光有这一条,把所有概念都投到同一个点也能满足,所以损失还有另一半:对没有上下位关系的概念对,把 A 在各维上超过 B 的部分平方后加起来,这个和要至少达到一个间隔 m,达不到就罚(式 2–4)。训练数据是 Wikipedia 标准边的 80%(按边切分,另 10% 做验证),10 轮,单卡约 4 秒;训练时每一步从 64、128、256、384、512、768 维里随机取一个长度截断,再在后面补零回到 768 维交给投影,让同一个投影适应不同的前缀长度(§4.2、§5.1)。
- 抽出一棵树。对任意两个概念 i 和 j,看 i 的投影在每一维上比 j 大出多少,没超过的维记 0,把超出的部分平方后加起来,作为“i 是 j 上位”的违背分数(式 5)。比如 i 只在两维上分别超出 0.1 和 0.3,违背分数就是 0.01 + 0.09 = 0.1(示意)。分数越低越像上下位,而且超出得多的维度罚得更重。把所有概念连成一张带权有向图,用 Chu-Liu/Edmonds 算法找总违背分数最小的有根树,这一步不需要设阈值(§4.3)。
- 补成有向无环图。一个概念可能有多个上位,所以再按违背分数从低到高加边,保证不成环,直到边数预算用完。Wikipedia 上推理用前 512 维、预算 15,000 条边,这些设置按 Wikipedia 验证集选定(§4.4、§5.1)。
结果
先说清指标。三个 F1 都是把恢复出的图和标准分类图对比(§5.1)。Lit. F1 要求一条边两端的概念名和标准边逐字相同。Cont. F1 用 embedding 相似度把恢复的边和标准边做一对一最优配对,每对边的得分取两端相似度里较低的那个,所以名字不同但意思接近的边也能得分。Graph F1 先给每个节点算一个向量:节点名字的 embedding 和周围邻居的 embedding 按图的连接关系反复做加权平均(SGConv),这样两个节点只有名字相近、邻居也相近时向量才接近;再给两张图的节点做一对一最优配对,每对节点的得分就是两个向量的相似度,由这些得分得出精确率和召回率,再合成 F1。具体换算公式这篇论文没有写,直接沿用 OLLM 基准(Lo et al., 2024)的实现。作者把 Graph F1 和 Cont. F1 当作主要指标;它们都是按语义相似度给的软分数,不要求边名逐字对上,这也是同一个 PEEL 在 Graph F1 上能到 0.885、在 Lit. F1 上只有 0.111 的原因。
| 数据集 | 方法 | 输入 | Graph F1 | Cont. F1 |
|---|---|---|---|---|
| Wikipedia | PEEL | 只有概念词表 | 0.885 | 0.551 |
| Wikipedia | 照抄训练边(Memorisation) | 训练边 | 0.419 | 0.314 |
| Wikipedia | OLLM | 文章标题和摘要 | 0.644 | 0.500 |
| arXiv | PEEL(不用 arXiv 数据) | 只有概念词表 | 0.931 | 0.604 |
| arXiv | OLLM(迁移版) | 文章标题和摘要,另加 2,048 条 arXiv 样本 | 0.633 | 0.357 |
上表数据来自表 2。这说明什么:一个只有 9.8 万参数、训练 4 秒的投影,Graph F1 和 Cont. F1 都高于 OLLM 报告的分数。但这不是同等条件下的比较(§5.3):OLLM 要从文档里自己发现概念再连边,PEEL 直接拿到标准概念词表,还用了 Wikipedia 标准边训练投影,作者只把 OLLM 当作跨任务的参照,不当排名。arXiv 上的结果更能说明迁移,因为投影完全没见过 arXiv 的边,也没有用 arXiv 数据调参;arXiv 上的推理设置是全部 768 维、只抽树不补边,作者说这是按 61 个概念的小规模定的(§5.1)。
逐字匹配的指标上,两边各有胜负(表 2)。在 Wikipedia 上,PEEL 的 Lit. F1 是 0.111,低于照抄训练边的 0.134,也低于微调 Mistral-7B 基线的 0.124;在用阈值判断边名是否相近的 Fuzzy F1 上,OLLM 的 0.915 也高于 PEEL 的 0.877。arXiv 上则反过来,PEEL 的 Lit. F1 是 0.298,OLLM 只有 0.040。所以 PEEL 在 Wikipedia 上恢复的主要是整体形状,具体到每条边的名字并不总能对上。
前缀选多长影响有多大
表 3 固定投影输出为 128 维,只改变输入前缀长度。把前缀从 64 维换到 768 维,Graph F1 一直在 0.879–0.906 之间,几乎不变;Cont. F1 变化更明显,前 512 维时最高(0.551),用全部 768 维反而降到 0.479,作者据此选了 512 维。把投影输出再缩到 32 维(2.4 万参数),Graph F1 仍有 0.870,Cont. F1 0.517(附录 A 表 4)。这说明开头那个 0.885 几乎不依赖选哪段前缀,前缀的作用主要体现在 Cont. F1 上;“前缀带着分类信号”这个发现和 PEEL 的头条成绩之间的联系,没有开头听上去那么紧。
我认为它的局限
- 输入条件不对等。PEEL 直接拿到标准的概念词表,也需要一份标准上下位边来训练投影。真实场景里概念词表往往要自己整理,这一步的难度没有被计入。
- Wikipedia 上的 0.885 不算迁移。投影用 Wikipedia 标准边的 80% 训练,评测却在全部 8,033 个概念的完整结构上算,评测图里就包含这 80% 训练边(§5.2);推理参数也按 Wikipedia 验证集选定(§5.1)。所以这个分数主要说明同一份数据上的拟合效果。真正的迁移证据是 arXiv,而 arXiv 只有 61 个概念、两层深,规模很小。
- 只在两个基准上评测,作者也承认迁移只覆盖了不比训练数据更深的分类树,生物医学、法律等专业领域还没测(局限 1)。也没有测分类图对检索或问答等下游任务的帮助(局限 2)。
一个搜索团队可以怎么试
- 如果线上已经在用 MRL embedding,先复现前缀对照实验:拿现有类目树里的类目名,分别用前缀截断、打乱后截断、截取末尾三种方式算最近邻同类比例,看前缀是否明显更好。
- 若前缀明显更好,用现有类目树的一部分边训练 PEEL 的小投影,在留出的类目分支上检查它能否恢复上下位关系。评测时把训练边排除在外,避免像 Wikipedia 那样把训练边算进分数。
- 把恢复出的关系用于类目补全或 query 的类目归属,和现有规则或人工标注比较准确率和覆盖率。注意不同前缀长度会解出不同的树,先固定一个长度再比较。
评价
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中,分类树构建成本高,但离检索主线稍远 |
| 方法创新性 | 中高,发现新颖,PEEL 本身是已有组件的简单组合 |
| 实验证据 | 中,三模型对照扎实,但只在两个基准上评测、没有下游任务,跨域只有一个 61 个概念的小数据集 |
| 工程成本 | 很低,9.8 万参数、几秒训练 |
| 是否值得尝试 | 值得,用现有 MRL embedding 做一次前缀对照实验成本很低 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…