
主动式助手(智能眼镜、车载、陪伴机器人上那种不用叫就会开口的 AI)最难的一点是挑时机:同样是在做饭,有的人希望被提醒,有的人只想安静。华南理工和鹏城实验室的这篇论文提出 EOPA(Evidence-driven Online Preference Adaptation),不训练模型、也不让大模型写反思总结,而是给每个用户记账:在一天的哪个时段、一项活动做到第几分钟、在做什么样的活动时,用户过去是希望被打扰还是希望安静,各记了多少次。新时刻来了就查账,算出“该开口”的证据有多强,超过阈值才说话。在 32 个模拟用户、14 天、16 万个判断时刻的测试里,该开口的时刻只占 1.129%;EOPA 的 F1 是 30.46,最好的基线 Reflexion 是 10.66,微调模型的方法 F1 只有 2.57。
值得读的人:做主动推送、智能提醒、陪伴类产品,需要决定“什么时候打扰用户”的团队。方法几乎全是计数和简单公式,决策本身不调用大模型,延迟和适配成本都很低。主要局限是全部实验在模拟用户上完成,标签也由大模型生成。
它到底在解决什么问题?
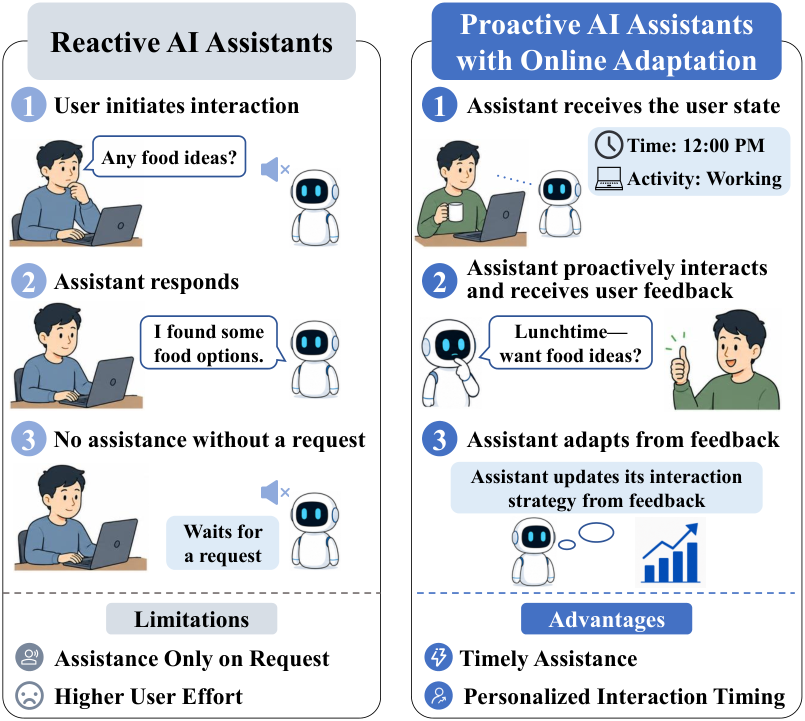
助手每 2.5 分钟看一次用户状态(当前时间加一段描述用户在做什么的文字),决定开口还是保持安静,然后收到反馈:这个时刻到底该不该开口,开口的话回复质量怎样。难点是值得开口的时刻非常稀少,又分散在大量相似的状态里:同一个时段、同一种活动,有时该说,有时不该。
已有两类做法都不理想。微调大模型的方法,监督信号太稀疏,学不出细粒度的时机偏好;让大模型把过往经验总结成文字规则(Reflexion 等几种方法),规则的适用范围说不清,要么套用过头,要么用得太窄。
方法:给每个用户记两本账
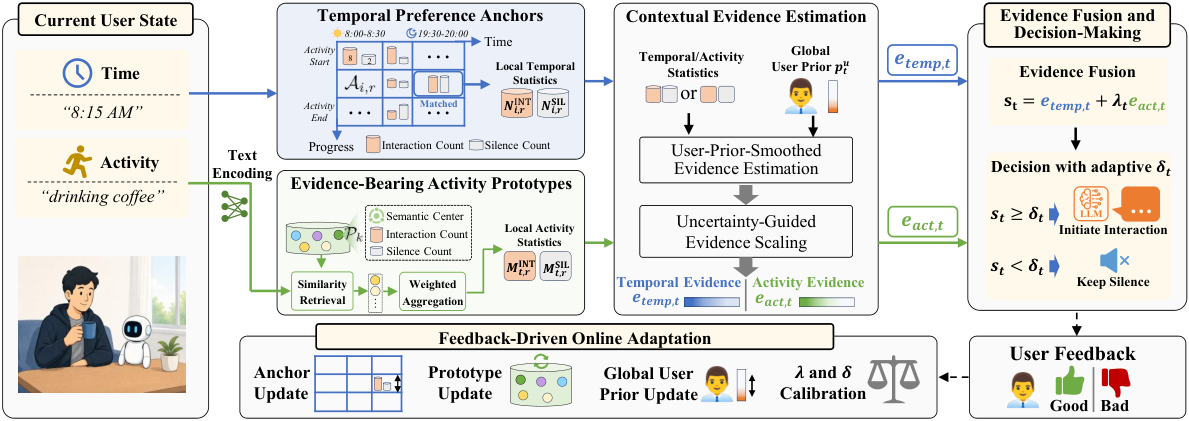
第一本账按时间记。一天切成 30 分钟一格,每一格再按“当前这项活动已经持续了几个判断步”细分,因为同一个活动刚开始时提醒可能有用,做投入了再打扰就烦人。每个格子记两个数:该开口的次数和该安静的次数。论文把这样一个格子叫 temporal preference anchor。
第二本账按活动内容记。用冻结的句子编码器(all-mpnet-base-v2)把活动描述变成向量。账本里每一条代表一类相似的活动,存一个中心向量,再像第一本账那样按活动持续步数分别记“该开口 / 该安静”的次数,论文把这样一条叫 prototype。查账时找和当前活动最像的 12 条,把它们在当前持续步数下的两种计数按权重加起来。每条的权重等于 exp((它的相似度 − 最高相似度) ÷ 0.1) 乘以“最高相似度的平方”:前一项让越像的记录分量越大,后一项在连最像的一条都不太像时把所有权重一起压低,避免把不相干活动的经验搬过来。收到反馈时,如果最像的那条相似度达到 0.96 就更新它:中心向量和当前活动向量做增量平均,对应持续步数下“该开口”或“该安静”的次数加一;否则新开一条,中心向量就是当前活动向量,次数从这一次记起。
从计数到证据分数分三步,两本账用同样的算法:
| 步骤 | 做什么 | 为什么 |
|---|---|---|
| 平滑 | 该开口比例 =(该开口次数 + 2.5 × 用户整体开口率)÷(总次数 + 2.5) | 格子里只有一两次记录时,不让比例跳到 0 或 1,先向这个用户的整体习惯靠 |
| 算不确定度 | 比例 ×(1 − 比例)÷(总次数 + 3.5),记录越少越大 | 同样是 50% 的比例,记了 2 次和记了 200 次,可信程度差很多 |
| 证据分数 | 比例 ÷ 不确定度的平方根 | 比例高、记录又多时分数才大 |
最后把时间证据加上 λ 倍的活动证据,与阈值比较,超过就开口。λ 和阈值不是固定的:EOPA 保存最近一段的证据和反馈,定期用几组候选参数把这些历史决策重放一遍,换成让 F1 最高的一组。论文只描述了这个流程,保留多长的历史、多久调一次、候选参数取哪些值,复现时要按自己的数据定。只有决定开口时,才让 Qwen3-4B 根据当前活动和过去评分高的回复写一句话。
实验结果
测试基于 ProPerSim:32 个不同性格设定的模拟用户,每人 14 天,判断时刻共 160,632 个;哪些时刻该开口由 Qwen3.5-397B 根据每个用户的时机偏好标注,共 1814 个,只占 1.129%,所以主要看 F1 而不是准确率。
| 方法 | F1 | 精确率 | 召回 |
|---|---|---|---|
| 参数学习(ProPerAssistant) | 2.57 | 1.36 | 28.82 |
| 文字经验(Reflexion,DeepSeek-V4) | 10.66 | 7.04 | 24.05 |
| EOPA | 30.46 | 24.89 | 41.10 |
换不同的大模型做文字经验总结,结果都在 10 左右,说明瓶颈不是大模型能力,而是文字规则本身说不清适用范围。逐步加部件的消融:只用用户整体开口率,F1 只有 1.13;加上时间账本到 17.57;加上平滑和不确定度到 25.81;加上活动账本到 28.95;再加上自动调参到 30.46。
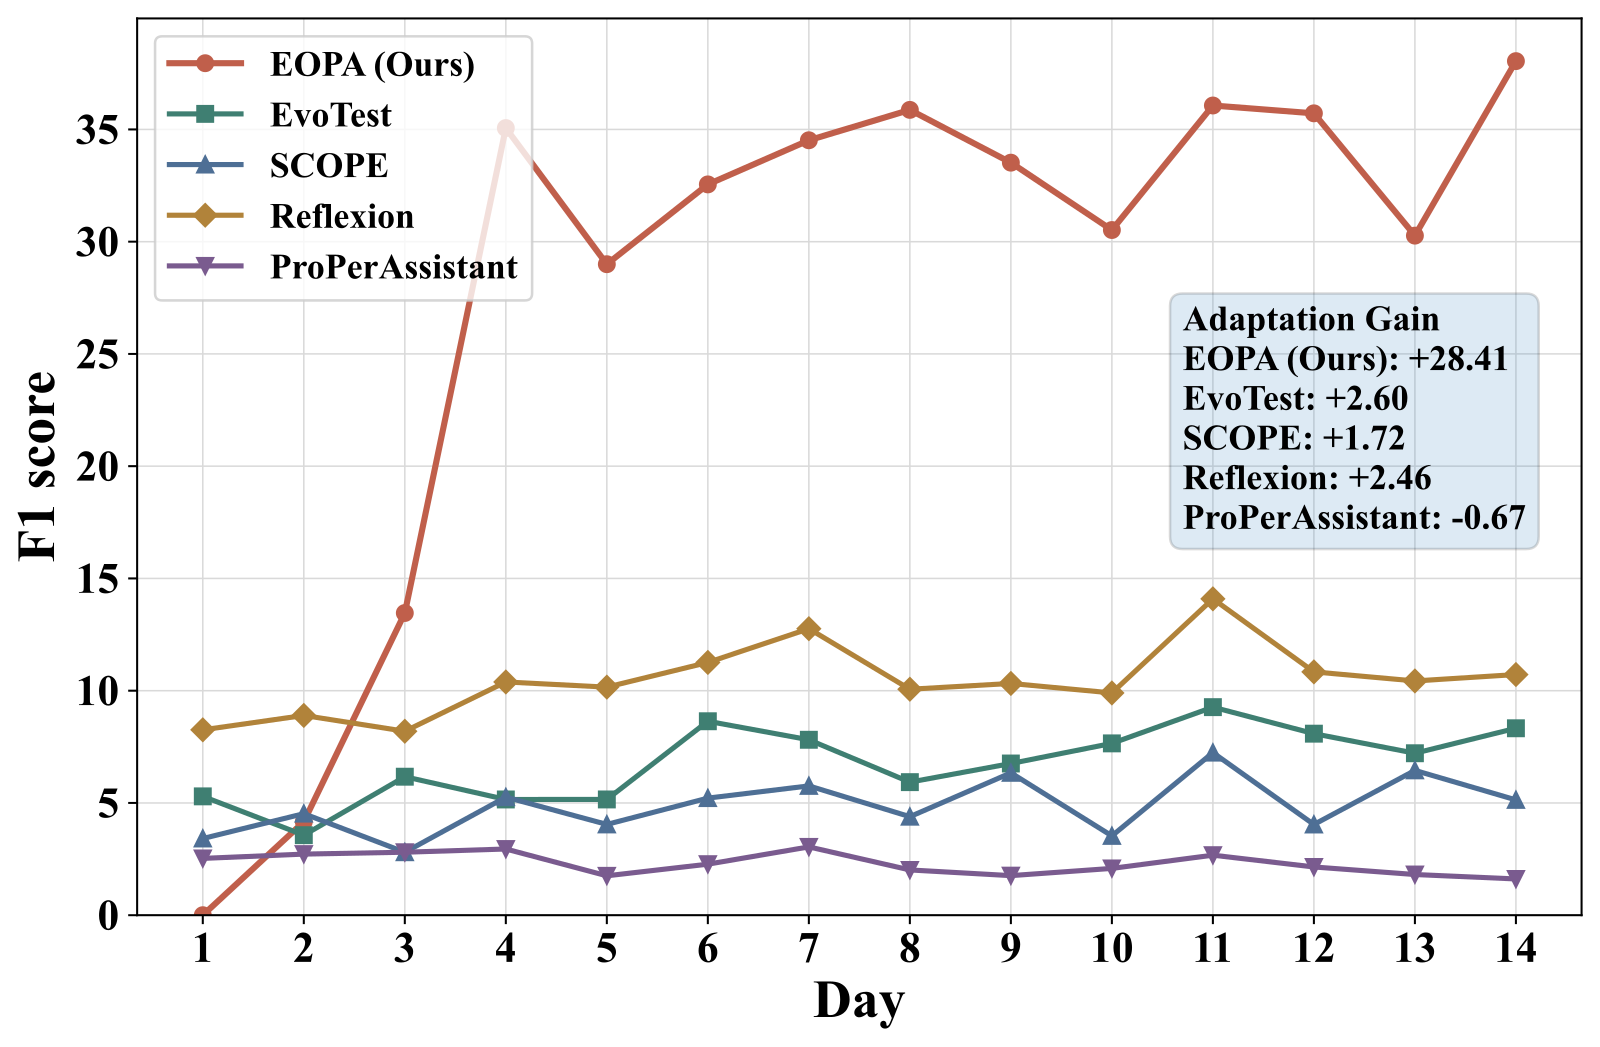
在线适应的效果很明显:从第 1 到 3 天到第 8 到 14 天,EOPA 的平均 F1 提升 28.41 分,所有基线的变化都不超过 2.60 分。反馈只保留一半时 F1 仍有 25.56,只保留四分之一时降到 13.35,说明它依赖足够多的反馈。
局限
- 用户、活动、该开口的时刻全部是模拟或大模型生成的,真实用户的反馈会更嘈杂、更不一致。
- 活动账本依赖文字描述的质量,真实设备上的描述来自视频转文字,误差会传进来。
- 冷启动要几天:前三天 F1 很低,产品上需要别的办法撑过这段时间。
- 只决定“开不开口”,不决定“说什么”;回复质量仍靠大模型和少量示例。
怎么借鉴
做主动提醒时,先别急着训练模型:按“时段 × 活动进行到第几步”的格子给每个用户记“该提醒 / 别打扰”的次数,用用户的整体习惯做平滑,再按记录多少给一个可信度,就能得到一个很强的基线。活动类型多而开放时,用句子向量把相似活动归到同一条记录里,加一个“最像的都不像就别借用”的保护。阈值和权重用最近的反馈重放来定期调整,比固定值稳。决策和回复生成分开,大模型只在需要说话时才调用,延迟和成本都低很多。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…