目录 · 9 节
1它到底在解决什么问题?2和已有做法差在哪里?3整体流程:上游边打分边导出,下游按时间读取4为什么取所有层,而不是只取最后一层?5下游怎么用这些编码?6实验结果7局限8如果要在自己的场景试9结论
同一个做菜视频,对随手看看的用户是消遣,对美食博主是找灵感的素材,可推荐模型在两人的历史序列里给它的是同一个初始 embedding。PRISM(Meta 这篇论文提出的方法)让历史里的每条行为都换成一个新向量,表达这个用户当时和这个物品的关系。它复用上游排序模型打分时已经算出的各层中间状态,把它们拼起来交给一个自编码器,压成每个被打分的用户–物品对一个 embedding 存起来,之后的序列模型按时间顺序读取。在 Meta 一个十亿用户级的推荐场景上,下游模型的 NE 平均下降 0.15%,在相近的历史长度下,另一种缓存历史摘要的做法 VISTA(把用户历史压成摘要 token 缓存起来的方案)只下降 0.07%,而且历史越长收益越大。历史序列的输入本身也可以个性化,计算成本还能摊到已有的上游排序上。
这篇值得细读,因为它把"历史序列里放什么"从物品 ID 换成了"上游模型当时对这次打分的理解",而这些理解本来每天都在算、算完就扔。证据目前只有离线 NE,没有线上实验,也没有拆开看哪部分状态最有用,所以更适合当作一个低成本可试的方向,而不是已经被证明的结论。
它到底在解决什么问题?
主流的序列推荐把用户历史写成一串物品 ID,每个 ID 查一张共享的 embedding 表,再交给 Transformer 之类的序列模型。问题出在这张表是所有用户共用的。还用开头的例子:
| 历史里的同一条记录(示意) | 普通 ID 序列给的输入 | 实际含义 |
|---|---|---|
| 用户甲看过做菜视频 V | V 的 embedding | 下班随手刷,看完就走 |
| 美食博主乙看过做菜视频 V | 同一个 V 的 embedding | 反复看刀工细节,准备自己拍 |
序列模型当然可以在后面的层里,结合上下文慢慢把这两种含义区分开,但这要靠模型容量和数据慢慢学。PRISM 的看法是:上游排序模型在当时给 V 打分时,已经结合用户甲或乙的特征、当时同一请求里的其他候选,把这层关系算了一遍。把这些中间结果留下来,历史里的每一条一开始就带着"这个人当时怎么看这个物品"的信息。
和已有做法差在哪里?
最直接的办法是单独训练一个用户–物品模型,把每个用户的每条历史都重新算一遍关系向量。历史事件量极大,这样做的计算量撑不住。论文注意到,很多推荐系统本来就有一个上游排序模型,给下游提供用户 embedding 特征和教师标签。它在打分时读过用户历史,结合了用户、物品和上下文,隐状态里已经有"这次相遇"的信息。PRISM 把这部分计算留下来,为了不额外再算一遍。
论文点名对比的两种做法,复用的粒度不同:
| 做法 | 存下来的是什么 | 下游能取到的粒度 |
|---|---|---|
| VISTA | 整段用户历史压成的若干摘要 token | 整段历史的摘要 |
| OneTrans | 跨请求复用的 KV cache | 前一次请求算过的中间结果 |
| PRISM | 每个被打过分的用户–物品对一个短编码 | 单条历史事件,且带着当时的用户和上下文 |
所以 PRISM 的区别在于"按条存":下游可以自己挑哪些事件、取多长,每一条都保留了当时的用户状态和同批候选的信息。
整体流程:上游边打分边导出,下游按时间读取
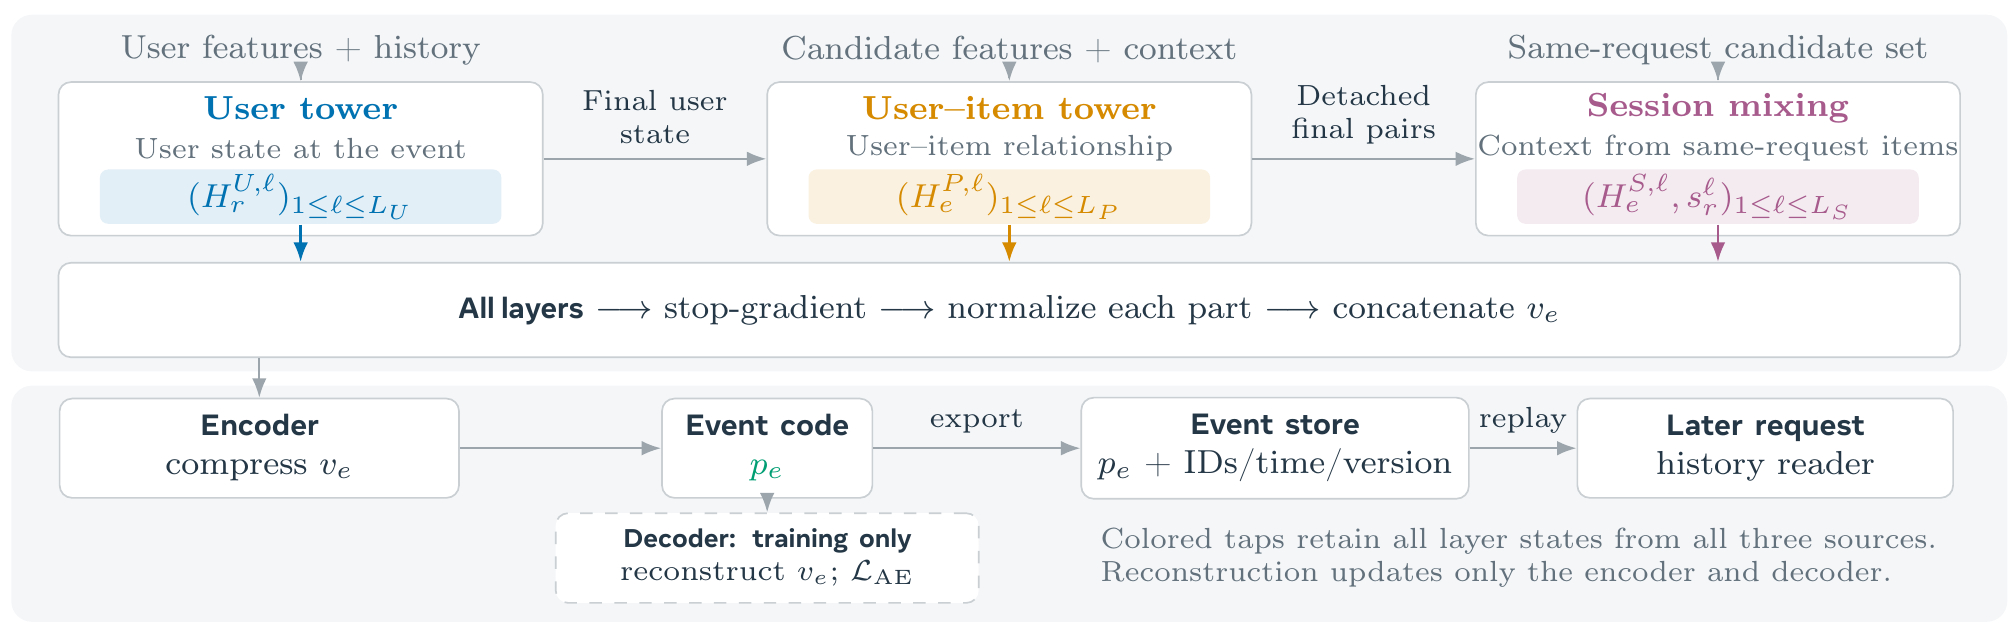
整个系统分两半:上面是生成编码的上游模型,下面是存储和下游读取。
| 环节 | 输入 | 做什么 | 产出 |
|---|---|---|---|
| user tower | 用户历史和用户特征 | 多层计算用户当时的状态 | 每层的用户状态 |
| user–item tower | 候选物品特征、上下文、用户最终状态 | 计算这个用户和这个候选之间的关系,接多任务预测头 | 每层的用户–物品状态 |
| session mixing | 同一次排序请求里所有候选的最终状态 | 候选之间互相交换信息(论文给的一种实现是 Transformer 式模块),每层把所有有效候选的状态汇总成一个请求摘要,接物品级和请求级预测头 | 每层每个候选的状态,加一个请求摘要 |
| 压缩 | 以上三部分所有层的状态 | 拼接后由 encoder 压短 | 每个被打分的用户–物品对一个编码 p_e |
| 下游读取 | 当前请求之前的最多 L 条编码 | 加上时间信息和这条事件的其他可用信息,用序列模型读取 | 给下游预测器的额外特征 |
这里的 session 不是用户过去的浏览会话,而是同一次排序请求里一起被打分的那一批候选。session mixing 收到的候选状态是断开梯度的,它的损失不会反过来改动前面的 user–item tower。
为什么取所有层,而不是只取最后一层?
最后一层的状态主要服务于上游自己的预测头,偏向"这次会不会点"。中间层保留的信息更杂,比如用户兴趣的不同侧面、候选之间的比较。PRISM 的做法是三个来源的每一层都取,每一部分先按自身的均方根缩放到相近的量级,免得某一块数值大就盖过其他部分,再拼成一个长向量 v_e。这个长度和一次请求里有多少候选无关,因为 session mixing 那部分只取当前候选自己的状态和一个请求摘要,而请求摘要是把所有有效候选的状态池化成固定长度的向量。
长向量直接存太贵,于是接一个自编码器:encoder 由若干带门控的残差块组成,最后用 softsign 把每一维限制在 (−1, 1),得到短编码 p_e;decoder 只在训练时用,要求从 p_e 还原出 v_e,重建误差越小,说明压缩丢的信息越少。关键的一点是,重建损失只更新 encoder 和 decoder,不回传到三个来源。上游模型照常按自己的推荐目标训练,压缩器只是在旁边学着"记笔记"。总损失是三项相加:user–item tower 的预测损失、session mixing 的预测损失、重建损失。
在实验里,每个编码是 128 维、每维用 INT8 存,按这个设置算,每条编码大约 128 字节。
这些编码是 PRISM 在线训练时导出的:上游模型本来就要为训练算一遍前向,导出就是把这次前向的中间状态压缩后写进事件库,实验里下游读到的历史全部来自这 14 天的导出。每条记录对应一次打分,记为(用户,物品,打分时间,请求),编码只用打分那一刻已有的信息:打分之前的用户历史、当时的用户特征、候选特征和这次请求的上下文。论文没说导出时同一次请求的完整候选集合从哪里取,也没说没展示给用户的候选是否参与 session mixing、是否写进事件库。这一步决定了请求摘要里装的是哪些候选,复现时要自己定口径。下游读取时再按保留规则(实验里是 30 天内最近 400 条)从事件库里挑出历史。
下游怎么用这些编码?
举个具体的例子,还是用户乙。她今天打开应用,下游模型要给一批新视频打分。读取器先去事件库里找她的记录,规则有三条:打分时间早于现在;编码已经写入、可以读;排除当前这次请求本身。按时间取最近的最多 L 条。
每一条编码 p_e 进入下游前做三件事:乘一个按上游版本区分的投影矩阵,因为不同版本的上游模型产出的编码空间不完全一样;加上距离现在多久的时间编码;加上这条事件其他可用信息的编码,论文只称之为“可用的元数据”,没有列出具体字段。之后由序列模型处理,再以当前候选为条件按相关程度加权读取,得到的结果和普通特征一起送进预测器。
存进去的编码是固定的,下游训练不会改动它们;下游的读取器、按版本的投影矩阵,连同普通特征那一路的网络和最终预测器,都随下游自己的训练更新。这意味着上游和下游可以各自迭代。没有历史记录的用户,下游用一个「有没有记录」的标记,走普通特征那条路。同一个做菜视频 V 在乙的历史里出现两次,也会是两个不同的编码,因为两次打分时她的状态、同批候选都不同。比如(示意)第一次打分时,她最近看的主要是搞笑视频,V 和几条搞笑视频同批出现;第二次打分时,她最近一周连续看了很多刀工教学,V 和几条教学视频同批出现。两条编码的差别来自打分那一刻已知的用户状态和同批候选,之后她有没有看完、有没有收藏,不会写进这条编码。普通 ID 序列里这两条长得一样,PRISM 序列里它们带着各自的上下文,下游模型更容易看出她对做菜内容的兴趣在变得专业。
实验结果
实验在 Meta 内部一个十亿用户级的推荐场景(论文称 Surface 1)上做。PRISM 先在线训练 14 天,边训练边导出编码,这样下游才有足够长的历史可读。下游模型接着用这 14 天之后 3 天的生产数据从头训练,再用紧接着的下一天的留出数据评估,对照组和 PRISM 组都不做热启动,所以差异只来自多加的这一路历史。
历史保留 30 天内最近 400 条,98% 的用户有记录,说明覆盖面不是问题。NE 越低越好,论文把 0.03% 以上的改进算作显著。
| 任务组 | VISTA | PRISM |
|---|---|---|
| 正向行为(8 个任务) | −0.05% | −0.17% |
| 负向行为(5 个任务) | −0.09% | −0.11% |
| 全部(13 个任务) | −0.07% | −0.15% |
VISTA 是一种把用户历史压成摘要 token 缓存起来、供目标 attention 读取的做法,两者使用同样的排序基线、数据、普通特征和评估方式,历史长度相近。正向行为里提升较大的任务是点赞 −0.22%、评论 −0.20%、分享 −0.17%,负向的不喜欢是 −0.09%。这说明 PRISM 的优势主要在正向互动上,负向行为两者差距只有 0.02 个百分点,低于显著线。
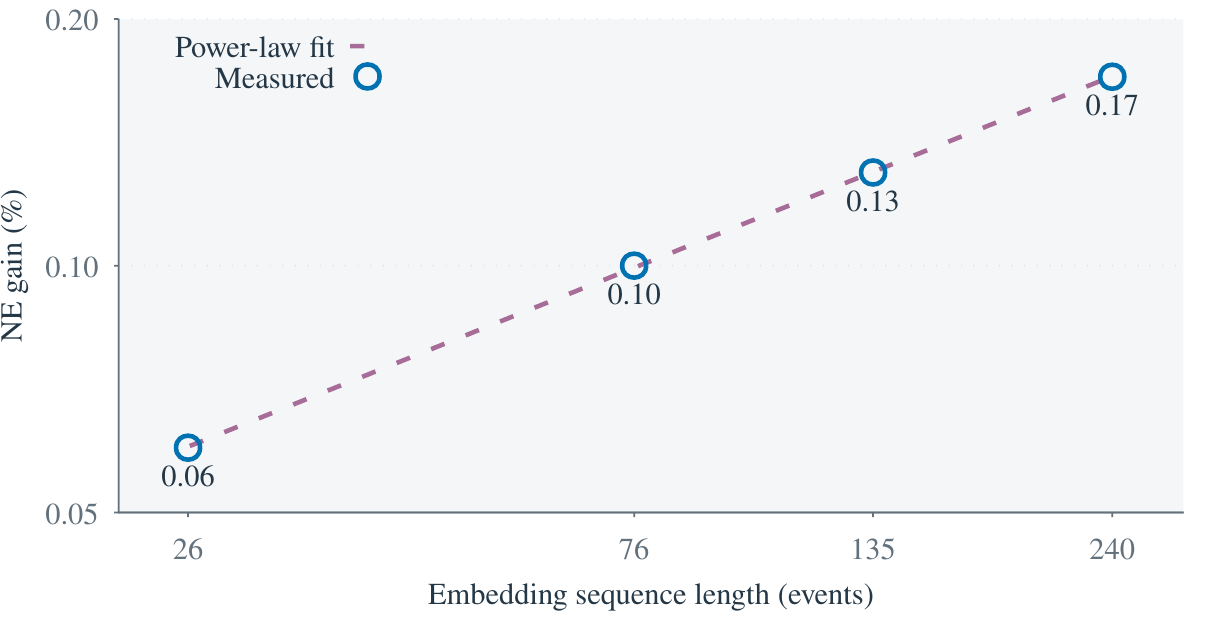
论文还改变下游读取的历史长度,从 26 条到 240 条,NE 改进从 0.06% 涨到 0.17%。拟合出的幂律指数是 0.468,意味着长度每翻一倍,收益约变成原来的 1.38 倍。这说明历史越长,这种编码带来的收益越大,至少在 240 条以内还没有饱和。
局限
第一,证据只有离线 NE。13 个任务平均 −0.15% 在大规模推荐里不算小,但实验部分全是离线评估,离线 NE 的改进能转化成多少线上指标是未知数。
第二,没有消融。实验只比较了完整的 PRISM 和 VISTA,三个来源、所有层、自编码器各自贡献多少无从得知。读者无法判断只取 user–item tower 的最后几层是否已经够用,而这恰恰决定了复现成本。
第三,没有成本数字。论文强调复用上游的计算,但导出和存储并非免费:按 128 字节一条、每人最多 400 条,事件库的规模随打分量线性增长,而实验部分只交代了训练用的硬件,存储量、写入延迟和下游读取耗时都没有数字。幂律拟合也只有 26 到 240 条之间的 4 个点,不能外推到更长的历史。
如果要在自己的场景试
如果已经有一个线上排序模型,可以分三步低成本验证:
- 先只导出 user–item tower 最后一两层的状态,用一个小 encoder 压到 64 或 128 维,按打分记录写进日志。
- 下游保持现有 ID 序列不变,另加一路读取这些编码的序列分支,对比同样长度下 NE 的变化,看提升主要在哪些任务上。
- 有收益后再逐步加入更多层和请求级状态,同时记录每加一部分的存储增量,决定性价比。
还要说明一点,论文里的 PRISM 是专门为产出编码而设计的上游排序模型,带 session mixing 和自编码器,并不是把现成模型原样拿来;现有模型直接导出状态,效果可能打折扣,第一步的对比正好能回答这个问题。
需要注意上游模型更新版本后旧编码的兼容问题,论文用按版本区分的投影矩阵来处理,这一点在试验中应当保留。
结论
| 维度 | 评价 |
|---|---|
| 新意 | 把上游排序的中间状态当作历史序列的个性化输入,思路清楚 |
| 证据 | 13 个任务离线 NE −0.15%,是 VISTA 的约两倍;无线上实验、无消融 |
| 成本 | 复用已有计算,但存储和读取成本未报告 |
| 值不值得试 | 已有成熟上游排序和长历史的团队值得做一次小规模离线验证 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…