目录 · 10 节
1一条点击在训练里经过的几步2在模型出错之前,先看出这次点击不对劲3一致性分是不是在重复 loss 已经知道的事?4两个信号按用户的历史长短混合5判成可疑之后,只少给几个维度6再加一个对比学习7NDL 的 Recall@5 比 DAR 高 5.63% 到 17.95%8NDL 各个部件的贡献9历史少的用户混合权重更偏向 loss,为什么这些用户反而涨得最多?10会判错的情况和上线的代价
网易这篇推荐去噪论文的关键一步,是判断一次点击算不算误点时,除了看模型预测得准不准,还要看这次点击像不像点它的用户平时的口味。
LightGCN 这类图协同过滤模型靠用户和内容之间的点击关系学习 embedding。一次点击就是图上的一条边。训练目标要求点过的用户和内容 embedding 点积更高,所以每条边都会把两者的 embedding 往一起拉。可点击里混着误点和一时冲动。示意:一位用户看过 60 部科幻片,某天手滑点开了一个做菜视频。这条边进入训练后,这位用户的 embedding 会被往做菜内容的方向拉一点,后面的推荐也可能跟着跑偏。
难处在于训练数据里没有标出哪次点击是误点。60 次看科幻和 1 次误点做菜,在日志里都是一条「点过」的正样本,模型得自己估计哪一条不可信。
现有的显式去噪方法(训练时直接找出可疑交互、压低它影响的方法)判断一条交互是不是噪声,依据几乎都是这条交互的训练 loss,区别只在拿 loss 做什么。T-CE(截断 loss)把 loss 超过阈值的交互整条从梯度更新里丢掉,R-CE(重加权 loss)给 loss 越大的交互越小的梯度权重,DAR(Dimension-adaptive,SIGIR 2025 的去噪方法,也是本文最强的对照方法)把每条交互的 loss 换算成这条交互能用几个 embedding 维度,loss 越大,能用的维度越少。
放回这位用户身上,只看 loss 会在两个地方出错。做菜视频要等模型把它预测得很差,loss 才会变大,也就是模型先在这条样本上出了错,才发现它可疑。如果到了训练后期模型已经把这条误点记住,loss 变小,它就被当成干净样本放过去了。反过来,这位用户真心喜欢、模型一时学不好、给出的预测分很低的一部冷门科幻片,loss 同样很高,会被错当成噪声。作者还指出,同一条交互在训练早期和后期、抽到不同负样本时,loss 都会不一样,单靠 loss 判断噪声不够可靠。
NDL(Noise-aware Dimension Learning,作者给这套去噪训练方法起的名字)多问了一句:这次交互在 embedding 空间里,和这位用户平时的交互朝不朝同一个方向?具体做法是把这次交互和用户平时的交互各表示成一个向量,比较两者的夹角,下文会算给你看。这一问不需要这条交互的预测误差。在三个公开数据集上,NDL 的 Recall@5 比只看 loss 的 DAR 高 5.63% 到 17.95%。这些计算只发生在训练时,线上照旧只用训练好的 embedding,所以线上服务部分不用改动。
一条点击在训练里经过的几步
把那条做菜点击放进 NDL 的训练流程,它依次经过下面几步。表里的做菜数字是后文要算出来的示意值,只有第 1 步的产物会带到线上。
| 步骤 | 输入 | 操作 | 产出 | 只在训练时存在? |
|---|---|---|---|---|
| 1. LightGCN 编码 | 用户和内容的点击图 | 两层图传播 | 用户和内容各一个 32 维 embedding | 否,线上就用它 |
| 2. 比较这次点击和用户平时像不像(RCD 分支) | 这次点击的交互向量、这位用户的历史均值(见下节) | 算余弦,再过 sigmoid | 一致性分 0(方向完全不同),噪声分 0.73 | 是 |
| 3. loss 分支 | 这次点击平滑后的 loss | 过 sigmoid | 按 loss 大小给出的另一个噪声分 | 是 |
| 4. 按活跃度混合 | 两个噪声分、这位用户的交互数 | 加权平均 | 最终噪声分 0.73 | 是 |
| 5. 限制维度 | 最终噪声分 | 换算成可用维度数 | 做菜点击只用 32 维里的前 8 维算预测分 | 是 |
| 6. 对比学习 | batch 内的 embedding | 两次 dropout,算 InfoNCE | loss 里多一项,不产生噪声分 | 是 |
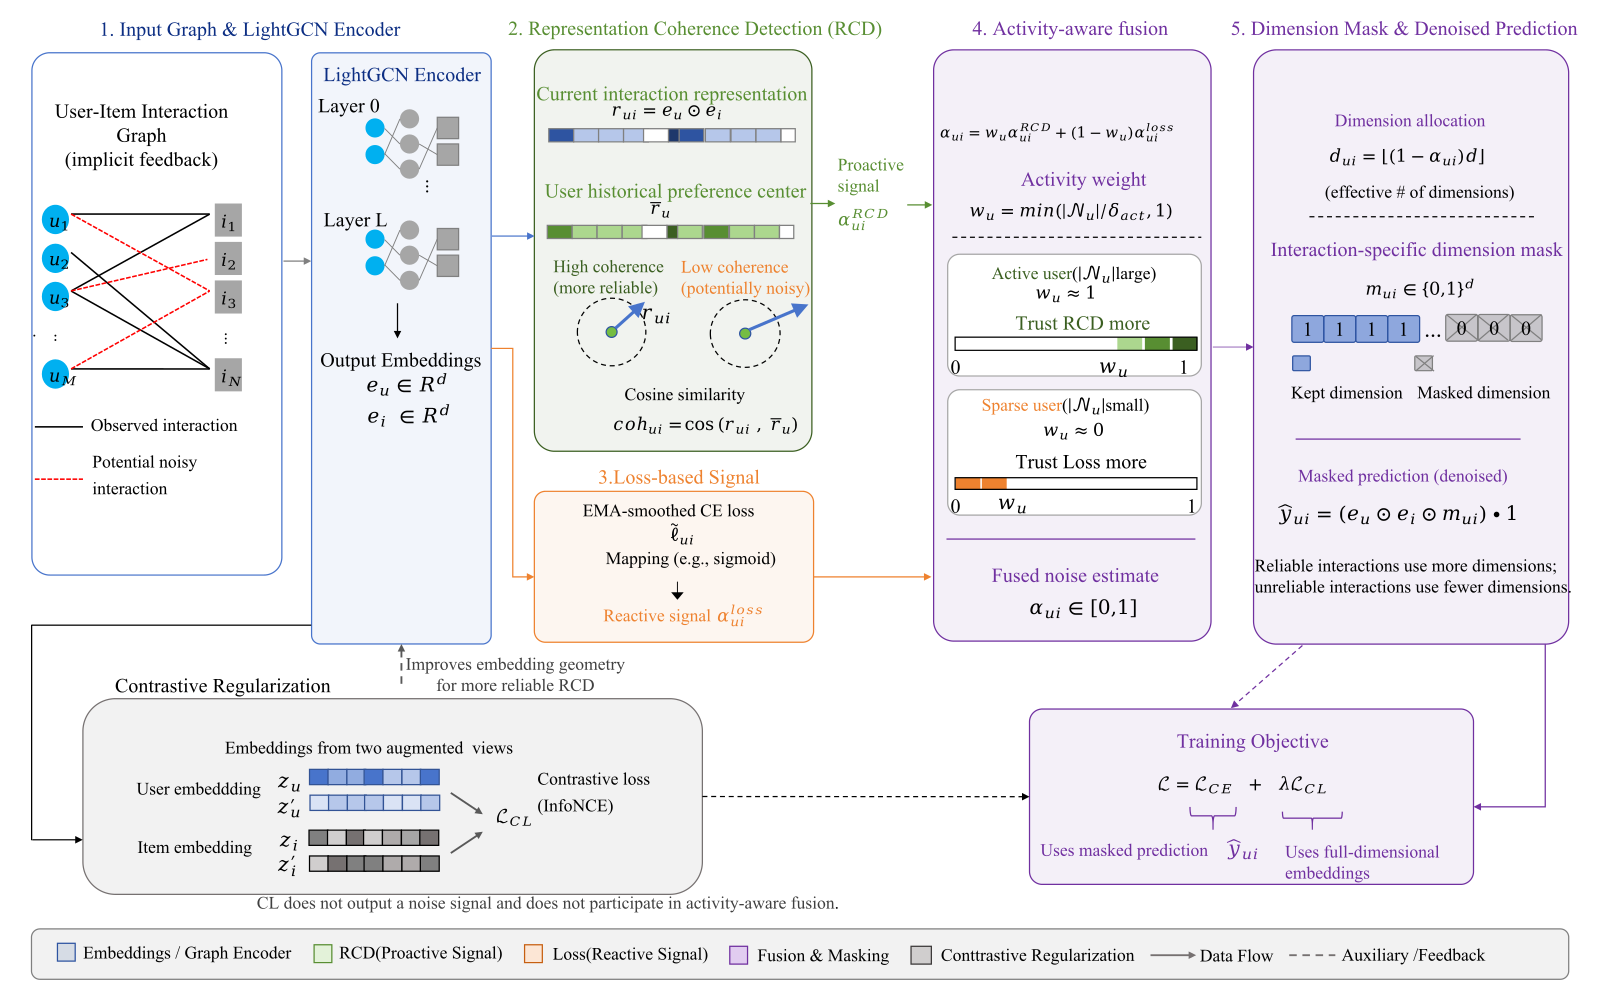
这张流程里的分工是:前面的分支判断这条交互有多可疑,后面的限制维度决定可疑的交互能造成多大影响。限制维度这一步是 DAR 已有的,NDL 主要换了决定维度的依据,从只看 loss 换成 loss 加一致性分。
在模型出错之前,先看出这次点击不对劲
NDL 先把「这次交互」变成一个向量。作者把用户 embedding 和内容 embedding 逐维相乘,得到 。预测分是两个 embedding 的点积,所以 每一维的值正好是这一维对预测分的贡献,各维加起来就是预测分。
然后,NDL 把这位用户所有交互的 取平均,得到历史均值 ,它概括了这位用户平时的得分集中在哪些维度。这个均值在每个 epoch 开始时用当前 embedding 重算一次。
和 的余弦就是这次交互的一致性分(论文叫 coherence)。算这个分数并把它变成噪声分的分支叫 RCD(Representation Coherence Detection)。RCD 比较的是这次得分靠哪些维度、这位用户平时得分靠哪些维度。余弦只看方向,向量整体放大两倍余弦不变,所以预测分的高低不进这个比较。 Hoot 说

3 维、3 条交互和所有向量取值都是示意,取正数只为手算方便;真实的 coherence 分布见正文图 1。
出处
论文 §1.2 式 (1)(2)、§3.1 式 (3)–(5);小例子的向量为示意,不来自论文示意:把 32 维缩成 3 维,这位用户的历史均值是 ,表示平时的得分主要来自前两维。一部科幻片的 是 ,大小是均值的两倍,方向完全相同,一致性分是 1。做菜视频的 是 ,和均值垂直,一致性分是 0。这个例子说明,只要 embedding 已经把做菜和科幻分在不同方向上,做菜点击不用等 loss 变大就能被标出来。真实 embedding 的维度并没有「科幻」「做菜」这样整齐的含义,这里只是为了能算。
作者说的「主动」(active)就是指这一点:算一致性分用不到这条交互的预测误差。不过 embedding 本身仍然是训练出来的,一致性分准不准,取决于 embedding 训得好不好。
接下来,一致性分要换算成 0 到 1 之间的噪声分:
是 sigmoid, 是一致性分, 是分界线。一致性分正好等于 时噪声分是 0.5,表示这条交互既不算可疑也不算可信;一致性分越低,噪声分越高。
示意: 取论文在 MovieLens 上的 0.1。科幻片的一致性分是 1,,。做菜视频的一致性分是 0,,。
Yelp 和 Amazon-book 上 取 0.5,作者的考虑是稀疏数据的历史均值噪声更大,需要更平缓的曲线。 越大,一致性分差同样多时,噪声分变化越小。在 MovieLens 上, 不超过 0.5 时效果稳定,到 1.0 时 NDCG 下降约 4.4%,因为不同交互算出的噪声分挤在一起,接近常数。这说明分界线不用调得很细,但取得太大,一致性分就区分不了交互了。
一致性分是不是在重复 loss 已经知道的事?
作者在 MovieLens 上拿验证效果最好的那个 DAR 模型,挑出它按 loss 判错的两组样本。一组是 12,145 条真噪声,DAR 把它们留下了;另一组是 68,689 条干净样本,DAR 把它们当成噪声压低了。作者再用全部样本一致性分的中位数(约 0.87)把一致性分切成高低两半。0.87 这条切线只用于这张图的分析,和训练里的 无关。
结果是,DAR 留下的噪声里有 22.4% 的一致性分不超过 0.87,也就是说,这部分噪声虽然 loss 不高,一致性分却偏低。DAR 压制的干净样本里有 19.6% 的一致性分高于 0.87,也就是说,这部分干净样本虽然 loss 偏高,一致性分却偏高。
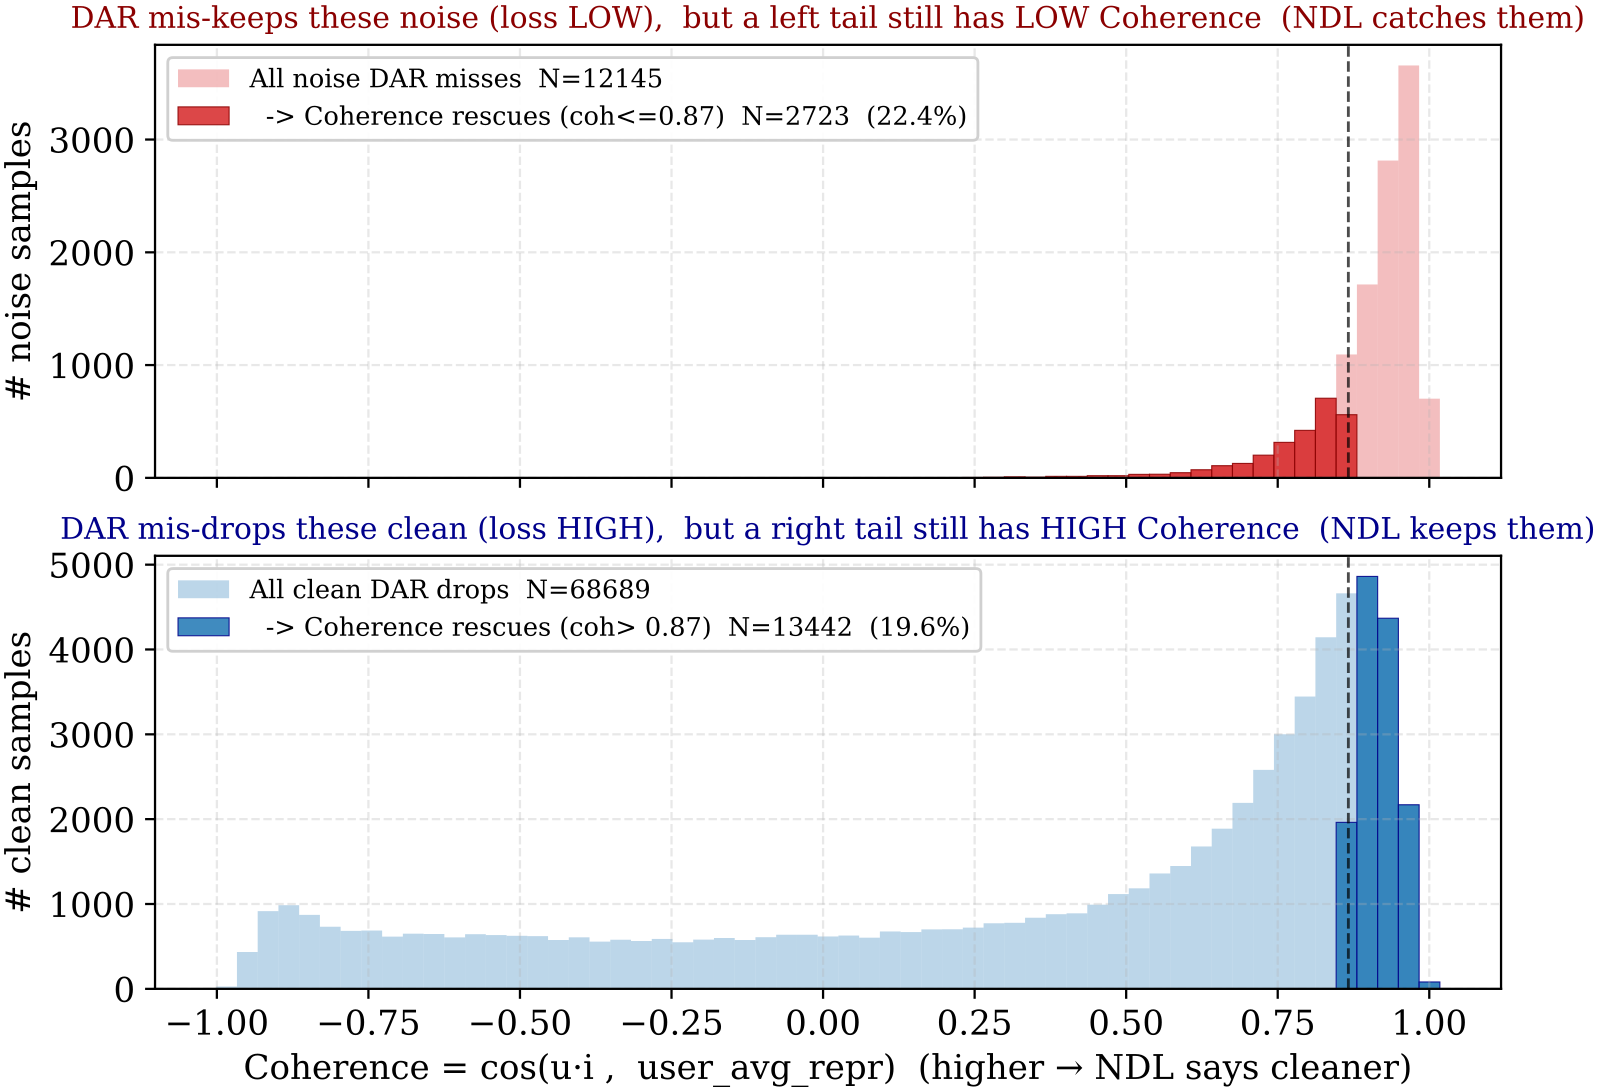
我的理解是,22.4% 和 19.6% 这两个比例要和 50% 比。如果一致性分和 loss 的错误毫无关系,用中位数切开时,每组大约一半会落在和 loss 判断相反的一侧。实际只有约五分之一,说明在这两组样本上,多数样本的一致性分落在和 loss 判断同一侧。作者称两个信号「正交互补」,这组数字我只看得出部分互补。放回做菜的例子:按这个比例,DAR 放过的噪声里,大约五条有一条的一致性分低于中位数。0.87 只是分析用的切线,这组比例说明两个信号有差异,不等于 NDL 训练时实际纠正了多少样本。
两个信号按用户的历史长短混合
一致性分依赖历史均值,而历史少的用户,均值本身就不稳。一位新用户只看过 10 部片,第 11 部换了类型,可能只是兴趣刚露出来,并不是误点。作者因此按用户活跃度混合两个噪声分:
是这位用户的交互数。 的算法是把这条交互 EMA 平滑后的 CE(交叉熵)loss 除以一个缩放常数(MovieLens 上取 5),再过 sigmoid,loss 接近 0 时它等于 。 是活跃度门槛,作者把它设在每个数据集用户交互数的中位数附近,MovieLens 取 50,Yelp 取 30,Amazon-book 取 25。
门槛不能随便定。MovieLens 上的调参显示,门槛设得太小,历史少、均值不稳的用户也会主要听 RCD,带来误判;设得太大,中等活跃的用户被迫主要听 loss,RCD 的好处就被稀释了。
示意:看过 60 部片的用户,,噪声分完全听 RCD,做菜点击的最终噪声分就是 0.73。看过 10 部片的新用户,。假设这位新用户点的一部悬疑片,交互向量和历史均值垂直,一致性分为 0,RCD 给 0.73;模型把这条样本预测得不差,loss 接近 0,loss 分支给 0.5。混合后是 。这说明历史少的时候,RCD 给的 0.73 只占两成权重,最终噪声分比纯听 RCD 时低,一次真实的新兴趣受到的处罚比纯听 RCD 时轻。
判成可疑之后,只少给几个维度
T-CE 整条丢掉的代价很直接:如果被丢的其实是那部冷门科幻片,这条信息就完全没了。R-CE 只是按比例缩小梯度,32 维的每一维仍然会被这条交互更新。DAR 的办法是让可疑交互只用前面一部分维度,NDL 沿用这个做法:
是 embedding 总维度, 是这条交互能用的维度数, 是用户 embedding 的第 维。把前面的科幻片、做菜视频、悬疑片三条交互都算完,结果如下(,示意)。
| 交互 | 一致性分 | 活跃度权重 | 最终噪声分 | 能用的维度 |
|---|---|---|---|---|
| 60 部科幻用户的一部科幻片 | 1 | 1 | 约 0 | 接近 32 |
| 同一用户误点的做菜视频 | 0 | 1 | 0.73 | 8 |
| 10 部片新用户的悬疑片 | 0 | 0.2 | 0.55 | 14 |
做菜视频是 ,悬疑片是 。求和只到第 8 维,所以做菜点击的预测分只由前 8 维决定,后 24 维既不进这条样本的预测分,也不会被这条样本的 loss 产生的梯度更新。这里限制的是这条点击作为训练样本的作用。如果冷门科幻片被误判成同样的噪声分,它还有 8 维可以继续训练,而在 T-CE 里它一维都用不上。
再加一个对比学习
一致性分靠余弦,余弦要有区分度,embedding 就得在空间里散得开,否则所有交互的余弦都接近 1。示意:如果所有内容都挤在同一个方向附近,科幻片的一致性分是 0.95,做菜视频是 0.90,两者几乎分不开。
作者因此加了一个对比学习,它只在训练 loss 里多加一小项。每个 batch 里的用户和内容 embedding 各做两次独立 dropout,同一个用户或内容的两个版本互相拉近,batch 内其他用户或内容被推远,loss 用 InfoNCE。这一项不产生噪声分,也不进混合,只以权重 加进总 loss。
这一项只能轻轻加。在 MovieLens 上, 时 Recall@5 最高,为 0.1126; 放大到 0.01 时掉到 0.1045,比完全不加对比学习的 0.1071 还低。这说明对比学习在这里只起辅助作用,权重大了反而有害。
NDL 的 Recall@5 比 DAR 高 5.63% 到 17.95%
实验用的噪声是人为划定的:三个公开数据集里,3 星以下的评分算噪声,只放进训练集,主实验的验证集和测试集只留 3 星及以上的交互。所有方法都用同一个 LightGCN,embedding 32 维,图传播两层。下表是 Recall@5,提升相对 DAR 计算;交互密度是实际交互数占「用户数×内容数」的比例。
| 数据集 | 交互密度 | LightGCN | DAR | NDL | 提升 |
|---|---|---|---|---|---|
| Amazon-book | 0.0342% | 0.0187 | 0.0273 | 0.0322 | +17.95% |
| Yelp | 0.0640% | 0.0229 | 0.0292 | 0.0328 | +12.33% |
| MovieLens-1M | 2.9586% | 0.1017 | 0.1066 | 0.1126 | +5.63% |
所有方法的 embedding 维度和骨干相同,这说明 NDL 对 DAR 的提升不是靠更大的模型容量换来的。数据越稀疏,相对提升越大。Amazon-book 和 Yelp 的 Recall@5 本身只有 0.03 左右,17.95% 在绝对值上是从 0.0273 到 0.0322。
光看总 Recall 还分不清涨的是哪类内容,作者为此单独做了一项诊断。这项诊断里,测试正样本按评分分成高分(3 星及以上)和低分(3 星以下)两组,用高分的 Recall@K 减去低分的 Recall@K。这个差越大,说明模型越偏向把高分内容排进前 K。在 MovieLens 上,NDL 的这个差在 K=10 时比 DAR 高 0.0118,K=20 时高 0.0137。这说明 NDL 的高分和低分召回差比 DAR 更大,也就是 NDL 的排序更偏向高分内容。
NDL 各个部件的贡献
作者在 MovieLens 上每次去掉 NDL 的一个部件、其余不变,看 Recall@5 掉多少。
| 去掉的部件 | Recall@5 | 相对完整 NDL |
|---|---|---|
| 无(完整 NDL) | 0.1126 | – |
| RCD 分支 | 0.1003 | -10.9% |
| 对比学习 | 0.1071 | -4.9% |
| loss 分支 | 0.1084 | -3.7% |
| 按活跃度混合 | 0.1103 | -2.0% |
去掉 RCD 跌得最多,0.1003 比没有任何去噪的 LightGCN(0.1017)还低。这说明在这套配置里,一致性分是对 Recall@5 贡献最大的部件。去掉 RCD 的版本同样只靠 loss 决定维度,却比 DAR 的 0.1066 低,所以这一行只说明从 NDL 里拿掉一致性分会损失多少,不能读成只靠 loss 的方法最多只有这个水平。
去掉对比学习后,NDL 只比 DAR 高 0.0005,所以在 MovieLens 上,完整 NDL 领先 DAR 的那 0.0060(0.1126 减 0.1066) 要一致性分和对比学习一起才拿得到。
作者把对 DAR 的差距归因于一致性信号,理由是骨干和维度都相同。NDL 比 DAR 还多了对比学习,这张表能支持的说法要窄一些:一致性分贡献最大,对比学习这一项也不能少。去掉 loss 分支损失 3.7%,说明 loss 在有了一致性分之后仍然有用。
历史少的用户混合权重更偏向 loss,为什么这些用户反而涨得最多?
作者把 MovieLens 用户按训练交互数等分成五档,每档约 1,000 人。这五档只用来画图,和 无关。图里 NDL 相对 DAR 的 Recall@5 提升,从最稀疏一档的 +15.90%,大体递减到最活跃一档的 +7.60%。这五档的提升都高于主结果表里 MovieLens 整体的 +5.63%,两组数字的统计口径对不上,所以这里只看趋势:越稀疏的用户,提升越大。
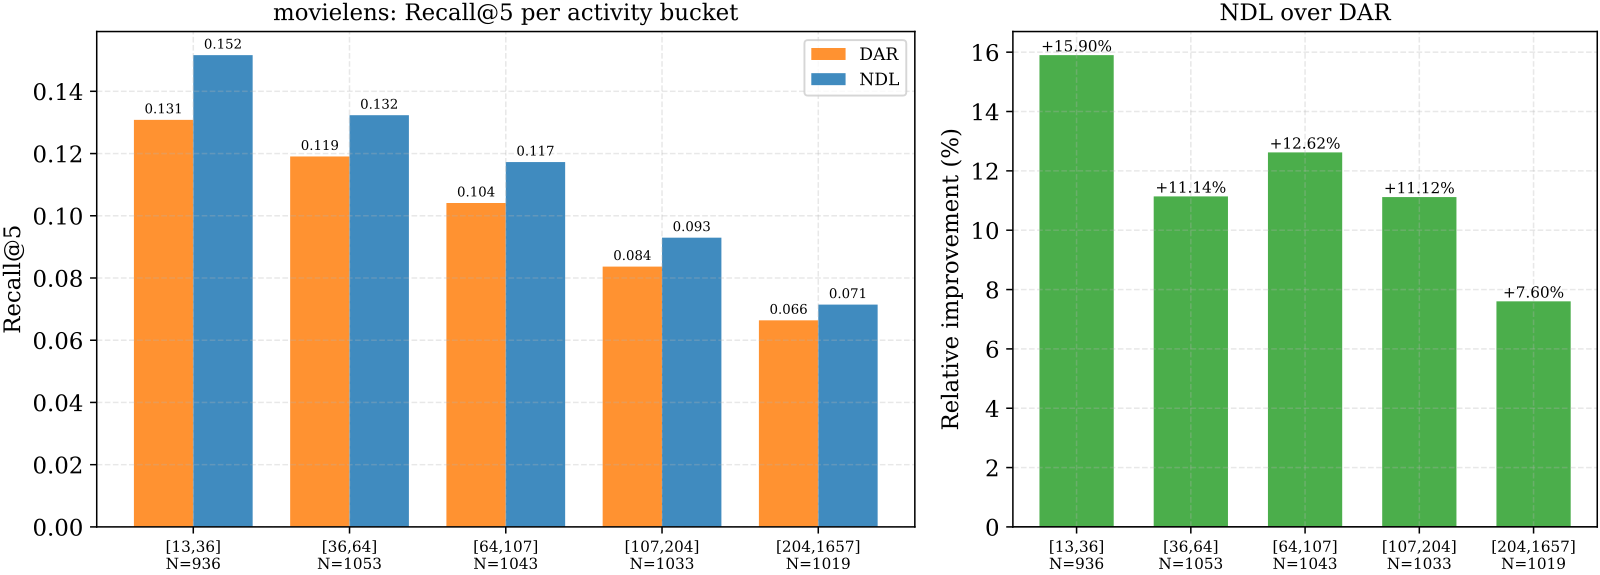
最稀疏一档的混合权重最偏向 loss,提升却最大,这说明混合权重偏向 loss 并没有让稀疏用户吃亏。作者的解释是,稀疏用户每条交互的分量重,一条噪声就足以带偏用户 embedding,活跃用户则有足够多的干净历史把噪声平均掉。这张图比的是完整 NDL 和 DAR,按它的趋势能说稀疏用户受益最大,说不出这部分提升有多少来自一致性分。
会判错的情况和上线的代价
一致性分假设用户的短期偏好是稳定的,也就是近期点的内容和过去点的内容朝同一类方向。示意:那位看了 60 部科幻片的用户,假如真的开始学做菜,这次点击的一致性分还是 0,活跃度权重还是 1。混合公式里 loss 分支的权重是 0,这次真实的新兴趣也只能用 8 维。
兴趣本来就分散的用户也会让一致性分变钝。示意:一位用户一半交互的 是 ,一半是 ,历史均值是 。此时科幻和做菜的一致性分都约为 0.71,比单一兴趣用户的 1 低。两类都是真实兴趣,所以偏离均值不再等于误点。作者把多兴趣用户留作后续工作。
工程代价集中在训练侧。线上只用训练好的 embedding,形状和存储与原来的 LightGCN 一样,不增加线上延迟、参数或内存。训练时多一张用户历史均值表和一份每条交互的平滑 loss,在作者的离线实验里,端到端训练时间比 LightGCN 多约 4.2%。作者的目标场景是网易新闻信息流,约 2000 万用户、800 万内容,模型目前还没有上线。
所以这篇的证据是公开数据集上的离线结果,噪声由低评分定义,手滑点击还没有线上数字。NDL 改动的只是训练环节:loss 只回答模型现在能不能拟合这条交互,NDL 再问一句这条交互像不像这位用户平时的样子。这一问加上小权重的对比学习,在同一个 LightGCN 上比只看 loss 的 DAR 多拿到 5.63% 到 17.95% 的 Recall@5。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…