
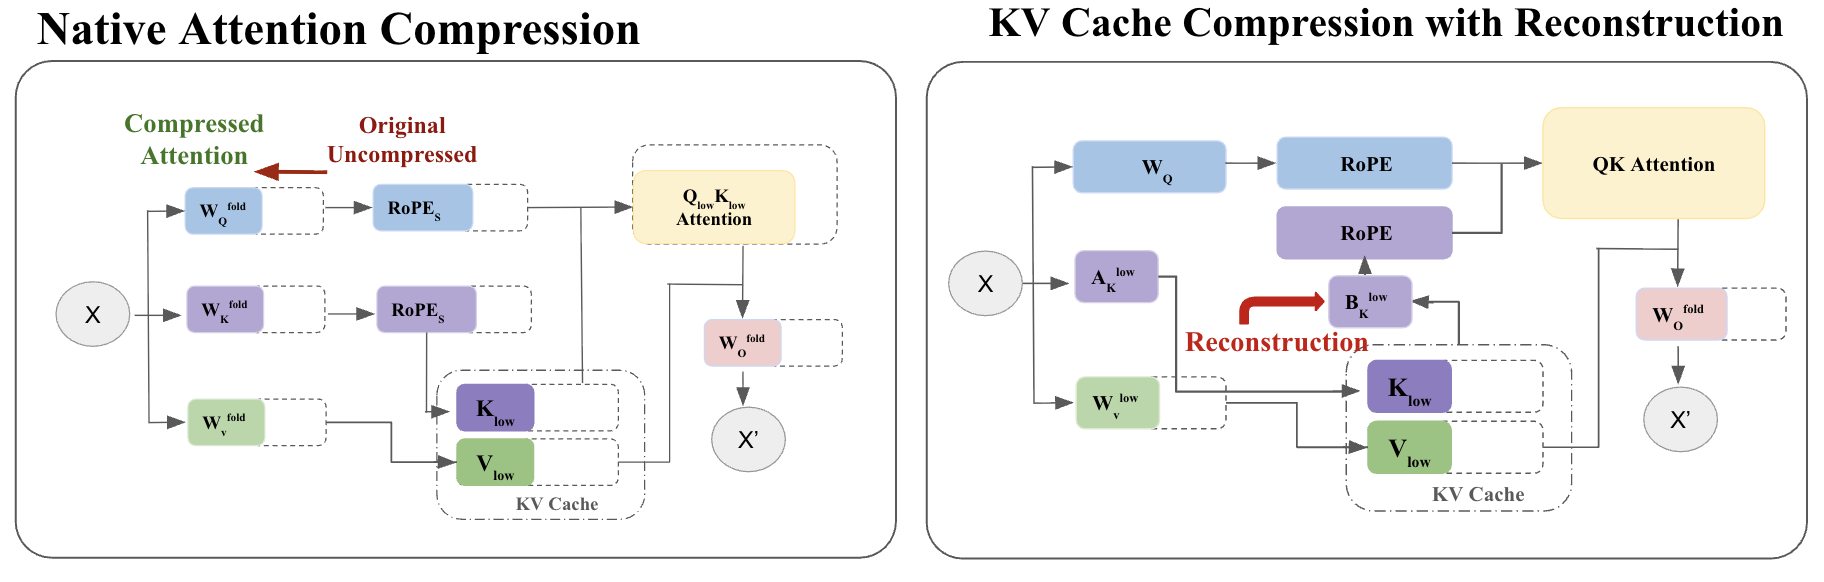
大模型处理长文本时,要把读过的每个词留下的中间结果存在显存里,这份“记忆”叫 KV cache。文本越长,它越大,到几十万字时往往比模型本身还占地方。压缩它有三个方向:少存几个词,降低每个数的精度,或者把每个词存的向量变短。第三个方向已有方法,但大多只省了存储:存的时候是短向量,真到计算时又得先还原成原来的长度,计算量反而暴涨,最多到原来的 22 倍。这篇论文的 RACE(RoPE-Aligned Attention Compression,与旋转位置编码对齐的注意力压缩)找到了一种不用还原的变短办法:只成对地保留模型位置编码要用的坐标,再把这个选择直接写进模型权重。这样存储、位置编码和注意力计算全都在短向量上完成,不需要改推理程序。在 Llama-3.2-3B 上,向量缩短一半、输入 25.6 万个 token 时,总计算量降 47.8%,整体吞吐提高到 1.79 倍,首字延迟降 43.2%。
1. 问题:省了存储,没省计算
先交代几个背景知识。注意力机制里,每个词会算出一个“查询”向量和一个“键”向量,两者做点积,得到这个词该多关注前面哪个词。KV cache 存的就是前面每个词的“键”和“值”向量。每个注意力头里这两个向量的长度叫“头维度”,常见的是 128。把头维度从 128 砍到 64,KV cache 就少一半。
难点在位置编码。现在的模型大多用 RoPE:向量里每两个相邻的数组成一对,按词的位置旋转一个角度。这样的每一对坐标,论文叫“旋转对”。
问题是,如果用一个一般的矩阵把键向量压短,这个压缩和旋转的先后顺序就不能交换:先压缩再旋转,和先旋转再压缩,结果不一样。而模型是按“先旋转”训练出来的。所以 EigenAttention、PALU(两种用矩阵压缩向量的方法)只好在每次计算前,先把短向量还原回 128 维,再做旋转。存储是省了,计算却多了一个还原步骤。论文统计,存储减半时,生成每个新词的计算量 EigenAttention 是原来的 11 倍,PALU 是 22 倍。
另外两种已有做法各缺一块。Thin Keys 不需要还原,但只压键向量、不动值向量,KV cache 只能省到 75%。同期的 RAP(一种结构化剪枝方法)也保留完整的旋转对,但它要算梯度来决定留哪些,需要反向传播,而且只看键这一边。
2. 方法:成对保留坐标,按“能量”挑
作者把目标说得很清楚:找一种把向量变短的办法,让短的查询和短的键做点积,结果尽量接近原来长向量的点积;同时这个办法必须能放在旋转之前做。由此推出两条原则。第一,查询和键要用同一种方式变短,因为点积是两个向量逐个坐标相乘再相加,两边的坐标必须对得上。第二,挑保留哪些坐标时,要同时看查询和键,因为要近似的是两者的乘积。
哪种变短的办法能放到旋转之前?论文证明了一个精确的条件。如果变短的方式是直接挑出其中一些坐标、丢掉其余的,那么它和旋转可以交换先后,当且仅当挑出来的坐标正好是若干个完整的旋转对,并且顺序不变。道理很直观:一对坐标在旋转时会互相混合,只留其中一个,就会丢掉另一个混进来的那部分。只要成对保留,在短向量上按原来的角度转,结果就和“先整体旋转、再挑坐标”完全一样。 Hoot 说

整对保留 (x₁, x₂)
- 先转后挑:(1, 2) 转 90°
- (−2, 1)
- 先挑后转:留下 (1, 2) 再转 90°
- (−2, 1)
两种顺序完全一样,所以挑选能折进权重、放在旋转之前。
只留 x₁
- 先转后挑:1·cos90° − 2·sin90°
- −2
- 先挑后转:只剩 1·cos90°
- 0
x₂ 贡献的 −2 丢了。所以 128 维压到 64 维只能在 64 对里整对挑 32 对。
一对坐标 (x₁, x₂) = (1, 2),旋转 90°,数字示意。 出处: 论文 §3:挑坐标与 RoPE 可交换当且仅当挑出的是完整旋转对;128 维压到 64 维保留能量最大的 32 对
接下来要决定留哪些对。作者在一小批通用文本上跑一遍模型,记下每个旋转对上查询和键的数值有多大,把两边数值的平方和加起来,作为这一对的“能量”。能量大,说明这一对对点积的贡献大。要把 128 维压到 64 维,就保留能量最大的 32 对。作者证明,丢掉一些对造成的误差,不会超过被丢掉的那些对能量之和的一半。所以按能量挑,正好让这个误差上限最小。作者也说明,这不等于让真实误差最小,只是一个只需跑一遍前向、计算很便宜的实用准则。
值向量不参与旋转,所以压缩起来没有这个限制。作者沿用 EigenAttention 的办法:从同一批数据里找出值向量变化最大的 64 个方向,只保留这些方向上的分量。
最后一步是把这些选择“折叠”进权重。挑坐标和找方向,本质上都是乘一个固定的矩阵,可以提前乘进模型里生成查询、键、值的那几个权重矩阵,以及最后的输出矩阵。结果就是一个普通的注意力层,只是头维度从 128 变成了 64。位置编码只对保留的旋转对做,每一对仍然用它原来的旋转角速度。之后的点积、加权求和全都在 64 维上算,用标准的 PyTorch 注意力就能跑,不需要专门写底层程序。
压缩得比较狠时,可以再做一步可选的“恢复训练”:用 100 万个 token 的通用文本,让压缩后的模型去模仿原模型的输出,只更新被改过的注意力权重,其余参数不动。保留 75% 时这一步帮助不大;保留 50% 时,能找回大部分损失的效果。
论文的核心贡献在于说清了“哪些压缩是合法的”。证明只有“成对保留”这一类能直接在短向量上做之后,问题就从“怎么还原”变成了“在合法的旋转对里挑哪些”。压缩后的模型就是一个头维度更小的标准模型,现有推理框架不用做任何修改。
3. 实验一:效果能不能跟上需要还原的方法
作者在 Qwen2.5-7B、Llama-3.2-3B-Instruct、Granite-4.1-3B 三个模型上,比较 RACE 和 PALU、EigenAttention、Thin Keys、RAP。看的指标有三个:语言建模能力(困惑度,越低说明模型越能预测下一个词)、15 个不经额外训练直接测试的常识任务的平均准确率,以及 16 个长文本任务(LongBench)的平均分。
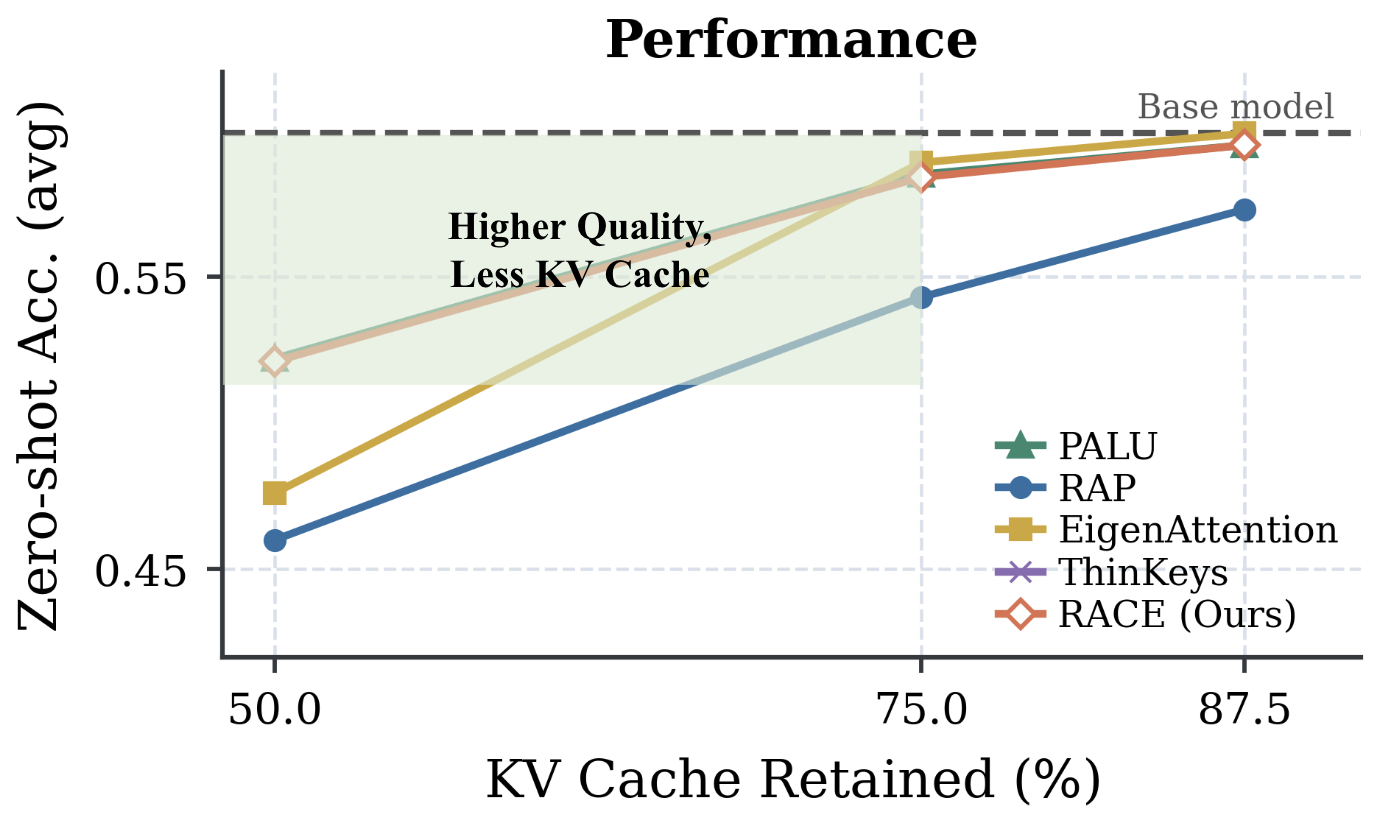
保留 75% 时,RACE 保住了原模型常识任务准确率的 96.5% 到 98.5%。各个压缩档位上,RACE 的常识和长文本分数都和 PALU 接近,但不需要计算时还原;它在所有档位都比 RAP 好,在保留 50% 和 75% 时困惑度最低。
下表比较五种方法在 KV cache 减半左右时的情况。“生成一个词的计算量”以原模型为 1:
| 方法 | 需不需要还原 | KV cache 保留 | 读完提示的计算量 | 生成一个词的计算量 |
|---|---|---|---|---|
| EigenAttention | 需要 | 50% | 0.75 | 11.42 |
| PALU | 需要 | 50% | 0.75 | 21.92 |
| Thin Keys | 不需要 | 75% | 0.75 | 0.75 |
| RAP | 不需要 | 50% | 0.5 | 0.5 |
| RACE | 不需要 | 50% | 0.5 | 0.5 |
4. 实验二:省下的存储能不能变成真实的速度
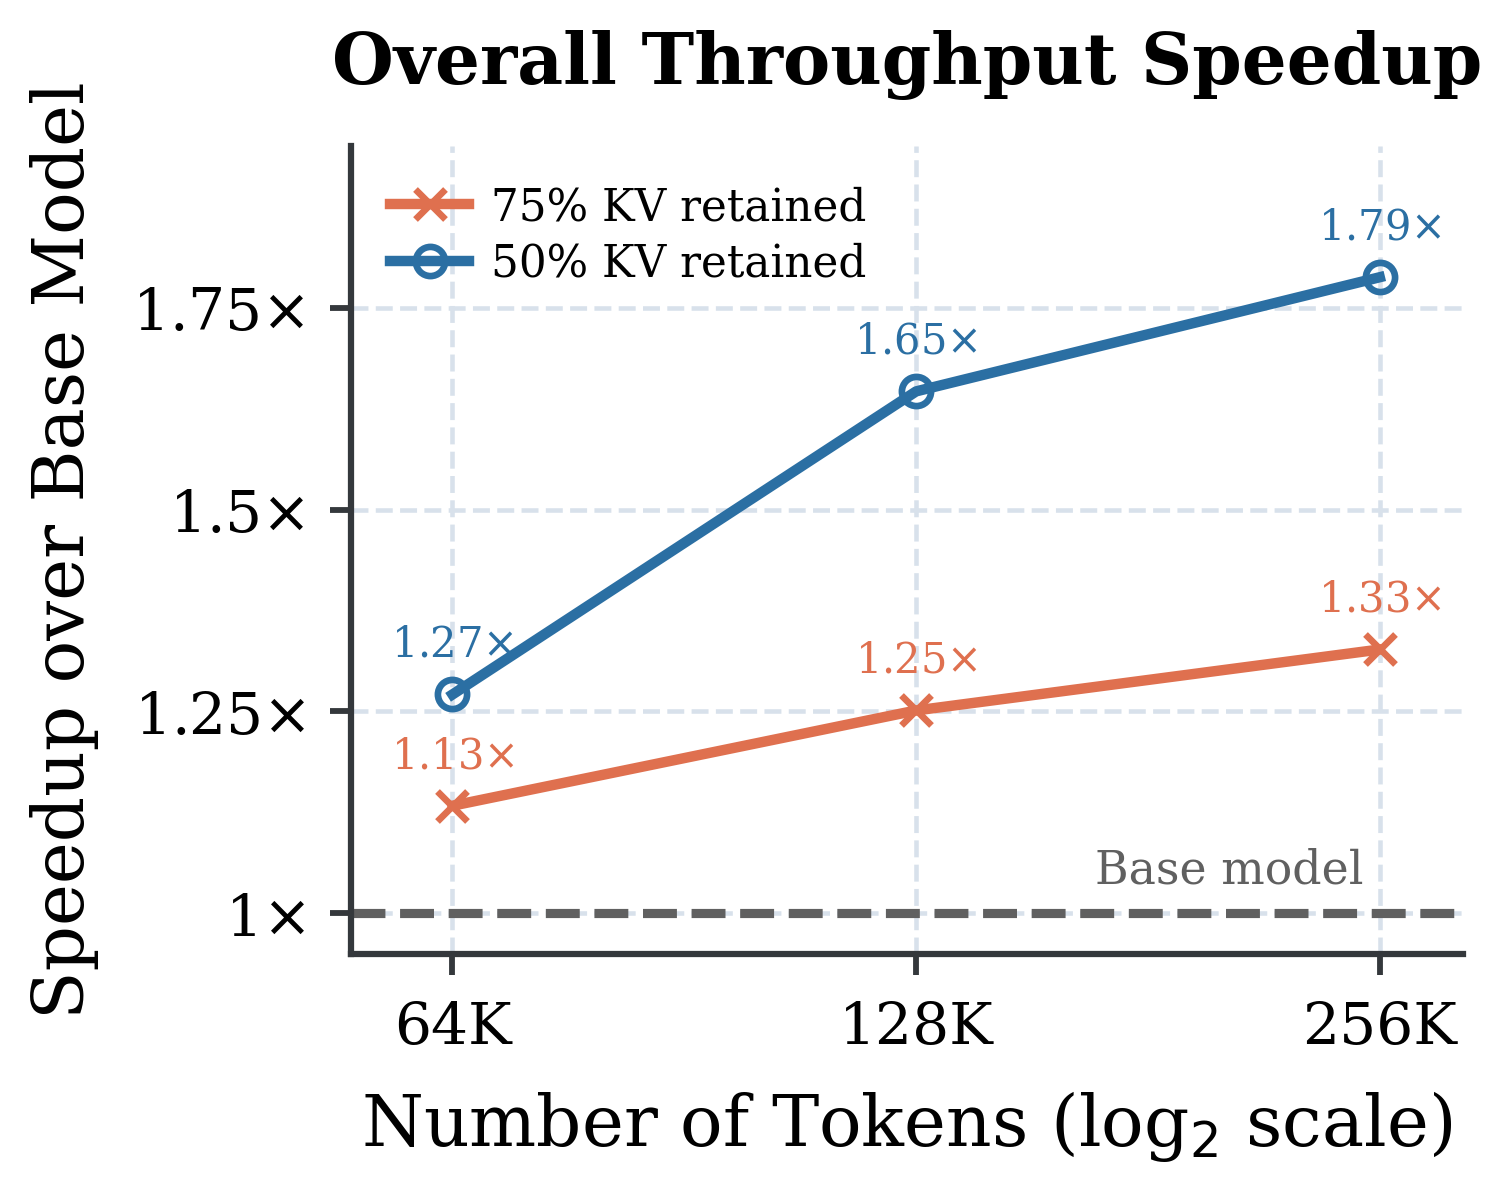
存储省了,不代表实际跑得更快,所以作者在 Llama-3.2-3B-Instruct 上实测了速度。提示长度分别是 6.4 万、12.8 万和 25.6 万个 token,每次输出 128 个 token,每组跑 10 次取平均。
提示越长,收益越大,因为文本越长,注意力在总计算里占的比例越高。25.6 万 token、保留 50% 时,读完提示的速度提高到 1.76 倍,逐词生成的速度提高到 1.90 倍,整体吞吐提高到 1.79 倍。显存只降了 28%,没有降到一半,因为显存里还有模型参数和其他中间结果,这部分不受影响。
作者还试了把 RACE 和其他压缩方法叠加:先用 RACE 保留 75%,再用 H2O 或 SnapKV 丢掉一半的词,或用 KIVI(一种降低 KV cache 数值精度的方法)把精度降一半,总共只剩 37.5%。叠加后的损失比单用 RACE 大,说明两种压缩的影响不是各算各的。三种组合里,和 KIVI 降精度叠加损失最小,困惑度尤其稳定。
另外三个发现也有参考价值。第一,用来计算“能量”的那批文本不必和下游任务相似:用通用文本和用任务数据,大多数任务的分数差距在 6% 以内。第二,同时看查询和键确实比只看一边好,近似误差更小,困惑度也最低;而且这种挑法很便宜,校准只要 2.7 秒,基于梯度的挑法要 8.3 秒。第三,作者从头训练了三个约 2.45 亿参数的小模型,总维度相同,只是头的数量和宽度不同。压缩得很狠时,头少而宽的模型保持得最好,因为每个头里可挑的旋转对更多。
5. 局限
作者自己指出了几点。按能量挑,让最小化的是误差的上限,不是真实误差。压到 50% 时需要一次恢复训练,不能完全免训练。和丢词类方法叠加时,两级压缩的损失会互相放大。论文的证明只覆盖“直接挑坐标”这一类变短方式;为了不用还原,它主动放弃了更一般的压缩矩阵,更大范围里有没有更好的办法,论文没有讨论。速度只在一个 30 亿参数的模型上测过,提示短于 25.6 万 token 时收益更小;更大的模型、或多个查询头共用一组键值的架构上效果如何,论文没有给出。
6. 实践意义
对长文本推理服务,RACE 最大的好处是部署简单:输出就是一个头维度更小的标准模型文件,vLLM、SGLang 这类推理框架不用改底层程序,还能和 KIVI 这类降精度方法叠加。可以先在自己的模型上保留 75% 做试点:用三万多个 token 的通用文本算能量,不做恢复训练,看长文本任务掉了多少。如果要压到 50%,就预留一次百万 token 量级的恢复训练。如果你在设计新的预训练模型,并且预计部署时要做这类压缩,头更少、每个头更宽的设计,会给后面的压缩留出更多余地。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…