
推荐系统在一排商品里放了某部电影,用户没点。系统该把这次记成“用户不喜欢”吗?如果用户根本没往右滑到那里,这条记录就是错的。大多数在线学习排序的算法分不清这两种情况,只能靠猜:先估计每个位置大概有多少人能看到,再把点击数按这个比例折算。这篇论文指出,在可以左右滑动的“轮播”界面里,其实用不着猜:手机或网页客户端本来就能记录用户这一次最远滑到了第几个位置。作者把这个信号用进排序算法:只拿用户确实看到了的位置来学习。在根据真实用户眼动数据搭建的模拟环境里,新算法 OD-TS 的表现和一个“提前知道每个位置被看到概率”的对手一样好,而它自己并不需要知道这些概率。
1. 问题:没点击,是不喜欢还是没看到
论文讨论的问题叫“排序老虎机”。名字来自赌场的老虎机:一排机器,每台出奖概率不同,你不知道哪台好,只能边玩边学。拉自己觉得最好的那台,叫“利用”;偶尔试试没把握的,叫“探索”。推荐里也是一样:每一轮给用户展示几个排好顺序的物品,根据有没有点击,更新对每个物品“有多吸引人”的估计,然后决定下一轮展示什么。
难点在于没点击的物品。已有的方法大致有两种处理。一种假设用户从上往下看,点了第一个喜欢的就走。另一种假设每个位置有一个固定的“被看到的概率”,越往后越低,然后用它折算。第二种方法既要估计每个物品有多吸引人,又要估计每个位置有多少人看到,两件事混在一起,学得就慢。
举个示意的例子。一部电影放在第 5 位展示了 1000 次,一次也没被点。如果第 5 位只有 8% 的人能看到,那真正被看到的只有大约 80 次。按位置折算的方法因为看不到每一次的深度,只知道“平均大约 80 次”,而且得先知道或估出这个 8%。如果日志能告诉你每次用户实际滑到了哪里,你就能准确挑出那 80 次,直接算这 80 次里的点击比例,干净又简单。
轮播和可滚动列表恰好能提供这个信息。客户端会记录这次实际显示到的最远位置,作者称之为浏览深度。浏览深度以内的位置,“点了”和“看到了没点”都确定;更靠后的位置这一次就不算数。这样,没被看到的物品就不会被错当成“不喜欢”。
2. 作者给问题定的规则
为了能做数学分析,作者给用户行为定了几条简化的规则:
- 一共有 50 个候选物品,每轮从中挑 5 个排好顺序展示;
- 用户一定会看第 1 个,之后依次往后看,在某个位置停下,停在哪里是随机的;
- 用户滑多远,和这一轮放了什么、怎么排无关;
- 每个被看到的物品,用户以一个固定但未知的概率去点它,点不点各物品之间互不影响,一轮可以点多个。
在这些规则下,最好的做法显然是把最吸引人的 5 个按吸引力从高到低排。但算法一开始不知道谁最吸引人,只能边展示边学。衡量算法好坏用的是“遗憾”:每一轮,如果一开始就知道最佳排法能拿到多少点击,减去算法实际拿到的,把这个差额一轮轮加起来。遗憾越小,说明算法学得越快、试错花的代价越少。
3. 三个算法:都只从“确认看到了”的位置学习
三个算法共用同一套记账方法:每一轮拿到浏览深度后,只给深度以内的物品各记一次“被看到”,被点了再记一次“被点击”。物品的吸引力估计就是“被点击次数 ÷ 被看到次数”。因为分母里只有确实看到的次数,这个比例不用再按位置折算。
三个算法的区别在于怎么在“利用”和“探索”之间取舍:
- OD-UCB 是 UCB:点击比例加上置信项,没被看过的物品得分无限大,一定会被试。每轮展示得分最高的 5 个,实现最简单。
- OD-TS 是 Thompson sampling。因为分母只有确认看到的次数,每个物品的后验一直是共轭的 Beta 分布,直接采样就行,每轮计算量很小。
- OD-DMED-L 平时就展示当前估计最好的 5 个;同时检查前 5 名之外的每个物品能不能断定比第 5 名差:用它被确认看到的次数,乘以它和第 5 名的点击率之间的 KL 散度(把两个点击率各看成一个伯努利分布,算两者差多远)。乘积小于 ,说明看到的次数还太少、差距也不够大,证据不够,就把它排进队列,下一轮放在第 5 个位置上试一次。试错只花在没把握的地方,所以理论上最省。
三个算法有一个共同点:真正需要分辨的,只是某个物品能不能挤进前 5,也就是它和第 5 名差多少。前面几名之间谁高谁低,对“该不该展示”影响不大。
4. 理论结果说明了什么
作者证明了三件事,这里只讲它们的意思。
第一,任何算法都免不了一定的试错代价。在这套规则下,遗憾至少随轮数的对数增长,也就是轮数翻十倍,遗憾只多出一截固定的量。这个最低限度由“前 5 名之外的物品和第 5 名差多少”决定:差得越小,越难分辨,代价越大。
第二,OD-UCB 的遗憾也只按对数增长。作者把它和一个“已知各位置被看到概率”的同类算法(PBM-UCB)的理论上界做了比较。当第 5 个位置很少有人看到时,PBM-UCB 的上界会急剧变差,因为它得通过很少的有效观测去折算;OD-UCB 用了真实深度,就没有这个问题。不过作者也承认,OD-UCB 的上界还不够紧,不是最优。
第三,OD-DMED-L 在长期看能做到理论上最好:它的遗憾增长速度可以任意接近第一条里的最低限度。
5. 实验:和“提前知道答案”的对手比
实验在三种模拟环境里各跑 50 万轮,每轮从 50 个物品里选 5 个展示。
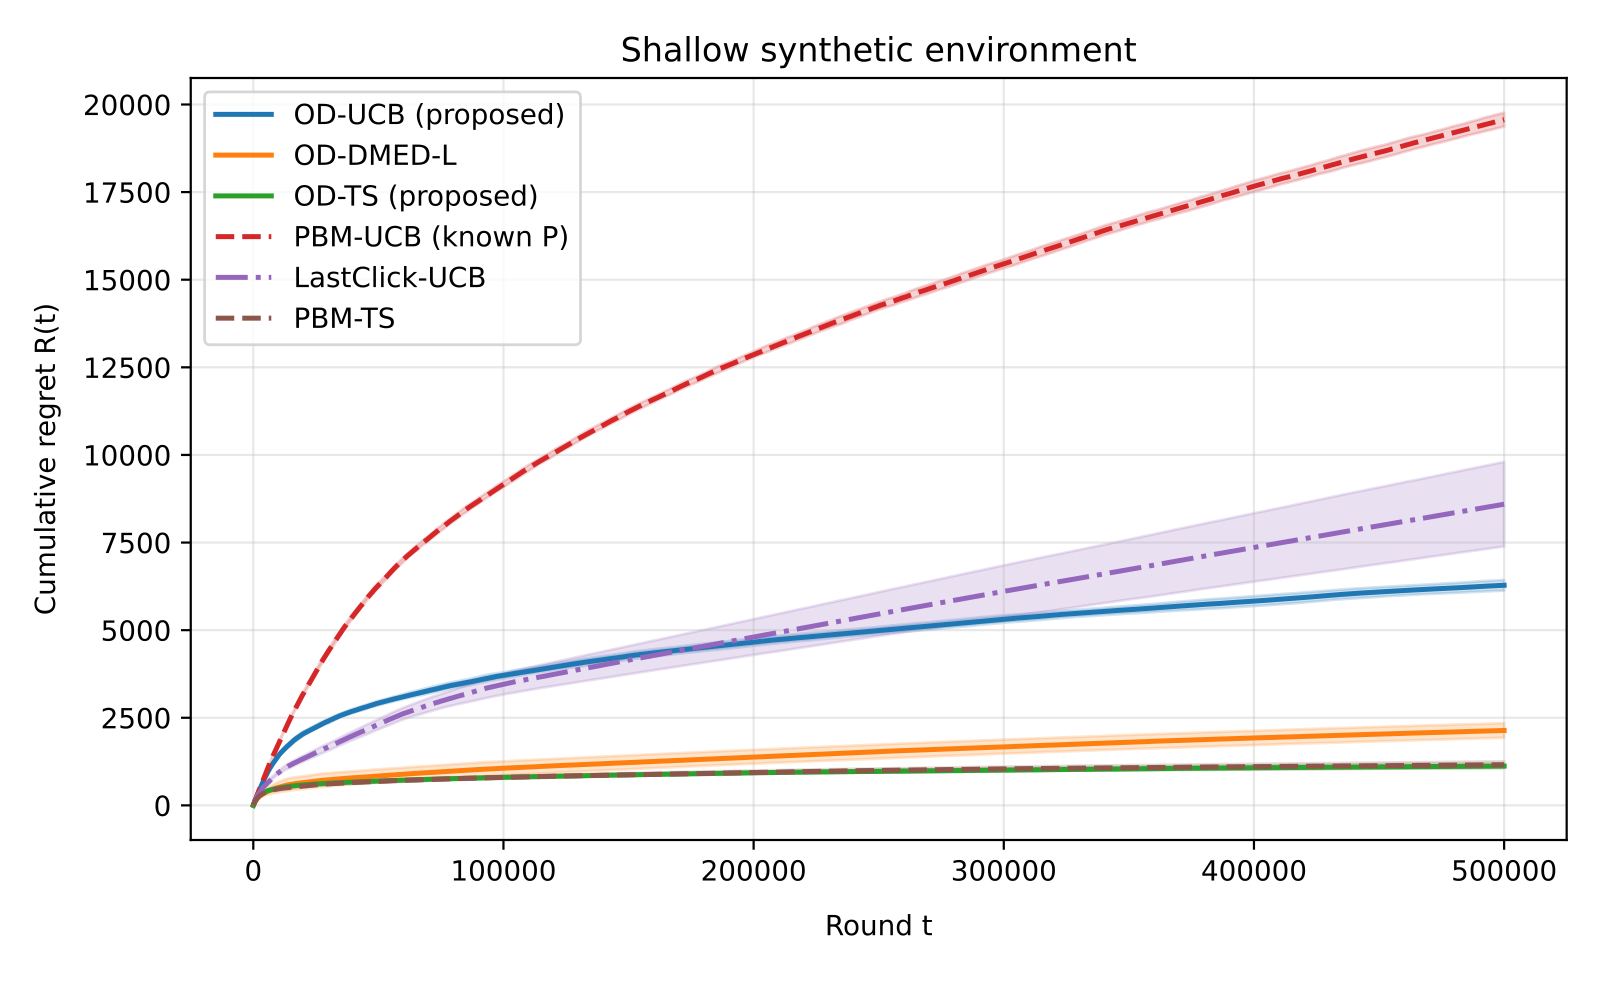
- “浅浏览”环境:用户大多只看前一两个,第 5 位只有 8% 的人能看到。
- “深浏览”环境:用户普遍往后看,第 5 位也有一半的人能看到。
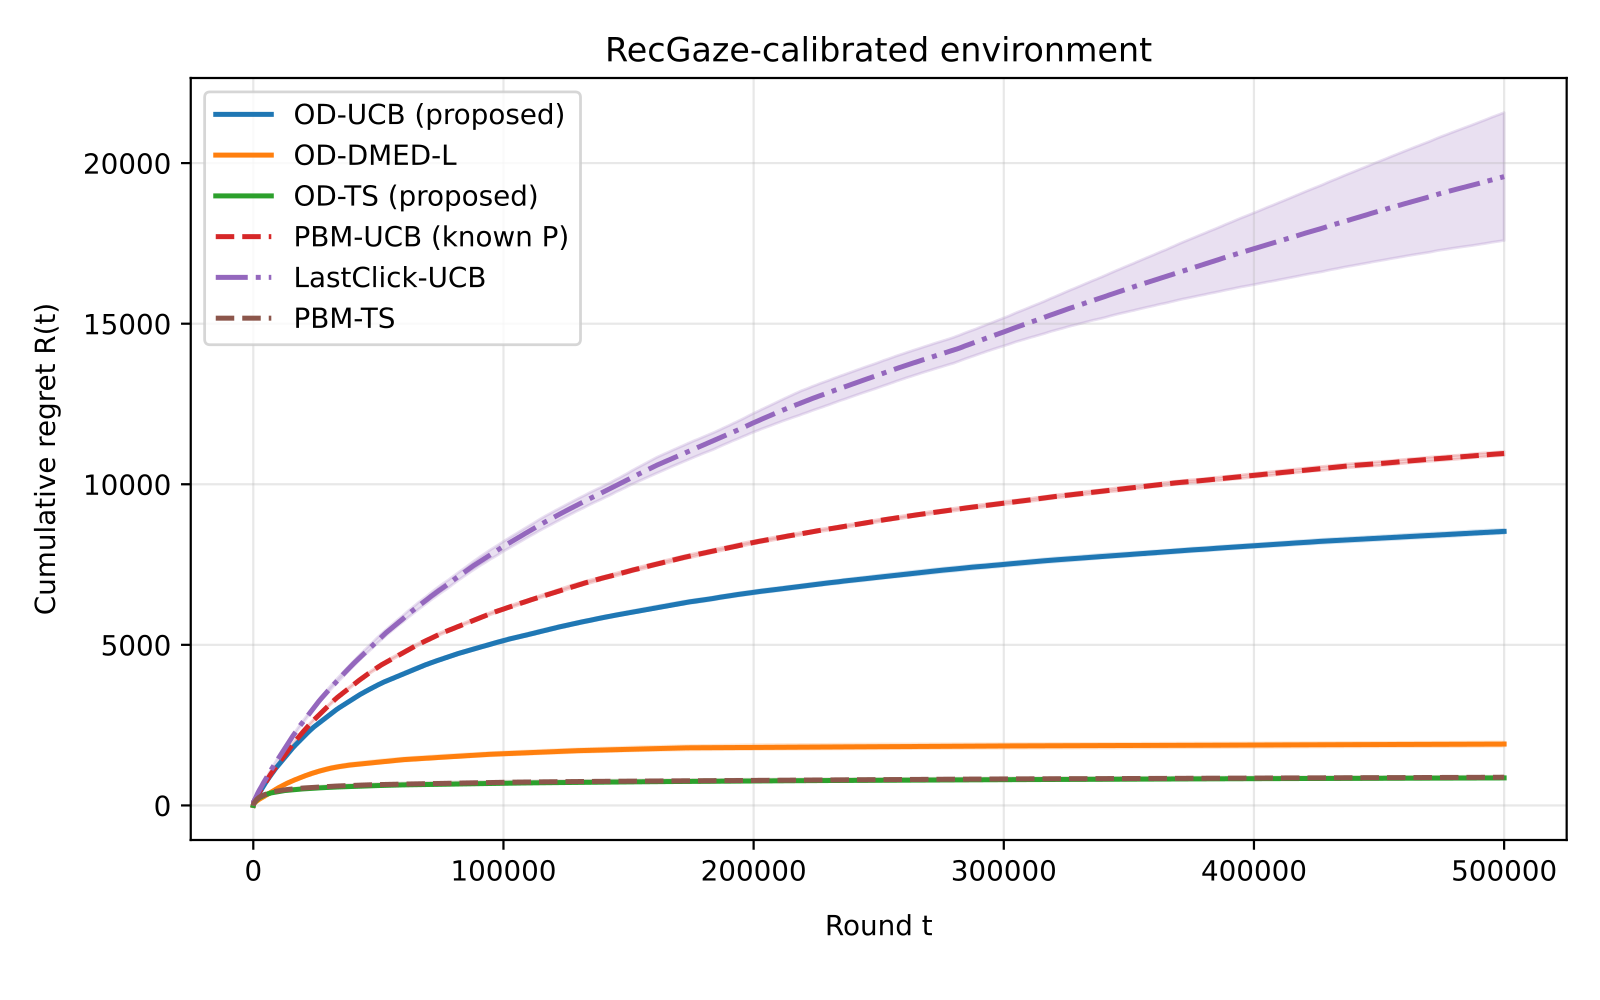
- RecGaze 环境:参数来自一个真实数据集。87 名参与者在轮播界面里挑电影,研究者记录了他们的眼动、点击和鼠标轨迹。作者从中估出各位置被看到的概率和各电影被点击的概率,再用它们来模拟用户。
对比的算法有三个。PBM-UCB 和 PBM-TS 是按位置折算的老方法。为了让它们处在最有利的位置,作者直接把真实的“各位置被看到概率”告诉它们,但它们看不到每一次的实际深度。LastClick-UCB 是一种常见的土办法:把最后一次点击及之前的位置都当作“看到了”,一次都没点时就当整排都看到了。
50 万轮后的累计遗憾(越小越好):
| 方法 | 浅浏览 | 深浏览 | RecGaze |
|---|---|---|---|
| OD-TS(本文) | 1,122 | 1,327 | 856 |
| PBM-TS(提前知道各位置被看到的概率) | 1,160 | 1,357 | 877 |
| OD-DMED-L(本文) | 2,137 | 4,007 | 1,911 |
| OD-UCB(本文) | 6,281 | 8,762 | 8,532 |
| LastClick-UCB | 8,595 | 9,819 | 19,581 |
| PBM-UCB(提前知道各位置被看到的概率) | 19,568 | 12,226 | 10,959 |
最重要的结论是:OD-TS 和 PBM-TS 打成平手,三个环境里两者的差距都在随机波动范围之内。可 PBM-TS 是被“喂了答案”的,现实里没人知道每个位置的真实被看到概率;OD-TS 不需要这个答案,计算也更简单。作者特别指出,PBM-TS 每轮要用一种比较费事的抽样方法,OD-TS 不用。
另外两点也值得注意。第一,三个用真实深度的算法,在所有环境里都比 PBM-UCB 和 LastClick-UCB 好。这说明拿到真实深度后,连最简单的乐观策略也能赢过老方法。第二,用户越不爱往后看,真实深度的价值越大:PBM-UCB 的遗憾在浅浏览环境是 OD-UCB 的约 3.1 倍,在深浏览环境只有约 1.4 倍。原因很直观:越靠后的位置越少人看,按概率折算时误差越大。
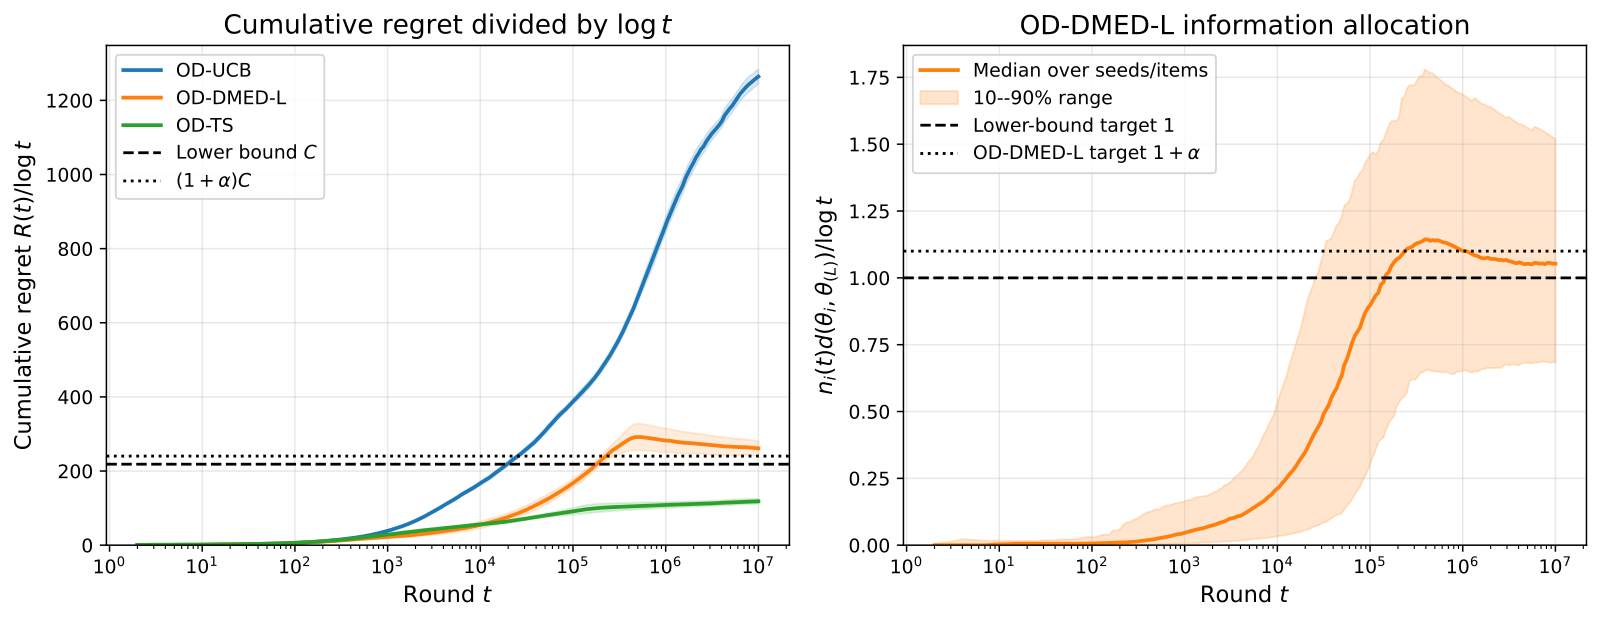
作者还把深浏览环境跑到 1000 万轮,检验 OD-DMED-L 是不是真的会向理论最低限度靠拢。结果是在靠拢,但很慢:它的“遗憾 ÷ 轮数的对数”在 50 万轮左右达到最高,之后一路下降,到 1000 万轮时离理论值还差约 9%。这也解释了为什么在 50 万轮的实验里它不如 OD-TS:理论上最好,指的是很长期的表现,短期内抽签式的 OD-TS 更实用。
6. 局限与实践意义
作者说明了几点局限。点击被假设为互不影响,浏览深度被假设与展示内容无关。现实中这一条可能不成立:前面放了特别吸引人的内容,用户可能更愿意往后滑,也可能点完就走,论文没有处理这种情况。RecGaze 实验是用真实数据设参数的模拟,不是线上实测,不能证明真实用户下效果如何。少数电影点击率特别高,可能和实验任务本身有关,而不是电影本身更吸引人。RecGaze 里用户看得比深浏览环境还深,所以那里的差异不能只归因于浏览深度。作者计划放宽这些假设,并做线上验证。
对做推荐的团队,最直接的启示是先查一查日志里有没有浏览深度。很多轮播、横滑和信息流客户端本来就上报了可见位置或滚动深度,但离线训练和在线探索仍然把“展示了但没被看到”的物品当成“不喜欢”。在需要边推荐边学习的场景,比如新物品冷启动,可以只用确认看到的数据来更新,再用 OD-TS 这种抽签方式选物品。它实现简单,不用估计位置效应,论文里效果和“提前知道答案”的老方法相当。
落地可以分三步。第一,在日志里把每次展示的最远可见位置存成一个字段,并和点击事件对齐。第二,离线统计各位置有多少人看到,看衰减有多快;衰减越快,改用确认数据的收益越大。第三,先在一小部分探索流量上替换更新方式,和现有方法比较累计点击。上线时还要检查不同排法下用户滑动的深度是否稳定,因为论文假设两者无关。在越往后越少人看的界面上(例如手机上的横滑),这个信号的价值最大。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…