
投机解码的做法是:先让一个小的草稿模型连猜几个 token,再让大模型一次性并行核对,猜对几个就收下几个。每轮平均收下的 token 数叫“接受长度”,它越长,大模型需要跑的轮数越少,生成就越快。草稿模型一般用蒸馏来训,也就是让它的输出分布尽量贴近大模型。海信的这篇论文认为这个目标选错了:核对时只看草稿给的 token 是不是大模型也会选的那个,草稿把排在最前面的几个候选排对就够了,不必把整个分布学像。作者提出的 RCSD(用强化学习继续训练草稿模型的框架)先用常规方法训好草稿模型,再用 DPO 或 GRPO 继续训练,训练数据全部由大模型自己生成,不需要人工标注,也不需要额外的奖励模型。在 Qwen3-1.7B 和 Llama-3.1-8B 上,接受长度在所有测试设置中都超过基线。不过论文摘要里的“平均提高 35%”和“端到端快 1.35 倍”,用正文自己的表格核算对不上,下文会具体说明。
1. 问题:草稿模型学的东西和它要做的事不一致
这篇论文的对照组只有一个,要先交代清楚。EAGLE 的草稿模型很小,除了看已经生成的 token,还直接读大模型的隐藏状态来猜下一个词。HASS(在 EAGLE 上训练草稿模型的一种蒸馏方法)就是对照组,RCSD 也是从训好的 HASS 草稿模型接着训。
蒸馏的损失是前向 KL 散度。它的特点是“全都要”:大模型认为有一点点可能的 token,草稿模型也得分一些概率过去,否则就会被罚。问题在于草稿模型比大模型小几个数量级,没有足够的容量把整个分布学像。于是它的容量被摊到了大量根本不会被选中的低概率 token 上。
作者用下图说明这种错位。接受与否只取决于草稿最看好的 token 和大模型最看好的 token 是否一致。左下角是理想情况:分布贴得近,最高点也对上了。右下角草稿的分布和大模型差得很远,KL 损失很高,但最高点仍然对齐,所以照样被接受。上面两幅则相反,最高点错开了,不管 KL 高低都会被拒。换句话说,KL 损失只是接受率的一个间接代理,而且是不太准的那种。
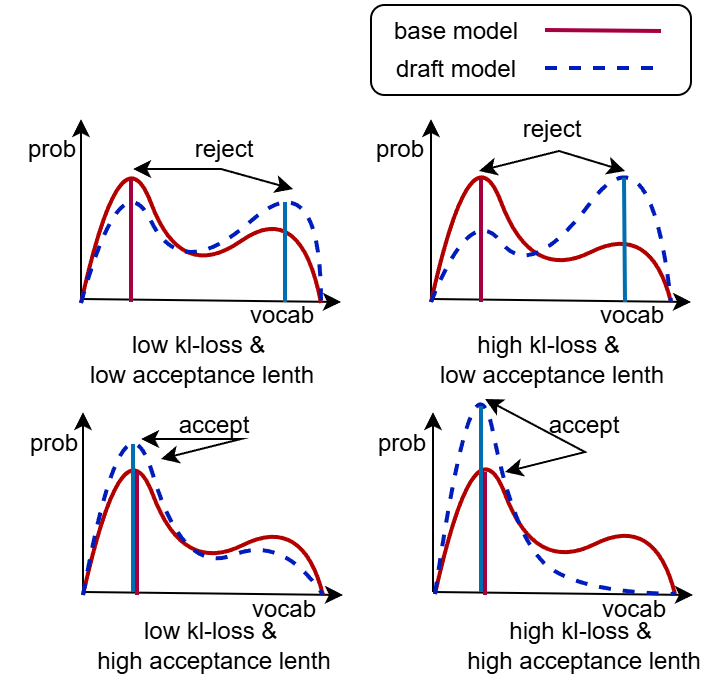
由此作者把目标改了:不再要求草稿“模仿整个分布”,而是让它把概率集中到大模型最可能选的那条路上,宁可放弃分布尾部。用论文的话说,从覆盖所有峰(mode-covering)改成只抓主峰(mode-seeking)。
2. 方法:拿大模型自己的输出当正例
两种训练方式都从训好的 HASS 草稿模型出发,并把这份初始权重冻结一份作参考,防止新模型偏得太远。
DPO 版需要成对的“好”与“差”序列。好的那条完全由大模型逐个 token 生成,代表草稿理想中应该猜出来的内容。差的那条是交替生成的:大模型先写 1 个 token,然后草稿模型不经核对、连着写 k 个,再换回大模型写 1 个,如此循环(DPO 版里 k 取多少,论文没有写明)。草稿自己写的部分往往会慢慢偏离大模型会写的内容,所以这条序列自然就是反例。训练时让草稿对好序列的概率相对参考模型上升,对差序列的概率下降。
这里有一个细节很关键:差序列里由大模型写的那些 token 在计算损失时被屏蔽掉。如果不屏蔽,训练会把这些本来就正确的 token 也当成错误来压低。另外,DPO 对序列长度敏感,所以好序列上也用了同样的屏蔽位置,保证两边比较的 token 数一致。
GRPO 版不再只比一对,而是对同一个提示准备一组序列:一条由大模型直接生成,另外三条由两者交替写:大模型写 1 个 token,草稿接着不经验证连写 个,再轮到大模型, 分别取 1、2、3。每条序列的得分由两部分相加,两部分都先在组内做标准化:一是大模型认为这条序列有多自然,用大模型给它的对数概率衡量,也就是每个 token 概率取对数后求和;二是这条序列里草稿写的 token 被大模型接受的比例。大模型直接生成的那条没有草稿 token,论文没有说明它这一项怎么算。组内得分高于平均的序列被加强,低于平均的被削弱。
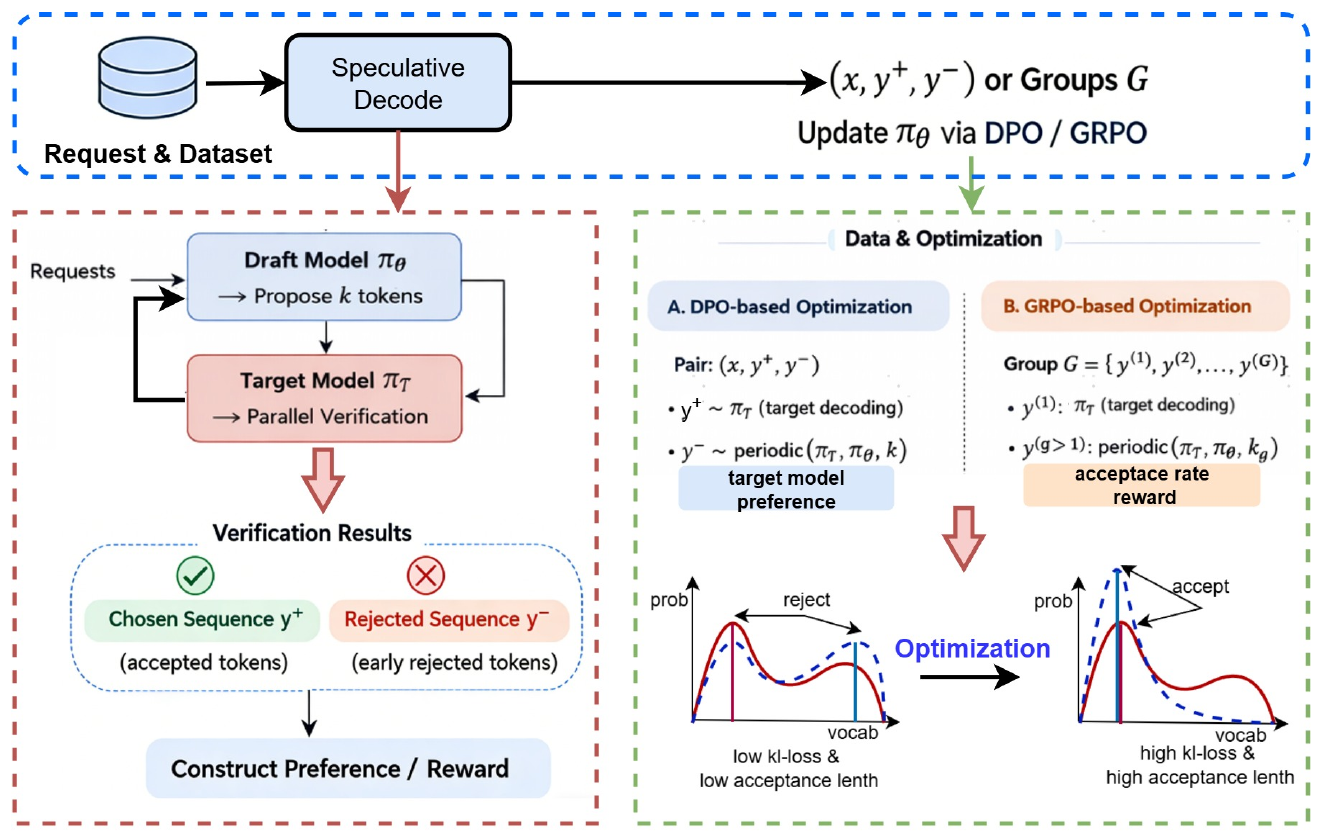
两种方法的共同点是:正例、反例和分数全部由大模型自动给出,数据可以从线上请求或任意文本提示里批量构造。这也是标题里“持续学习”的出发点:上线后可以不断用新请求继续训练草稿。不过正文并没有做这类实验,后文会再提。
3. 结果一:接受长度在所有设置里都变长了
训练数据是 ShareGPT 对话的 90%。测试用 HumanEval(代码)、MT-Bench(多轮对话)、GSM8K(数学)和剩下的 ShareGPT,所以只有最后一个和训练数据同分布,这一点后面会用到。“步数”指每轮草稿连猜几个 token,测了 3 到 6。下表是按论文表 1、表 2 算出的四个测试集平均接受长度:
| 模型 | 步数 | HASS | HASS + DPO | HASS + GRPO | GRPO 相对提升 |
|---|---|---|---|---|---|
| Qwen3-1.7B | 3 | 2.12 | 2.57 | 2.57 | +22% |
| Qwen3-1.7B | 6 | 2.26 | 2.97 | 3.00 | +33% |
| Llama-3.1-8B | 3 | 2.47 | 2.72 | 2.74 | +11% |
| Llama-3.1-8B | 6 | 2.78 | 3.26 | 3.29 | +18% |
从这张表可以读出三点。
第一,提升是稳定的。两个模型、四个数据集、四种步数共 32 个组合,DPO 和 GRPO 都比 HASS 长,没有一个例外,所以这不是挑出来的好结果。
第二,猜得越多,提升越大。Qwen3-1.7B 在 GSM8K 上,步数 3 时提升 31%,步数 6 时到 49%。原因是接受是连锁的:第一个 token 被拒,后面的就全部作废。草稿每一步的命中率只要提高一点,连猜 6 个时被一路接受的概率就会放大。这意味着如果你的部署本来就用较长的猜测步数,这个方法的收益会更明显。
第三,GRPO 和 DPO 几乎打平。两者在平均值上最多差 0.03,单个数据集上也大多在 0.05 以内。GRPO 每个提示要生成四条序列,DPO 只要两条,所以从投入产出看 DPO 更划算。论文结论里说 GRPO 在训练早期收敛更快,但没有给出对应曲线。
还要注意两个模型的差别。Qwen3-1.7B 提升明显,Llama-3.1-8B 在代码、对话和数学上只提高 6% 到 11%,只有 ShareGPT 提高 24% 到 43%。ShareGPT 正是训练数据所在的分布,所以 Llama 上的大幅提升有一部分可能来自“训练和测试是同一种数据”,而不全是训练目标改对了的功劳。
4. 结果二:速度提升没有摘要说的那么大
接受长度变长要换成实际速度才有意义。作者在 SGLang 5.5.0 上用 Llama-3.1-8B-Instruct 测了每秒输出 token 数,结果如下(论文没写这组用的步数,图中的接受长度和上表步数 3 的数值一致):
| 数据集 | 不用投机解码 | HASS | HASS + DPO | HASS + GRPO | GRPO 比 HASS |
|---|---|---|---|---|---|
| HumanEval | 90.7 | 163.1 | 173.1 | 173.8 | 1.07 倍 |
| MT-Bench | 90.6 | 134.2 | 141.9 | 143.1 | 1.07 倍 |
| GSM8K | 90.8 | 150.5 | 159.7 | 160.3 | 1.07 倍 |
| ShareGPT | 90.2 | 142.3 | 176.1 | 176.6 | 1.24 倍 |
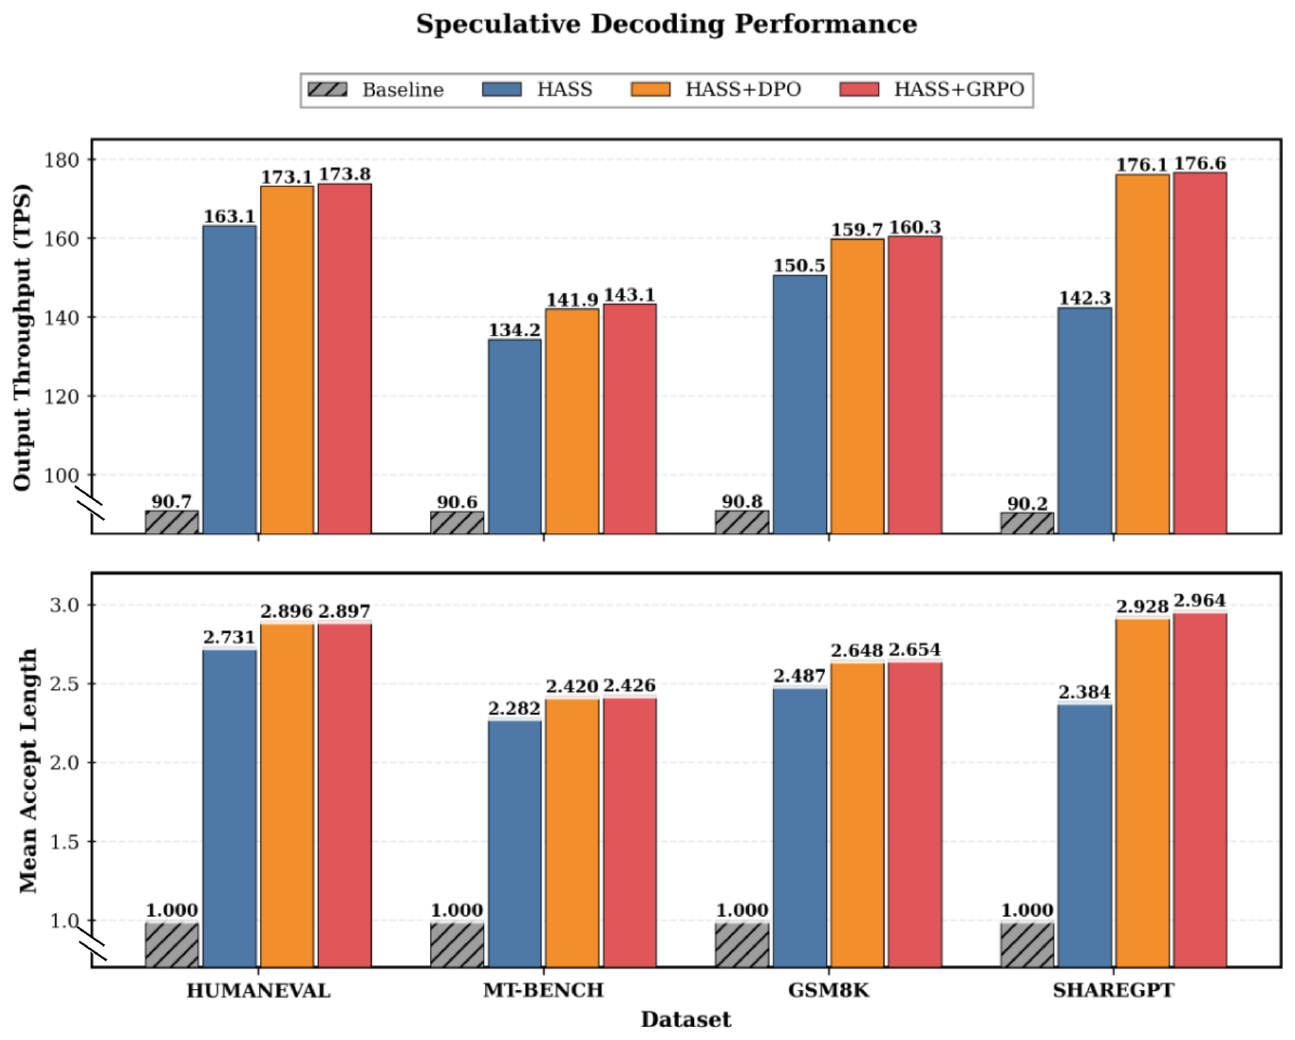
最后一列是按表中数字算的,它说明速度收益主要来自同分布数据。在三个通用测试集上,新方法只比 HASS 快约 7%;只有在 ShareGPT 上快 1.24 倍。
摘要里的“比 HASS 快 1.35 倍”在这张图里找不到对应数字,结论部分又写成“1.2 到 1.35 倍”,两处说法也不一致。“接受长度平均提高 35%”也只在 Qwen3-1.7B 步数 6 附近勉强对得上,那里是 33%。Llama-3.1-8B 的平均提升只有 11% 到 18%,所以这两个宣传数字应当看成最好情况,而不是平均水平。
接受长度提升 11%,速度却只快 7%,这个差距也合理。每一轮除了草稿猜测,还有大模型核对和调度开销,这部分不会因为猜得更准而变少。所以接受长度的提升要打个折扣才能变成吞吐。
5. 论文没有回答的问题
- 质量没有测。论文多次说“不影响生成质量”。按投机解码的标准核对规则,最终输出确实由大模型决定,理论上应该如此。但实验部分没有任何质量指标,在采样温度不为 0 或用了近似核对的部署里,这一点需要自己验证。
- 标题里的“持续学习”和“特定领域”都没有实验。训练和测试都是通用数据集,没有做“上线后用新请求不断训练”的实验,也没有某个垂直领域的评测。
- 方法描述前后有出入。Figure 3 左侧说正例和反例来自核对时被接受和被拒绝的 token,而方法章节写的是“大模型单独生成”对“大模型与草稿交替生成”。实验用的是后者。
- 缺少成本数据。论文没报告构造数据和继续训练要花多少 GPU 时间,也没和其他非蒸馏的草稿训练方法比较,只和 HASS 一个基线比。
- 吞吐只测了一组配置:一个模型、一个推理框架、一种步数,没有测不同并发下的表现。
6. 实践意义
如果你已经在线上用 EAGLE 或 HASS 类的草稿模型,这篇论文给出一个成本不高的后续步骤:用大模型对线上或离线提示生成一批回答,再按“大模型单独写”和“大模型与草稿交替写”构造正反例,对现有草稿模型做一轮 DPO。整个过程不需要标注,也不改推理代码。
预期收益要按自己的流量来估。如果训练数据和线上请求同分布,接受长度可能提高两成以上,吞吐提高一到两成。如果分布不同,按论文在 Llama 上的通用测试集结果,吞吐大约只多 7%。GRPO 比 DPO 多花一倍的生成成本,收益几乎相同,可以先不做。上线前需要自己补上论文缺的两项检查:输出是否与不开投机解码时一致,以及继续训练的 GPU 开销。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…