目录 · 9 节
1它到底在解决什么问题?2一个任务长什么样3评测怎么搭起来的4结果一:说出的时机影响最大5结果二:要问才说的任务,输在不问6结果三:有隐藏要求的任务,输在不验证7我认为它的局限8一个推荐团队可以怎么试9评价
做对话式推荐 agent 的人值得读:它把用户什么时候说出需求单独当成变量,测出了 agent 最常见的两种失败。对话式推荐难在用户不会一开口就把要求说全。τ-Rec-Books 固定同一个找书请求,只改变用户什么时候说出要求:一开始全说,开头说一条、其余等问了再说,或者有些要求始终不说。不说的要求只能靠先提几本书、看用户接受还是拒绝来推断。在有解的任务上,四个 agent 的平均成功率从全说时的 0.975 掉到要问才说时的 0.756,有隐藏要求时只剩 0.283。要问才说的任务失败,主要因为 agent 根本不问。在提示词里明确要求它提问,成功率就回到 0.93 以上。隐藏要求的任务里,agent 常把从没给用户看过的书直接当成答案。评估推荐 agent,要看它会不会主动问,会不会用拒绝来排除可能的要求。
我的判断:这篇的价值在于把“用户什么时候说出要求”从一个模糊的难点变成了可以单独测量的变量。同一个请求只改说出的时机,成功率的差距就比换检索接口、换目录大小大得多。这给评估推荐 agent 提了一个具体要求:不能只测用户一次说全的情况。
它到底在解决什么问题?
真实用户很少一开口就把要求说全。作者统计了 ReDial 里 11,348 段真人推荐对话:用户第一次提到类型、年代、产地这类要求时,只有 36% 是主动说的,52% 是被问到才说,12% 是看到推荐之后才说。
已有的对话推荐评测大多没把这件事当成变量。同一个找书请求,用户一次说全和问了才说,对 agent 是两种完全不同的任务。τ-Rec-Books 把它单独拿出来测。
一个任务长什么样
论文用第 060 组任务举例。用户要找一本书,要求有三条:类型含科幻,类型含青少年,出版不晚于 2001 年。这三条要求在三种条件下的说法不同:
| 要求 | 一开始全说 | 要问才说 | 有隐藏要求 |
|---|---|---|---|
| 类型含科幻 | 开头就说 | 开头就说 | 开头就说 |
| 类型含青少年 | 开头就说 | 问到才说 | 始终不说 |
| 不晚于 2001 年 | 开头就说 | 问到才说 | 问到才说 |
在“要问才说”的版本里,一个 agent 问了语言、年份和其他类型,用户就把两条要求都说了,agent 推荐的书被接受。在“有隐藏要求”的版本里,用户回答了年份要求,但说“类型方面我不想再多说了”。agent 搜了 93 次,提了一本被拒绝的书,最后直接推荐了《华氏 451》。这本书是 1953 年的科幻,但不是青少年读物,而且从没先给用户看过。
用户说“不想多说”,其实是在告诉 agent:这个字段上有一条要求,只是不说内容。agent 要找出它,只能先提几本书,看用户接受还是拒绝,再排除不符合的可能。
评测怎么搭起来的
目录来自 Wikidata,共 20,000 本书,还有 5,000 和 10,000 本的子目录,小目录完全包含在大目录里。任务一共 450 个,分成 150 组。每组固定要求、答案集合、读过的书和接受的格式,只改变要求说出的时机,所以同一组的三种条件可以直接对比。要求只涉及四个字段:类型、语言、原产国和出版年份。
其中 15 组故意让目录里没有符合要求的书。这时正确做法是放弃推荐,论文叫 NVR(无有效推荐)任务。
和 agent 对话的是一个模拟用户,它按固定规则回答:问到能说的字段就说,问到隐藏字段就说“不想多说”。agent 提一本书并带上它的目录 ID 时,只有这本书满足全部要求、没读过、并且有用户接受的版本,用户才回“接受”,否则回“拒绝”,从不说原因。提书只是问用户意见,可以提很多次。agent 最后要调用一个专门的“推荐”工具,交上一本书,或者什么都不交、表示放弃,对话就此结束。评测按目录元数据检查交上的这本书是否满足全部要求,还要过几条规则检查,比如不能推荐读过的书、无解时要放弃。整个打分不用大模型当裁判。agent 能看到用户的回答、接受或拒绝,以及搜索和其他工具返回的结果,但拿不到答案集合。 Hoot 说

上面一行是对话里能做的事。agent 可以提问,也可以提书。提书时用户只说接受或拒绝,不说原因。下面一行是一个示意:书 A 读过,被拒;书 B 被接受。agent 最后要调用推荐工具,交一本书或放弃。只有这一步会被判分。
出处
论文 §3 交互协议:提书只得到接受或拒绝;对话以推荐工具交一本书或不交结束参评的是四个 agent:三个开放权重模型 DeepSeek、GLM、Qwen,加一个前沿模型 GPT-6.1 Sol。检索接口有两种:一种是返回前 20 条的关键词搜索,另一种是可以按字段筛选的结构化搜索。另外有一个按脚本行动的参照 agent,叫“热门”agent。它先问一个覆盖所有字段的问题,再按热门程度逐本提书,直到被接受。
结果一:说出的时机影响最大
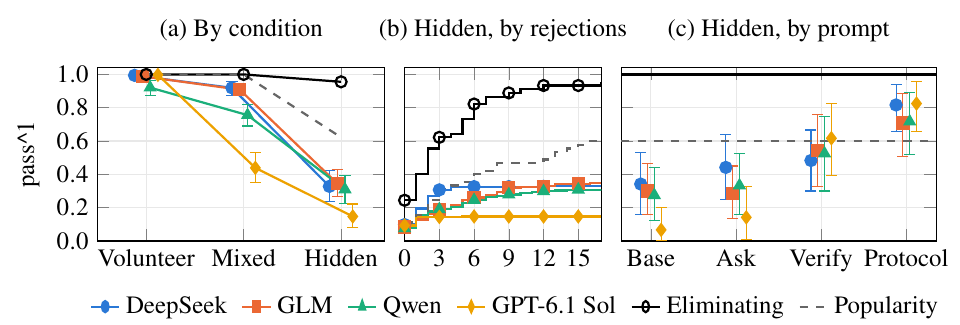
在评测面板里有解的 45 组任务上(20,000 本目录),四个 agent、两种接口的平均成功率,一开始全说时是 0.975,要问才说时是 0.756,有隐藏要求时只有 0.283。无解的隐藏任务另算,平均只有 0.047。每个模型、每种接口都是这个顺序。相比之下,结构化搜索平均只比关键词搜索高 7.1 个百分点,而且主要来自 Qwen 一个模型;去掉 Qwen 只剩 3.3。结构化接口的提示词还列出了字段,所以比的是工具加提示的组合。目录从 5,000 本扩到 20,000 本,影响也小。目录规模这项实验只用三个开放权重模型,只测了一次说全和要问才说两种条件:关键词搜索降 4.2 个百分点,结构化搜索只降 0.8。
结果二:要问才说的任务,输在不问
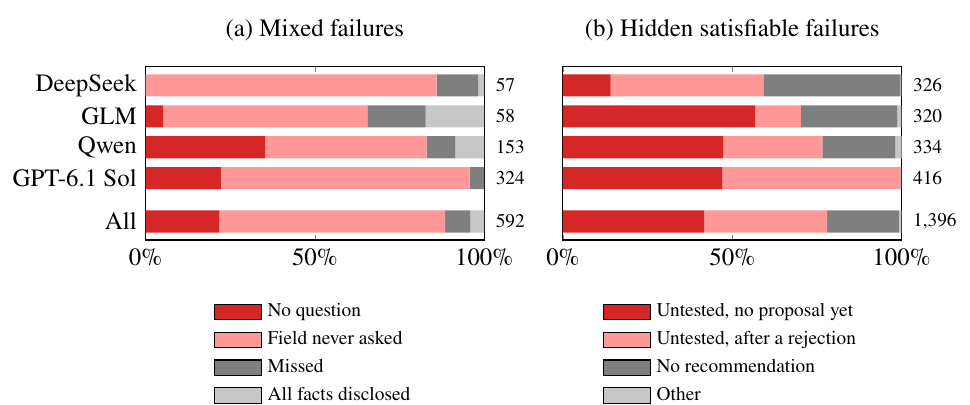
GPT-6.1 Sol 在一次说全时几乎全对,要问才说时却是四个里最低的。它有 40% 到 49% 的对话一条能问的要求都没问出来。而它把能问的要求全问出来的 101 次对话,全部成功。
这说明它会找书,只是不问。作者在 18 组任务的可靠性子集上(结构化搜索)试了几种提示词。系统提示词里加一句“用户可能还有没说的要求,推荐前先问”,GPT-6.1 Sol 在这类任务上提高 59.0 个百分点,四个 agent 都到了 0.931 以上。
结果三:有隐藏要求的任务,输在不验证
有隐藏要求的任务里,78% 的失败是 agent 推荐了一本从没让用户表态过的书,GPT-6.1 Sol 失败的 416 次里有 415 次是这样。所有这类没经表态的推荐里,73% 发生在用户已经说过“不想多说”之后,也就是 agent 已经得到“这里有隐藏要求”的信号,却没用上。
在提问提示的基础上,再加一句“推荐前先把书提出来,等用户表态”,没经表态就推荐的情况降到隐藏任务失败的 30% 以内。成功率到了 0.483 到 0.617,和先问一遍所有字段、再按热门度逐本提书的脚本 agent 的 0.600 差不多。再加上一段解释“不想多说”和“被拒”是什么意思的说明,成功率平均再涨 22.5 个百分点,到 0.708 到 0.825。作者的结论是:把规则讲明白,能补上一部分差距。
我认为它的局限
第一,模拟用户很机械。它只用目录里的标签说话,拒绝时从不给理由,也没和真人对比验证过。作者让 GLM、Qwen 扮演用户测了 DeepSeek(结构化搜索),成功率分别降 10.2 和 7.4 个百分点,主要掉在要问才说的任务上,因为大模型用户只在约一半对话里把能说的都说了。这提示更像真人的用户可能更难,但还没有真人验证。
第二,要求只覆盖四个元数据字段的硬过滤。真实找书常见的“类似某本书”“读起来轻松”这类软偏好不在范围内。要问才说的任务里,一个问到所有字段的问题就能把要求全问出来,所以它测的是问不问,不是问得好不好。
第三,目录偏英美作品:83.2% 的书是英语,41.5% 来自美国。前沿模型只测了一个。
一个推荐团队可以怎么试
- 把自家对话推荐的评测集按同一个请求拆成三版:一次说全、问了才说、有一条始终不说,分开报成功率。
- 统计失败对话里有多少是一次没问,有多少是推荐了没让用户确认过的东西。
- 先试最便宜的改动:提示词里要求推荐前先提问,并先提出候选等用户表态。
- 如果隐藏要求的场景重要,再在提示词里讲清“不想多说”和“被拒”是什么意思。
评价
一句话:评估推荐 agent,要单独测它会不会主动问、会不会先验证再推荐。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。用户不一次说全是常态,现有评测大多忽略 |
| 方法创新性 | 中高。同一请求只改说出时机的对照设计很干净 |
| 实验证据 | 高。近 3.3 万次对话,统计检验完整,所有记录公开 |
| 局限 | 模拟用户机械,只有硬过滤,目录偏英美 |
| 是否值得借鉴 | 值得。三版拆分的做法可以直接用到自家评测 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…