目录 · 8 节
1它到底在解决什么问题?2整体流程:先教一个看得见答案的老师,再教学生3学生怎么在看不清时撑过去?4为什么还需要训练技巧?5实验结果说明了什么?6我认为它的局限7一个机器人团队可以怎么试8结论
人形机器人去抱箱子,手一靠近,箱子就会挡住头上的深度相机,可控制器还得把抓起、搬走、放下这一整套做完。这篇论文的做法是:让机器人主要靠关节状态那条通路行动,深度画面只当作一路由学出来的门控缩放的修正,设计上希望画面不可靠时少放进来;前几帧攒下的信息存在循环层的记忆里,画面断了也不会马上丢。在仿真里抓取静止箱子,成功率是 85.2%,同样测法下对比方法 VisualMimic 只有 48.5%;箱子横向移动时成功率是 85.9%。在 Unitree G1 真机上,相机看过箱子一眼后被完全挡住,机器人仍然抓到了箱子。
它到底在解决什么问题?
先看一个场景(示意)。箱子放在机器人左前方 0.3 米,用户按下“去抓”的指令。机器人走近、弯腰、伸手,这几秒里头部相机看到的画面变化很大:
| 阶段(示意) | 相机看到的 | 关节状态能告诉控制器的 |
|---|---|---|
| 走近 | 箱子完整,位置清楚 | 身体在往哪走 |
| 伸手 | 手臂挡住箱子一部分 | 手到了哪里 |
| 抱起 | 箱子贴着身体,画面几乎没用 | 关节在负重下的位置和速度变化,可以间接看出是否抱住 |
| 相机被遮 | 全黑 | 照常可用 |
如果控制器每一帧都把画面当作同等可信的输入,到了后两行就会被坏画面带偏。很多已有方案的做法是外接动作捕捉或单独的物体位姿估计器,把箱子的位置喂给控制器,这在实验室之外很难部署。这篇论文要的是只用机器人自己身上的传感器:头部深度相机加关节状态。
整体流程:先教一个看得见答案的老师,再教学生
论文用了机器人学习里常见的师生两阶段训练。
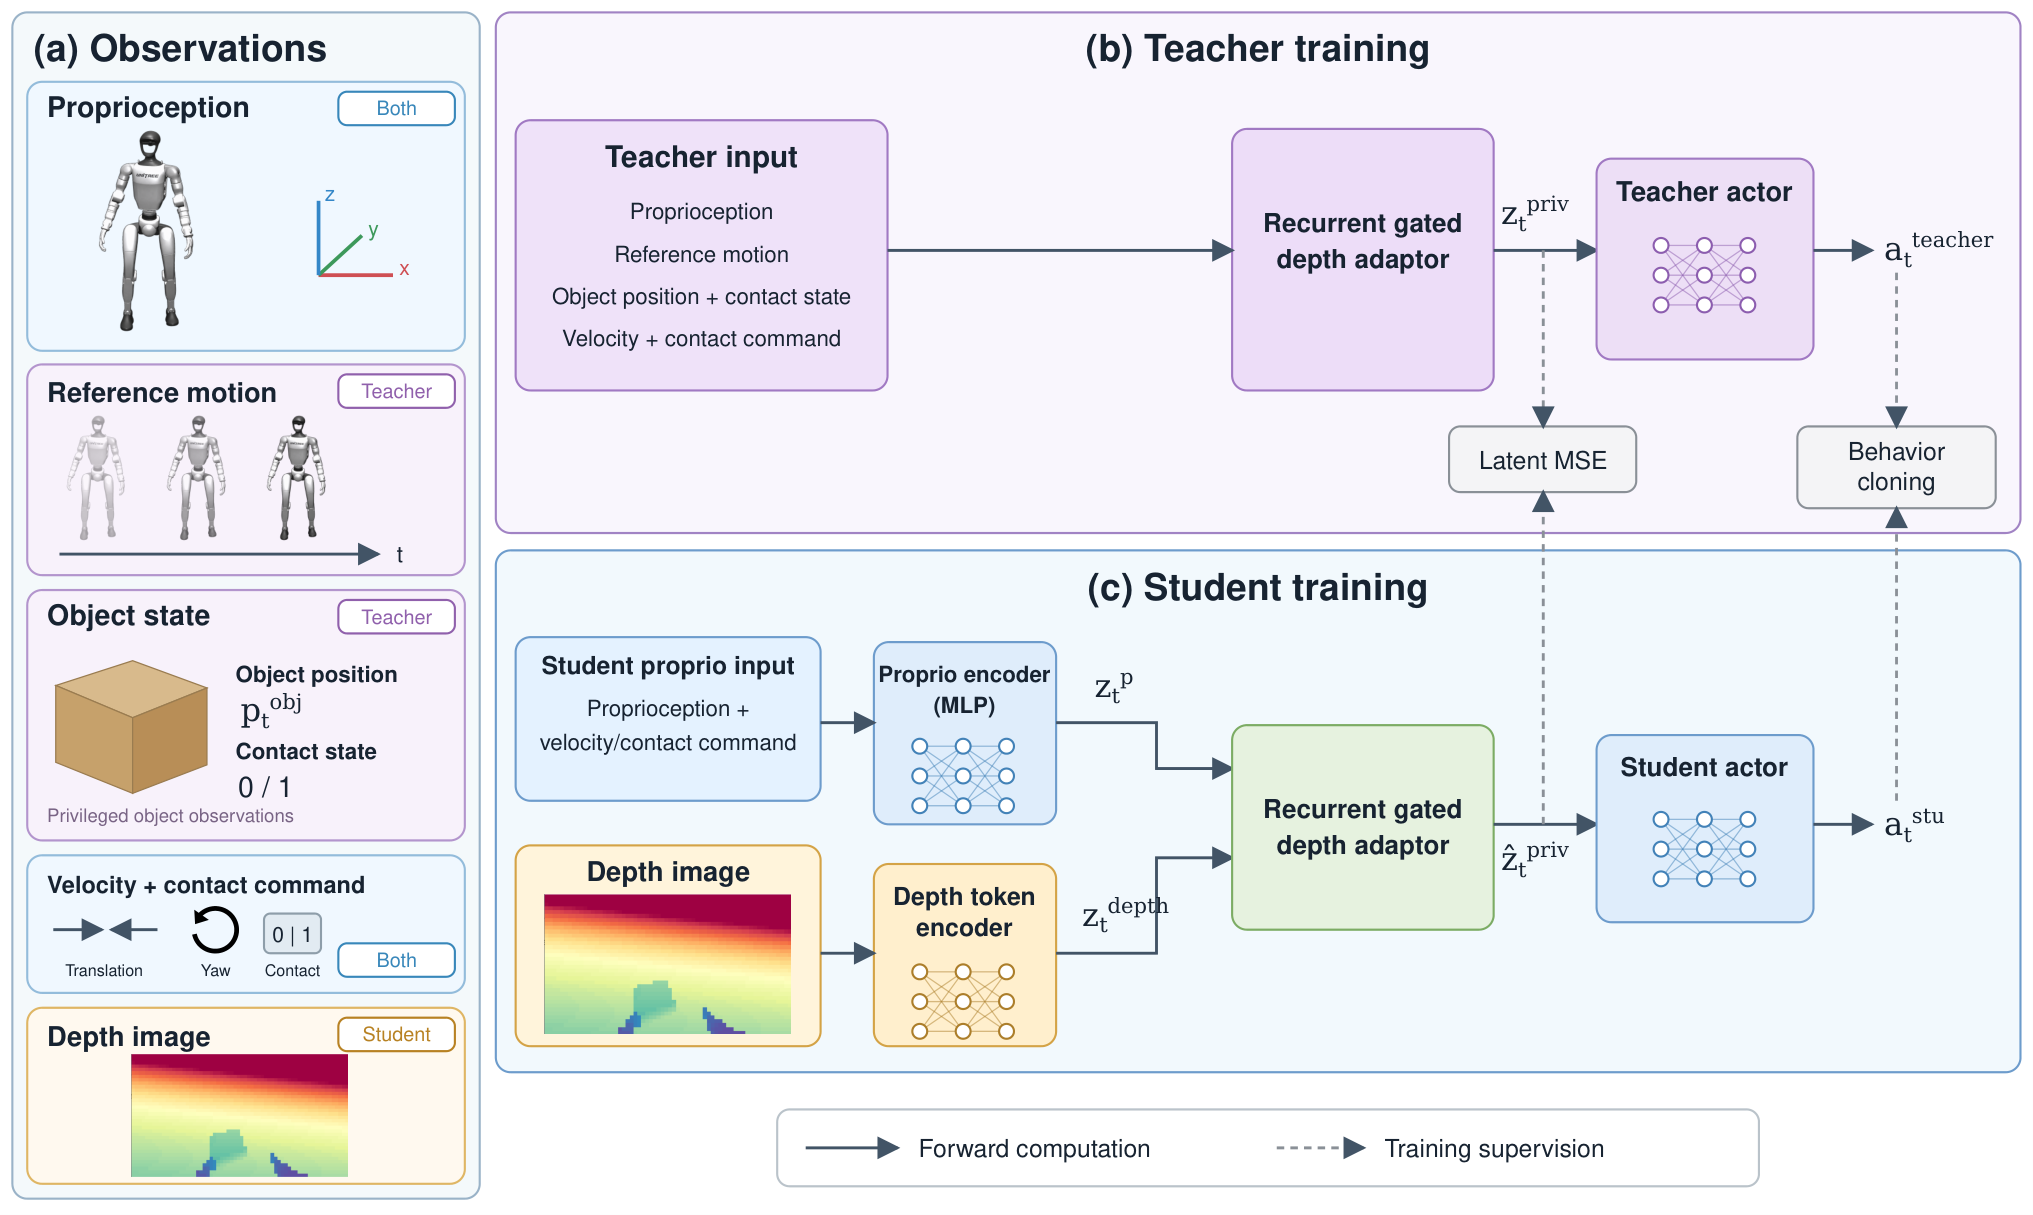
| 阶段 | 谁 | 能拿到什么 | 学什么 |
|---|---|---|---|
| 第一阶段 | 老师 | 仿真里箱子的真实位置、接触信息、参考动作 | 用强化学习学会整套搬运动作 |
| 第二阶段 | 学生 | 只有关节状态、深度画面、用户指令 | 模仿老师的动作,并从自己的输入里估计老师掌握的箱子信息 |
第一阶段训练老师的同时,学生的估计模块已经在深度特征全部置零的条件下先练了一轮,学会只靠关节状态估计箱子信息。第二阶段学生的动作网络除了模仿老师,还会再用强化学习微调。老师只在仿真里训练时存在。部署到真机上的只有学生,它拿不到任何真实状态。用户指令包括走路的速度、转向速度,以及一个“要不要接触箱子”的开关。
学生怎么在看不清时撑过去?
学生的关键部件是一个循环模块,论文叫 recurrent gated fusion adapter。它每一步做三件事。
第一,深度画面先加上像素坐标,经过卷积网络和一个能记住前几帧的循环层,变成一组画面 token,每个 token 对应画面上的一块区域。
第二,关节状态和用户指令编码成一个向量,拿它去和这些画面 token 做 attention,找出当前这个动作阶段最该看画面的哪几块。用关节状态来提问有它的道理:不同阶段该看画面的地方不一样,比如走近时要看箱子在哪,问什么取决于机器人此刻在干什么。
第三,查到的画面信息先经过分层门控,再加回关节状态那条通路。门控分两层:第一层决定每个 attention 头的画面信息留多少,第二层决定整个画面修正加回多少。按论文图 3,模块把这一步的关节状态特征和 attention 打分拼在一起,分别送进两个线性层,再过 sigmoid。这样得到 8 个头各自的门控值和 1 个整体门控值,都在 0 到 1 之间。输入每一步都在变,所以门控值每一步都重新算一次。两个线性层的权重是训练中学出来的。乘过门控的画面修正直接加到关节状态特征上,再对相加的结果做一次 LayerNorm。整体门控为 0 时,加上的部分也是 0,结果就只剩关节状态那一路。论文沿用了前人的门控融合做法,并提醒门控值是为任务学出来的,不要把它当成传感器可靠程度的读数。门控和画面编码器、第二个循环层一起,只由学生估计模块的那组损失来训练,模仿老师动作的损失不会改动它们。
还有一个只看画面、不看关节状态的小预测头,训练时让它预测箱子在图像里的位置。它逼着画面特征自己学会定位箱子,而不是借关节状态的光。
融合后的结果不直接交给动作网络,而是先预测三样东西:箱子的状态、箱子在空间里的点云、两只手有没有真正碰到箱子。点云指把整只箱子的点按箱子当前的位姿摆到空间里,代表的是整个箱子,不只是相机看到的那一面。只有点云和接触这两个预测,连同关节状态和指令,进入第二个循环层,得到交给动作网络的状态表示。这样画面里的信息必须先变成“箱子在哪、碰没碰到”,才能影响动作。两个循环层各管一段。第一个在画面这边,把前几帧的画面特征带到当前帧。第二个在预测之后,把关节状态、指令、点云和接触预测,连同自己上一步的记忆,合成交给动作网络的状态表示。三个预测头只看当前这一步的融合结果,不读第二个循环层的记忆。第二个循环层由其中对齐老师表示那一项来训练:它的输出要去对齐老师的表示。老师的表示由老师自己的编码器算出,用到参考动作、箱子的真实状态和接触信息这些仿真里才有的量;这个编码器第一阶段训好后,在第二阶段冻住不动。所以画面断了以后,当前这一步的点云和接触预测并不会自动“记住”箱子:门控关上时,它们只能依靠关节状态那一路。真正保留历史的是两个循环层,尤其是第二个循环层里上一步的状态记忆。它和始终在线的关节状态一起,让交给动作网络的状态不会在画面断掉的那几帧突然变样。 Hoot 说

- 画面正常时:门控放进画面修正,点云和接触预测跟着画面更新,第二个循环层把这一步的结果写进记忆。
- 画面断掉时:当前这一步的预测只能依靠关节状态,不会自己记得箱子;之前看到的箱子信息由第二个循环层上一步的记忆带下来,加上始终在线的关节状态,交给动作网络的状态才不会突然变样。
从上往下是一步之内的信息流。门控只控制画面那一路放进来多少;三个预测头不读任何记忆;箱子状态的预测只用来在训练时监督,不进第二个循环层。 出处: 论文 §III-B(循环深度 token、关节状态提问的 attention、两层门控、交互状态预测)、§III-C(第二个循环层对齐冻住的老师表示)
为什么还需要训练技巧?
门控有一个容易出现的毛病。训练刚开始时,深度编码器是随机的,画面信息全是噪声,模型最省事的办法就是把门控关掉,只靠关节状态。门一旦过早关上,画面就再也学不进来。论文的办法是分步来:先用干净的深度画面、强制把两层门控都开满,让编码器学出有用的特征;热身结束后,门控从强制全开逐步过渡到模型自己学出来的值。也是从这时起,训练里开始加入局部遮挡和整帧全黑的画面。
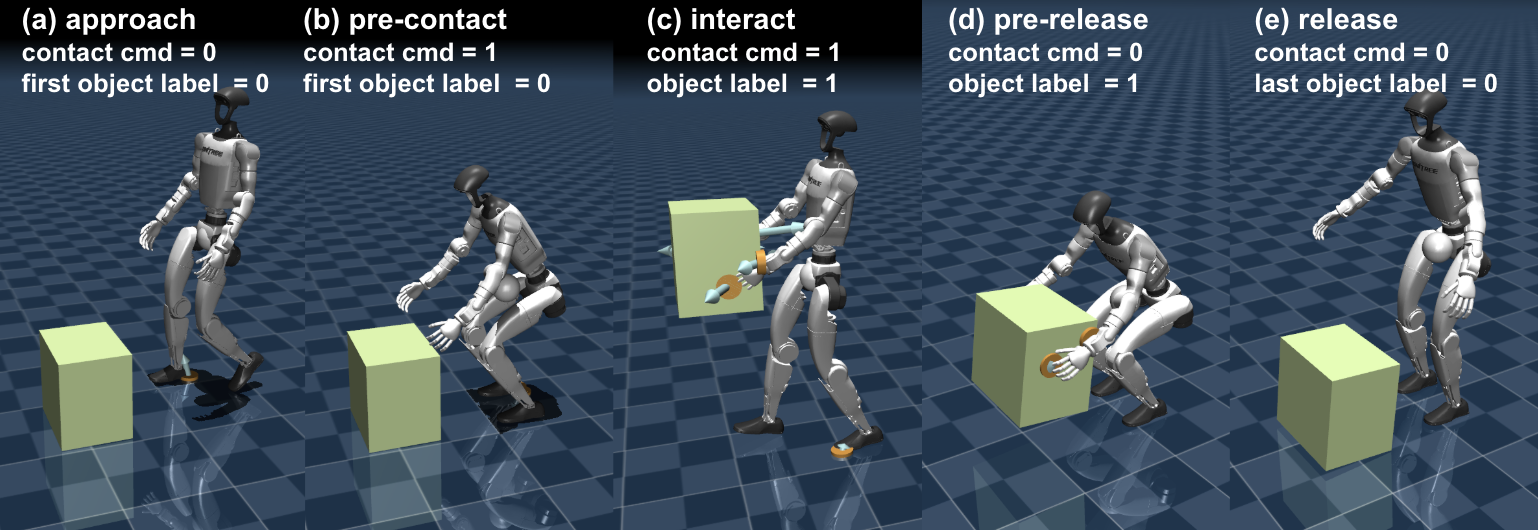
另一个问题是采样。训练时每一局从示范动作的某一帧开始。如果均匀随机挑帧,伸手接触前后这种很短的过渡几乎抽不到。论文把每条示范切成五段:走近、准备接触、抱着、准备放下、放下后离开。每段按固定概率抽,和这一段有多长无关,再在段内随机挑帧。
实验结果说明了什么?
成功的标准是:13 秒的一局结束时,骨盆高度在 0.7 米以上,手和箱子之间的接触力至少 1 牛。评测在 MuJoCo 里进行,训练用的是另一个仿真器 Isaac Sim,箱子位置在训练时没有随机化,所以横向偏移的测试都是没见过的位置。
| 箱子横向位置(米) | −0.5 | −0.3 | 0.0 | +0.2 | +0.3 | +0.5 | 总体 |
|---|---|---|---|---|---|---|---|
| VisualMimic | 23.3 | 43.3 | 63.3 | 70.0 | 53.3 | 50.0 | 48.5 |
| ReGATE | 70.0 | 90.0 | 100.0 | 76.7 | 63.3 | 83.3 | 85.2 |
(成功率 %,每个位置 30 次,共 330 次;表中只摘了部分位置,完整 11 个位置 ReGATE 都更高。)
静止箱子在 −0.2 到 +0.1 米这段中间区域,120 次全部成功。这说明正前方附近的抓取已经很稳,难点在两侧边缘,+0.2 到 +0.4 米最低,只有 63.3% 到 76.7%。VisualMimic 失败时,要么手没碰到箱子,要么抱起后站不稳。
箱子横向移动时更难,因为机器人碰到箱子的那一刻,箱子停下,机器人要马上稳住自己和箱子。测试里箱子以四档速度横穿,在 11 个位置之一下达抓取指令,总成功率 85.9%,和静止箱子差不多,说明整套控制器能抓住移动中的箱子。论文没有做消融,所以这份功劳不能单独记在循环层头上。按速度看,最慢的一档反而最差,只有 73.6%,其余三档都在 87% 以上。
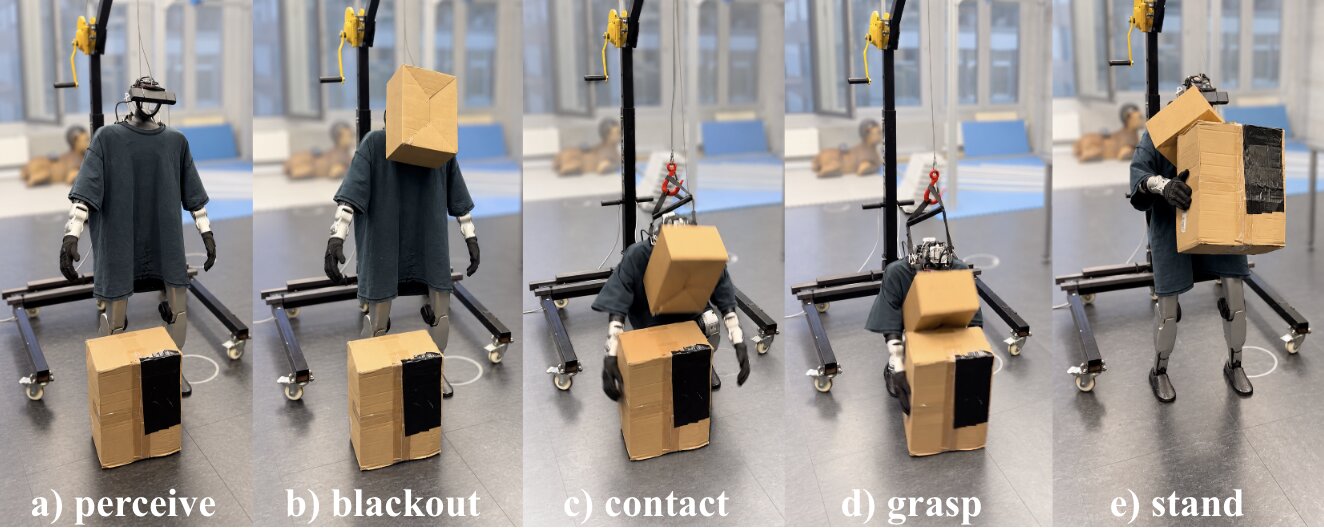
真机上的结果是定性的。连续下达抓起、搬运、放下的指令,10 次全部完成。相机看过箱子后被完全挡住再下达抓取指令,机器人仍然抓到了箱子。
我认为它的局限
第一,最关键的门控没有消融。实验里没有去掉门控或去掉循环层的对照,所以 85.2% 里有多少来自门控设计,读者无从判断。和 VisualMimic 的对比同时换了整套控制器,差距不能全算在门控头上。
第二,画面被遮挡的鲁棒性只有定性证据。论文第 IV-B3 节在接触前、搬运中和放下前加入局部遮挡和整帧全黑,结果只用图 7 展示。图 7 是真机在画面被完全挡住时抱起箱子的一个成功示例,而这恰恰是这篇论文最想证明的事。
第三,任务很窄。只有一种箱子,抓取前的走近和“何时下达抓取指令”被明确排除在评测之外,论文设想交给视觉语言模型或更上层的控制器去做。
一个机器人团队可以怎么试
- 先在自己的仿真里复现“关节状态为主、画面加门控”的结构,只做一个物体、一个抓取动作,看遮挡情况下成功率是否比直接把画面拼进输入高。
- 补上论文缺的消融:分别去掉门控和循环层,测遮挡和全黑画面下的成功率,判断收益到底从哪来。
- 训练里加入分步开门控和按阶段抽起始帧,这两步代码改动小,可以单独验证。
- 上真机前,先在真机上录一段带遮挡的深度画面回放给策略,同时记下两层门控的取值,和仿真里相似遮挡场景下的取值对比。
结论
画面会被挡住时,与其让控制器每帧都相信画面,不如让它以关节状态为主、按需采信画面,并用循环层记住之前看到的信息。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。真机抓取时遮挡几乎必然发生,不依赖外部位姿估计才能走出实验室 |
| 方法创新性 | 中。门控融合在带视觉的行走控制里已有,这篇把它搬到了搬运任务 |
| 实验证据 | 中低。静止和移动抓取有量化结果,但没有消融,遮挡只有定性示例 |
| 工程成本 | 中。需要仿真里的师生训练和深度相机渲染,单张 RTX 5090 可以训练 |
| 是否值得尝试 | 值得在人形或移动操作的抓取任务上试,先补消融再决定是否采用 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…