
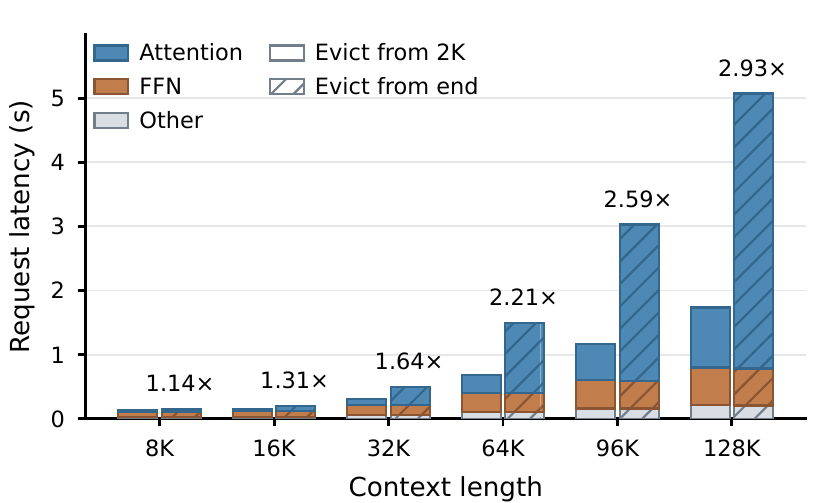
做大模型推理服务、尤其是要接 coding agent 流量的团队值得读。这篇论文指出,KV cache 不够用时,SGLang、vLLM 都从一段历史的末尾开始删,而末尾恰恰是重算起来最贵的部分。作者的系统 Penelope 反过来做:保住多个会话共用的开头,从剩下的私有历史的最前面开始删,留下靠后的部分。核心思想一句话:同样腾出空间,删靠前的 token 比删靠后的 token 重算起来便宜得多。论文先做了一个单请求测量:128K 上下文里删掉 30% 的缓存,从第 2K 个位置删比从末尾删,下一次请求快 2.93 倍。在真实的 Claude Code 轨迹上,和原版 SGLang 比,Penelope 只用 GPU 显存时首 token 延迟平均降低 36% 到 60%。加上 CPU 内存做第二层缓存后降幅是 46% 到 76%,这组的对照是调度器也改成计入 CPU 缓存的 SGLang。
它到底在解决什么问题?
先说 agent 流量和普通聊天有什么不同。一个 coding agent 做一件事要连续发几十上百次请求,每次都带上之前的全部对话和工具结果,所以同一段历史被一轮轮地复用,而且越来越长。论文统计了 TraceLab 数据集里 Claude 和 Codex 的 66.5 万条请求,输入长度的中位数约 132K token,79% 超过 64K。
服务框架会把请求结束后的 KV cache 留着,下一轮请求前缀对得上就直接复用。可显存装不下所有会话的历史,总要删一些。删的时候有两个决定:删哪段历史,删这段历史的哪一部分。主流做法用 LRU 挑最久没用的那段历史,然后从它的末尾往前删。从末尾删的理由很直接:前缀缓存只能从头连续匹配,保住开头,以后分叉的请求还能共用这段开头。
问题出在重算的代价上。被删掉的 token 下次要用时,得重新过一遍模型。在因果 attention 下,每个 token 要和它前面所有 token 算 attention,所以位置越靠后,重算越贵。线性层和 FFN 的开销每个 token 差不多,差别全在 attention 上。
用一个示意例子看差多少。一个 agent 会话的前 16K token 是系统提示和工具定义,所有会话都一样;后面 100K 是这个会话自己的历史,现在要腾出 30K token 的空间(示意)。
| 删法(示意) | 删掉的位置 | 按论文代价公式算的重算量 |
|---|---|---|
| 从末尾删(SGLang 做法) | 86K 到 116K | 约 37.4 亿个单位 |
| 从私有历史开头删(Penelope) | 16K 到 46K | 约 16.4 亿个单位 |
这里用的是论文 2.2 节的代价公式,单位是“一对 query 和 key 算一次 attention”。一个 token 的线性层和 FFN 开销,按 Qwen3-8B 的结构折合约 23,552 个单位,不随位置变。重算一个 token 时,它的 attention 开销等于它前面的 token 数。两种删法重算的 token 一样多,线性层部分相同,差在 attention 那一项。从末尾删的每个 token 要和前面 8.6 万到 11.6 万个 token 算,平均约 10 万。从开头删的每个 token 只要和前面 1.6 万到 4.6 万个算,平均约 3 万。算下来,同样腾出 30K,从末尾删的重算量是从开头删的 2.3 倍左右(示意里 1K 按 1000 算)。这比下面实测的 2.93 倍低,因为示意里删除从 16K 的共享前缀之后开始,而不是从第 2K 个位置开始,也只算了补回的那一段。
论文在一张 H100 上用 Qwen3-8B 实测了这件事:缓存好整段历史后,删掉约 30% 的 token,一种从第 2K 个位置开始删一段,一种从末尾删;再在历史后面接 512 个新 token,测下一次请求的延迟。两种删法重算的 token 数一样,8K 上下文时从 2K 处删只快 1.14 倍,128K 时快 2.93 倍。代价公式预测的加速比和实测相差不到 4%。
从开头删,为什么不能直接删?
想法很简单,落地有三个坑。
第一,开头往往是共享的。在论文用的 Claude Code 轨迹里,会话一开始约 15.6K token 是各会话共用的系统提示和工具定义。删了它,别的会话也得重算。正在跑的请求要用的 KV 也不能删。
第二,从开头删会在历史中间留下一个洞:前面一段 KV 没了,后面一段还在。SGLang 的前缀匹配一碰到缺失就停,找不到后面还留着的那段。执行时也麻烦,原来只需要接着已缓存的前缀往后算新 token,现在要算两段:洞里的旧 token 和新追加的 token。
第三,加了 CPU 内存当第二层缓存后,两层各自删各自的,会打乱删的顺序。比如 GPU 把一段 KV 挪到已满的 CPU 内存,CPU 那边按自己的规则删掉的可能正好是同一段历史靠后的部分,而 GPU 上还留着靠前的部分,又变回了删贵的、留便宜的。
Penelope 怎么做:三个部件
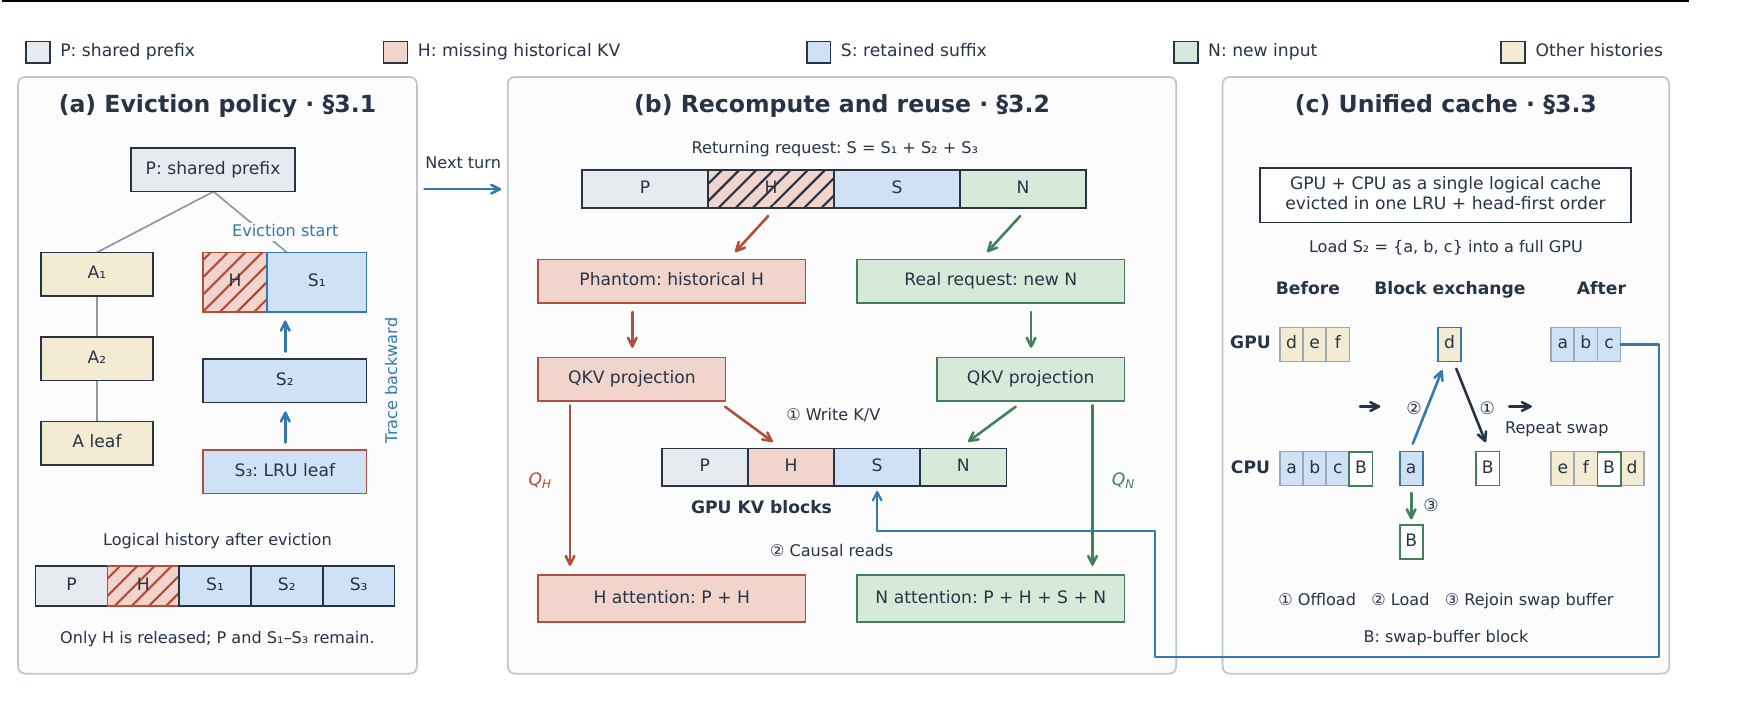
下面这张总览图对应三个部件:(a) 决定从哪里删,(b) 下次请求来时怎么补回删掉的那段,(c) GPU 和 CPU 两层怎么共用一个删除顺序。
部件一:找到可以删的最早位置,只删需要的块
SGLang 用一棵基数树(radix tree)存所有缓存的历史:多个会话共用的前缀是树上的公共路径,每个节点存一段连续的 token 和它们的 KV 位置,还记着有几个正在跑的请求在用它。
缓存不够时,Penelope 仍用 LRU 挑最久没用的那段历史,也就是树上的一个叶节点。它从这个节点往根的方向回溯,碰到下面四种情况之一就停:上一个节点是根;上一个节点有多个孩子,说明从这里往上是共享前缀;上一个节点正被运行中的请求使用;上一个节点的 KV 已经被删过。停下的那个节点,就是这段私有历史里可以删的最早位置。
找到起点后,还要控制删多少。SGLang 一删就是整个节点,而靠近开头的节点可能装着整段初始提示,一次删掉远超需要的量,下次又得多重算。Penelope 按 KV 块的边界把节点切开(论文实验里一块 64 个 token),只删够用的前几块。论文图 3 的例子里,需要腾 3 块,起点节点有 8 块,它就切开节点,删前 3 块,留后 5 块。不够再按顺序往后删。
部件二:用影子请求补回洞里的 KV
删的时候,Penelope 只释放 KV 存储,节点里的 token 和父子关系都留着,只把它标成“KV 缺失”。下一轮请求来时,前缀匹配沿着树往下走,遇到缺失的节点只要 token 对得上就继续走,于是能找到洞后面保留的那段,并知道哪段需要补算。
补算交给一个影子请求(论文叫 phantom request)。它是 Penelope 内部造的一个只做 prefill、不产生输出的请求,专门把洞里那段旧 token 的 KV 算回来。真实请求只算新追加的 token。两个请求保留各自 token 的原始位置,放在同一个批次里跑。
为什么要放同一批?因为在每一层里,这一批的 K/V 会先写进缓存,再算 attention。影子请求在这一层写好洞里的 K/V。真实请求在同一层算 attention 时,就能同时读到刚补好的这段、前面的共享前缀和后面保留的那段。这样真实请求不用先等影子请求把整个模型跑完一遍。合在一批跑几乎不增加开销:在 8B 模型、H100、32K 到 128K 的上下文上,对照做法是把同样的工作拆成两个互不相干的普通请求:一个只补洞里的位置,一个只算真实请求的新内容。合批后的总执行时间和这个对照相比,差别在 1% 以内。其中 attention 慢了约 1%,其余部分略快。 Hoot 说

- 先写:影子请求写位置 2、3 的 K/V,真实请求写位置 5 的 K/V(示意,一层之内)。
- 再算 attention:位置 2 读 1–2,位置 3 读 1–3,各自只看自己之前的位置;位置 5 读 1–5,整条历史这时都在缓存里。
- 下一层照样先写后读。所以真实请求每层只等这一层的洞补好,不用等影子请求把整个模型跑完。
- 位置 4 的 KV 为什么还能用:删的只是存储,位置 2、3 的 token 没变。位置 4 当初就是读着同样的 1–3 算出来的,补回后历史和原来一样。
示意:用 5 个位置代表一条历史,真实场景里每段有成千上万个 token。图里只画一层,每一层都按同样的先写后读进行。 出处: 论文 §3.2 与图 2(b)(影子请求只做 prefill,补算被删段;与原请求保留各自原始位置、同批执行;每层先写入本批 K/V 再算 attention,真实请求可读到补好的段、共享前缀和保留后段);位置编号全部为示意。
部件三:GPU 和 CPU 当成一个缓存
Penelope 让一段 KV 只待在一层,要么在 GPU,要么在 CPU,然后把两层当成一个逻辑缓存,用同一套 LRU 加从开头删的规则决定最终删谁。两层之间挪数据只改变 KV 待在哪,只有删掉最后一份拷贝才算真正删掉。这样先决定删谁,再安排搬运,搬运本身不会引发额外的删除。
两层都满时,从 CPU 往 GPU 搬一段 KV,就得同时把 GPU 上一段 KV 挪到 CPU,可两边都没有空位。Penelope 在 CPU 上预留一小块交换缓冲区(实验里是 1,024 个 token),分块交换:GPU 要挪出的数据先写进缓冲区,腾出的 GPU 块再装 CPU 搬来的数据,CPU 上被搬空的块又成为下一块的缓冲区。
效果怎么样?
评测时,论文用两套真实的 coding agent 轨迹回放:Claude Code(24 个会话、4,688 条请求,每轮上下文中位数 80K;公开记录缺开头的上下文,回放时用人造 token 补齐,其中 15.6K 是各会话共用的一段)和 FreeInference(Codex 风格,48 个会话、4,089 条请求)。回放时同时保持 N 个会话在跑,每个会话等上一次回复完、再等轨迹里记录的工具耗时,才发下一次请求。模型是 Qwen3 的 8B、32B 和 235B-A22B 三个尺寸。为了制造缓存压力,只用 GPU 的实验里,8B、32B、235B 的 KV cache 容量分别限制在 256K、192K、384K token。两层缓存实验的容量见后面的表。对比对象是原版 SGLang,两边的调度器都优先跑可复用缓存最长的请求。指标有两个:TTFT,以及整个会话从头到尾花的时间(论文记作 JCT)。
只用 GPU 显存时,在 Claude Code 轨迹上,TTFT 平均降低 36% 到 60%,JCT 降低 27% 到 37%。在 FreeInference 上用 8B 模型、3 个和 4 个并发会话时,TTFT 分别降低 30% 和 32%,JCT 只降了约 2%。原因是这套回放里会话大部分时间在等工具,prefill 变快只缩短了很小一部分。这说明收益大小取决于会话有多少时间花在等第一个 token 上。
两层缓存的实验里,GPU 层更小,再配一个同样大的 CPU 层,降幅更大。论文先把 SGLang 的调度改成也计入 CPU 上缓存的前缀,这本身就让 SGLang 的 TTFT 降了 13% 到 37%。在这个更强的基线上,Penelope 再降 46% 到 76%:
| 模型 | 并发会话数 | GPU / CPU 容量(token) | 平均 TTFT(秒,SGLang 对 Penelope) | 平均 JCT(分钟,SGLang 对 Penelope) |
|---|---|---|---|---|
| 8B | 4 | 128K / 128K | 10.4 对 4.5 | 81 对 50 |
| 8B | 8 | 128K / 128K | 23.5 对 12.8 | 124 对 79 |
| 32B | 4 | 128K / 128K | 11.0 对 3.9 | 84 对 47 |
| 235B-A22B | 4 | 256K / 256K | 24.2 对 5.8 | 359 对 142 |
235B 降得最多,原因有两个。一是它支持 256K 上下文,会话能跑得更长(每条请求平均 144K token,8B 和 32B 是 83K),SGLang 重算的 token 位置更靠后,正好是最贵的那些。二是 Penelope 的命中率领先更多(高 43 个百分点,8B 和 32B 是 29 到 30 个)。用和小模型一样的轨迹长度和缓存大小时,235B 的降幅回到 49%。
收益来自哪里?
最有意思的是消融。论文把两件事拆开:从哪里开始删(叶节点的尾部、叶节点的头部、私有历史的开头),以及一次删多少(整个节点,还是只删需要的块)。8B 模型、4 个并发会话下,TTFT 相对 SGLang 的变化如下:
| 删的起点 | 删整个节点 | 只删需要的块 |
|---|---|---|
| 叶节点的尾部 | 0%(即 SGLang) | 降 45% |
| 叶节点的头部 | 降 12% | 降 43% |
| 私有历史的开头 | 降 6% | 降 63%(Penelope) |
只删需要的块,删的位置才开始起作用。删整个节点时,常常一次删掉一个会话的大半私有历史;整段都没了,下次只能从头重算,从哪删都一样。论文统计,删整个节点时,私有历史丢了至少 90% 的请求贡献了 90% 到 94% 的重算量;只删需要的块时降到 16% 到 23%。
只删需要的块之后,从叶节点的头部删和从尾部删差不多(降 43% 对降 45%),因为叶节点装的是会话最新的 token,头尾都在上下文末尾附近,重算一样贵。一路回溯到私有历史开头才拉开差距:命中率只比从尾部删高 1.9 个百分点(84.5% 对 82.6%),TTFT 却从降 45% 变成降 63%。这说明只看命中率会低估收益,关键是留下的是哪些位置。
我认为它的局限
第一,收益依赖调度器。换成 FCFS 调度后,235B 上的 TTFT 降幅从 43% 掉到 17%。FCFS 不偏向历史还在缓存里的会话,排队的会话更容易整段历史都被删光,这时从哪删已经无所谓。用 FCFS 的服务要先估一下自己的收益。
第二,代价公式假设每一层都是完整的因果 attention。用滑动窗口 attention 或线性 attention 的模型,靠后 token 的重算不会贵这么多,从开头删的优势会小很多。论文三个模型都是完整 attention 的 Qwen3。
第三,缓存紧张程度决定收益。论文另做了一组实验:8B 模型、8 个并发会话、两边都用 FCFS,GPU 缓存固定 128K,只改 CPU 缓存的大小。CPU 缓存是 GPU 的 4 倍时,SGLang 的命中率也到了 92%,两者 TTFT 和 JCT 几乎一样;CPU 缓存和 GPU 一样大时,两边都老是缺失,TTFT 只降 10%。评测里 GPU 容量是故意限小的,真实部署要先看自己的缓存压力落在哪一段。
一个推理服务团队可以怎么试
- 先拿自己的 agent 流量算一下:请求长度分布、各会话共享前缀有多长、缓存命中率多少。上下文大多很短、或者几乎不发生删除时,这个方法收益很小:论文图 1 里 8K 上下文时,两种删法只差 1.14 倍。
- 在 SGLang 上只改删除粒度,让它按块删而不是按整个节点删。消融里单这一步就让 TTFT 降了 45%,而且改动最小。
- 再加上回溯到私有历史开头的删法和影子请求补算。验证时打开 SGLang 的确定性推理模式、用贪心解码。论文拿 40K 缓存的 Penelope 和一个 256K、从不删除的缓存对比,输出连同补算位置和复用位置的 prompt 对数概率都要逐位一致。
- 有 CPU 卸载时最后再上统一的两层管理。重点看两层都满时的搬运:论文在 Claude Code 轨迹上做正确性验证时(批大小为 1,GPU 和 CPU 各 128K),763 次从 CPU 搬回中有 602 次要走交换缓冲区。
结论
先只删需要的块,删哪里才能再省一大截。agent 的长上下文让“末尾最贵”这件事变得非常明显,Penelope 用约 2.5K 行 Python(含诊断检查和对比用的策略)、不加新 GPU kernel 就把它利用起来,这是它最值得借鉴的地方。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。agent 请求中位数 132K token,缓存被删后的重算直接决定首 token 延迟 |
| 方法创新性 | 中。从开头删的思路前人提过(Pensieve 用在多轮聊天上,AsymCache 在 vLLM 里权衡命中率和位置代价),新意在保住共享前缀、同批补算和两层统一管理 |
| 实验证据 | 较强。三个模型尺寸、两套真实轨迹、两种硬件,有拆开位置和粒度的消融和逐位一致的正确性检查 |
| 工程成本 | 中。约 2.5K 行 Python,改 SGLang 的缓存、调度和搬运模块,不需要新 kernel |
| 是否值得尝试 | 值得。长上下文、缓存紧张、优先调度有缓存的请求的 agent 服务最受益 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…