目录 · 8 节
1它到底在解决什么问题?2整体流程:沿着目录一层层往下找3为什么要把候选放在同一个上下文里打分?4为什么语料变大,延迟几乎不变?5实验结果:不训练,也能赢过召回加精排6我认为它的局限7一个推荐/搜索团队可以怎么试8一句话结论
大多数 RAG 系统的召回仍然靠 BM25 或向量相似度,召回漏掉的证据,生成模型再强也找不回来。DecisionRAG 干脆不用召回模型,而是让一个决策模型像人逛图书馆一样,从主题到页面再到段落逐层往下找。决策模型是一类不生成 token 的大模型接口:给它一段上下文和一组是非题,一次前向就返回每道题答“是”的概率。每个请求内的候选放进同一个上下文里一起判;一层的候选太多时,就拆成多个并行请求,再汇总分数筛选,留下最有希望的几个再展开。在 268 万个维基百科段落上,它的 Hit@1 比 Qwen3-Embedding-8B 召回加 8B reranker 高 17.4 个点,每个 query 的检索只要 1.7 秒左右。
做 RAG 和文档搜索的团队值得读这篇,因为它把召回加精排的两段式换成了沿文档目录逐层剪枝,并且用一个干净的对照说明收益来自导航本身:同一个决策模型去精排向量召回的前 100 个段落,Hit@1 反而比沿层级导航低 7 个点。核心思想一句话:语料的目录结构负责缩小范围,决策模型负责在每一层把候选放在一起比较、决定往哪几支走。但我认为它离直接上线还有距离,它依赖一个商用决策模型接口,在大语料上每个 query 要 2.33 美分,比 GPT-5 精排还贵,每层保留多少个候选也是按数据集单独调的。
它到底在解决什么问题?
论文用一个问题贯穿全文:“克里斯托弗·诺兰 2000 年那部电影的主角是谁?”答案在维基百科《记忆碎片》页面里描写主角 Leonard Shelby 的那一段。难点是这句话里既没有片名,也没有主角的名字。
| 方法 | 主要看什么 | 容易排到前面的(示意) | 结果 |
|---|---|---|---|
| BM25 | 词面重合 | 《角斗士(2000 年电影)》,因为“2000”“电影”都对得上 | 找错页面 |
| 向量召回 | query 和段落的 embedding 相似度 | 讲诺兰生平的段落,或其他 2000 年电影的段落 | 正确段落可能不在前几名 |
| DecisionRAG | 逐层判断哪一支值得展开 | 先留下《克里斯托弗·诺兰》和《记忆碎片》两页,再在这两页的段落里找主角 | 找到描写 Leonard Shelby 的段落 |
问题的根子在于召回模型的能力远弱于后面的生成模型。精排模型能把顺序排得更好,却只能在召回给出的候选里挑;agent 式检索让大模型一步步翻目录,能力够了,但每一步都要生成一串 token,太慢。DecisionRAG 想要的是大模型的判断力,同时保持召回级别的速度。
整体流程:沿着目录一层层往下找
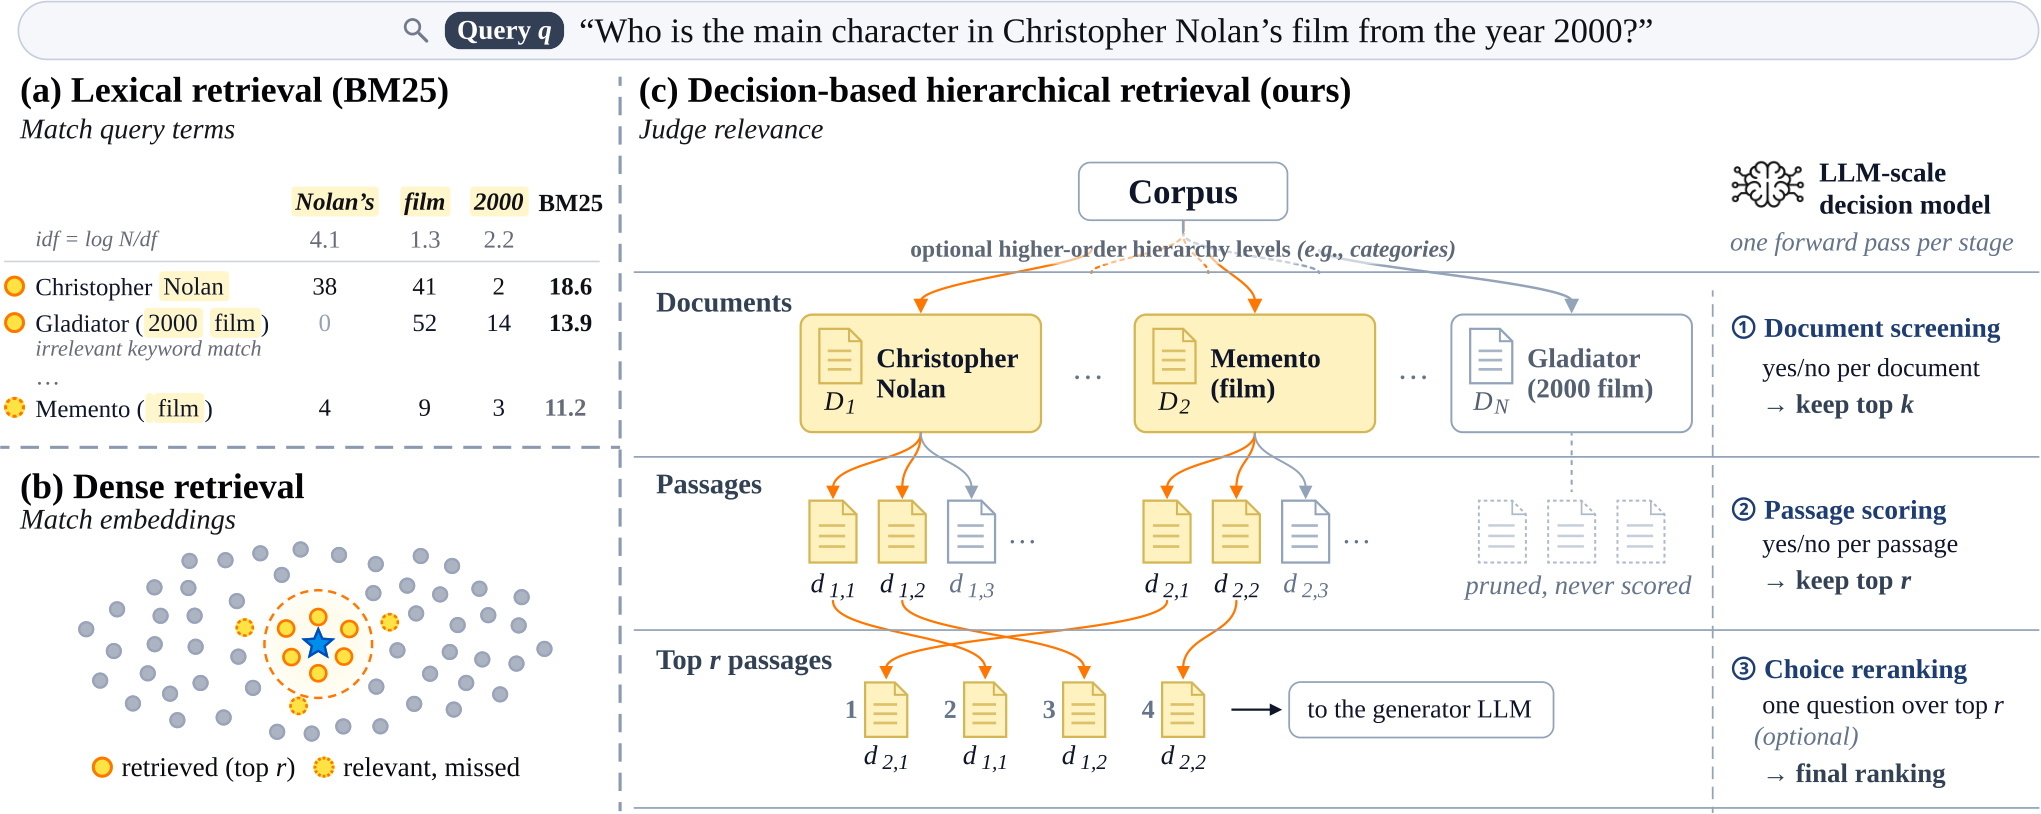
以 Natural Questions 这个 268 万段落的语料为例,流程是这样的:
| 层级 | 候选 | 决策模型做什么 | 留下 |
|---|---|---|---|
| 主题簇 | 1,000 个簇,每个簇用一句话概括 | 每个簇问一遍值不值得展开 | 150 个簇 |
| 页面 | 这 150 个簇下的约 17,500 个页面标题 | 分成多个请求并行判断 | 前 30 个页面 |
| 段落 | 前 3 页的全部段落、第 4–10 页各自的前十段、第 11–30 页各自的前三段 | 放在同一个上下文里判断 | 按分数排序 |
| 最后精排 | 前 5 个段落 | 改成一道多选题,让 5 个段落互相竞争 | 最终顺序 |
维基百科本身没有页面之上的层级,作者用页面标题和首句的 e5 embedding 做 k-means 聚成 1,000 个簇,再让 Qwen3-8B 根据簇里的页面标题写一句概括。其他三个数据集直接用现成的帮助中心、页面、小节标题结构。关键分工是:目录结构决定每一层要看多少候选,决策模型决定往哪几支走。下面拆开讲。
为什么要把候选放在同一个上下文里打分?
决策模型有两种用法。一种是并行是非题:上下文里写着 query 和这一层所有候选的描述,每个候选对应一道题“这个候选值得为这个 query 展开吗”,模型一次前向给出每道题答“是”的概率:
其中 是共享的上下文, 是关于第 个候选的那道题。每道题只在“是”和“否”之间归一化,所以各候选的概率加起来不必等于 1,候选数也只受上下文长度限制。另一种是多选题:把几个候选当成选项,概率在选项之间归一化、加起来等于 1。Jev 最多支持 255 个选项,所以多选题只用在最后的精排。
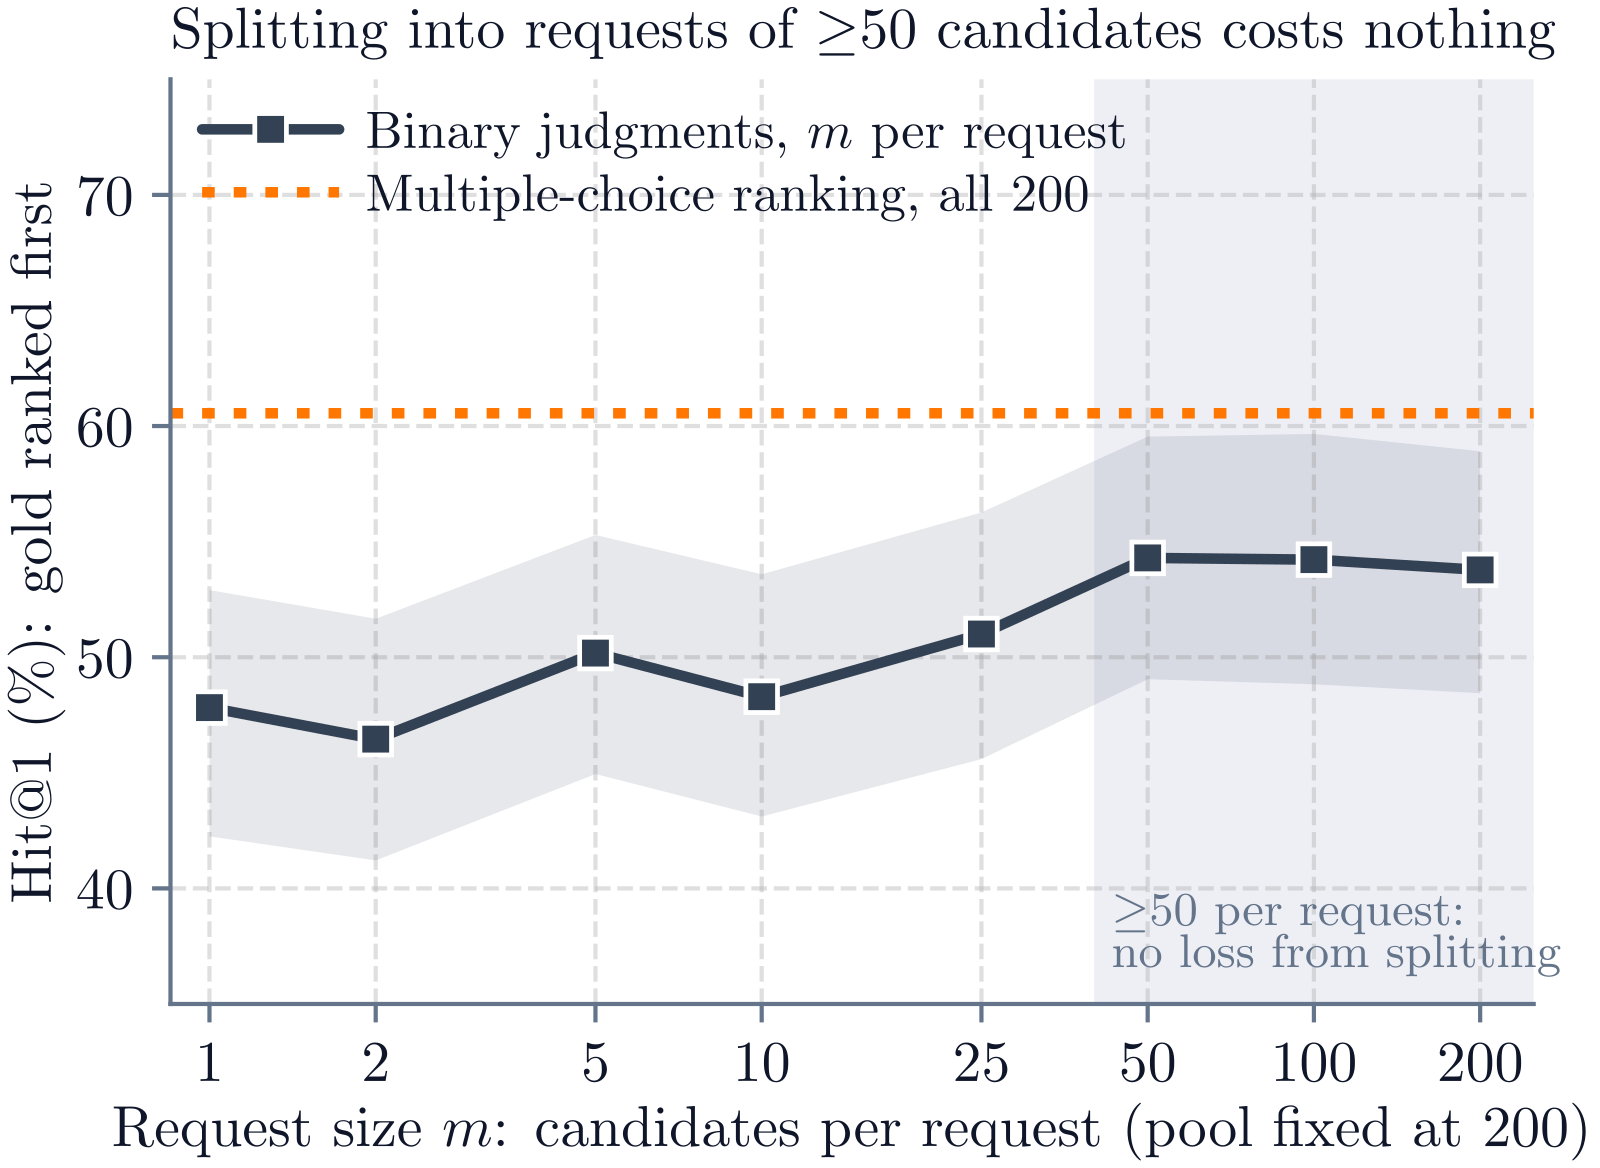
共享上下文怎样帮助判断?单独问“《角斗士》这一页值得看吗”,它和 query 有不少重合,模型可能给出 0.6(示意);把它和《记忆碎片》放在同一个上下文里问,模型看得到一个明显更好的选择,同一道题的概率就会降到 0.2(示意)。共享上下文能改善候选分数的可比性。筛选时更看重召回,可以直接汇总不同请求的分数。排最终顺序时,把候选放在同一个请求里比较更有帮助。
论文用一个固定的 200 个候选池验证这一点,候选来自正确段落加上 BM25、SPLADE-v3 和 e5 召回的难负例。每个候选单独一个请求时,Hit@1 是 47.8%;每 50 个候选放进一个请求,升到 54.3%,再增大请求基本不再提升。这说明可比性主要来自同一请求里的几十个对手,大的层级可以拆成每份约 50 个候选的并行请求,几乎不损失效果。在完整流程里也一样:MultiDoc2Dial 上把所有选中页面的段落放在一起打分,而不是一页一页地打,R@1 从 36.7% 升到 44.4%。
为什么语料变大,延迟几乎不变?
同一层的候选是并行判断的,所以延迟取决于层数,而不是段落总数。假设层级大致平衡、每个节点最多有 个孩子, 个段落大约需要 层;每层增加一次串行决策,延迟可估为:
是一次请求的延迟,论文里约 0.2 秒。手算一下(示意): 时,一百万个段落需要 3 层,约 0.6 秒;论文给出的例子是十亿个段落只需 5 层,约 1 秒。这里的前提是服务端能同时处理一层的所有请求。成本则跟判断的候选数成正比,每层最多判 个, 是上一层保留的节点数。
剪枝的风险在于不可逆:一个簇在第一层被丢掉,它下面的页面就再也找不回来。作者在 Natural Questions 上改变第一层保留的簇比例来看这个代价。保留 15% 的簇时,Recall@10 是 86.2%,比直接给全部 108,626 个页面标题打分的 84.5% 还略高,成本却只有五分之一。保留不到 5% 时,正确页面所在的簇经常被丢掉,只保留 1% 时 Recall@10 跌到 63.7%。这说明预算要往召回那一侧放,第一层宁可多留。
实验结果:不训练,也能赢过召回加精排
主实验比较的是不做任何任务训练的方法。下表摘出三个数据集的首位指标:MultiDoc2Dial 是政府帮助中心的多轮对话,看 R@1;ConditionalQA 是英国政府指南上的情景问答,Natural Questions 是真实搜索问题配维基百科,都看 Hit@1。
| 方法 | MultiDoc2Dial R@1 | ConditionalQA Hit@1 | Natural Questions Hit@1 |
|---|---|---|---|
| BM25 | 20.6 | 24.7 | 16.4 |
| 向量召回(Qwen3-Embedding-8B) | 27.9 | 47.2 | 46.2 |
| 向量召回前 100 + Qwen3-Reranker-8B | 33.6 | 64.6 | 48.0 |
| 向量召回前 20 + GPT-5 精排 | 47.5 | 73.4 | 60.8 |
| DecisionRAG | 47.4 | 69.7 | 65.4 |
| DecisionRAG + 向量召回候选 | 48.5 | 73.4 | 66.4 |
和 8B reranker 相比,DecisionRAG 在三个数据集上都明显更高,Natural Questions 上高 17.4 个点。和 GPT-5 精排相比互有胜负:Natural Questions 上是 65.4 对 60.8,ConditionalQA 上是 69.7 对 73.4。把向量召回的前 20 个段落也加进最后一层,三个数据集都再涨一点,说明两种方式找到的证据有互补。
收益到底来自导航,还是来自决策模型本身?作者让 Jev 直接精排向量召回的前 100 个段落,打分方式和 DecisionRAG 最后一层完全一样。Natural Questions 上,这样精排的 Hit@1 是 59.4%,沿层级导航加向量候选是 66.4%。有意思的是,向量召回前 100 里含有正确段落的比例更高,98.4% 对 94.0%;但两边都含有正确段落时,导航把它排到第一的比例是 70.1% 对 61.9%。导航时,模型在共享上下文里给候选段落做二元评分。这些段落按页面分组,按阅读顺序排列。作者认为,这样可能有助于判断。随后的多选精排只用二元评分后排名前 5 的段落作选项,上下文也只包含这 5 段。
和生成式导航相比,作者保持层级和预算不变,换成 GPT-5 逐层写出要保留的候选编号。Natural Questions 上 GPT-5 的 Hit@1 是 59.0%,DecisionRAG 是 65.0%,而 GPT-5 每个 query 要 250.8 秒,DecisionRAG 只要 1.73 秒。这说明在这一步,生成一串 token 并没有换来更好的判断。
检索质量也传到了最终回答。作者让同一个 Qwen3.5-27B 读各方法的前 5 个段落作答。在 MTRAG(IBM Cloud 技术文档上的多轮对话)上,回答被判为正确的比例从 Qwen3-Reranker 的 39.4% 升到 DecisionRAG 的 44.1%,说明多找对的证据确实变成了更多答对的回答。如果用 MultiDoc2Dial 的训练数据把 Qwen3-8B 训成专门的决策模型,R@1 到 60.7,比论文对比的最好的已发表任务训练召回模型高 5.7 个点。
我认为它的局限
第一,成本依赖一个商用接口。主实验用的是 TypeSafe AI 的 Jev,在 Natural Questions 上每个 query 2.33 美分,高于 GPT-5 精排的 1.40 美分;本地一张 A6000 跑的 Qwen3-Reranker 没有接口费。对日均千万次查询的搜索系统,这个单价很难接受,更适合查询量小、单次价值高的企业文档问答。
第二,层级和预算是按数据集调的。每层留多少个候选,各数据集都在单独的设计集上选过,比如 MultiDoc2Dial 留 10 个页面,ConditionalQA 只留 3 个。这意味着换一个语料就要重新调。预算太紧的代价很大,第一层只留 1% 的簇时 Recall@10 会跌到 63.7%。
第三,延迟数字有前提。理论延迟模型假设服务端能同时处理一层的所有请求。Natural Questions 上的实测延迟约为 1.7 秒。测量时,每次处理一个 query,每个 query 内最多八个请求并发。约 17,500 个页面标题拆成多个请求,每个请求最多 20k tokens。
一个推荐/搜索团队可以怎么试
- 先在已有目录结构的文档库上试,比如帮助中心、产品文档、知识库。这类语料不需要聚类,层级和节点描述现成,最容易看出导航本身有没有用。
- 先做精排对照,再做导航。用同一个打分模型分别精排现有召回的前 100 个结果、沿目录导航,比较首位命中率;如果导航赢不了精排,就没必要改架构。
- 第一层预算宁可放宽,并把向量召回的前 20 个结果也加进最后一层。论文里这一步几乎不增加成本,却能补回剪枝丢掉的证据。
- 同时记录每个 query 的请求数、并发数和费用。决定能不能上线的是单价和并发,而不是论文里的中位延迟。
一句话结论
把大模型用在召回这一步,关键是让它在同一个上下文里比较候选,而且不生成 token;DecisionRAG 证明了这条路在中小规模文档库上可行,大规模搜索还要等决策模型的单价降下来。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。召回能力跟不上生成模型,是 RAG 效果的常见瓶颈 |
| 方法创新性 | 中高。层级导航早有人做,新意在于用不生成 token 的决策模型并行判断整层候选 |
| 实验证据 | 中高。四个数据集、和 GPT-5 精排与生成式导航都做了对照,还有导航对精排的拆分;但预算按数据集调过 |
| 工程成本 | 中高。不需要索引和训练,但依赖商用决策模型接口,大语料上单价和并发压力都不小 |
| 是否值得尝试 | 值得在有目录结构的企业文档问答上试;高流量通用搜索暂不合适 |
| 适用场景 | 帮助中心、产品文档、法规指南这类结构清楚、查询量适中的检索 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…