目录 · 12 节
1为什么需要这样一个评测网络2整体结构:两条赛道各自固定什么3Open Track:怎么让难度不同的任务放在一起比4主动配对:把昂贵的试验花在最没把握的对比上5Fine-tune Track:同样的示范,微调后做得怎样6结果一:开箱能力,通用大模型不输 VLA,但谁都做不稳7结果二:微调后,谁强取决于机器人和任务8结果三:开箱排名预测不了微调后排名9结果四:排名靠得住吗,要多少次试验10我认为它的局限11一个模型评测团队可以怎么借鉴12结论
做机器人模型和评测的人值得读这篇,因为它用真实机器人上的大量对比说明:一个模型“开箱直接用”时排第几,和“拿同样的示范数据微调后”排第几,可以明显对不上,所以只看一张排行榜选模型是不够的。论文所说的“物理智能”,在本文里落到模型在真实机器人上完成操作任务(包括人形机器人边走边操作)的能力。RoboColosseum 是一个分布在 124 个真实场所(办公室、食阁、住家、工厂等)的评测网络,分两条赛道:Open Track 里,VLA(看画面和文字指令、直接输出机器人动作的模型)用已针对这种机器人训练好的权重、不针对具体任务再训练;两个匿名模型在同一台机器人、同一个任务上先后执行,由现场评测员比较。Fine-tune Track 让每个模型从各自的基础预训练权重出发,在每个任务上用同一批 100 条示范微调,再在固定任务上评测(基础权重通常是在多种机器人数据上预训练得到的;针对某种机器人的权重则用这种机器人的数据训练过,下一节细说)。在 Franka 机械臂上,π0.5 在 Open Track 的 5 个 VLA 里排第 5,微调后排第 1(两条赛道的任务和排名指标也不同,下文细说)。只看成功率也会漏掉差别:Fine-tune Track 里,Unitree G1 人形机器人的 5 个任务微调后没有一个策略完成过,但各策略的平均进度(每个任务列出几条进度标准,数一次试验满足了其中几成)从 13.3% 到 23.2% 不等。
为什么需要这样一个评测网络
先说现在的机器人策略是怎么来的。这篇评测的主角是 VLA(vision-language-action)模型:输入摄像头画面和一句文字指令,直接输出机器人动作(本文三种机械臂上就是各关节和夹爪的目标位置)。它们通常先在多种机器人、多种任务的示范数据上预训练,得到基础权重;再用某一种机器人的大规模数据继续训练,就得到针对这种机器人的权重(如 Franka 用的是大规模 Franka 机械臂示范数据集 DROID)。碰到新任务,可以拿针对这种机器人的权重直接上手试;想做得更好,通常再拿这个任务的示范做微调。下面两条赛道分别测这两种用法:Open Track 拿针对机器人的权重直接试,Fine-tune Track 从基础权重出发,用任务示范微调。这次参评的 5 个 VLA 模型 GR00T N1.7、π0.5、MolmoAct2、G0.5、LingBot-VLA v2 都属于这一类。以往的真机评测大多在一个实验室里、用受控的任务和环境来报告成功率。
问题是,这样得到的数字很难互相比较。同名任务换个场所,物体摆放、相机位置、光线、物体材质都会变,分不清差别来自模型还是来自场景。仿真可以反复复位、精确控制条件,但仿真里的感知、标定和物理与真实世界有差距,仿真成绩不一定能预测真机表现。真机评测又很费人:每次试验都要有人摆场景、复位、看护,所以论文里常常只跑很少的次数,结果容易受挑哪几次试验影响。
已有的分布式评测已经往前走了一步。RoboArena 让 7 所高校的评测员自己选任务和环境,每次把两个匿名策略放在相同场景下先后执行,一共积累了 612 次两两对比。但它只用一种机器人(按数据集 DROID 的采集配置搭建的 Franka 机械臂),任务也完全开放:每一对模型共享同一个场景,但不同的对各自做评测员自选的题,没法让所有模型面对同一组固定任务、用同一批数据训练,只比较模型本身;依靠学生和志愿者的方式也很难长期维持。
RoboColosseum 对应补了这三处。机器人覆盖 4 种:低成本单臂 SO-101、Franka、双臂 Bimanual-YAM、Unitree G1 人形机器人,100 多台分布在美国、英国、新加坡、马来西亚和中国。人手上,最多 30 名全职评测员负责执行、复位和打分。对照实验上,Fine-tune Track 固定每个任务的示范数据、任务定义和评分标准,并按任务卡规定的评测场所、物体和初始设置评测(任务目标固定,物体摆放和环境条件可在任务规范内变化),所以数据和评测规程对所有模型相同,有意改变的只有模型本身和它的微调流程。此外,推理既可以在配 RTX 5090 的本地笔记本上跑,也可以走远程服务器;评测录像会做人脸模糊;全部微调示范公开,并承诺给学术机构 1 万小时免费评测。
整体结构:两条赛道各自固定什么
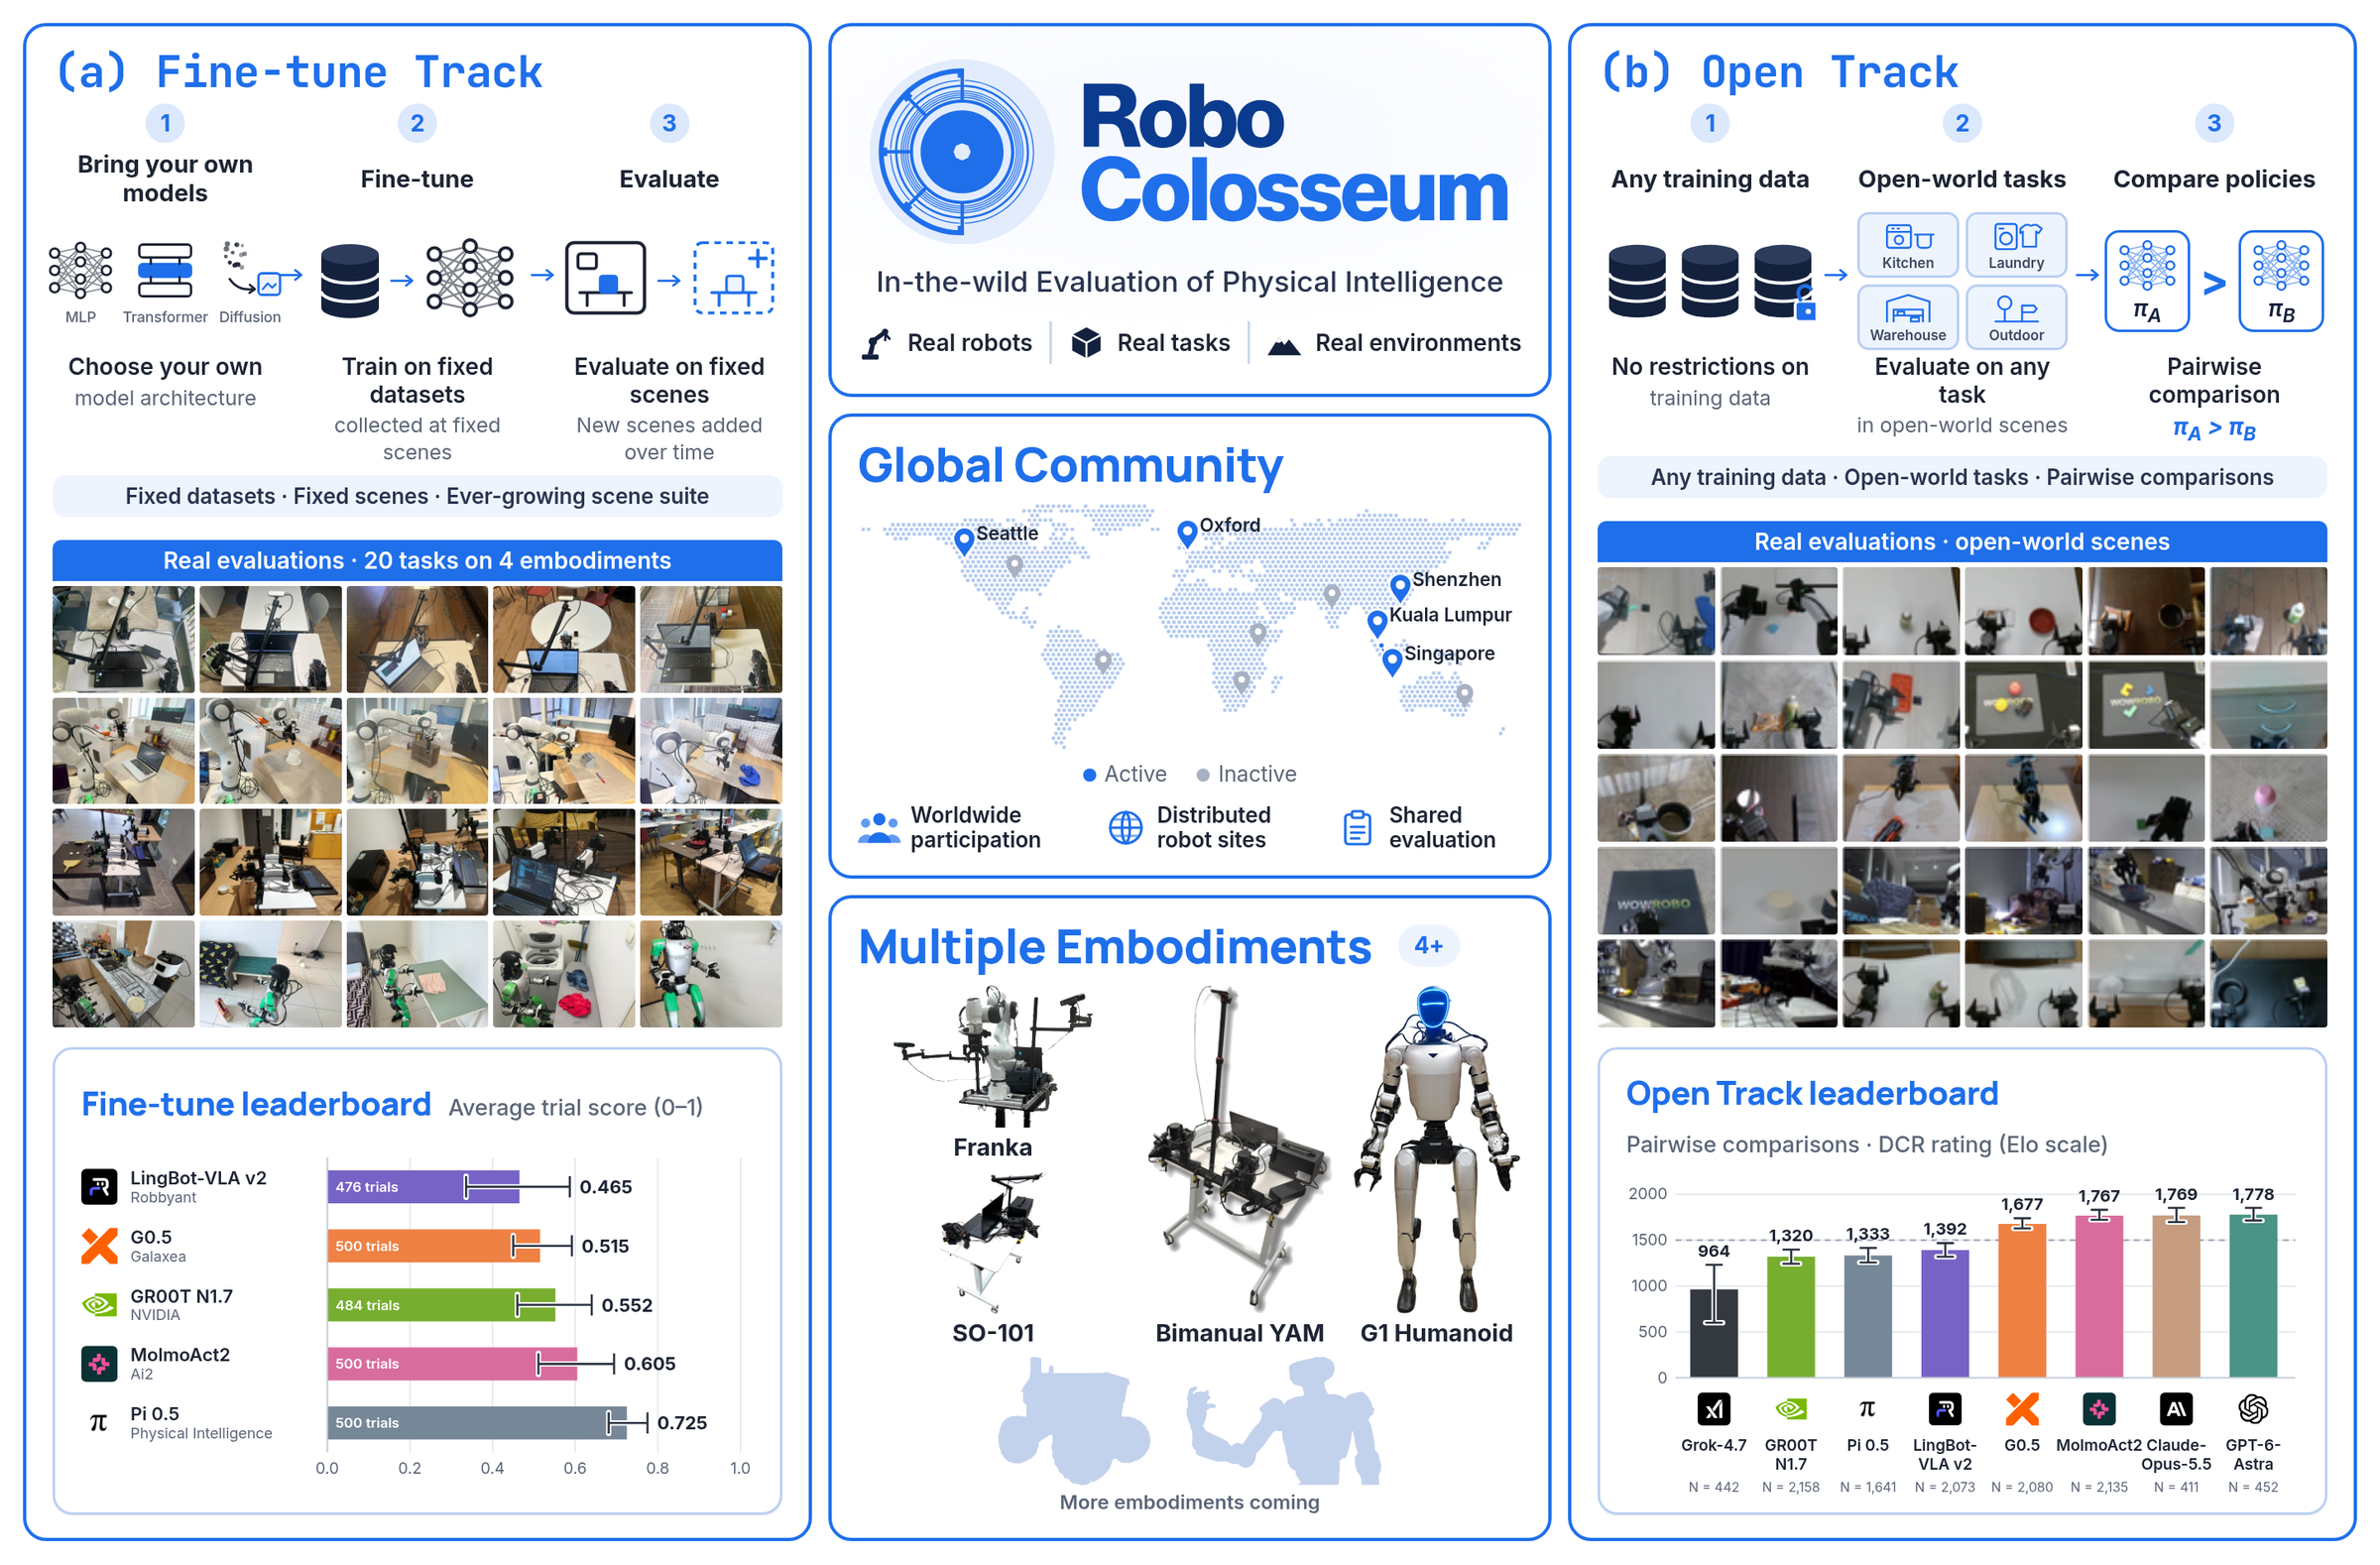
两条赛道的区别在于哪些东西固定、哪些允许变:
| Fine-tune Track | Open Track | |
|---|---|---|
| 测什么 | 拿同样的示范按各自流程微调后,模型在新任务上最终做得多好(不是和微调前比提高了多少) | 不做任务适配,模型在陌生环境里能做多少 |
| 起点权重 | 各模型的基础预训练权重 | VLA 用已在该机器人数据集上训练好的权重(如 Franka 用 DROID 数据集) |
| 固定的 | 每个任务同一批 100 条示范、同一套成功标准和进度标准、每个模型在每个任务上 25 个试验名额(因安全中止没跑的记 0) | 同一次对比里的机器人、指令、物体、初始摆放和超时时间 |
| 允许变的 | 每个模型按自己官方的微调流程训练,训练时长可以不同 | 任务和环境随对比变化,由各场所评测员自己出题 |
| 参与模型 | 5 个 VLA | 5 个 VLA,加 3 个通过 API 调用的通用大模型(GPT-6 Astra、Claude Opus 5.5、Grok 4.7) |
| 怎么排名 | 平均进度分和成功率 | DCR 评分(下文解释) |
论文的设计取舍是:不要求每个场所环境一样,而是让被比较的两个模型面对一样的条件。通用大模型只参加 Open Track。论文表 1 说,所列三种机械臂各有一套对所有策略、所有场所固定的输入和输出格式:输入是固定的几路摄像头画面(如 SO-101 是一路外部相机加一路腕部相机),输出是各关节和夹爪的目标位置;大模型经评测平台统一的接口接入。大模型是直接看这些画面、直接给出关节目标,还是经接口做了转换,论文没有交代。所以 Open Track 比的是“大模型加这套接入方式”整体和 VLA 的结果。下面拆开讲 Open Track 的打分,再讲 Fine-tune Track。
Open Track:怎么让难度不同的任务放在一起比
一次 Open Track 对比是这样进行的(场景为示意):某个食阁里的评测员推着 SO-101,用现场有的纸杯和托盘出一道题“把纸杯放进托盘”。系统给这位评测员分配两个模型 A 和 B,评测员不知道它们是谁。两个模型在同一台机器人上先后执行;第二个开始前,场景摆回同样的初始摆放,指令、物体和超时时间也相同。评测员记录谁做得更好(A 胜、B 胜或平局)、两个模型各自是否完成了任务、各自的任务进度分、文字反馈,以及评测员凭自己感受给这道题打的难度分(1 到 10 分,论文称为感知难度)。论文对开放赛道进度只讲到这一层:评测员按完成了多少中间要求打进度分,再归一化到 0 到 100%。
难点在于,5699 次对比用了 5699 道题,每道题只出现在一次对比里,而不同模型碰到的题难度差别很大。看一个示意:
| 模型(示意) | 碰到的题 | 成功次数 | 原始成功率 |
|---|---|---|---|
| X | 10 道简单题 | 6 | 60% |
| Y | 10 道难题 | 2 | 20% |
只看原始成功率,X 远好于 Y,但这可能只是 X 运气好、碰到的题容易。论文用 DCR(Difficulty-Calibrated Rasch,难度校准的 Rasch 模型)同时估计模型能力和题目难度。它用的是每个模型在每道题上各自成功与否,不是评测员的胜负判断(胜负和平局留给另一种对照排名方法 BTD(Bradley–Terry–Davidson))。可以把它想成统一考试:考生是模型,考题是任务;每个模型有一个能力值 θ,每道题有一个难度值 β,模型在这道题上成功的概率是
σ 是 logistic 函数,能力比难度高得越多,成功概率越接近 1。回到示意:若 X 的能力 θ=0、它碰到的简单题 β=−0.4,成功概率是 σ(0.4)≈0.60;若 Y 的能力 θ=1、难题 β=2.4,成功概率是 σ(−1.4)≈0.20。两者和表里的成功率基本对上。这说明 Y 的原始成功率更低,能力却可以更高,前提是能知道两组题各有多难。 Hoot 说

两条曲线是成功概率 σ(能力 − 难度):实线是能力 0 的 X,虚线是能力 1 的 Y,数字沿用正文的示意,并把每组 10 道题当成同一个难度。X 在它碰到的简单题(难度 −0.4)上约 0.60,Y 在它碰到的难题(难度 2.4)上约 0.20。换一下:Y 去做 X 那组简单题约 0.80,X 去做 Y 那组难题只有约 0.08,两种情况都是 Y 更高。拖动滑块看同一道题上两者的成功概率。真实的 Open Track 每道题只出现一次,题目难度要靠同题另一个模型的结果和评测员打的难度先验,与能力一起从全部对比里估出来。
出处
示意例子,对应论文 §3.2 的 DCR 成功概率 σ(θ_p − β_t);X、Y 及其数字为正文示意,不是论文结果题目难度从哪来?一部分来自评测员打的 1–10 分。因为每道题实测次数很少,论文不把这个分数直接当权重,而是当成先验:打了 k 分的题有一个典型难度 μ_k,并要求 μ_1<μ_2<…<μ_10,打分越高、典型难度越高;每道题的实际难度在 μ_k 附近正态分布,可以被实测结果拉开。另一部分来自两个模型在同一道题上的结果:两个都成功,说明这道题偏容易;两个都失败,说明偏难;一个成功一个失败,是倾向于成功一方能力更高的证据。单次结果带随机性,所以不是逐题下结论,而是把能力、难度和这套先验参数放在全部对比上一起估计,得到能力的后验分布,再按能力的后验均值排名,并换算成 Elo 风格的分数:R = 1500 + 400/ln10 × 能力值,能力值为 0 对应 1500 分。
主动配对:把昂贵的试验花在最没把握的对比上
真机对比很贵,所以下一次让哪两个模型对比,不是随机抽。先积累一批对比得到初步排名,之后照搬 Chatbot Arena 的做法:目标是让排名尽快定下来。对每一对候选模型 a,平台估计目前对“这两个谁强谁弱”有多没把握,以及再比一次能让这个误差下降多少,再按这个下降量的比例抽下一次对比:配对只决定下一次比哪两个模型,排名仍用同一个 DCR 方法。
Σ̂_a 是当前这一轮对这对模型的估计方差;论文没有说明它在 DCR 下具体怎么算。在它照搬的 Chatbot Arena 里(略去原方法的加权细节),被估计的是“这对模型里一方赢的比例”:每次对比记一个结果(赢记 1、输记 0),Σ̂_a 是单次结果的方差;n_a 是这对已经比过的次数;两者相除再开根号,就是这个胜率估计的标准误,也就是目前对“这两个谁强”还差多少把握,比得越多误差越小。示意:两对模型都胜负各半,单次结果的方差都是 0.25;一对只比过 4 次,再比一次的下降量是 0.25−0.224≈0.026;另一对已比过 100 次,下降量只有 0.05−0.04975≈0.00025。于是试验会集中在比得少、结果还不确定的那几对上。
Fine-tune Track:同样的示范,微调后做得怎样
每种机器人选 5 个任务,共 20 个,涵盖抓放、叠碗叠杯叠方块、扶正倒下的瓶子、开关抽屉和微波炉门、合笔记本盖、处理毛巾衣服、用簸箕和刷子清扫、双臂配合,以及人形机器人边走边操作。每个任务在评测现场、用同一台机器人通过遥操作采集 100 条示范。每个模型从自己的基础预训练权重出发,只用这 100 条数据全量微调,按官方流程训练到收敛。
每个任务都有一张任务卡,除了成功标准,还列出 K 条进度标准,每条权重相同;打分时只数满足了几条,不检查先后。一次试验满足了 s 条,进度就是 s/K;示意:一个任务有 4 条标准,一次试验做到其中 3 条,进度是 0.75,但不算成功。每个模型在每个任务上跑 25 次,进度分(PS)是这 25 次进度的平均,成功率(SR)是完全成功的比例。评测员因安全风险中止的试验记 0。进度分能区分“满足了大部分要求”和“一条要求都没满足”,这是成功率给不了的。不过它只是数了几条,要知道具体卡在哪一步,还得看每条标准各自有没有满足;对标准本身有先后的任务,论文看的是第一条没满足的是哪条,下文合笔记本盖的例子就是这样看的。
结果一:开箱能力,通用大模型不输 VLA,但谁都做不稳
按 DCR 排名,GPT-6 Astra 在 Franka 上的点估计最高,Claude Opus 5.5 在 SO-101 和 Bimanual-YAM 上最高。再看进度:在 901 次“一个通用大模型对一个 VLA、同一任务”的对比里,大模型进度更多的有 394 次,VLA 更多的 265 次,打平 242 次,大模型平均多出 5.3 个百分点。但这个优势不是所有大模型都有:Claude Opus 5.5 和 GPT-6 Astra 平均多出 12.1 和 11.0 个点,Grok 4.7 反而比 VLA 少 7.5 个点。这说明不做任务适配、经统一接口控制机器人的前沿通用大模型,已经能在真机上和专门的 VLA 一较高下,但差别取决于具体模型和机器人。
相对排名领先不等于能把事做完。论文用一个固定的语言模型分类器,把 Open Track 任务分成抓放、叠放摆放、开关、扶正翻转、柔性物体、工具与交互 6 类,每次对比里两个系统的执行各算一次。这里的相对得分这样算:在每一类里单独用 BTD 拟合按进度判的胜负(进度高者胜,相同算平)。然后算每个系统对上一个假想对手时的期望得分:这个对手的能力处于这一类参评系统的平均水平;期望得分就是赢的概率加上一半平局的概率,50% 就是平均水平。MolmoAct2 在 6 类里都是 VLA 中这项得分最高的(58% 到 77%),但它的成功率只有 6% 到 13%,没有任何一个系统在任何一类的成功率超过 13%;论文也提醒,这些成功率的绝对值还取决于每个系统实际测了哪些任务和机器人。按评测员打的难度看,1–4 分的题成功率是 30.7%,9–10 分的题只有 0.4%;没成功的那些执行里,平均进度也从 56.6% 掉到 3.5%。这说明难题上策略往往离成功还很远就已经卡住,而不是差最后一步。
结果二:微调后,谁强取决于机器人和任务
| 机器人(5 个任务平均) | GR00T N1.7 | π0.5 | MolmoAct2 | G0.5 | LingBot-VLA v2 |
|---|---|---|---|---|---|
| SO-101 PS / SR | 89.0 / 82.4 | 85.4 / 77.6 | 71.8 / 59.2 | 58.8 / 40.0 | 55.2 / 36.8 |
| DROID Franka PS / SR | 56.4 / 42.4 | 91.2 / 84.0 | 78.2 / 54.4 | 44.8 / 16.0 | 59.4 / 40.8 |
| Bimanual-YAM PS / SR | 52.6 / 20.0 | 97.2 / 93.6 | 72.1 / 49.6 | 89.1 / 75.2 | 48.3 / 30.4 |
| G1 人形 PS / SR | 22.7 / 0.0 | 16.3 / 0.0 | 19.8 / 0.0 | 13.3 / 0.0 | 23.2 / 0.0 |
数字来自论文表 2(%)。Bimanual-YAM 上有两格因安全原因提前停止:GR00T N1.7 的 microwave 任务在 9 次后停、LingBot-VLA v2 的 drawer 任务在 1 次后停,没跑的试验记 0,拉低了这两个模型的平均。SO-101 上 GR00T N1.7 第一,Franka 和 Bimanual-YAM 上 π0.5 第一,G1 上没有任何成功。按微调后的平均进度分给四种机器人分别排名,四份排名的一致性 Kendall W 只有 0.24,离完全一致的 1 很远。因为每种机器人的任务也不同,这不能全归因于机器人形态,但说明在一种机器人的任务上领先,换一种不一定还领先。
平均数下面还有更细的差别。同在 Franka 上,LingBot-VLA v2 开抽屉成功 100%、把记号笔插进笔筒 0%;MolmoAct2 正好相反,分别是 0% 和 88%。每个任务都是用各自的 100 条示范单独微调的,所以这说明:一个模型用某个任务的示范微调得好,换一个任务、用那个任务的示范微调,不一定还好。
合笔记本盖这类任务的动作本身有先后,论文专门挑它来看失败卡在哪一步。按论文提到的几个阶段:先接触盖子并开始压低,再压过一半,再接近合上,最后完全合上。G0.5 在 25 次中全都完成了第一步,但有 24 次没压到一半;MolmoAct2 有 24 次接近合上,却只完成 7 次;π0.5 25 次都接近合上,完成 17 次。这说明同样的示范数据,G0.5 卡在前半程,另两个卡在最后一步,而且最后一步的通过率也不同,只看成功率看不出这一点。
结果三:开箱排名预测不了微调后排名
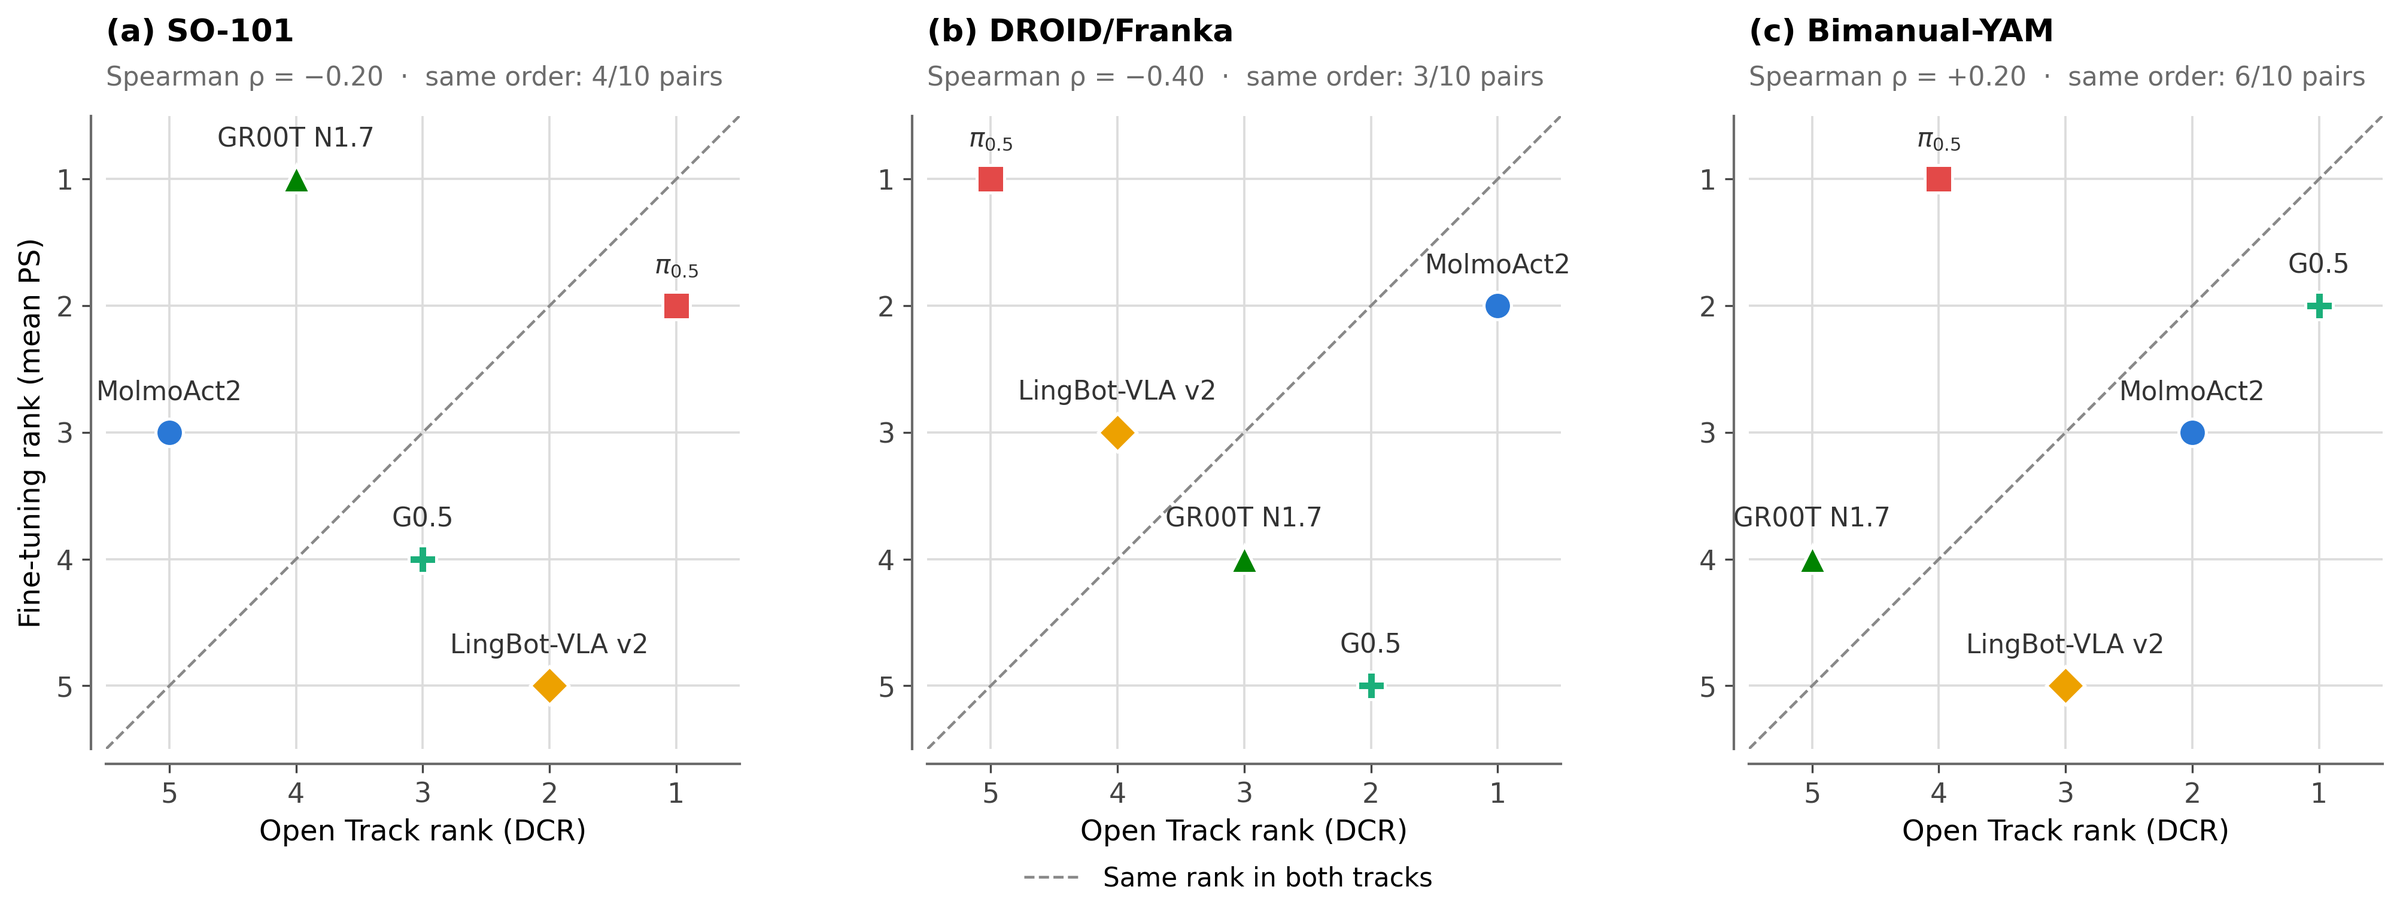
论文表 1 只列出 SO-101、Franka、Bimanual-YAM 三种机器人的 Open Track 训练数据,摘要也说两条赛道共有的就是这三种,所以跨赛道比较只覆盖三种机器人。图 9 里没有一个点正好落在对角线上,多数只差一两名,但有几次大幅反转。两条赛道名次的 Spearman 相关在 SO-101、Franka、Bimanual-YAM 上分别是 −0.20、−0.40 和 0.20;5 个模型两两组成 10 对,在两条赛道里先后顺序不变的只有 4、3、6 对。π0.5 在 Franka 上从开箱第 5 变成微调后第 1,G0.5 从第 2 变成第 5。作者自己提醒,两条赛道的任务、起点权重和排名指标都不同,所以不能把差异全归到“泛化能力”和“适应能力”上。但至少可以说,开箱强的模型微调后不一定强。
结果四:排名靠得住吗,要多少次试验
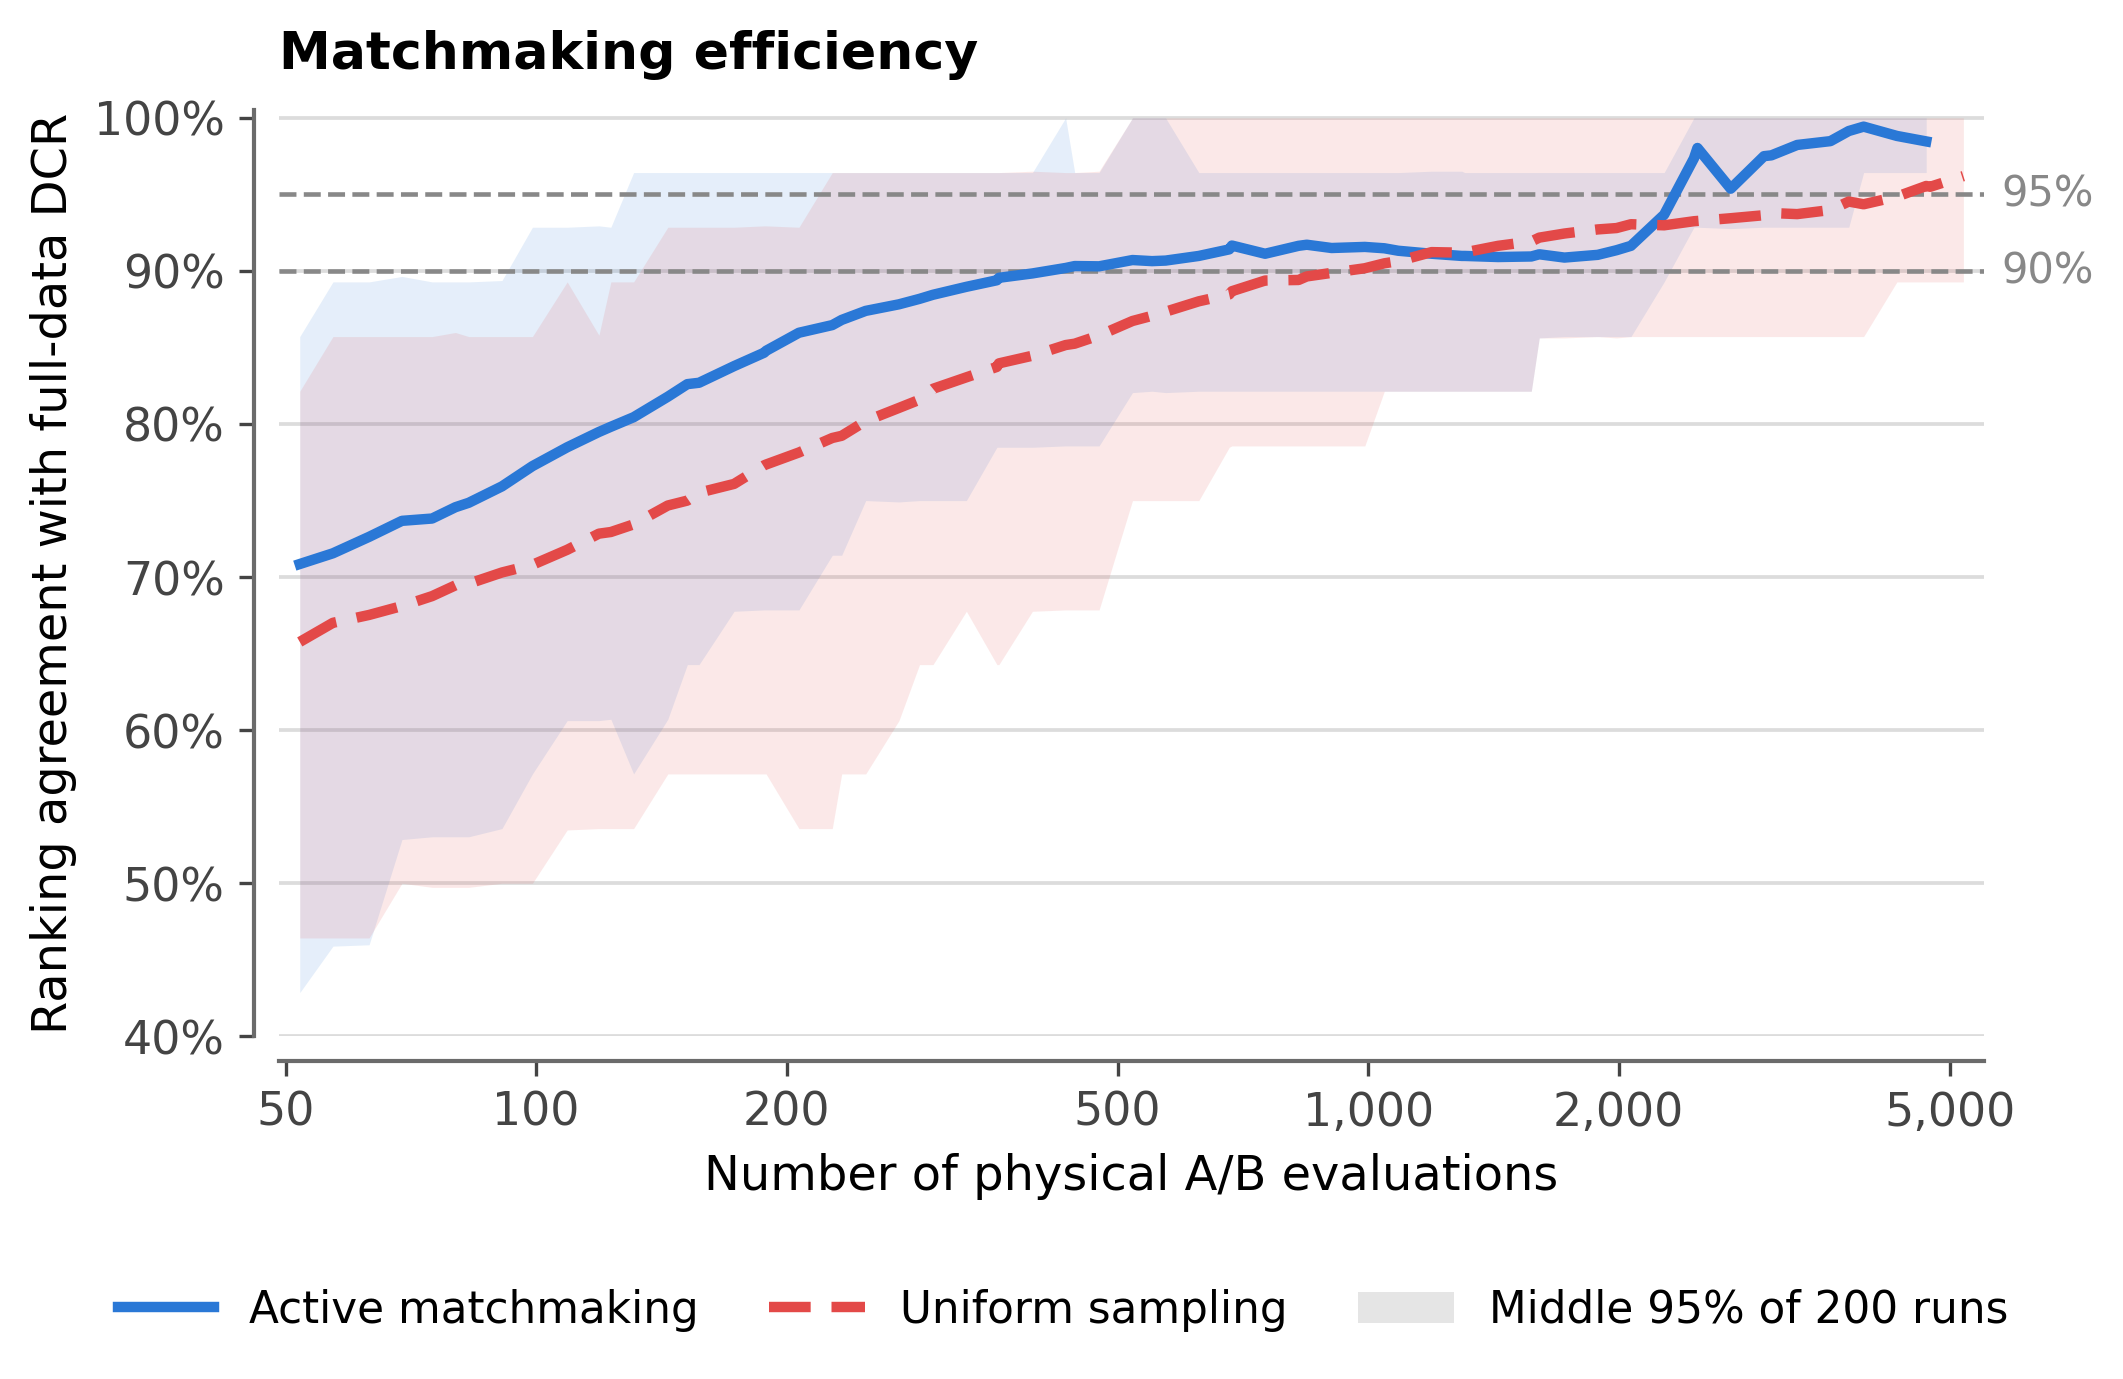
这里的“一致度”都指:两份排名里,模型两两之间先后顺序相同的比例。论文做了三项检查。
第一项看换一批场所排名会不会变:对每种机器人,把评测场所随机分成两半,同一场所的数据只进一半,各自算一次 DCR 排名再互相比较。Franka 和 Bimanual-YAM 两半之间约 85% 一致,SO-101 只有 59%,说明 SO-101 的排名很受哪些场所参与的影响。
后两项的参照是全量数据的 DCR 总榜:同一个系统在各种机器人上的对比都算作它的数据,8 个系统排成一张榜,反映的是各系统在这次实际收集到的机器人和任务组合上的综合表现,不是在一套统一的机器人组合上比。第二项比较两种分配方式(图 11a)。论文图注只写了 200 次独立运行。每次运行都要一路累积到几千次对比,200 次运行累计需要的对比数远超全部 5699 次真机对比,所以应是离线模拟(例如在已收集的数据上按两种规则重新抽样),而不是重新做真机试验;具体怎样逐步抽样,图注和正文都只给到这一步,所以这条曲线只能当作报告的结果来读。两种方式用同一个 DCR 排名方法,并都和全量数据总榜比。在这个设置下,主动配对约 400–500 次对比就能和全量数据排名达到约 90% 一致,均匀抽样要约 1000 次;预算更大时,两者都接近全量排名,差别逐渐缩小。
第三项看总量:每个预算下随机抽 200 个包含全部 8 个系统的子集,和用全部 5699 次对比得到的排名比较。平均一致度在约 1123 次时达到 90%、约 4755 次时达到 95%,但同样大小的不同子集之间仍有明显波动。这说明大致的排名很早就出来了,要稳定到不随抽到哪些对比而变,需要多得多的试验。
我认为它的局限
第一,后两项检查的参照是自己的全量数据排名,不是某个真实答案,作者也承认这一点;而第一项里 SO-101 两半场所之间只有 59% 一致,这台机器人的排行榜目前还不稳。
第二,跨赛道比较的样本很小。每种机器人只有 5 个模型、10 对,Spearman 从 −0.40 到 0.20 这样的数字受一两个模型换位影响很大;加上两条赛道的起点权重和指标都不同,π0.5 从第 5 到第 1 这样的大幅反转值得重视,但具体相关系数不宜多读。
第三,“通用大模型不输 VLA”只在开箱条件下测过:这些大模型不参加 Fine-tune Track,比的又是“大模型加接口”的整体。Fine-tune Track 允许各模型用自己的官方微调流程,测的是“同样数据下的端到端效果”,不是架构本身谁更好。
一个模型评测团队可以怎么借鉴
- 先把“同一条件下两两对比”做起来:两个匿名模型在同一输入、同一环境下先后执行,评测员除了判谁更好,还分别记下两边是否成功和进度。这样不需要统一场地,也能在每一次对比内部排除“场景不同”带来的差异;但不同对比的题目难度仍不一样,把它们合起来排名还要靠第 3 条的难度校准。
- 记录部分完成的进度,而不只是成败。为每个任务列几条可核对的进度标准,并逐条记下是否满足,能看出模型卡在哪一步;G1 上全是 0 成功,靠进度分才看出各模型之间的大致梯度。
- 用能力和难度一起估计的模型排名,把评测员的难度打分当先验。判断排名稳不稳:把评测场所分两半各算一次排名,看两半是否一致。
- 对比次数有限时用主动配对,把试验集中在不确定的模型对上;按论文图 11a 的比较,这样做把达到约 90% 一致所需的对比从约 1000 次降到 400–500 次。
结论
RoboColosseum 最值得带走的一点是:机器人模型的强弱要分“开箱能做什么”和“给同样数据微调后能做到什么”两问来回答,两者的排名可能明显不一致,个别模型的名次会大幅反转。它同时给出了一套让分散各地的真机评测可以放在一起比的做法,并且在 Franka 和 Bimanual-YAM 上,用互不重叠的两半场所各算一次排名,约 85% 的模型对先后一致。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。真机评测难复现、难比较,是通用机器人模型落地前绕不开的问题 |
| 方法创新性 | 中。两两盲评、难度校准、主动配对都有前例,贡献在多机器人、多场所的规模化组织 |
| 实验证据 | 中高。5699 次开放对比、20 个微调任务,但每种机器人的跨赛道比较只有 5 个 VLA,SO-101 排名还不稳 |
| 工程成本 | 高。论文的网络有 100 多台机器人和全职评测员,多数团队只能借鉴协议 |
| 是否值得尝试 | 值得借鉴两两盲评、进度标准和难度校准的排名方法;选模型时两条赛道的结果都要看 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…