
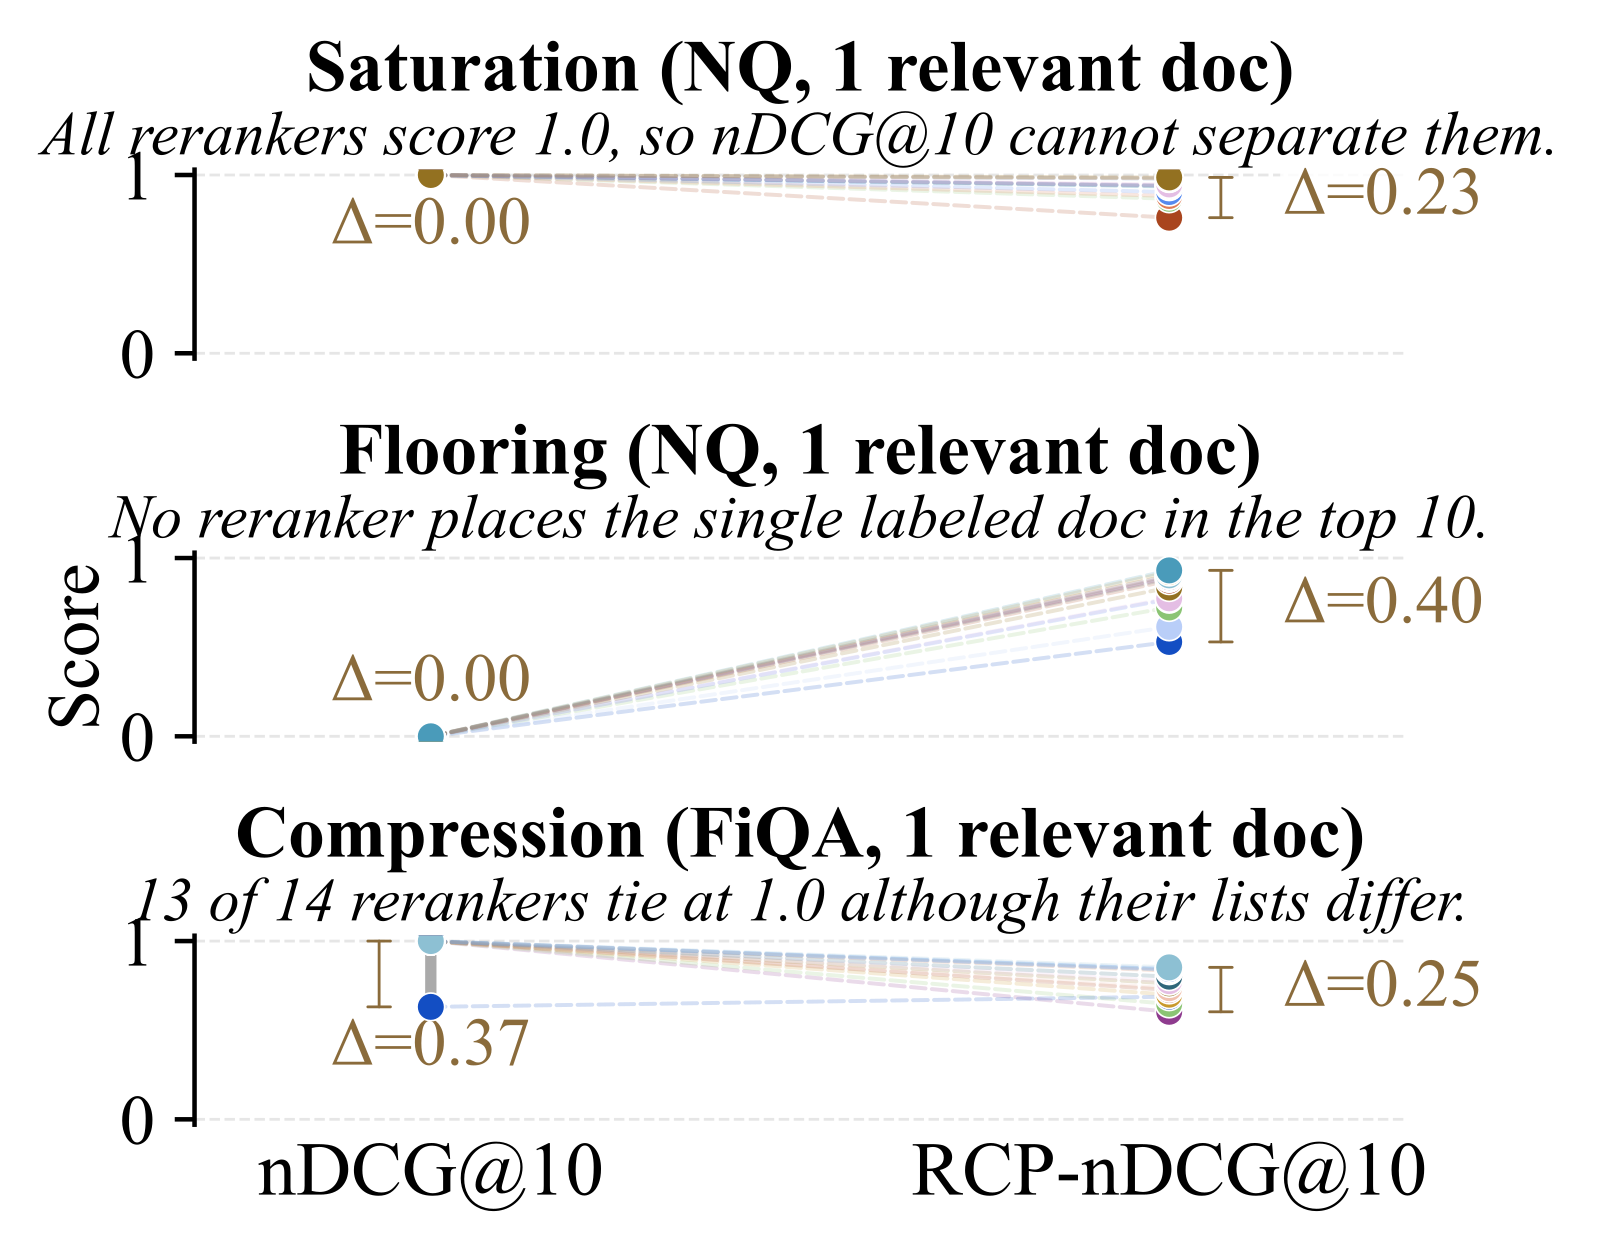
在作者评测的 14 个重排器上,NanoBEIR 有 45.6% 的查询、BRIGHT 有 30.7% 的查询,nDCG 根本分不出高下:要么所有重排器都得 1 分(饱和),要么都得 0 分(触底),要么 14 个重排器两两之间有一半以上的组合分数相同(压缩)。根源在人工相关性标注(qrels):又贵又稀疏,有噪声,而且只有几个离散等级,重排器之间越接近,这个问题越严重。Cohere 的作者提出 RCP(Rubric-Calibrated Preferences)。它先让 LLM 每次读 10 篇文档、给它们打分,多轮比较后汇总出同一查询下所有文档的细致排序;再让 LLM 对每篇文档回答五个是/否问题,借助项目反应理论(IRT)用这些答案把不同查询的分数换算到同一把尺子上,最后得到增益连续的 RCP-nDCG。拿 46 名外部标注员的盲评做对照,RCP 增益把“有用文档排在无用文档前面”的概率做到 0.910,原来的 qrels 只有 0.651;在 NanoBEIR 上,能被显著区分的重排器对从 34.1% 提高到 63.5%。
1. 问题:相对判断没有共同尺度,绝对判断太粗
用 LLM 当相关性评审,可以大规模地标注,质量也接近人工。但 LLM 的两种判断方式各有短板。第一种是相对判断,也就是两两或列表式比较。它能把同一查询下很接近的文档分开,可不同查询之间的分数没有共同尺度,没法变成分级标签,也没法设统一阈值或跨查询统计。Bradley–Terry(BT)模型只看两篇文档的分数差,给一个查询下所有文档同时加上同一个常数,结果完全不变,所以两个查询的分数没有共同的零点,不能直接比。评审在某些查询上判断更果断,分数拉得更开,不同查询的分数幅度也就不一致。第二种是绝对判断,也就是直接打等级。它可以跨查询比较,但等级太粗,同一查询下大量文档会打平。
作者想回答的问题是:用一套固定的是/否标准,能不能把同一查询内的 LLM 偏好放到所有查询共享的尺度上,而且结果和人的判断一致?他们选在重排评测里检验,因为这里有独立的人工参照,而这样得到的分数也正好能替代稀疏、离散、有噪声的 qrels。
2. 方法:锦标赛定顺序,量表定尺度
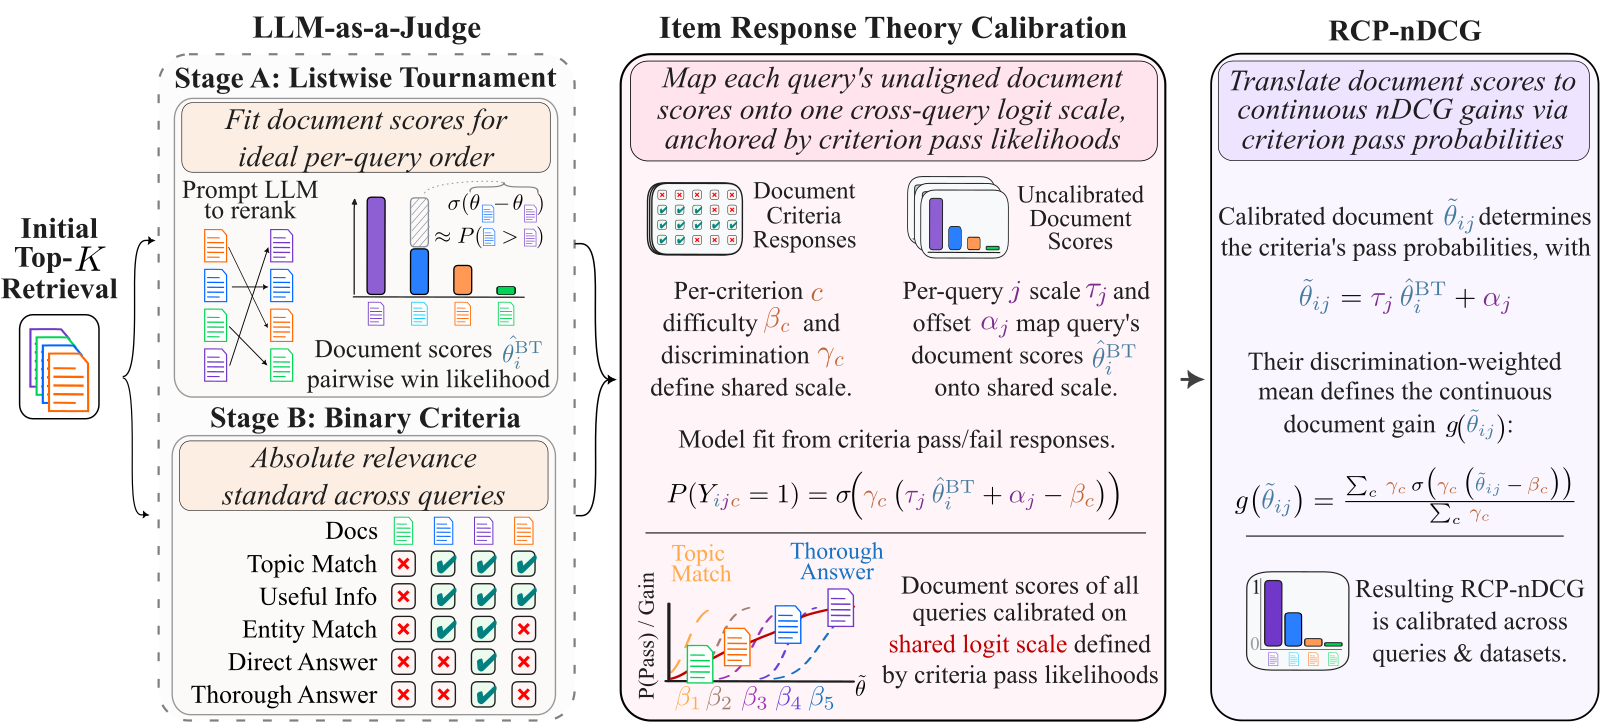
IRT 原本用在考试上:根据考生对同一组题目的作答,把所有考生放到同一个能力尺度上。RCP 借用这个思路,把文档当考生,把量表里的标准当题目。整个流程分两个阶段,再加一步校准。
第一个阶段用锦标赛定出每个查询内部的顺序。每个查询有 150 篇候选文档。评审 LLM 每次调用只读其中 10 篇,一次调用里放在一起的这 10 篇文档叫一个“窗口”。评审给窗口里每篇文档打一个 到 的分,提示词告诉它把这个分当 logit 用:两篇文档分差越大,表示评审越确定前一篇更相关。同一篇文档放在不同窗口里,得分可能不一样,原始分数在窗口之间不能直接比,所以作者只用同一窗口内的分差:把每两篇文档的分差换成偏好概率 ,10 篇文档两两组合共 45 对;再用 BT 模型把所有窗口的两两偏好合在一起,给每篇文档拟合出一个总分。
窗口怎么组,作者分三轮安排,每一轮解决一个问题。第一轮随机组窗口,让 150 篇文档都被评审看过几次,先得到一个粗略分数。第二轮按粗略分数把水平相近的文档放进同一个窗口。原因是评审给分会受同一窗口里其他文档影响:一篇中等文档如果总是和明显强得多的文档放在一起,会被衬得更差,分数被压低。这两轮共 80 个窗口,每个窗口还会把 10 篇文档倒过来排,再给评审看一遍,所以一共调用 160 次。第三轮是自适应的,目的是把剩下的调用花在名次还没定、而且值得分清的地方。它分 7 批,每批 8 个窗口。每批开始前,先用已有的全部比较重新拟合 BT 分数,再给当前排序里每两个相邻名次打一个“值得再比”的分,这个分由三个因素相乘:BT 预测这两篇谁在前的概率越接近一半,也就是越像抛硬币,分越高;名次越靠前,分越高,权重就是 nDCG 的位置折扣;两篇以前同处一个窗口的次数越少,分越高。然后贪心地挑 8 个窗口,每个窗口取当前排名上连续的 10 篇,每次挑“值得再比”分加起来最大的那一段;挑中以后,这一段里的分要打折,下一个窗口就不会再挑同一段。这一轮调用 56 次,加上前两轮的 160 次,每个查询共调用评审 216 次,平均每篇文档出现在约 14 个窗口里。
第二个阶段让评审按绝对标准逐篇作答。评审同样一次读 10 篇,但不再互相比较,而是对每篇文档单独回答五个是/否问题,难度一个比一个高。每个查询安排 100 个这样的窗口,前 50 个尽量让每篇文档出现次数均匀,后 50 个把初步估计水平相近的文档放在一起,平均每篇文档被问到约 6.7 次。五个问题如下:
| 编号 | 标准 | 诊断问题 | 区分度 γ | 难度 β |
|---|---|---|---|---|
| C1 | 主题相关 | 主题是否明确与查询的信息需求相关? | 1.17 | −2.57 |
| C2 | 信息有用 | 是否包含能回应查询的具体有用信息? | 1.05 | −2.00 |
| C3 | 实体/细节匹配 | 是否点名并讨论了查询里的特定实体或细节? | 0.94 | −0.25 |
| C4 | 直接回答 | 是否明确直接地回答了查询的主要问题? | 1.16 | 0.71 |
| C5 | 深入处理 | 是否深入而非浅尝辄止地处理了主题? | 0.69 | 4.12 |
(参数为 NanoBEIR、评审 Qwen3.5-397B 下的拟合值。难度越高,文档要越相关才能通过这条标准;区分度越高,这条标准越能把相关性略高和略低的文档分开。)
最后一步用这些作答把各个查询对齐到同一尺度。BT 分数和 IRT 两参数模型(2PL)的能力值都在 logit 尺度上,所以作者把 BT 分数做一次线性变换,当成文档的“能力”,也就是 IRT 里衡量文档相关性强弱的分数。下面的式子给出文档 在查询 下通过标准 的概率:
每条标准的区分度 和难度 在所有查询间共享。每个查询有自己的偏移 ,补上 BT 缺的那个常数;还有自己的缩放 ,让“能力差一个 logit”在每个查询上代表同样大的相关性差别。拟合时 BT 分数本身不动。所有查询的第二阶段作答放在一起,同时估计各条标准共享的 、 和每个查询自己的 、,目标是让式子预测的通过率尽量贴近实际作答。因为 ,每个查询内部的顺序一定和第一阶段一样(命题 3.1),校准只改变不同查询之间怎么比。
有了统一的能力值,就能定义 RCP-nDCG:把 nDCG 里的离散增益,换成按区分度加权的“各条标准的通过概率”:
从 0 平滑地升到 1,在各条标准的难度附近上升最快,因为能力值越过一条标准的难度,通过它的概率就会明显上升。计算 nDCG 需要的理想排序,直接用第一阶段排出的顺序。在 NanoBEIR 上,79.3% 的候选文档能力值低于 C1 的难度,也就是连“主题相关”都算不上;只有约 15.6% 落在 C1 和 C4 的难度之间, 在这一段从 0.22 升到 0.69,所以靠前的候选主要靠这段拉开差距。
举个假设的例子看校准改变了什么。查询 A 下排第一的文档通过了 C1 到 C3,查询 B 下排第一的文档只通过了 C1。BT 分数只在各自查询内部有意义,两篇文档都是本查询的最高分,单看 BT 分数分不出谁更相关;校准后,A 的第一名会落在更高的能力值上,增益也更高。
3. 实验设置与校准质量
评测覆盖四组数据:NanoBEIR 的 13 个数据集和 BRIGHT 的 12 个任务(都是二元 qrels)、TREC-DL 2019 和 2020(NIST 评估员打 0–3 分级),以及 ViDoRe v3 的 8 个语料(三级)。为了只比较重排,每个查询的候选池固定为三个检索器(Cohere Embed v4、Octen-Embedding-8B、BM25)用 RRF 融合后的前 150 个,检索器漏掉的正例会替换掉排名最低的候选。被评的 14 个重排器来自 Cohere、Contextual AI、Qwen3 Embedding、Voyage AI、Jina AI、ZeroEntropy 六个家族。主评审是 Qwen3.5-397B,第二评审是 gpt-oss-120b,用来检查结论会不会随评审变化。
人工对照是这样做的。作者请了 46 名付费的外部标注员,每人至少有所标学科的学士学位。每场对比是一个查询加两个重排器各自的前五名,标注员按随机顺序给两份列表合起来的文档打分,看不到文档来自哪份列表,也看不到 qrels 和指标分数。最后分析了 311 场对比、7,080 个人工评分,每场三人。
校准本身是可靠的,主要证据有三条。第一,知道一篇文档校准后的能力值以后,它过不过一条标准,对预测它过不过另一条几乎没有额外帮助(作答之间的平均绝对相关从原始的 0.60 降到 0.123),所以 IRT 要求的“各题独立”大体成立。第二,在其他数据集上拟合的标准参数搬到留出的数据集上,预测作答的交叉熵比“按每条标准的平均通过率猜”低 60.6%,说明参数能迁移。第三,每个查询的缩放 在 5% 和 95% 分位之间差了约三倍,说明各查询的尺度确实不一样,这个缩放项是必要的。
校准也让分数更接近人。ECE(校准误差)衡量预测概率和实际发生频率的平均差距,0 表示完全一致。直接对 BT 分数取 sigmoid、不做查询缩放时,预测作答的 ECE 是 0.371,2PL 校准后降到 0.017。增益 还可以读成“一名标注员把这篇文档评为有用及以上的概率”,拿 7,080 个人工评分检验,ECE 为 0.054,说明这个读法基本成立。查询平均分和标注员平均评分的 Spearman 相关,从原始 BT 的 0.538 升到校准后的 0.795。
4. 主要结果:更会区分,而且分得对
先看标签本身对不对。在人工盲评过的 2,268 篇文档上,RCP 增益把有用文档(人工平均分 ≥2)排在无用文档前面的概率是 0.910,二元 qrels 只有 0.651,因为大约一半这样的文档对在 qrels 里标签相同。qrels 在两个方向上都和人不一致:标注员认为没有正例 qrel 的文档里有 27.8% 其实有用,有正例 qrel 的文档里有 37.5% 其实没用。
再看能不能分出重排器的高下。作者用配对 t 检验统计 91 对重排器里有多少对被显著区分:NanoBEIR 上 qrel-nDCG@10 是 34.1%,RCP-nDCG@10 是 63.5%。BRIGHT、ViDoRe v3 和两年的 TREC-DL 上也都区分得更多,换 gpt-oss-120b 当评审,结论不变。作者还做了一个只用量表的对照 Count-nDCG:一篇文档的增益就是它在第二阶段全部作答里通过标准的比例,不经过锦标赛排序,也不做 IRT 校准。它区分出的对数和 RCP-nDCG 差不多,所以多出来的区分力主要来自量表。不过 Count-nDCG 会让同一查询下很多文档得分相同,锦标赛能把这些文档继续排开。作者分别按两种方法排出每个查询的理想前十,请三个不同家族的 LLM 盲评哪份更好,它们在 80.6–98.8% 的查询上选了 RCP-nDCG 的那份,说明更细的差别要靠锦标赛来分。
分得多还不够,还要分得对。每位标注员给两份列表的文档打完分后,按他自己的评分分别算出两份列表的 nDCG@5,分高的那份就是他选的列表;多数标注员选中的那份算作这场对比的结论。只看结论恰好和一个指标一致的 185 场(包括另一个指标打平、没选任何一份的情况),和结论一致的是 RCP-nDCG 的占 72.4%。随机水平不是一半而是 52.7%,算法是假设标注员随机选:两个指标选了不同列表时,各有一半机会和结论一致;只有一个指标分出胜负、另一个打平时,这场只可能算给分出胜负的那个。qrel-nDCG 打平的场次更多,这类场次大多只能算给 RCP-nDCG,所以随机水平略高于一半。RCP-nDCG 分差达到 0.20 以上时,标注员 96.8% 和它结论一致;qrel-nDCG 同样分差下只有 53.1%。TREC-DL 上,NIST 等级能显著区分的重排器对,2019 年只有 14 对、2020 年 37 对,RCP-nDCG 在这些对上全部和 NIST 一致,同时还多区分出了许多对。
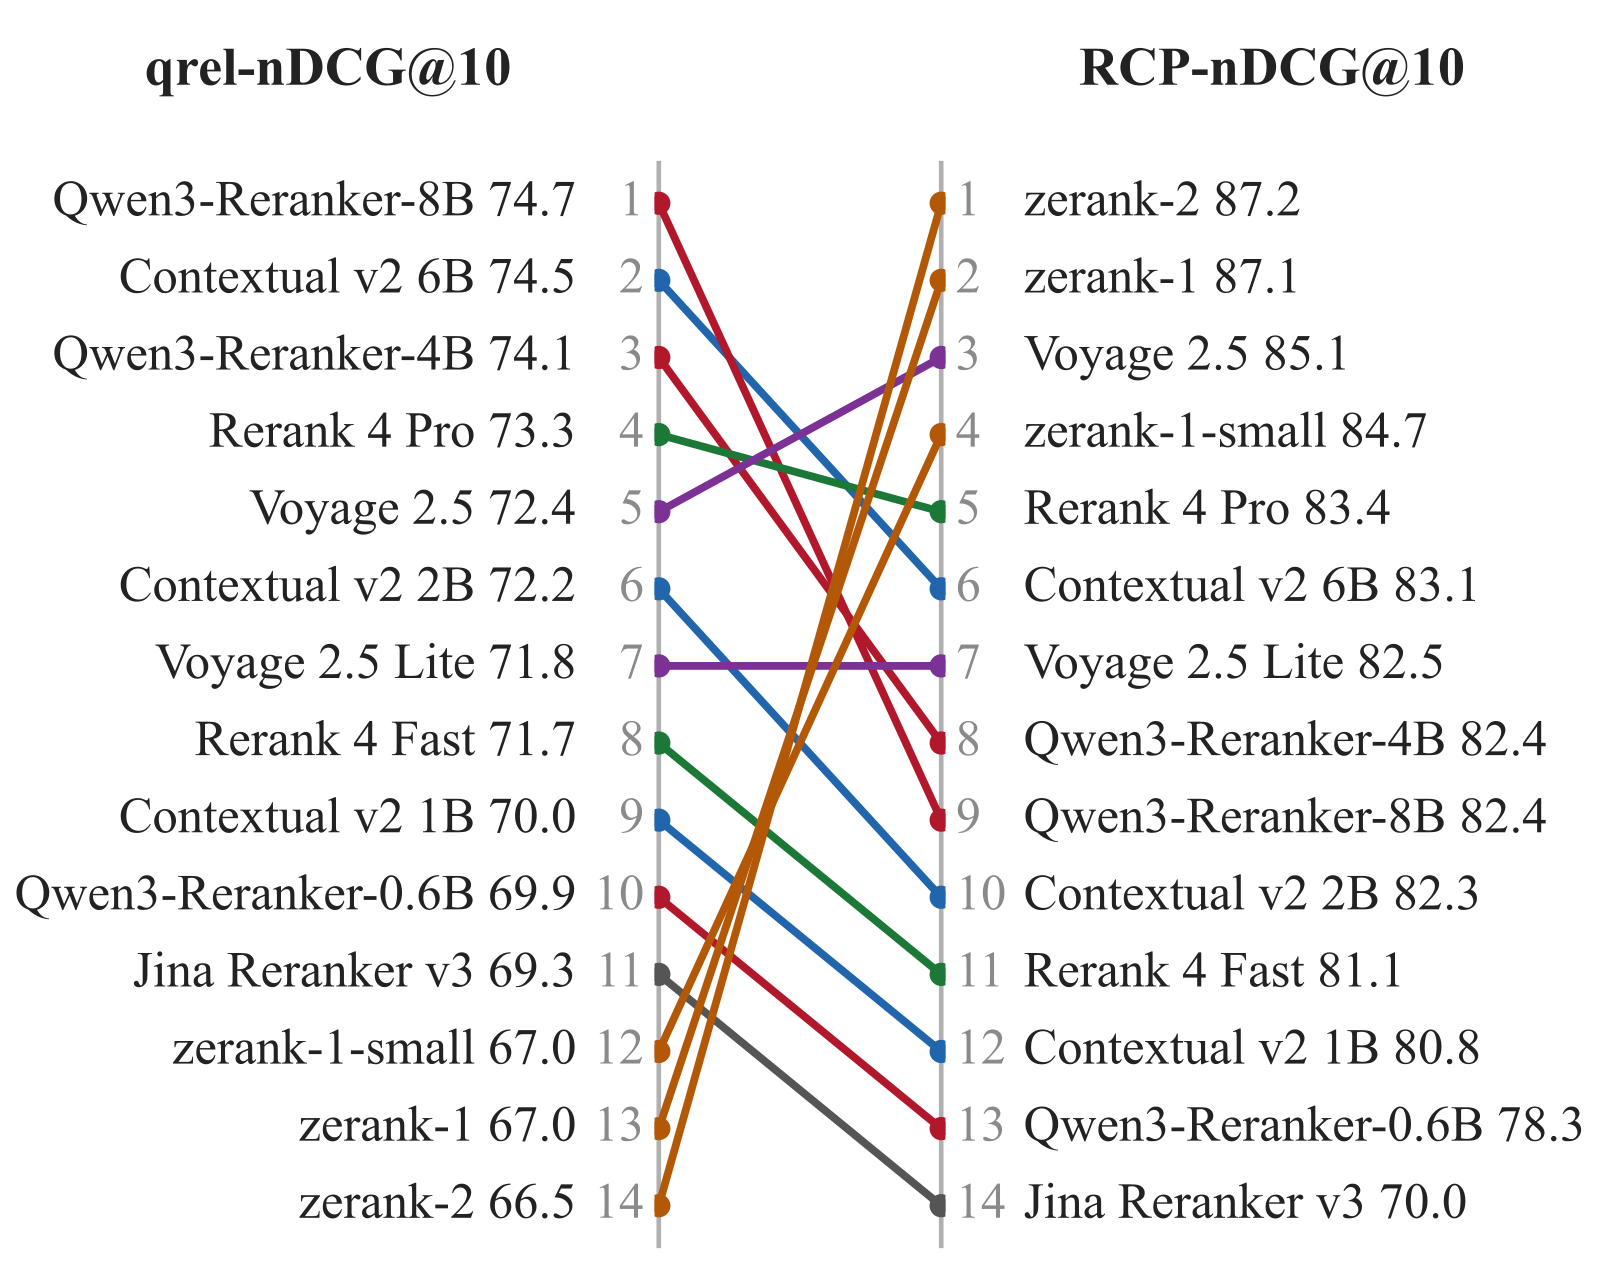
排名变化最大的是 ZeroEntropy 的重排器。在 qrel-nDCG@10 下,Qwen3-Reranker-8B 和 Contextual v2 6B 领先,ZeroEntropy 的三个模型垫底;换成 RCP-nDCG@10,zerank-2 和 zerank-1 从第 14、13 名升到了第 1、2 名。这引出一个疑虑:zerank 是用多个 LLM 的两两偏好训练的,RCP 可能只是奖励了同源的信号。作者的检验是看人怎么选:在 66 场 RCP-nDCG 偏向 zerank、qrel-nDCG 偏向对手的对比里,完全不用 LLM 的人工标注员 78.8% 选了 zerank。去掉所有和 zerank 有关的对比,RCP-nDCG 的一致率从 72.4% 降到 68.1%,仍然明显高于随机。所以 zerank 的上升大体是真实的,但偏向的担忧没有完全排除。
5. 量表本身稳不稳
作者在 TREC-DL 上测试了原始量表和 15 个改写的变体。只要量表没有完全无视查询,也没有把所有标准都挤在难度的同一端,原本被显著区分的重排器对就一对都没有反转。这说明 RCP 对量表的措辞不太敏感,但量表必须覆盖从宽松到严格的难度范围。作者也提醒,这五条标准是为通用检索设计的,换到别的应用可能需要别的标准。
6. 局限与实践意义
作者承认的局限有几条。RCP 的增益和人工评分都是一篇一篇单独评的,没考虑文档之间的冗余,这在 HotpotQA 这类多跳任务上尤其明显。两者测的都是“看起来相关”,不是事实是否正确。给标注员的评分问题是有意按量表的思路设计的,所以人工和 RCP 吻合,不能完全当成独立验证。相关性本身就难判断一致,两名标注员评分相差不超过一级的只有 77.8%。LLM 评审可能和被评的重排器有同样的偏好,所以用 RCP 信号训练出来的模型,最好再用别的标签检验。还要留意利益关系:作者都来自 Cohere,Cohere 出钱做了人工标注,而 14 个重排器里有两个、三个检索器里有一个是 Cohere 自己的产品。
对做检索和 RAG 的团队,这项工作的价值在于把评测从“依赖稀疏的人工标注”变成“用 LLM 把候选池一次标好,之后评任何重排器都不再花钱”。代码、全部评审分数和 7,080 个人工评分都已开源;候选池标好之后,任何对这些候选重新排序的模型都能直接打分,不用再调用评审。作者建议基准同时报告 RCP-nDCG 和 qrel-nDCG,而不是用前者替换后者。落地时有两点要注意:RCP-nDCG 分差小于 0.02 时,和人工的一致率只有 47.2%,接近随机,这种差距应该当作打平;如果自家的重排器本身就是从 LLM 偏好蒸馏来的,最好再留一份人工评审做交叉验证。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…