目录 · 9 节
1它到底在解决什么问题?2全景:在 LoRA 的计算里多留六个插槽3哪些插槽可以在加载时并掉?4并不掉的插槽在哪里算最省?5Scute 怎么接进 vLLM?6这套方案真的更好吗?7我认为它的局限8一个推荐/搜索团队可以怎么试9结论
做多租户大模型服务的团队值得读。这篇论文说明,vLLM 里现成的批量 LoRA 内核只要改几处,就能把 DoRA、(IA)³、VeRA 和 OFT(给每层输入乘一个旋转矩阵的方法)这些非 LoRA 方法训出来的 adapter,和 LoRA 放进同一个 batch 精确地跑,不必先把它们转成 LoRA。核心思想是把这几种方法都写成同一个公式:在 LoRA 的计算里多留六个插槽,每个 adapter 往里放自己的向量或矩阵。插槽旁边挨着 adapter 自己的权重,就在加载时并进去;并不掉的,再找最省显存带宽的地方每步现算。作者把它做成 Scute(一个打在 vLLM 上的补丁)。
在一张 RTX A6000 上、请求同时涌入时,四种或五种方法混在一起服务,decode 时间只比同样数量的纯 LoRA 多 5%(不含 VeRA)到 17%(五种都有);同一张卡上放 64 到 1024 个 (IA)³ 和 VeRA adapter 时,能扛住的请求速率是它们转成 LoRA 之后的 1.5 倍到至少 2.5 倍。这说明精确服务本身只多花一点时间,而 adapter 保持原来的大小,省下的显存能换来更多租户。
它到底在解决什么问题?
一张 GPU 上放一份基座模型,再给每个租户挂一个小 adapter,这是多租户服务的常见做法。Punica、S-LoRA 让不同 LoRA adapter 的请求共用一次批量计算,vLLM 和 SGLang 都沿用这个设计。可它们只认 LoRA,别的参数高效微调方法训出来的 adapter 在加载时就被拒收。
这些方法各自改的地方不同。DoRA 把每个输出列重新缩放到一个学出来的长度;(IA)³ 只给 key、value 和 FFN 中间激活各乘一个向量;VeRA 让所有 adapter 共用一对冻结的随机矩阵,每个 adapter 每层只学两个小向量;OFT 在每层输入上乘一个块对角的旋转矩阵。
下面用一个示意场景贯穿全文。一个平台有四个租户,方法各不相同:
| 租户(示意) | 方法 | 自己拥有的参数 | 转成 LoRA 的代价 |
|---|---|---|---|
| 甲 | LoRA,rank 16 | 两个低秩矩阵 | 无需转换 |
| 乙 | DoRA | 两个低秩矩阵 + 每列一个长度 | 论文测得基本不掉点 |
| 丙 | (IA)³ | 每层几个向量,共几 MB | 拿不到租户数据时最多掉 23.2 个百分点 |
| 丁 | VeRA | 每层两个向量 | 变成 rank 64 的 LoRA 要 0.34 GB |
转换的两种代价都在表里。(IA)³ 和 OFT 对基座权重的改动是满秩的,rank 64 的 LoRA 只能近似。VeRA 本来只有几个向量,转成 LoRA 后每个租户都要自带一对大矩阵,挤占别的租户和 KV cache 的显存。另一条路是给每个租户合并出一份完整模型,结果是精确的,但不同租户的请求再也没法拼进同一个 batch。
全景:在 LoRA 的计算里多留六个插槽
先回顾 LoRA 在批量服务里怎么算。一个 batch 里装着来自许多 adapter 的 token,同一层的基座权重 只有一份。内核先对整个 batch 做一次 ,再按 adapter 分段做两步小计算:shrink 用 把输入降到 rank 维,expand 再乘 升回去,加到 上写出结果。
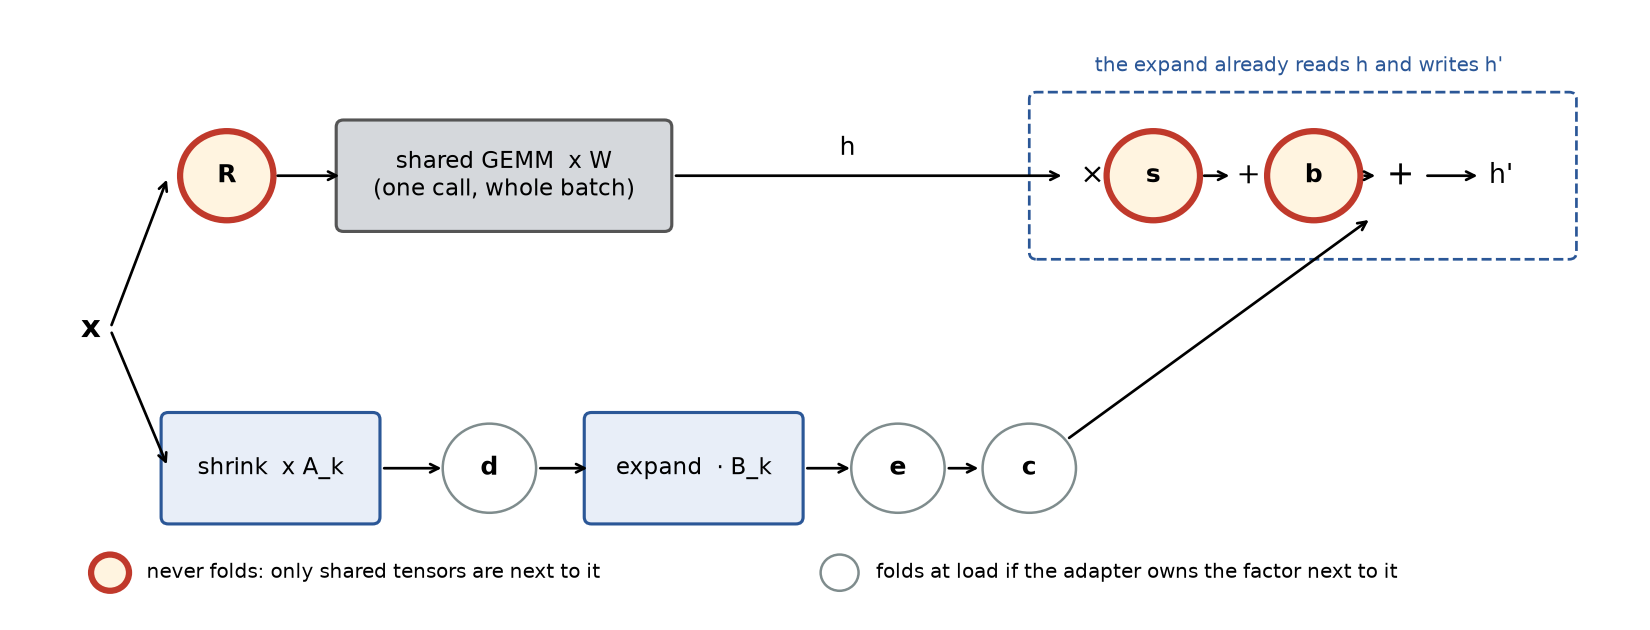
论文的第一个贡献,是在这套计算里标出 adapter 可以放进自己参数的位置,论文叫 slot,下文叫插槽。插槽里装的是 adapter 自己的一个向量、标量或矩阵,作用是在计算的某一步乘上或加上它。没用到的插槽就填成恒等值(1、全 1 向量、0 或单位矩阵)。写成公式就是:
基座这一路有三个插槽: 在乘 之前旋转输入(OFT), 给每个输出列乘一个系数(DoRA、(IA)³), 给输出加一个偏移。低秩这一路每一项也有三个: 夹在 和 之间, 乘在 之后, 是一个标量(VeRA 的两个向量就是 和 )。论文管这个公式叫 normal form。
(IA)³ 怎么装进来是个好例子。它给 FFN 的中间激活 乘一个向量 。逐元素乘法可以换个位置,先乘到 上再和门控相乘,结果一样,所以 就是 up 投影那一层的插槽 。
哪些插槽可以在加载时并掉?
插槽多了,每一步都要多算。论文的第二个贡献是一条判断规则:插槽旁边挨着 adapter 自己的矩阵或向量,就能在加载时并进去;旁边全是共享的张量,就只能每步现算。共享的张量包括基座 ,也包括 VeRA 那种全体租户共用的矩阵。这条规则在 adapter 总秩很低时成立,论文给出了严格条件。 Hoot 说

三格分别是 DoRA 的 e、VeRA 的 d 和 e、DoRA 的 s;判断只取决于插槽旁边那个矩阵归谁。 出处: 论文 §3 并掉规则与 DoRA、VeRA 的分析(DoRA 的 e 并进 B、c 并进 A;VeRA 共享 rank 256 的 A、B;60 个 DoRA 矩阵上 rank-16 近似的残差至少 59.7%)。
可以并掉的例子:。如果 是这个 adapter 自己的,加载时把 乘进 一次,服务时这个插槽就不存在了。DoRA 就是这样。它把 的每一列缩放到学出来的长度,所以基座那一路乘的是插槽 ,低秩那一路乘的同一个系数放在 上; 并进自己的 ,标量 并进自己的 。
并不掉的例子:、、 旁边只有所有租户共享的 。把 并进去就得改 ,相当于给这个租户复制一份基座权重。能不能用一个小的低秩项把 的作用吸收掉?作者取了四个公开的 Llama-3.1-8B DoRA 微调版本,每个看 3 层、每层 5 个投影,共 60 个矩阵。 离 1 很近,均方根偏差只有 0.2%,可 全都是满秩;用最好的 rank-16 近似去逼近,丢掉的部分也至少占这个矩阵元素平方和的 59.7%。所以批量服务只能把 DoRA 的 留着每步现算。
VeRA 和 DoRA 的情况相反:DoRA 的插槽留着现算是不得不付的代价,VeRA 的插槽留着现算反而是省钱的办法。它的 、 挨着的 、 是全体 VeRA 租户共享的,所以并不掉;硬并的话每个租户都得复制一对 rank 256 的矩阵,这就等于转成 rank-256 LoRA。对 VeRA 来说,插槽留着现算正是它省显存的原因:全体 VeRA 租户共用一份矩阵。
并不掉的插槽在哪里算最省?
adapter 的计算每搬一个字节只做很少的算术,耗时由显存带宽决定,所以论文用读写的字节数来衡量代价。剩下要现算的插槽,论文给了三条计算路线(论文叫 route),也就是在现有流程的哪一步、用哪个内核把它算掉。
DoRA 和 (IA)³ 的 放在 expand 里顺手乘。expand 本来就要把输出一个 tile 一个 tile 地读进来、加上低秩更新、再写回去,而每个小块只属于一个 adapter。Scute 在这里给基座输出 乘上这个 adapter 的 ,再加上低秩更新(DoRA 低秩那一路的系数已经并进 ),额外只多读一次 。在 vLLM 内核里这只是一行改动 tiled_c += tiled_out * s。vLLM 里一个还没合并的 DoRA 补丁,是先给每一行复制一份 ,再在 expand 之后单独跑一遍内核乘上去。这样单独跑一遍要花 LoRA expand 2.38 到 2.95 倍的时间,接近字节数推出来的 3 倍;放进 expand 里,在 1024 个 token 及以上只要 0.985 到 1.022 倍。端到端、请求同时涌入的 decode 测试里,4 个 DoRA 租户的每 token 时间是 4 个 LoRA 租户的 1.002 倍,几乎一样。
VeRA 的共享矩阵改成整个 batch 一起乘。VeRA 没有自己的低秩矩阵,vLLM 的加载器又要求每个 adapter 有一项,所以给它填一个全零的 rank-1 项占位,不贡献任何低秩更新。按 adapter 分段的 expand 是一个 adapter 一个 adapter地处理,每段都要把 读一遍,16 个 VeRA 租户就读 16 遍。Scute 改成在 expand 之后另跑两次 GEMM:先对整个 batch 的每一行算 ,再乘上该行所属租户的 ;然后乘 ,每块算完时乘上各行的 ,加到输出上;batch 里不属于 VeRA 租户的行直接跳过。这样不管 batch 里有多少个 VeRA 租户,共享矩阵每步只读一次。
OFT 的旋转在共享 GEMM 之前单独跑一遍。 作用在输入上,而 expand 在 GEMM 之后,带不上它。Scute 在 GEMM 之前加一个内核,把每一行输入乘上所属租户的块对角矩阵。旋转后的各行仍然一起进同一个共享 GEMM,所以 OFT 租户照样和别人共用基座权重。
论文用 Llama-3.1-8B(fp16,32 层里每个加了 adapter 的投影都算上)、batch 里 16 个租户,算了每个 decode 步 adapter 这部分要读多少字节,基座权重人人都要读,不算在内:
| 方法 | 计算路线 | 是否精确 | 每步读取 GB | 按带宽折算 ms |
|---|---|---|---|---|
| LoRA rank 16 | expand | 是 | 1.34 | 1.97 |
| VeRA | 共享矩阵整批乘 | 是 | 1.19 | 1.75 |
| VeRA 转 LoRA rank 256 | expand | 是 | 21.47 | 31.58 |
| VeRA 转 LoRA rank 64 | expand | 否 | 5.37 | 7.90 |
| OFT(块大小 32) | GEMM 前单独旋转 | 是 | 1.28 | 1.88 |
| OFT 转 LoRA rank 64 | expand | 否 | 5.37 | 7.90 |
| (IA)³ | expand 里乘 | 是 | 0.01 | 0.01 |
| (IA)³ 转 LoRA rank 64 | expand | 否 | 1.88 | 2.76 |
每种方法按自己的路线读的字节都比转换版本少。VeRA 那一行读的主要是共享矩阵,比 rank-64 的转换版本还少;论文测得 rank 64 的 VeRA 转换在这些任务上基本不掉点,所以它才是 VeRA 真正的对手。表里的毫秒数就是字节数除以显存拷贝带宽:1.34 GB 除以 680 GB/s 约等于 1.97 ms。论文据此写出一个不用拟合任何参数的时间模型:多出来的时间 = 多读写的字节 ÷ 显存带宽 + 多启动的内核次数 × 每次启动开销(A6000 上 0.96 微秒)。作者在 OFT 的输入旋转和四种把 DoRA 的 放在 expand 之外的做法上验证了它:多出的字节压过内核启动开销时,对总时间的预测误差中位数在 0.7% 到 14.0% 之间。这说明上机实测之前,先数字节就能对代价有个一阶估计。
Scute 怎么接进 vLLM?
Scute 不 fork vLLM,分两部分。加载时,一个转换器读入 Hugging Face PEFT 库的 checkpoint,按上面的公式改写,再用 vLLM 自己的 LoRA 张量名存好,vLLM 的换页和调度不用改,加载器和 adapter 激活这几处由运行时补丁扩展。LoRA 和 DoRA 原样通过;DoRA 的 在加载时算好,等于学出来的长度除以 每一列的范数,这一步要用到引擎里按自己布局切好的基座权重,所以放在加载时做;VeRA 只存两个向量和一个指向共享矩阵的引用;OFT 的参数展开成显式的块。
运行时,每个被改的层多出几块缓冲区,存 、、、,默认填恒等值。一层的前向分四步:基座 GEMM(有 OFT 时按 q、k、v 拆开算,因为三者各有自己的旋转)、vLLM 原有的 shrink、带 的 expand、VeRA 的整批共享计算。新增的内核用 Triton 写,注册成 PyTorch 自定义算子,CUDA graph 和 torch.compile 都能照常开。
这套方案真的更好吗?
第一个问题是算得对不对。训练出来的向量离恒等值很近,漏乘一个插槽也很少改变贪心解码的结果。所以这项测试里作者用随机数把 adapter 的向量拉离恒等值,例如 (IA)³ 的 取 1 加上 0.3 倍的标准正态噪声,让它明显改变 log 概率。9 个这样的 adapter 覆盖全部五种方法,放进一个 batch,和 PEFT 库在 float32 下算出的 log 概率对比:每种方法的平均误差,只有 adapter 本身让 log 概率改变的幅度的 0.3% 到 1.5%。最大的误差和普通 LoRA 在 fp16 下的舍入误差相当,两卡张量并行时也一样。15 个真实训练的 adapter(五种方法各在 GSM8K、BoolQ 和一个文本蕴含分类数据集上训一个)一起服务,所有任务指标和 PEFT 库相差不超过 0.4 个百分点。
再看转成 LoRA 会掉多少准确率。论文把 (IA)³ 和 OFT 的 adapter 转成 rank 64 的 LoRA,用了几种方式:直接对权重改动做截断 SVD,以及激活感知 SVD(在 128 条样本输入上让输出误差最小),样本分别取租户自己的任务数据和通用文本。下表是掉点最多的三行,数字是和 PEFT 库相差的百分点:
| adapter | 任务 | PEFT 库准确率 | Scute 差值 | 截断 SVD 差值 | 激活感知 SVD(租户数据)差值 | 激活感知 SVD(通用文本)差值 |
|---|---|---|---|---|---|---|
| (IA)³ | GSM8K | 59.8 | +0.4 | −18.6 | −0.8 | −19.6 |
| (IA)³ | MNLI | 90.2 | 0.0 | −23.2 | +0.5 | −16.9 |
| OFT | GSM8K | 63.0 | +0.2 | −5.6 | −1.2 | −4.6 |
能拿到租户自己的任务数据时,转换基本守得住,rank 64 时六个 adapter 都在 1.2 个百分点以内;拿不到时,用通用文本拟合在 12 种情况里有 8 种掉了 3 个百分点以上。平台通常只拿到 adapter 文件,拿不到训练数据,所以 转换的真实风险落在不用租户数据的那两列。
接着看每多一个租户要多花多少时间。租户数从 1 加到 16 时,转成 rank-256 LoRA 的 VeRA 每 token 时间从 36.7 ms 涨到 65.1 ms,因为每个租户都带来一对自己的大矩阵要读;Scute 只从 35.4 ms 涨到 36.1 ms,因为共享矩阵每步只读一次。
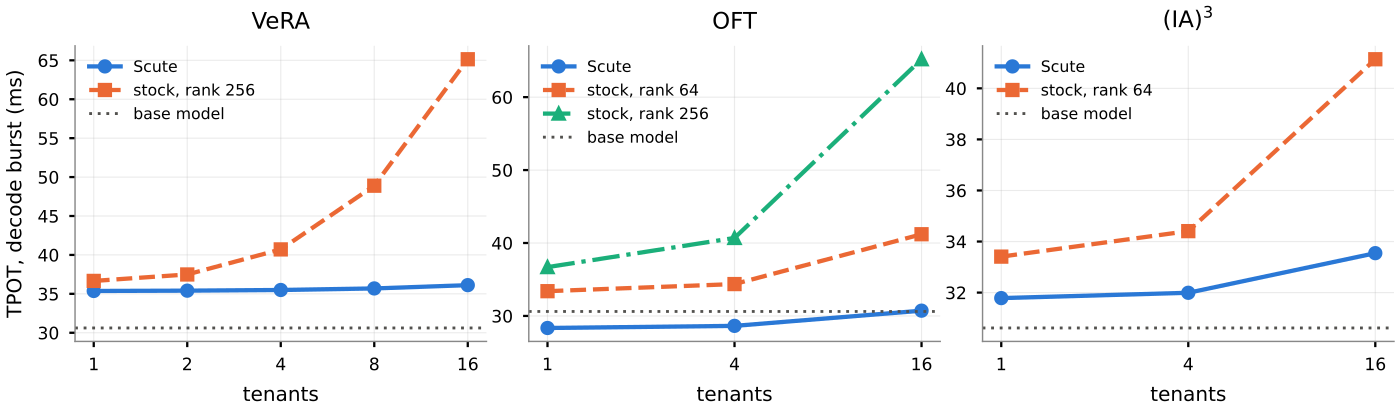
平台实际会同时服务多种方法,所以作者又把几种方法混在一个池里测。20 个租户、五种方法各 4 个,两边都用同样的基座 GEMM 写法:Scute 的 decode 时间是纯 LoRA 的 1.17 倍。转换版本把 VeRA 转成 rank 256 时是 Scute 的 1.65 倍,这时 20 个租户里只有 16 个放得进显存;改成不掉点的 rank-64 VeRA 转换后,20 个都能常驻,差距缩到 1.12 倍。去掉 VeRA 的 16 租户池里,Scute 只比纯 LoRA 多 5%。论文把多出来的时间归到 VeRA 的共享计算、OFT 的输入旋转和每步多读的向量上。
转换版本慢,很大一部分来自补零:vLLM 把每个 adapter 都按池里最大的 rank(这里是 256)来跑,租户没改的投影也照样跑一遍全零的矩阵。五种方法的池里,转换版本按各自 rank 读字节只要每步 13.0 ms,补零后升到 31.6 ms,和实测的 34.7 ms 接近。
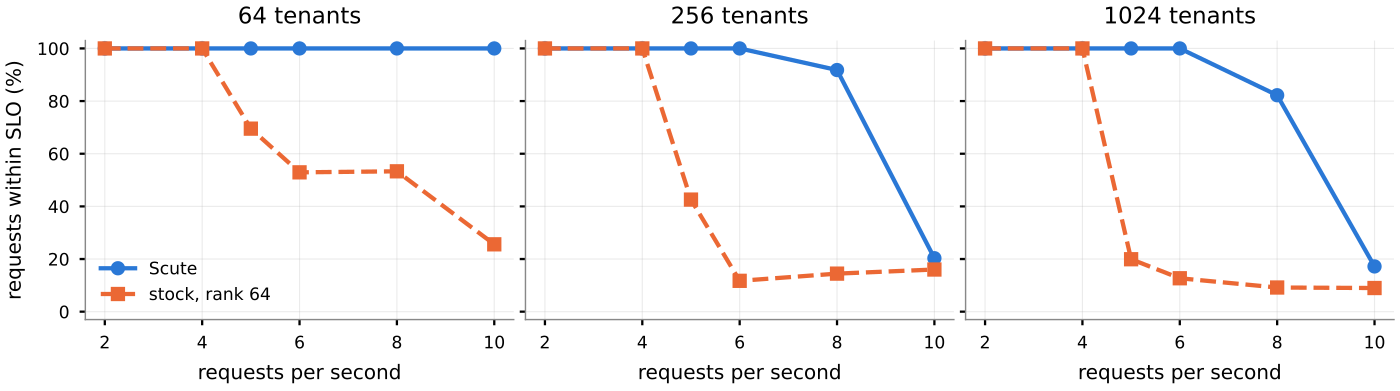
最后是租户很多的情况,这里 adapter 的大小直接决定显存够不够。(IA)³ 和 VeRA 各占一半的租户池里,一张 A6000 上 Scute 能让 1024 个租户全部常驻显存,原版只放得下 64 个 rank-64 的转换版本。
作者定了一个延迟目标(首 token 1 秒内、之后每 token 100 ms 内),看 90% 请求达标时能扛住的最高请求速率。Scute 在 64、256、1024 个租户时分别是每秒 10、8、6 个请求,原版都只有 4 个。这个实验里两边常驻显存的租户数接近(Scute 限 64 个,原版 48 个),差别在换入:Scute 的 adapter 只有几 MB,全部 1024 个都能放在主机内存里,需要时很快拷进显存;原版每个转换版本 0.34 GB,除了常驻的 48 个,另有 256 个放在主机内存,其余要从磁盘读。Scute 限 64 个常驻只是测试设置,目的是让两边都要换入换出;实际部署时它可以让 1024 个全部常驻。所以 adapter 保持原来的大小,直接决定了换入的代价。
我认为它的局限
第一,换到 A100 上代价变大,说明收益和显存余量有关。显存有 80 GB 时,原版能把所有转换版本常驻,Scute 的 decode 仍然更快,但混合池里 Scute 要花纯 LoRA 的 1.07 到 1.89 倍时间;prefill 为主的负载下,原版的平均首 token 时间低到 Scute 的 0.76 倍。显存宽裕时原版不必频繁换入,租户多时的容量优势也变小:256 个租户时两边都能扛每秒 8 个请求。
第二,评测范围窄。所有测量都用 Llama-3.1-8B,服务开销用的是形状照搬真实 adapter 的合成租户,准确率只看 15 个 adapter、三个任务。多卡方面,论文只在两卡张量并行上验证了端到端正确性和部分延迟,DoRA 的 另在 2、4、8 卡切分下单独核对过。
第三,覆盖的方法有边界。HiRA 和全量微调需要每个 adapter 在共享 GEMM 之后再乘一个稠密矩阵,装不进这个公式;BOFT(OFT 的变体,旋转由几个矩阵相乘得到)要多个输入变换,作者没有实现;SSF(给激活乘系数再加偏移的方法)理论上装得进,但 PEFT 库里没有它,也就没测。
一个推荐/搜索团队可以怎么试
如果团队用一个大模型基座给不同场景或客户各训了一个 adapter,可以这样试:
- 先盘点手上的 adapter 用了哪些方法,对照上面的规则标出每种方法有哪些插槽必须现算。全是 LoRA 和 DoRA 的话,只需要把 放进 expand,改动最小。
- 用论文的字节模型估一遍:按自己的模型尺寸和 batch 里的租户数,算每种方法每步多读多少字节,除以自己 GPU 的带宽,再和一个准确率可以接受的 LoRA 转换版本读的字节比。精确服务读得更多的话,这一步会慢一些;整体快慢还要算上换入代价、能常驻多少租户,以及 KV cache 能多分到的显存。
- 拿开源的 Scute 在测试环境复现混合池,先确认和 PEFT 库的 log 概率误差在 adapter 效果的几个百分点以内,再测 decode 时间和首 token 时间。
- 最后在显存最紧的机器上压测租户数,看同一延迟目标下能多扛多少请求;显存宽裕的卡上收益可能明显变小。
结论
多租户服务不一定要逼所有人都训 LoRA;把 adapter 写进同一个公式,再按“挨着谁”决定并掉还是现算,就能在一个 batch 里精确服务几种主流方法。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。多租户平台确实会遇到非 LoRA 的 adapter,现有引擎直接拒收 |
| 方法创新性 | 中高。统一公式和并掉规则把“能不能精确批量服务”变成可以事先推出来的问题 |
| 实验证据 | 中。正确性验证扎实,但只测了一个 8B 模型和两种 GPU |
| 工程成本 | 中。核心改动是 expand 里一行加两个 Triton 内核,但依赖较旧的 vLLM 0.19.1 |
| 是否值得尝试 | 显存紧、租户多、adapter 方法杂的平台值得先用字节模型估一遍 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…