目录 · 10 节
1它到底在解决什么问题2整体流程3Sketch Attention:每条历史行为都被算进摘要4两个时间尺度:近期 10K 直接看,更早的看摘要5系统:缓存、MRLB 和算力账6离线结果7线上结果8我认为它的局限9一个推荐或搜索团队可以怎么试10总结评价
这篇论文最值得看的地方,是它把超长行为序列的计算从按候选重复做改成了每个用户只做一次。字节跳动的 SequenceO1 先把用户最多 10 万条历史行为压成一份固定大小、与候选无关的摘要并缓存起来,同一用户的所有候选和相邻请求都复用它;每个候选只对这份摘要和最近的行为做交叉注意力,不再逐个重读整段历史。按论文的公式估算,推理时这一路每个候选的计算量比直接读整段历史少约 64 倍。在抖音上线一个月,用它替换原来的终身兴趣模块后,完播提升 2.33%,不喜欢下降 6.98%。
具体来说,这份摘要由论文提出的 Sketch Attention 生成,是 1024 个 token;候选读的近期行为是最近 10K 条。按论文的 FLOPs 公式和实测缓存命中率,100K 长度下超长分支每个候选的计算量,训练时是直接用 STCA 的 49.9 分之一,推理时是 63.9 分之一。抖音极速版上,完播提升 3.49%,不喜欢下降 6.00%。
做长序列排序的团队值得读它,主要是三处可以单独借用的设计:一种让每条历史行为都被算进摘要的压缩方式、只缓存用户侧结果的训练与服务共用缓存、把用户侧计算提前到拿到候选之前。需要留意的是,效率数字全部来自 FLOPs 公式,延迟和吞吐要自己测。
它到底在解决什么问题
抖音用户的行为历史可以积累到十万条量级,里面有长期兴趣和周期性的需求。排序模型想用这些信号,常见做法有三种,各有代价:
| 做法 | 代表 | 怎么用长历史 | 代价 |
|---|---|---|---|
| 截断 | 只看最近 1K–10K 条 | 更早的历史直接丢掉 | 快,但长期信号没了 |
| 两阶段检索 | TWIN V2 | 先离线聚类,再按候选检索相关的簇,交给排序 | 检索和最终排序目标不一致,系统复杂 |
| 直接拉长 | STCA | 候选对整段历史做交叉注意力 | 端到端,但每个候选都要重新扫一遍历史 |
STCA 的问题在于它是“目标相关”的:同一个用户、同一段历史,换一个候选就要重算一遍。示意:一个有 100K 条历史的用户,一次请求要给几百个候选打分,STCA 就要把 100K 条历史读几百遍。论文还指出,短序列训练、长序列推理的外推路线也不彻底:ULTRA-HSTU 在平均约 4,400 的长度上训练、在 16,384 上推理,STCA 训练时平均长度约 2–2.5K、服务时用 10K,外推倍数有限,而且服务时的特征存储和传输仍随历史长度增长。
SequenceO1 的出发点是:长历史里大部分信息可以先压成一份与候选无关的摘要,摘要只依赖用户,就能算一次、存起来、反复用。名字里的 O1 指的是缓存命中时,超长分支的计算量和原始历史长度无关。
整体流程
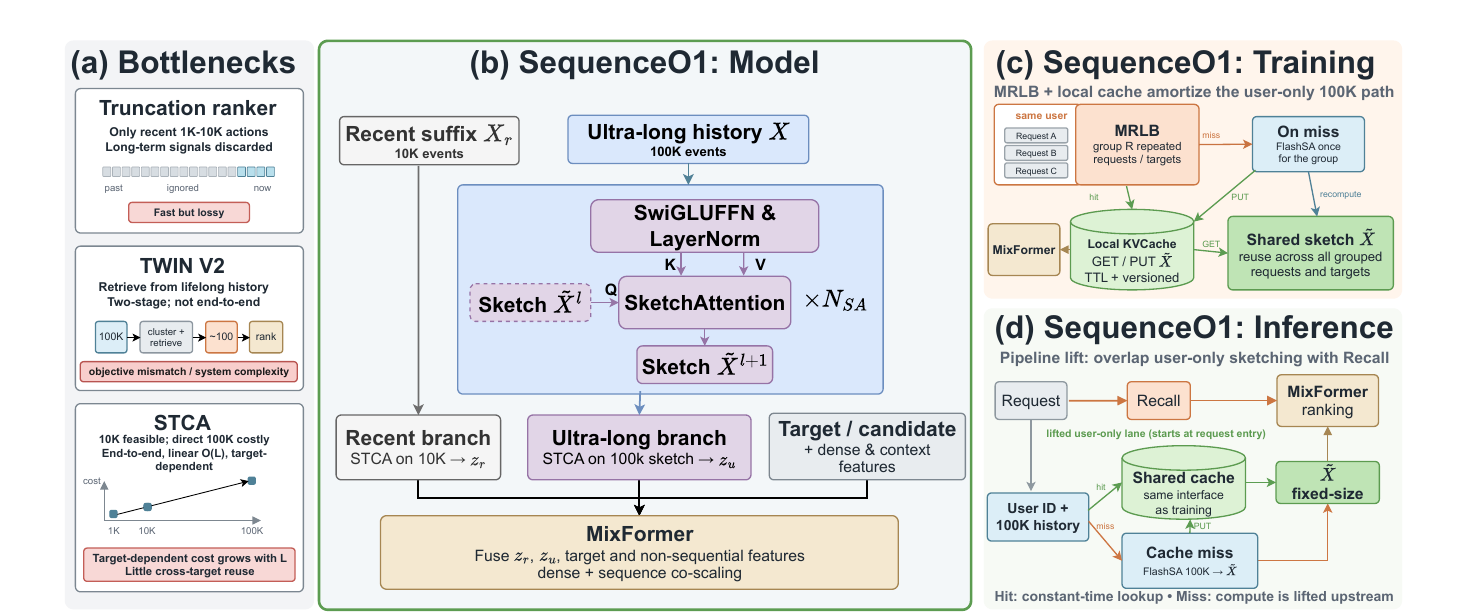
一次打分按下面的顺序走:
- 用户的 100K 条历史先经过 2 层 Sketch Attention,压成一份摘要: 个 token,每个宽度 。论文把这份摘要叫 sketch,下文统一称摘要。这一步只用用户侧信息。
- 摘要写进缓存,键是用户 id、模型版本、历史时间戳和摘要配置。同一用户后面的请求命中缓存就直接读。
- 拿到候选后,候选对摘要做 STCA 得到长期表示 ,对最近 10K 条行为做 STCA 得到短期表示 。
- 、、候选特征和其他非序列特征一起交给 MixFormer 打分。
Sketch Attention:每条历史行为都被算进摘要
为什么不直接用普通注意力来压缩?用普通注意力压缩,相当于准备一组查询,让每个查询从全部历史里挑出和自己最像的几条,把权重集中给它们。这样一来,和哪个查询都不像的行为几乎分不到权重,也就进不了摘要。可这份摘要要给之后任意一个候选用,眼下不起眼的行为,换一个候选可能正好相关,提前把它丢掉不合适。
SequenceO1 的做法分两步。第一步,模型学习 个兴趣槽(论文里叫 prototype,用 1024 个),记作 。每个兴趣槽代表一类兴趣,由训练学出来,所有用户共用同一套。先算每个兴趣槽和每条历史行为的相似度:
第二步,把相似度换成权重。普通注意力是让每个兴趣槽在全部历史行为上做 softmax,由兴趣槽来挑行为;这里反过来,对每条历史行为,在 个兴趣槽之间做 softmax:
也就是说,每条行为手里有一份总量为 1 的权重,按它和各个兴趣槽像不像分出去,所以每条行为都会被算进去;每个兴趣槽把分到自己这里的行为加权求和,就是摘要里的一个 token,写成 。兴趣槽对所有用户都一样,摘要只取决于这个用户的历史,所以可以缓存。
这一步可以重复做几遍。第一遍拿学到的兴趣槽去和历史比相似度;第二遍改用第一遍得到的摘要去比,这时每个兴趣槽已经汇总过这个用户的历史,作者的解释是这样能调整每条行为该怎么分。每一遍都重新扫一次全部 100K 条行为、按同样的方式分权重,新结果加回上一遍的摘要,再过 LayerNorm 和 SwiGLU FFN。作者发现做 2 遍就够。每条历史行为的输入也不只是物品 embedding:物品 embedding 和行为类型 embedding 拼起来过一个 SwiGLU,再加回物品 embedding,这样同一个视频被完播、被跳过、被点赞,给出的信号不同。
手算一个例子(示意):3 条行为、2 个兴趣槽。每条行为和两个兴趣槽的相似度是: 为 , 为 , 为 。也就是只有 像这两类兴趣,、 和哪个都不像。
- 普通注意力,由兴趣槽挑行为:兴趣槽 1 看到三条行为的相似度是 2、0、0,给出的权重约 0.79、0.11、0.11;兴趣槽 2 看到 1.5、0、0,约 0.69、0.15、0.15。两个兴趣槽给的加起来, 拿到约 1.48,而 和 因为不像任何兴趣槽,各只有约 0.26。
- Sketch Attention,由每条行为自己分: 按 把自己的 1 分成约 0.62 和 0.38;、 和两个兴趣槽都一样不像,所以各自平分成 0.5 和 0.5。三条行为进入摘要的总权重都是 1。
所以在 Sketch Attention 里,一条行为哪怕和所有兴趣槽都不像,也照样进入摘要,不会被挤掉;一份要给所有候选共用的摘要,需要的正是这一点。 Hoot 说

普通注意力:兴趣槽挑行为,每个兴趣槽分出 1 份
- 兴趣槽 1 → t₁、t₂、t₃
- 0.79 · 0.11 · 0.11
- 兴趣槽 2 → t₁、t₂、t₃
- 0.69 · 0.15 · 0.15
- t₁ 进摘要的总权重
- 1.48
- t₂、t₃ 各自
- 0.26
- 如果再多一条 t₄
- t₂ 降到 0.23,t₄ 也只有 0.23
历史越长,每条冷门行为分到的越少。
Sketch Attention:行为分给兴趣槽,每条行为分出 1 份
- t₁ → 兴趣槽 1、2
- 0.62 · 0.38
- t₂、t₃ → 兴趣槽 1、2
- 0.5 · 0.5
- 每条行为进摘要的总权重
- 都是 1
- 兴趣槽 1、2 收到的总量
- 1.62 · 1.38
- 如果再多一条 t₄
- t₂ 仍是 1,t₄ 也是 1
每个兴趣槽收到多少不再固定,每条行为送出的总量固定是 1。
沿用正文的示意例子:3 条行为、2 个兴趣槽,t₁ 和两个兴趣槽的相似度是 (2, 1.5),t₂、t₃ 都是 (0, 0)。左栏是每个兴趣槽在三条行为之间分出 1 份权重,右栏是每条行为在两个兴趣槽之间分出 1 份权重。最后一行是“如果”:历史里再多一条和两个兴趣槽都不像的行为 t₄(相似度 (0, 0)),其余不变。这只说明每条行为都会进入摘要,不等于摘要无损,也不说明每条行为同样重要。 出处: 论文 §3.2 Prototype-wise normalization(每条行为在各兴趣槽之间做 softmax,权重和为 1);数字按本节的示意例子手算
效果上,在后面离线结果里介绍的轻量消融设置中,只把这一步从普通注意力的挑法换成每条行为自己分权重,六个互动目标的 UAUC 都更高:点赞 +0.10%、关注 +0.20%、评论 +0.19%、分享 +0.14%,完播只有 +0.01%(论文 Table 1)。可见收益主要在偏好类目标上,完播几乎不变。
两个时间尺度:近期 10K 直接看,更早的看摘要
压缩会损失细节,而最近的行为最需要细节。所以 SequenceO1 保留两路:最近 条行为直接交给 STCA;全部 100K 历史先压成摘要,摘要经过一个宽度适配器从 128 映射到 STCA 的宽度 1024,再做 STCA。摘要只有 1024 个 token,这一路的计算量和原始历史长度无关。两路输出交给 MixFormer 和候选特征、非序列特征一起融合,作者也说明这里换成别的融合方式同样可以。
这样摘要只负责长期信号,短期兴趣仍由 STCA 逐条读近期行为来捕捉,两路分工明确。
系统:缓存、MRLB 和算力账
模型层把压缩做成了与候选无关,系统层要做的就是让它只算一次。论文用了四个部件:
- 本地 KVCache。训练和服务共用同一套 get/put 接口,只缓存摘要,不缓存近期行为和候选特征。训练时 TTL 是 3 小时,命中率约 0.5;服务时 TTL 是 1 小时,命中率约 0.6。命中时,100K 条原始特征也不用再存储、传输。
- MRLB。同一用户短时间内的多个请求分到一组,摘要只算一次,组内所有候选共用。作者的理由是长期历史在短时间内变化很慢;各请求自己的近期行为和候选特征仍按请求单独计算,近期分支还加了请求级的 mask,防止一个请求看到另一个请求之后的行为。
- Pipeline Lift。精排通常只分到整条链路延迟预算的一小部分。摘要只依赖用户,所以可以在请求入口就开始算,和召回并行,候选到达时摘要已经就绪。
- FlashSA。直接实现会把 的相似度矩阵写进显存, 时访存很重。FlashSA 分块计算相似度,以及每条行为在各兴趣槽之间做 softmax 所需的最大值和 log-sum-exp,边算边累加出摘要,不保存完整矩阵。
算力账按论文附录的公式算,每个候选的期望 FLOPs 是“每个候选都要做的部分”加上“组内共享部分除以 ”, 是一组请求里所有候选加起来的个数,缓存未命中时共享部分里还要加上 SA 本身。训练时 、命中率 0.5,100K 长度下 STCA 每个候选约 152.13 GFLOPs,SequenceO1 约 3.046 GFLOPs,差 49.9 倍;推理时 、命中率 0.6,分别约 43.076 和 0.674 GFLOPs,差 63.9 倍。STCA 也能从分组里省一部分:它每层有一个只作用于历史、和候选无关的 FFN,分组后可以共享,但候选对历史的注意力每个候选都要重算。如果不做 MRLB 分组、只按训练侧命中率 0.5 计,每个候选 STCA 约 5059.46 GFLOPs,SequenceO1 约 108.10 GFLOPs,也有 46.8 倍。
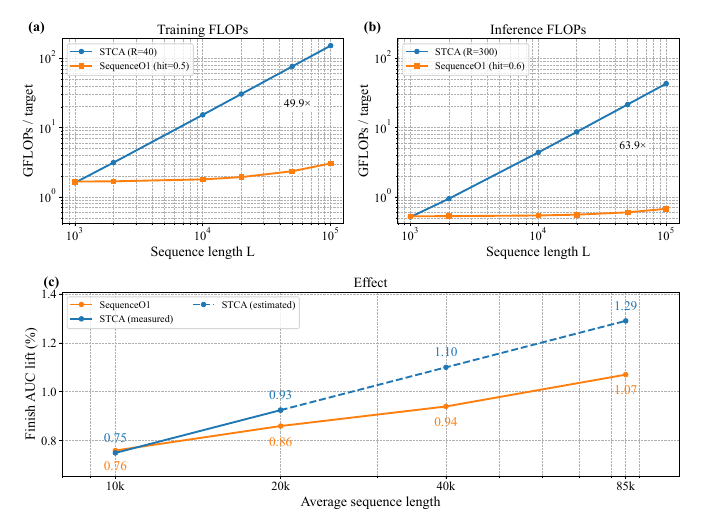
要注意,49.9 倍和 63.9 倍是在给定的命中率和组大小下算出来的:如果某个业务同一用户的请求很少聚到一起,或者缓存命中率低,倍数会小很多。
离线结果
这组实验先在论文的轻量消融设置里比压缩方法:稠密部分做了简化,底座的序列部分只有 STCA(512),即只对最近 512 条行为做 STCA;各方法再加一路把 100K 历史压成 1K×128 的分支,表示大小相同,比完播 AUC(论文 Table 3)。
| 压缩方法(同为 1K×128) | 做法 | 完播 AUC 提升(相对 STCA(512)) |
|---|---|---|
| Sketch Attention | 1K 个可学习的兴趣槽,每条行为把权重分给各兴趣槽,再按兴趣槽汇总 | +1.07% |
| 最近行为初始化查询 | 用最近 1K 条行为当作 1K 个查询,对全部历史做注意力 | +0.78% |
| 分块取平均 | 相邻行为分块,每块取平均 | +0.46% |
| TWIN V2 式聚类 | 参照 TWIN V2 用 KMeans 把历史聚成簇 | +0.30% |
论文一共比了六种压缩方法,SA 最高,上表摘了其中四种。既然表示大小相同,差别就来自压缩方式本身。
结构消融在同一设置下做,数字是完播 AUC 相对最终配置(=1K、2 层、宽度 128,完播 AUC +1.07%)的变化(论文 Table 2):兴趣槽从 1K 减到 512 是 −0.04%,加到 2K 是 +0.03%;SA 层数从 2 加到 3 是 +0.02%;宽度从 128 减到 64 是 −0.10%;去掉行为类型融合是 −0.20%,去掉每层的 Add&Norm 和 FFN 是 −0.10%。可以看到,加大规模的收益很小,作者也只把这些数字当成本和效果之间的参考,生产上保留了较小的配置;行为类型融合是这些部件里最重要的一个。
拉长序列的收益(论文 Figure 1c):在平均长度 85K 的设置下,SequenceO1 的完播 AUC 提升是 +1.07%,直接把 STCA 拉到同样长度估计是 +1.29%,SequenceO1 保留了其中 83%。
再看完整生产模型(论文 Table 4)。对照是生产上的 STCA 10K 加 TWIN V2,实验组去掉 TWIN V2,换成 100K 摘要分支。各目标的 AUC 提升在 +0.04% 到 +1.29% 之间,UAUC 提升在 +0.40% 到 +3.63% 之间,最大的是不喜欢(AUC +1.29%、UAUC +3.63%)和收藏(UAUC +1.47%),完播是 AUC +0.29%、UAUC +0.40%。也就是说,摘要分支换掉 TWIN V2 之后,所有评估目标都更好,偏好类目标的 UAUC 涨得最多。
线上结果
在抖音和抖音极速版上各做了一个月 A/B,对照是 STCA 10K 加 TWIN V2,实验组用 100K 摘要分支替换 TWIN V2。下表是全体用户的相对变化,论文注明全部统计显著(论文 Table 5):
| 指标 | 抖音 | 抖音极速版 |
|---|---|---|
| 30 日活跃 | +0.1968% | +0.2335% |
| 时长 | +1.4999% | +1.6655% |
| 完播 | +2.3256% | +3.4872% |
| 评论 | +3.5910% | +8.6132% |
| 点赞 | +2.3617% | +2.9399% |
| 不喜欢 | −6.9829% | −5.9972% |
按活跃度分层,抖音低活用户的 30 日活跃提升 +0.5484%,高于全体的 +0.1968%。低活用户涨得更多,作者把它解读为更长的历史把这部分不常来的用户重新拉了回来;两个应用上各项指标的方向和离线结果一致。
我认为它的局限
- 效率证据都是公式算出来的 FLOPs。49.9 倍和 63.9 倍依赖组大小 40 和 300、命中率 0.5 和 0.6 这些工作点,全文给出的都是计算量,延迟、吞吐和显存要自己测。FlashSA 和 Pipeline Lift 带来多少实际收益,也只能从描述上判断。
- “保留 83%”的对比对象是估计值。Figure 1c 里 STCA 在 40K 和 85K 两个点画的是虚线,标注为估计;+1.29% 不是实测出来的,而且这组对比在轻量的 STCA(512) 设置下完成,不是完整生产模型。
- 消融差距很小。增大兴趣槽数和层数只带来 +0.03% 和 +0.02%,Sketch Attention 的分权重方式相对普通注意力的 UAUC 提升都在 0.20% 以内,表里都是单个数字,看不到运行之间的波动,这些结论更适合当方向参考。
一个推荐或搜索团队可以怎么试
- 先确认能复用:统计同一用户在缓存 TTL 内有多少个请求和候选,估算自己的组大小和命中率,代入论文的 FLOPs 公式,看节省是否足够大。
- 在已有的长序列排序模型上加一路压缩分支:用 Sketch Attention 把全部历史压成固定大小的摘要,关键是让每条行为自己把权重分给各个兴趣槽,而不是让兴趣槽挑行为;原有的近期序列分支保持不变;历史行为的输入里带上行为类型。
- 离线先在小底座上比压缩方法,同样的表示大小下对比聚类、分块平均和普通注意力压缩,确认压缩方式本身有收益,再接入完整模型。
- 缓存只放用户侧的摘要,训练和服务共用同一套接口和缓存键;用户侧计算提前到拿到候选之前。
- 上线时实测延迟、吞吐和缓存命中率,不要只看 FLOPs;按用户活跃度分层看指标。
总结评价
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。长序列排序的瓶颈在每个候选重复处理历史,这是把序列拉长到十万量级时绕不开的问题 |
| 方法创新性 | 中高。压缩本身很简单,只是把普通注意力的分权重方向反过来,价值在于把“与候选无关、可缓存”贯穿到模型、训练和服务 |
| 实验证据 | 中高。有压缩方法对比、结构消融、完整生产离线结果和两个应用一个月的 A/B;但效率只有 FLOPs,83% 的对比对象是估计值,消融差距很小 |
| 工程成本 | 高。需要训练和服务共用的缓存、按用户分组的训练、提前计算用户侧表示和定制 kernel,只复现 Sketch Attention 一层拿不到同样的效率 |
| 是否值得尝试 | 值得,前提是同一用户的请求和候选能大量复用同一份用户侧表示;先用自己的组大小和命中率算一遍账 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…