目录 · 9 节
1现有推荐 agent 卡在哪2模拟用户只认「这次要什么」3奖励怎么给:推中的次数太少4走一遍:钓鱼竿那一单5训练时把目标「塞」进候选6实验结果7训练改掉的是哪些行为8这对做推荐 agent 的人意味着什么9局限
被用户回一句「不要伸缩的」,推荐 agent 下一步该干嘛?SimRec 用模拟用户把整段对话练出来你在一个购物助手里说:想要一套高品质的钓鱼竿加渔轮套装,泄力顺滑,做工扎实,性价比要好。助手搜了一轮商品,又调出你过去的购买偏好,然后推荐了一款便于旅行的伸缩竿。
你回它:不要伸缩的,想要一节或两节的竿,渔轮更顺、更结实。这时助手面前有好几条路:换个词重新搜,打开某件候选商品的详情核对,或者再问你一句。论文里的这个例子,助手打开了第二件候选的详情,确认它是一套标准的两节竿,改推它,这次推中了。
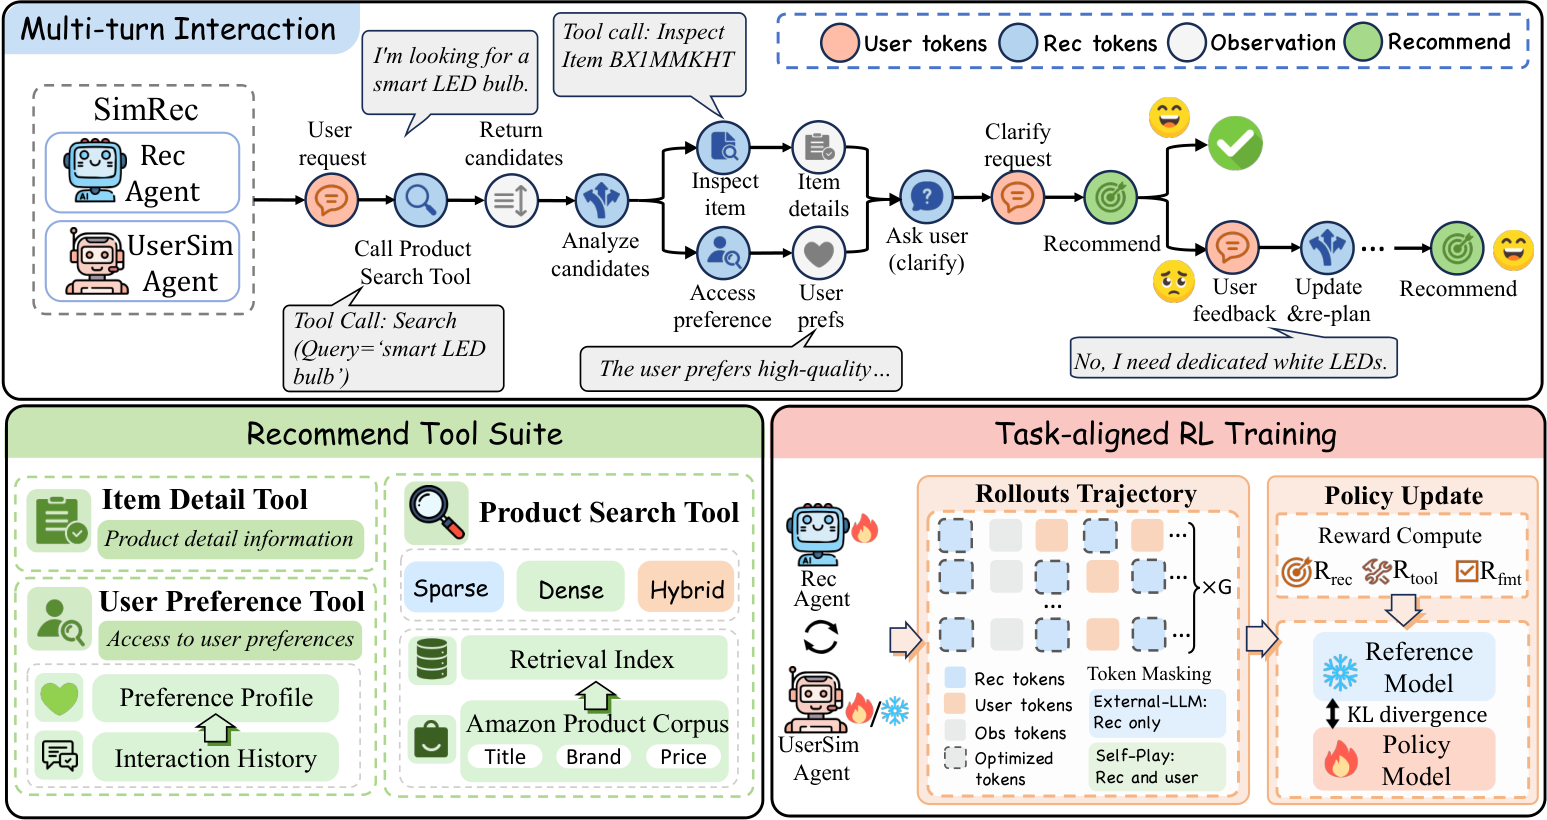
这篇论文来自浙江大学、清华大学和海康威视研究院,要解决的是:这种「搜、查、问、推、被拒再改」的推荐 agent,怎么学会每一步该做什么。现有的 agent 大多按人写好的流程走,先搜什么、什么时候问、什么时候推都事先定死。已有的训练只练其中一步,比如改写搜索词、给一张现成的列表排序,整段对话最后成没成,传不回做决定的模型。SimRec 用强化学习训练整段交互:一个以这次需求为准、看不到目标商品的模拟用户,对每次推荐回一句「缺什么」;奖励除了看最后推没推中,还看搜索结果好不好、工具有没有用对。用 Qwen3-4B 做 agent,在带查询与商品相关性标注的 ESCI 数据集上, NDCG@100 从 32.23% 升到 35.42%;在由复杂购物需求组成的 Amazon C4 上,从 22.94% 升到 24.72%。
把「什么时候搜、查、问、推」交给整段对话的结果去训练,4B 的 agent 在检索排序指标上超过了大得多的未训练模型;陪它练和考它的都是模拟用户,论文没有真人实验。
现有推荐 agent 卡在哪
基于大模型的推荐 agent 手里有几样工具:商品搜索、商品详情、用户偏好。它还能追问用户,也能在被拒之后接着推。问题是这些动作的顺序由人写的流程规定,模型自己没机会从结果里学。
论文把这种做法的后果写得很具体:agent 很少去核对搜出来的候选,很少看用户历史,推错一次之后也很少能救回来。换更大的底座模型,这些毛病也没有消失。
那照搬搜索 agent 的强化学习做法行不行?搜索 agent 的环境是现成的:同一个查询,索引永远返回同样的结果;工具只有搜索一种;答案对就是对,错就是错。推荐这三样都没有。环境是一个会对每次推荐做出反应的用户;证据来自几种代价不同的工具;结果是「推中了」,这件事很少发生,没推中时也说不出是哪一步错了。所以要训练推荐 agent,得先补上三样东西:用户、动作和目标。
模拟用户只认「这次要什么」
真人用户给不了强化学习需要的交互量,只能用大模型扮演用户。扮演的方式有讲究。如果模拟用户知道目标商品,它说话时容易把答案漏出来。如果先给它重建一份完整的用户画像,聊几轮之后它可能偏离这次真正想买的东西。
SimRec 的模拟用户以这次购物的需求为准,论文实现里是一条参考查询,比如上面那句「高品质钓鱼竿加渔轮套装」。除此之外,它还能读到 agent 刚推荐的商品或刚问的问题,以及最近几轮对话;它看不到目标商品的 ID,也不拿完整的用户画像。每次 agent 推荐之后,它按提示词的要求,用自然的话说出一两条没被满足的具体要求,比如「不要伸缩的」,而且不准说出任何商品 ID。
推中没推中由环境判断,跟模拟用户无关:环境拿推荐的商品去比对目标集合。模拟用户只负责说话,环境负责打分,两件事分开。
用户的长期偏好也不交给模拟用户扮演,而是做成 agent 可以主动调用的工具。agent 一共有这些动作,顺序不固定:
| 动作 | agent 拿到什么 | 用来做什么 |
|---|---|---|
| 商品搜索 | 一个查询返回 100 件,agent 只看到前 20 件的简短摘要 | 找候选 |
| 商品详情 | 一件商品的完整信息 | 核对价格、尺寸、兼容性等硬条件 |
| 用户偏好 | 用大模型把购买历史总结成的一句话,已删去目标商品 | 排序和选词时参考 |
| 追问 | 模拟用户的回答 | 需求缺关键条件时补上 |
| 推荐 | 环境判定 + 模拟用户的反馈 | 推中就结束,被拒就继续 |
一段对话在三种情况下结束:推中了,推荐次数用完了,或者轮数到了上限。
奖励怎么给:推中的次数太少
最直接的奖励是推中给 1、没推中给 0。问题有两个。一是商品库很大,推中很少,大多数对话拿到的都是 0。二是一个 0 说不清问题出在哪:目标可能根本没被搜出来,也可能搜出来了却没被选中。
所以 SimRec 的奖励由几块相加,总分截在 0 到 2.5 之间:
推中奖励:最后推荐的商品在目标集合里,得 1,否则 0。
检索奖励:在这段对话的所有「不重复的搜索」里,取目标排得最好的那次,算它的 NDCG@100。不重复的意思是查询词以前没用过,而且前 100 个结果里至少有一件新商品。单个目标时,这个分只由目标的名次决定,排第 1 得 1,排得越后越小。
工具奖励:搜索、商品详情、用户偏好三类工具,每类只要有效用过一次就给分,分别是 0.03、0.01、0.01。同一类用十次也只算一次,无效或重复的调用不算。
惩罚:用户纠正之后,agent 如果还用跟之前一样的查询去搜,扣 0.05;对话超过 4 轮之后,每多一轮扣 0.02,最多扣 0.20。另外,每次推荐能写出合法的商品 ID 和描述,有一份很小的格式分。
训练算法是 GRPO:同一个任务让当前模型跑 8 段对话,每段算出总奖励,再看它比这 8 段的平均高多少(再除以组内标准差),用这个差去调整这段对话里模型生成的每个 token。同一段对话里,搜索词、查详情的调用、最后的推荐都共用这一个分数。用外部大模型当模拟用户时,只更新推荐方的 token。
走一遍:钓鱼竿那一单
下面按论文 Figure 2 的案例走。对话内容来自论文;名次、轮数和奖励数值是示意。
第一步,用户需求变成搜索。agent 把需求写成查询「high-quality fishing rod and reel combo with smooth reel…」,检索器返回 100 件,agent 看到前 20 件,其中有 Item1、Item2、Item3。示意:目标商品在这次自然搜索结果里排第 3,检索奖励就是 1 ÷ log2(3+1) = 0.5。
第二步,偏好影响第一次推荐。agent 调用用户偏好,拿到「用户偏好可调节、高品质的产品」,于是推荐了 Item1,一款便于旅行的伸缩竿。环境一比对,Item1 不在目标集合里,这一推失败,对话继续。
第三步,反馈改变下一步动作。模拟用户回:「不要伸缩的,想要一节或两节的竿,渔轮更顺、更结实。」这句话没提任何商品,只说缺什么。agent 没有重新搜,而是打开 Item2 的详情,看到「一套标准的两节竿」。因为反馈之后没有新的搜索,「重复查询」那项惩罚不触发。
第四步,核对之后改推。agent 推荐 Item2,环境判定命中,对话结束,Hit@1 = 1。
第五步,这段对话拿到的分数在同组里比较。示意:推中 1 + 检索 0.5 + 工具 0.03 + 0.01 + 0.01 = 1.55;对话 6 轮,超出 4 轮的 2 轮扣 0.04,总分约 1.51。同组里另一段对话如果被拒后没有查详情,坚持推了别的伸缩竿,就只有 0.5 + 0.03 + 0.01 = 0.54。如果前一段高于组内平均,它里面「被拒后查详情」的那些 token 就被加强;后一段低于平均,就被削弱。
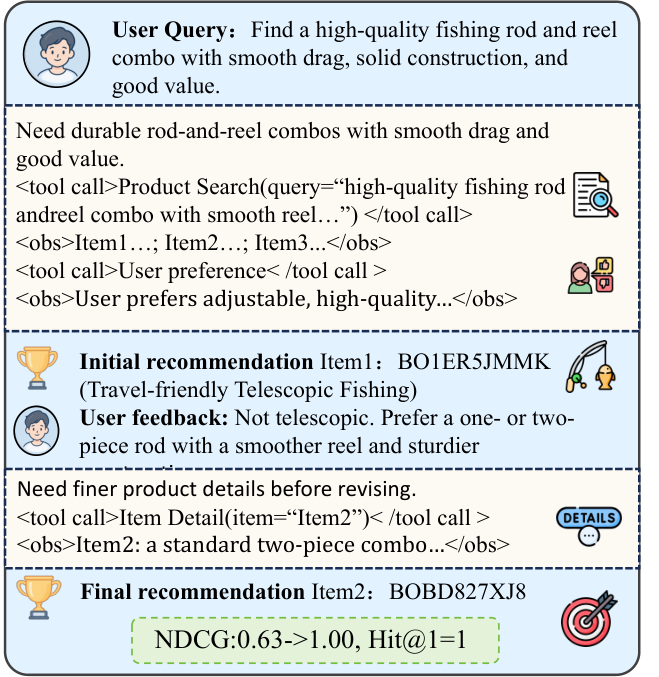
这个例子说明了两件事。第一,模拟用户那句「不要伸缩的」本身就是训练信号的一部分:它决定了 agent 下一步有没有东西可查。第二,奖励只在整段对话结束时给一次,agent 被拒后的那一步选择好不好,要靠同组对话之间的比较才分得出来。
训练时把目标「塞」进候选
奖励之外还剩一个麻烦:商品库很大,agent 搜了几轮,目标可能一直不在它看得到的前 20 件里。这时它根本没机会练「在几件相似商品里挑对那件」。
SimRec 的办法是训练时作弊一下:用户已经说过至少 2 轮话,目标还不在可见的候选里,就把目标插到候选列表的随机位置。位置随机,模型没法靠位置猜。检索奖励始终按没被插入的自然结果算,所以插进来的目标不会白送检索分。评测时关掉插入。
训练过程中,需要插入的比例在下降。最早一段训练里,满足条件的对话有 38.18% 要靠插入,最后一段降到 31.48%。同时,目标排进自然结果前 10 的比例从 61.81% 升到 68.52%,前 100 都没有目标的比例从 19.70% 降到 14.50%。这说明 agent 自己写的查询越来越好,靠插入的需要在减少。
实验结果
论文在 ESCI 的 5 个类目和 Amazon C4 的 4 个类目上评测。NDCG@100 看目标在搜索结果里排得多靠前,取所有不重复搜索里最好的一次;Recall@100 看目标有没有进前 100;Hit@1 看最后推荐的那件是不是目标。
| 方法 | ESCI NDCG@100 | ESCI Hit@1 | C4 NDCG@100 | C4 Hit@1 |
|---|---|---|---|---|
| 只用 Qwen3 Dense 检索 | 32.62 | 19.98 | 19.80 | 6.45 |
| Qwen3-4B 未训练 | 32.23 | 21.20 | 22.94 | 8.30 |
| GLM-5.1 | 34.99 | 36.96 | 24.61 | 16.09 |
| Kimi-K2.6 | 34.50 | 40.40 | 22.69 | 16.26 |
| SimRec-4B | 35.42 | 24.08 | 24.72 | 9.76 |
(数字来自论文表 1,单位为 %。GLM-5.1 和 Kimi-K2.6 都在同一套工具和模拟用户下运行,没有训练。)
这说明训练确实改善了 4B 模型找候选的能力:两个数据集的 NDCG@100 都是表里最高,ESCI 的 Electronics 类目涨了 7.66 个百分点。但最后推中这件事,大模型仍然强得多:Kimi-K2.6 在 ESCI 上的 Hit@1 是 40.40%,SimRec 是 24.08%。在 C4 上,用亚马逊数据训练的检索器 BLAIR-LARGE 的 Recall@100 也更高,63.01% 对 59.18%。
把检索器换成更弱的 BM25,SimRec 相对单独用 BM25 的提升更大:ESCI 的 NDCG@100 从 19.68% 到 24.02%,C4 从 7.68% 到 15.88%。agent 多轮改写查询,能补上一部分检索器的弱。
训练改掉的是哪些行为
工具用法变化最明显。在 C4 测试集上,每段对话的工具调用从 2.43 次涨到 5.19 次。多出来的主要是查详情(0.58 次到 1.83 次)和看用户偏好(0.02 次到 0.86 次)。这说明训练后的 agent 更愿意核对商品、参考用户,而未训练的模型几乎从不看偏好。
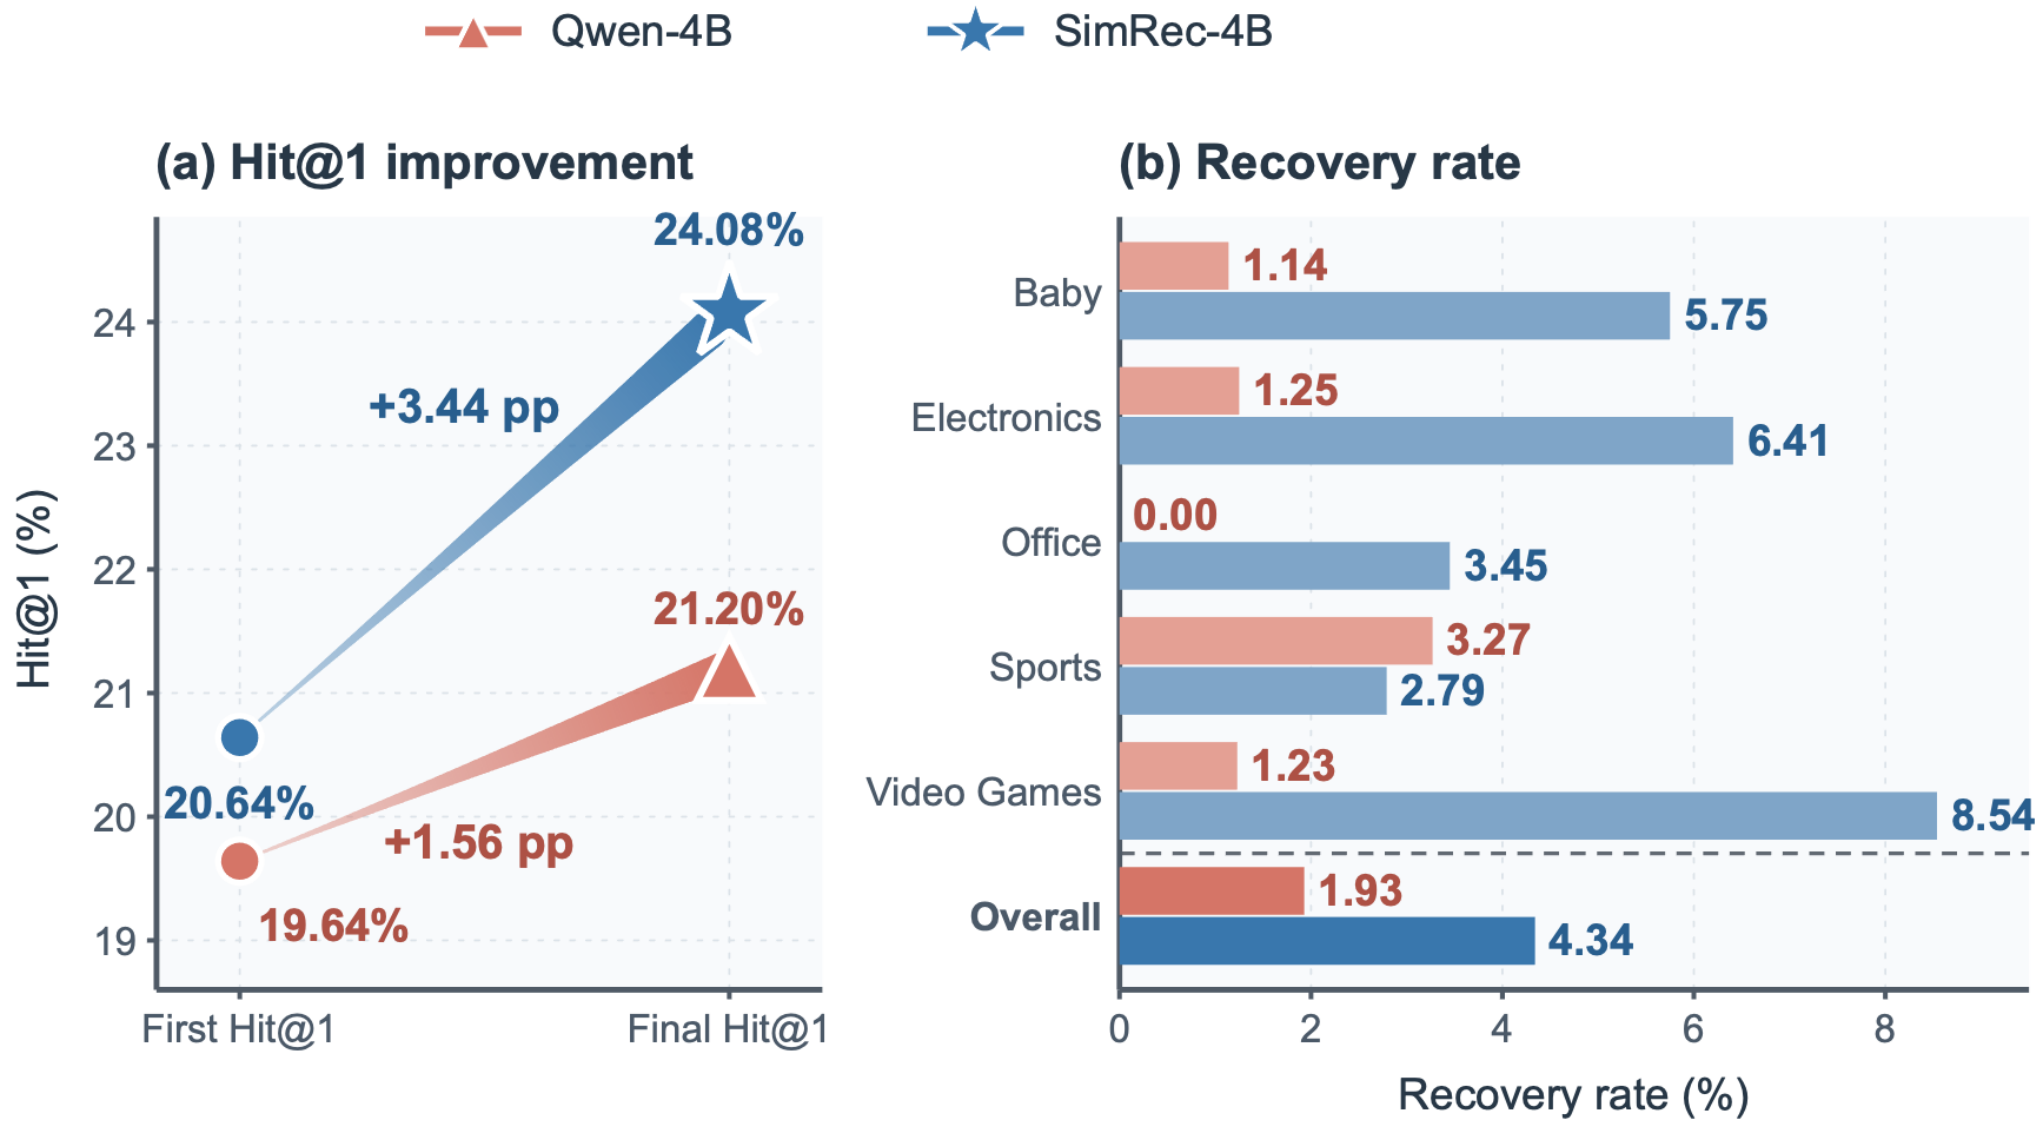
被拒之后能不能救回来,也有变化。论文把第一次推荐没中、最后推中的比例叫恢复率。在 ESCI 上,未训练模型从第一次推荐到最后一次,Hit@1 只涨了 1.56 个百分点,SimRec 涨了 3.44 个。恢复率从 1.93% 升到 4.34%,五个类目里四个变好,Sports 略降。这说明多轮反馈确实被用上了,但能救回来的仍是少数。
挑商品的本事也单独测了。论文给每个模型同样的 16 件候选,打乱顺序,隐去检索分,让它重新排序。NDCG@10 从未训练的 24.75% 升到 28.06%,随机顺序是 19.73%。候选完全相同,这个差别反映的是比较商品的能力。
消融实验把各部分拿掉看损失。在 C4 上,拿掉用户偏好工具,NDCG@100 降得最多,3.55 个百分点;拿掉商品详情工具,Hit@1 降得最多,3.72 个百分点。有意思的是,拿掉商品详情后 Recall@100 反而从 59.18% 升到 63.65%,最后推中的却更少了。搜出来的候选多,不等于能挑对。拿掉多轮反馈,两个指标都降。
奖励的消融在 ESCI 上做,训练到第 500 步就比较。完整奖励的 NDCG@100 和 Hit@1 是 32.38% 和 17.22%。拿掉推中奖励,降到 25.45% 和 14.28%;拿掉检索奖励,Hit@1 降到 14.58%;拿掉工具奖励,Hit@1 降到 14.34%。最后一项说明,即使保留了推中奖励,奖励「把证据找齐」这件事仍然帮到了最后的推荐。
这对做推荐 agent 的人意味着什么
如果你的推荐 agent 是按人写的流程调工具,可以试着让整段对话的结果来决定流程。
先看一眼自己的 agent 在被拒之后做了什么:有没有去查详情,有没有看用户偏好,还是换个说法又推了一件差不多的。SimRec 的未训练底座几乎从不看偏好,这类毛病光换大模型不一定能解决。
搭模拟用户时,给它这次的需求、agent 当前的推荐或问题和最近的对话,让它说「缺什么」,别让它知道答案;推中与否交给环境判断。奖励里除了最终命中,再给检索质量一份分;工具奖励按「每类用过一次」给,别按次数给;论文这样设计,就是为了鼓励把工具用对,而不是用得多。
局限
陪 agent 练和考它的都是大模型扮演的用户,真实用户会不会这样说话、会不会这样给反馈,论文没有验证。换模拟用户,结果就变:评测时用 GLM-5.1 扮演用户,NDCG@100 升到 36.93%;换成 Kimi-K2.6,NDCG@100 和 Hit@1 都降了。
训练时插入目标,评测时不插,训练和推理之间有一处不一致。论文自己也把它列为局限。
让 agent 自己同时扮演用户的 self-play 版本,在 ESCI 上接近外部模拟用户(34.72% 对 35.42%),在 C4 上差得多(19.77% 对 24.72%)。
最终推中率仍明显低于大模型,实验也只覆盖 4B 和 1.7B 两种规模、ESCI 和 Amazon C4 两个数据集。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…