目录 · 8 节
1为什么改写策略要跟着语料走?2整体流程:离线挖技能,在线选技能3离线阶段:怎么从语料里挖出技能?4在线阶段:选技能,再改写5实验结果:不训练,也追平了训练过的改写模型6我认为它的局限7一个推荐/搜索团队可以怎么试8一句话结论
推理型检索里,用户问题常常绕着弯说,直接拿去做向量检索效果差,所以大家先让大模型改写一遍 query。常见做法是对所有 query 用同一条改写指令,比如“生成和问题相关的详细信息”。SkillQR 的看法是:改写该往哪个方向写,取决于要搜的语料。同一句“怎么实现二分查找”,去搜理论计算机论文和去搜 Python 问答,应该写出完全不同的改写。它离线扫一遍语料,自动总结出几条改写“技能”,查询时先选技能再改写,全程不需要训练数据。在 BRIGHT 上去掉伪相关反馈单独比较技能时,它的平均 NDCG@10 从通用指令的 32.1 升到 33.7,和人工写的学科指令持平;14B 版每个 query 改写耗时 38.1 秒,迭代改写的 ThinkQE 要 85.3 秒。
值得读的理由是它把“按语料定制改写策略”这件事自动化了,而这件事过去要靠人读完语料再写提示词。核心思想一句话:先离线从语料里挖出少量改写技能,查询时让同一个大模型挑一个技能来改写。我认为它的价值主要在于便宜和能迁移,绝对效果并没有超过已有方法:它和用 RL 训练的改写模型打平,在医疗语料上更稳,但离“每个 query 都挑对技能”的上限还差得远。
为什么改写策略要跟着语料走?
作者先做了一个对照实验。在 BRIGHT 上用同一个 7B 模型改写、同一个召回模型检索,只换改写指令:通用指令对所有学科一视同仁;人工指令为编程和定理类学科各写一条,比如 Pony 语言学科写“生成相关的 Pony 语法和语言特性,并详细解释用法”。
| 学科(来自论文表 1) | 原始 query | 通用指令 | 人工指令 |
|---|---|---|---|
| LeetCode | 35.0 | 31.7 | 37.2 |
| Pony | 10.4 | 15.3 | 30.1 |
| 全部平均 | 24.4 | 30.4 | 33.0 |
LeetCode 上通用指令反而比不改写更差,换成“找出需要的数据结构和算法”后才恢复。这说明同一个模型,只要写作方向对了,检索效果就能明显变好。问题是人工写指令要求先吃透语料,换一个语料就要重来,没法规模化。
用一个示意场景说明。假设一个站内知识库同时有代码片段、API 文档和故障排查帖,用户问“为什么我的服务启动后五分钟就挂了”:
| 改写方向(示意) | 改写内容大意 | 更可能命中 |
|---|---|---|
| 通用指令 | 解释服务崩溃的各种可能原因 | 泛泛的概念文章 |
| 故障排查技能 | 列出内存泄漏、健康检查超时、连接池耗尽等症状和日志关键词 | 故障排查帖 |
| API 文档技能 | 列出相关的超时参数和配置项名称 | API 文档 |
整体流程:离线挖技能,在线选技能
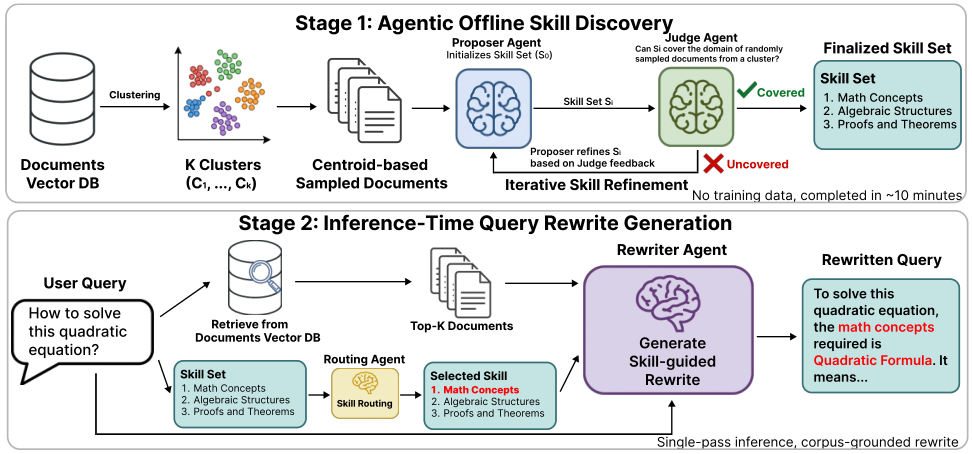
SkillQR 把工作拆成离线和在线两个阶段,目的是把读语料这件贵事只做一次。离线阶段在语料上跑一次,产出不超过 5 条技能;在线阶段每个 query 先由大模型从技能里挑一条,再按这条技能改写。
离线阶段:怎么从语料里挖出技能?
第一步是看清语料由哪些内容组成。直接用召回模型已经算好的文档向量做聚类,不增加编码成本。簇数取文档数的平方根左右,例如 1 万篇文档就聚成约 100 个簇(示意)。每个簇取离中心最近的几篇,让一个“提议者”大模型给出两个标签:领域和内容类型,比如“数学 / 证明”“Python / 报错排查”。
第二步是起草技能。提议者拿到所有簇的标签和那条通用指令,被要求“扩展成能覆盖所有簇的最小技能集”,同领域的簇要合并,只有需要不同知识类型时才分开。
第三步是让“评审者”大模型逐簇检查。它从每个簇随机抽几篇文档,判断现有技能里有没有一条能指导大模型写出和这些文档相像的内容。能就算覆盖;不能就指出缺了哪种知识,并判断该扩写某条已有技能,还是新增一条。比如气候动力学的簇可以并入已有的地球科学技能,界面设计的簇和哪条都不沾,就新建一条。这一步最多循环 3 轮,技能总数上限 5 条。
用前面的知识库场景走一遍(示意)。聚类后得到三类簇:“后端 / 报错日志”“后端 / 配置参数”“前端 / 交互设计”。提议者先起草两条技能:“列出可能的故障症状和日志关键词”“列出相关的配置项和参数名”。评审者检查交互设计簇时发现两条都不沾,判为未覆盖,并建议新增;下一轮提议者补上“描述界面元素和交互流程”。三个簇都被覆盖,循环结束,最终技能集是这三条再加上那条通用指令。上限设得小,是为了让路由器在少量选项里挑,挑错时更容易归因到技能质量。
这一步的成本是一次性的。整个 BRIGHT 在一张 H100 上大约 2 小时挖完,其中最大的 LeetCode 学科有 40 万篇文档,用了 21 分钟。
在线阶段:选技能,再改写
查询时只用一个大模型,7B 或 14B。它先读 query 和编号的技能列表,回答这个问题属于什么体裁、需要什么知识,然后选出一条,有领域技能能用时优先于通用技能。接着用原始 query 先检索一次,取前 5 篇文档作为伪相关反馈,和选中的技能一起放进改写提示,生成扩写内容。最终检索用的 query 是原始 query 拼上扩写内容。保留原始 query 是为了不丢掉用户的原话,扩写部分负责补上语料里文档会用的说法。14B 版沿用 ThinkQE 的设置,采样两次,把两段扩写都拼到原始 query 后面。
接着看示意场景:用户问“为什么我的服务启动后五分钟就挂了”,路由器判断这是故障类问题,选中“列出故障症状和日志关键词”的技能;改写模型参考前 5 篇召回结果,写出“内存持续上涨、OOMKilled、健康检查超时、连接池耗尽”这类词,再拼回原句去检索。故障排查帖里正好会出现这些词,所以更容易被召回。
论文举了一个例子:一道物理题,标准文档是简谐运动的定义。通用指令写出的改写重在一步步解题,内容像一份解答,和定义类文档的写法差得远,NDCG@10 是 0;SkillQR 选中“讲解概念”的技能,改写转为列出并解释题目涉及的概念,写法更接近语料里的定义条目,NDCG@10 到了 43.1。改写的方向和语料里文档的写法对上,检索才找得到。
实验结果:不训练,也追平了训练过的改写模型
除了 BRIGHT,作者还在 R2MED(医疗领域的推理型检索基准)上测了迁移能力。对比对象有三类:迭代改写的 ThinkQE(14B,检索和改写交替 3 轮)、用 RL 训练的 TongSearch(7B,3 万条训练数据)和 Reasoner-Rewriter(7B,6.8 万条从 BRIGHT 文档构造的数据,还用了人工学科指令)。
| 设置(Reason-Embed 召回) | BRIGHT | R2MED | 每 query 改写耗时(秒) |
|---|---|---|---|
| 原始 query | 36.2 | 42.0 | — |
| ThinkQE 14B | 39.3 | 49.1 | 85.3 |
| SkillQR 14B | 38.5 | 49.3 | 38.1 |
| Reasoner-Rewriter 7B | 38.4 | 42.3 | 21.1 |
| SkillQR 7B | 38.3 | 46.1 | 13.9 |
耗时一列是 Diver 召回下测的。在 BRIGHT 上,SkillQR 和各自同规模的对手差别都不显著,但耗时更短。14B 时省时间是因为只改写一遍,ThinkQE 要来回三轮;7B 时省时间是因为训练过的改写模型会模仿训练数据里的长推理,输出更长。
更有意思的是医疗语料 R2MED。两个 RL 改写模型都是瞄着 BRIGHT 训的,换到医疗语料,Reasoner-Rewriter 只比原始 query 高一点;SkillQR 7B 在两个召回模型上都显著胜过它们。这说明把改写策略训进权重里,换语料时会失效;而每到一个新语料就重新挖技能,天然能适应。
技能本身的质量也单独测过。去掉伪相关反馈、用 Diver 召回,SkillQR 自动挖出的技能平均 33.7,和人工指令一样,通用指令是 32.1。人工指令对 StackExchange 各学科都用通用写法,SkillQR 却为它们找到了专门的技能,比如机器人学科从 28.3 升到 30.2。
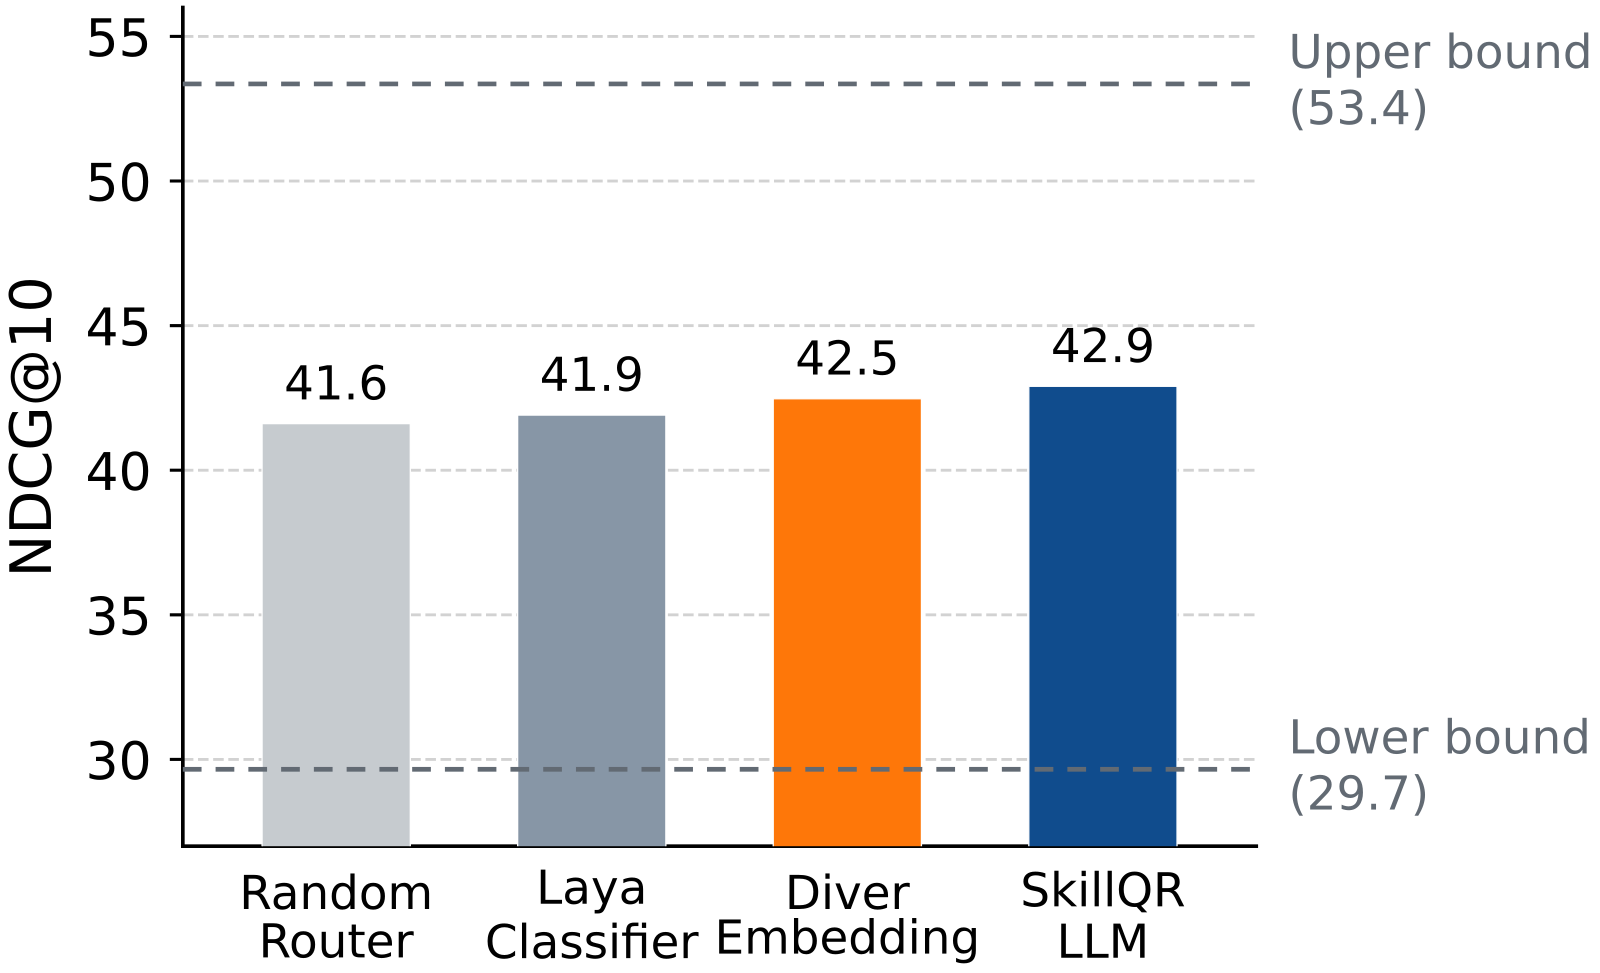
路由的上限值得单独说。作者对每个 query 用每条技能都改写一遍,挑出 722 个技能选择会影响结果的 query。大模型路由得到 42.9,每题都挑最优技能能到 53.4,说明技能本身够用,瓶颈在选择。
我认为它的局限
第一,在线延迟仍然很高。7B 版每个 query 改写要 13.9 秒,14B 版 38.1 秒,适合离线批处理或 deep research,离在线搜索的毫秒级预算差得很远。
第二,并不总是比不改写好。在 Diver 召回下,SkillQR 7B 在 LeetCode 上是 11.8,原始 query 是 13.4;14B 版在 Reason-Embed 召回下 BRIGHT 平均 38.5,仍低于 ThinkQE 的 39.3。
第三,路由差距大。大模型路由 42.9、最优选择 53.4,说明相当多的收益还卡在“选哪条技能”上;而且技能集是对静态语料挖的,语料持续变化时要怎么更新还没有方案。
一个推荐/搜索团队可以怎么试
- 先确认改写方向对自己的语料是否敏感:挑几百条难 query,用通用指令和两三条手写的领域指令分别改写,看召回指标差多少。差别不大就不必上这套。
- 差别明显时,用现有召回模型的文档向量聚类,按论文的提议者加评审者流程挖不超过 5 条技能,人工过一遍技能文本。
- 改写放在离线或近线:例如对高频难 query 预先改写缓存,或只在 agent 式检索、问答这类能容忍秒级延迟的入口启用。
- 监控路由:记录每条 query 选了哪条技能,对技能敏感的 query 抽样比较各技能的效果,路由明显不准时再考虑用少量样例做提示里的示范。
一句话结论
改写策略应该从语料里来,而不是写死在模型里。SkillQR 用很轻的流程把这件事自动化,效果追平训练过的改写模型,换语料时更稳,但延迟和路由仍是落地前要解决的两件事。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。改写是推理型检索的常用环节,按语料定制的需求真实存在 |
| 方法创新性 | 中。聚类加两个 agent 的技能挖掘思路清楚,各组件都不新 |
| 实验证据 | 中。两个基准、两个召回模型、显著性检验都有;多数比较是打平而非胜出 |
| 工程成本 | 低到中。无需训练,离线约 2 小时;在线每 query 十几秒以上 |
| 是否值得尝试 | 语料多样、改写延迟可接受时值得一试 |
| 适用场景 | 企业知识库、deep research、垂直领域问答的检索前改写 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…