
把大模型压到 4 位,误差更小的 scale 为什么反而让模型变差?SoScale 按层输出来挑你在做 FP4 量化,换了一个更精细的 scale 搜索:每个权重块都挑重建误差最小的那个 scale。逐块看,误差确实降了。跑一遍困惑度,却比什么都不做的默认量化还高一点。
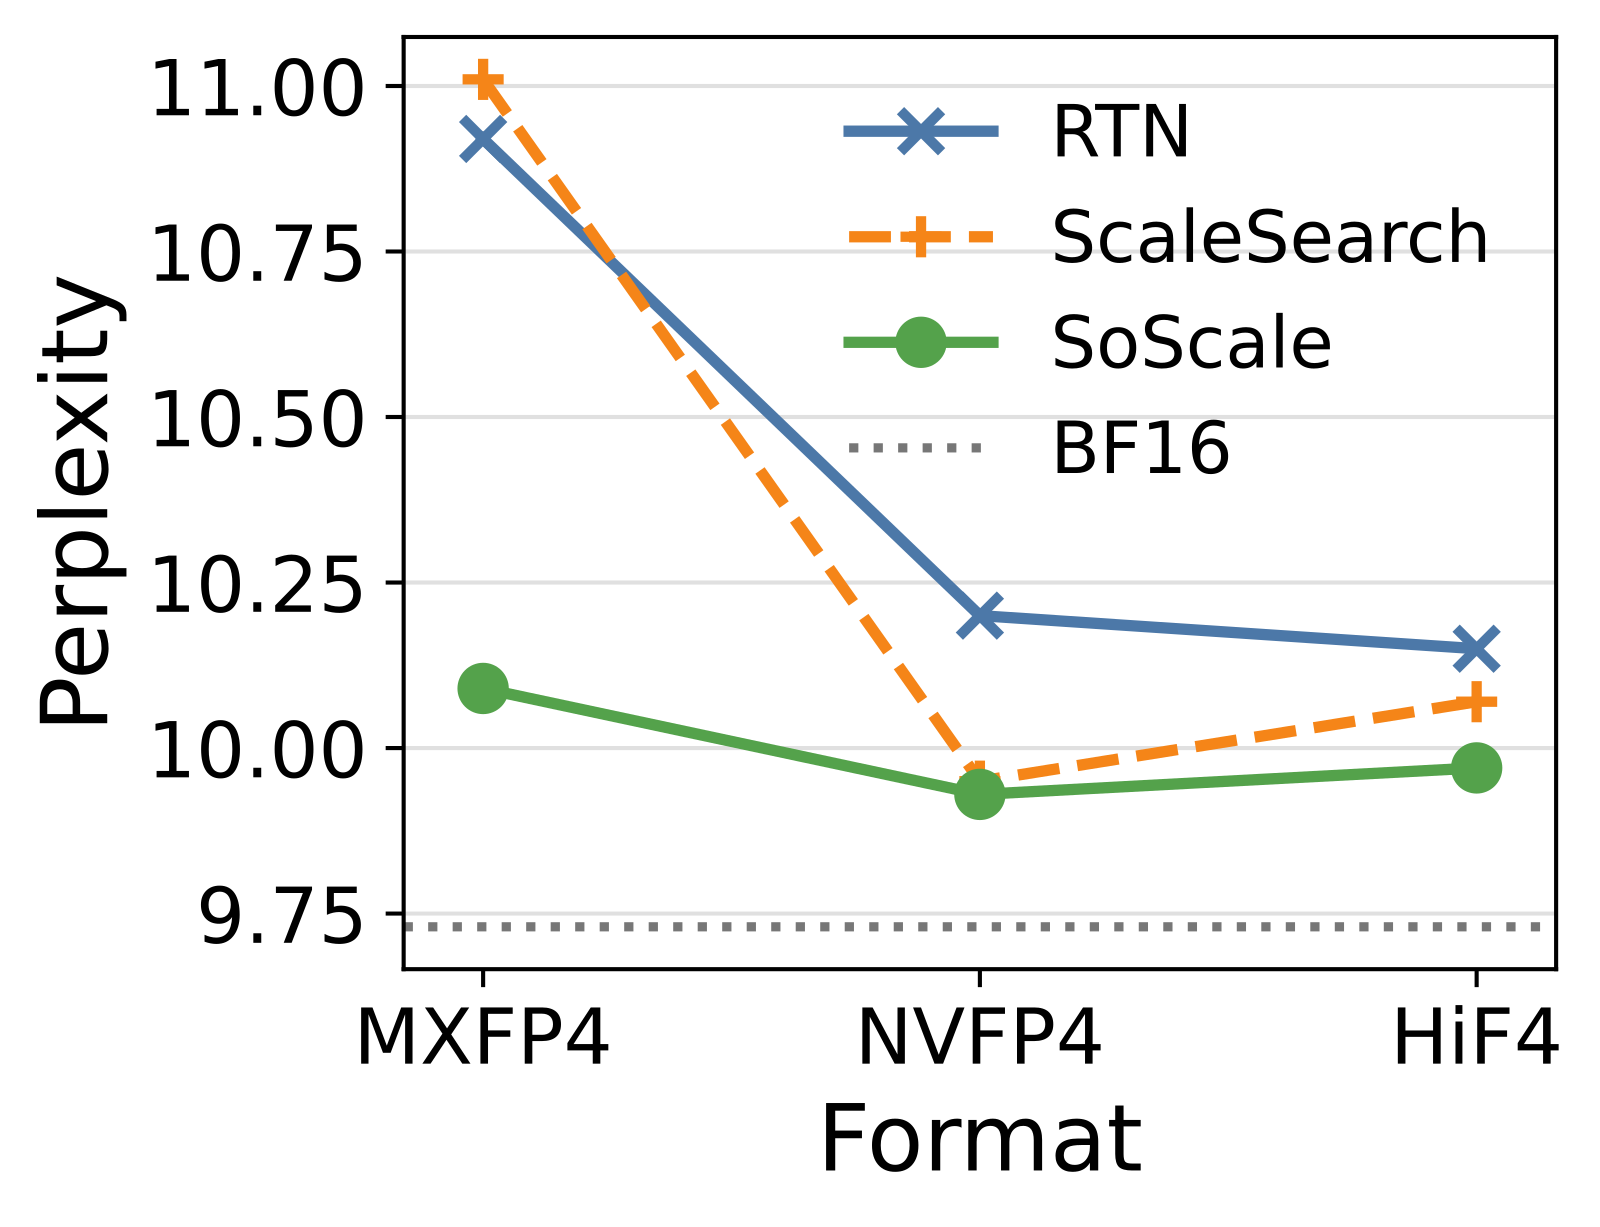
论文在 Qwen3-8B 上量到了同样的事:在 MXFP4 下,按逐元素误差挑 scale 的方法,困惑度比默认量化还高;换成按层输出来挑,困惑度降到 10.1 左右,离 BF16 的 9.7 近了一大截。
这篇论文来自华为,做的是大模型的 FP4 训练后量化。FP4 每个数只有 16 个可选值,MXFP4、NVFP4、HiF4 这类格式给每一小块数配一个 scale,scale 决定这 16 个值摆在数轴的哪里。默认规则按块里最大的绝对值定 scale;已有的 scale 搜索方法(比如 ScaleSearch)在几个候选里挑让块内均方误差最小的那个。SoScale 换了打分标准:用校准数据算出的 Hessian 给每个误差加权,看它会让层输出偏多少,再配上 GPTQ 式的误差补偿,前一块的误差由后面的块分摊。在 Qwen3-14B 上,它在三种格式下分别保住 BF16 平均准确率的 97.17%、99.20% 和 99.40%,每一组都是最好。
挑 scale 要看它对层输出的影响,块内误差最小不等于模型最好;提升幅度不大,比最强的非 SoScale 基线高 0.21 到 0.77 个百分点。
FP4 的 16 个值,被离群值占走了
FP4 的数值本身只有 4 位。MXFP4 用 E2M1 编码,正半轴只有 8 个可选值,最大是 6,再乘上这一块共用的 scale。因为 MXFP4 的 scale 只能是 2 的整数次幂、每 32 个数共用一个,scale 每挪一档,整张格子就放大或缩小一倍。
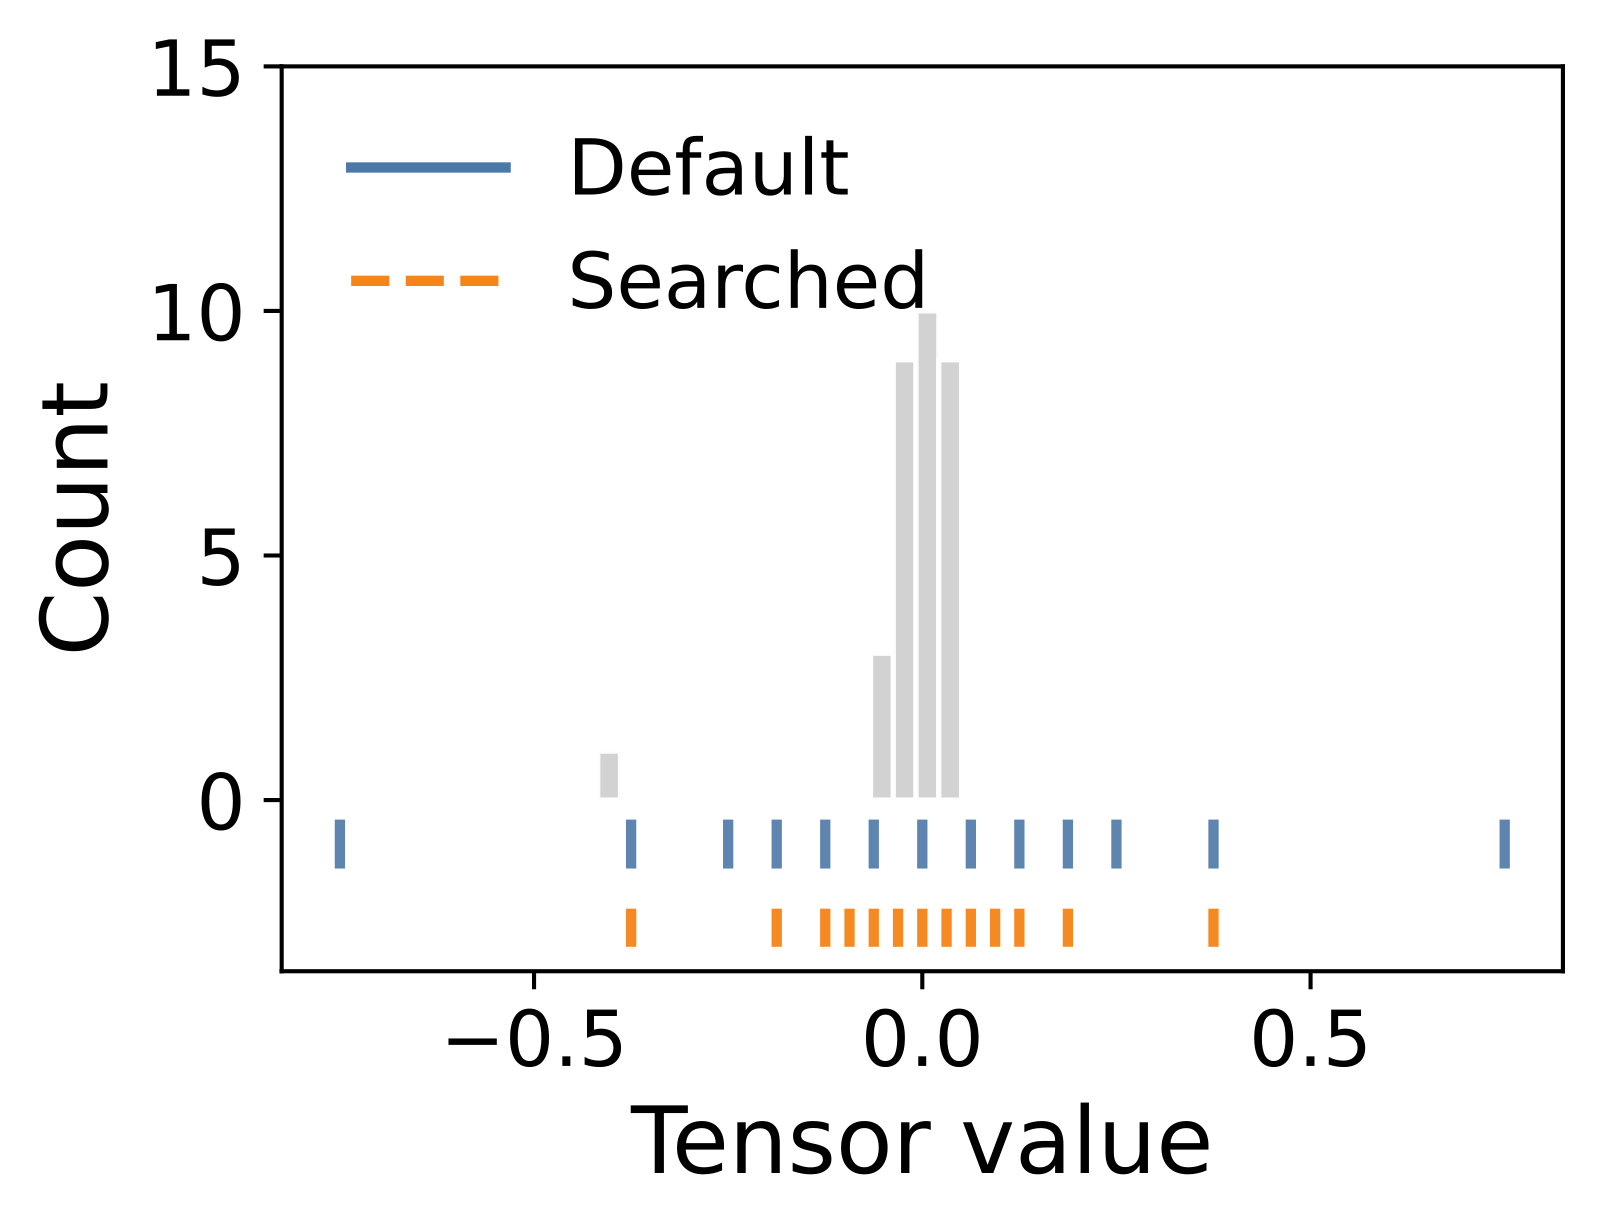
scale 大,覆盖的范围宽,但相邻两个可选值隔得远;scale 小,范围窄,靠近 0 的地方分得更细。默认规则为了不截断最大的数,按块里的最大绝对值定 scale。块里有一两个离群值时,整张格子被拉宽,大部分挤在 0 附近的数只能用很少几个格子。
只看块内误差,哪里不够
已有的 scale 搜索在一个小窗口里试几个候选 scale,挑块内均方误差最小的。它默认每个权重的误差同样要紧。
可层的输出是输入乘权重。某一列权重对应的输入通道在数据上常常很大,这一列的误差就会被放大;对应的输入几乎总是 0,误差再大也影响不到输出。两列误差还可能互相抵消或叠加,取决于两个输入通道是否同时出现。块内均方误差看不到这些。
论文图 1 右边就是这个后果。在 MXFP4 下,按均方误差挑 scale 的 ScaleSearch 困惑度约 11.0,比默认量化的约 10.9 还高。
SoScale 怎么挑 scale
先用 128 段、每段 2,048 个 token 的 WikiText 校准数据跑一遍,收集每个线性层的输入 X,算出 H = XᵀX。H 的对角线记录每个输入通道平时有多大,非对角线记录两个通道是否常常一起出现。
然后一块一块地挑 scale。候选是默认 scale 码上下各挪几档,超出格式合法范围的剪掉。每个候选都把这一块量化一遍,得到这一块的误差向量 e。打分用 eᵀH_b e,H_b 是 H 里只属于这一块输入通道的那一小块,算的是这块误差单独会让层输出偏多少。H_b 换成单位矩阵,这个分数就退回成均方误差。
挑定一块之后,它的误差不会就这么留着。SoScale 沿用 GPTQ 的做法,用 H 的逆把这块的误差折算到后面还没量化的权重上,让后面的块去补。下一块的 scale 是在补过之后的权重上挑的。 Hoot 说
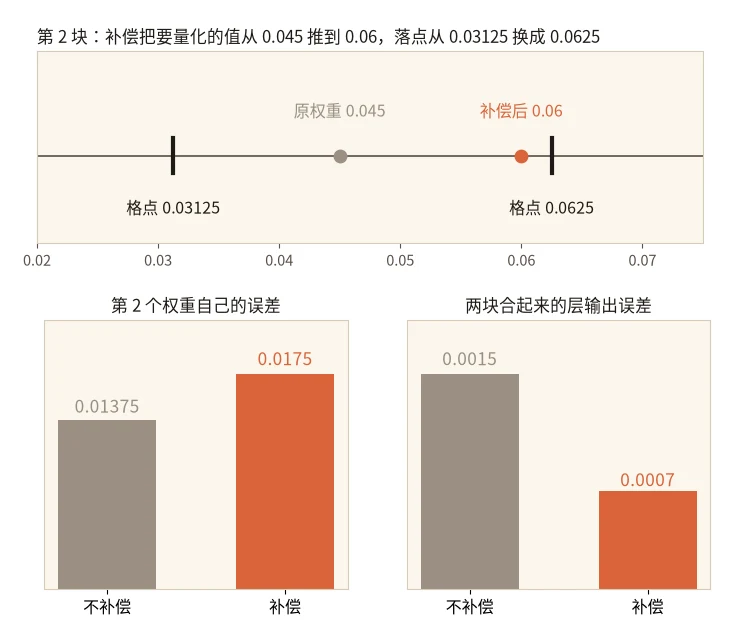
示意:一行权重只看两列,各当一块。第 1 列是 0.03,第 2 列是 0.045。
第 1 块的误差 → 第 2 块的工作副本 → 第 2 块的落点 → 层输出误差
- 校准数据 → H两个输入通道平时一样大,而且常常一起变大,所以 H 的交叉项是正的。h11 = h22 = 1,h12 = 0.5
- 第 1 块 → 误差按第 1 块选定的 scale,0.03 只能落在 0 上,留下 0.03 的误差。e1 = 0.03 − 0 = 0.03
- 第 1 块的误差 → 第 2 块的工作副本两个通道常一起出现,第 1 列少给的输出可以让第 2 列多扛一部分。补偿把第 2 列的工作副本往上推。0.045 + 0.5 ÷ 1 × 0.03 = 0.06
- 工作副本 → 第 2 块的落点第 2 块的格点里,附近有 0.03125 和 0.0625。不补偿时 0.045 落到 0.03125,补偿后 0.06 落到 0.0625。0.045 离 0.03125 差 0.01375,离 0.0625 差 0.0175
- 两块的误差 → 层输出误差补偿后第 2 个权重自己的误差变大了,两块合起来的 eᵀHe 却降了一半多。下一块挑 scale 时,打分用的就是补偿后的值。不补偿 0.0015,补偿 0.0007
出处
论文 §3.2 式 (9)–(13)(GPTQ 式误差传播,按逆 Hessian 回代到后续列)与式 (2)、(7) 的 eᵀHe 损失;两列权重、H 的取值和格点都是示意数字,两列各当一块三种格式各搜各的码。MXFP4 搜 2 的幂次 scale;NVFP4 搜每 16 个数一个的 E4M3 scale,整张张量的 FP32 scale 不动;HiF4 搜顶层的 E6M2 码,下面两层 E1 scale 跟着推出来。
走一遍:图 1 里那块权重
下面用论文图 1 的那个 Qwen3-8B 权重块,scale 0.125 和 0.0625 来自论文,单个元素的数值是示意。
第一步,默认规则。块里最大的是一个约 −0.4 的离群值,默认 scale 定为 0.125,所以最外面的可选值是 ±0.75,相邻格子在 0 附近隔 0.0625。离群值 −0.4 四舍五入到 −0.375,±0.75 一个数都没分到。挤在 0 附近的大部分数,只能落在 0 和 ±0.0625 这三个格子上。
第二步,列候选。scale 码上下各挪两档,候选 scale 是 0.03125、0.0625、0.125、0.25、0.5。
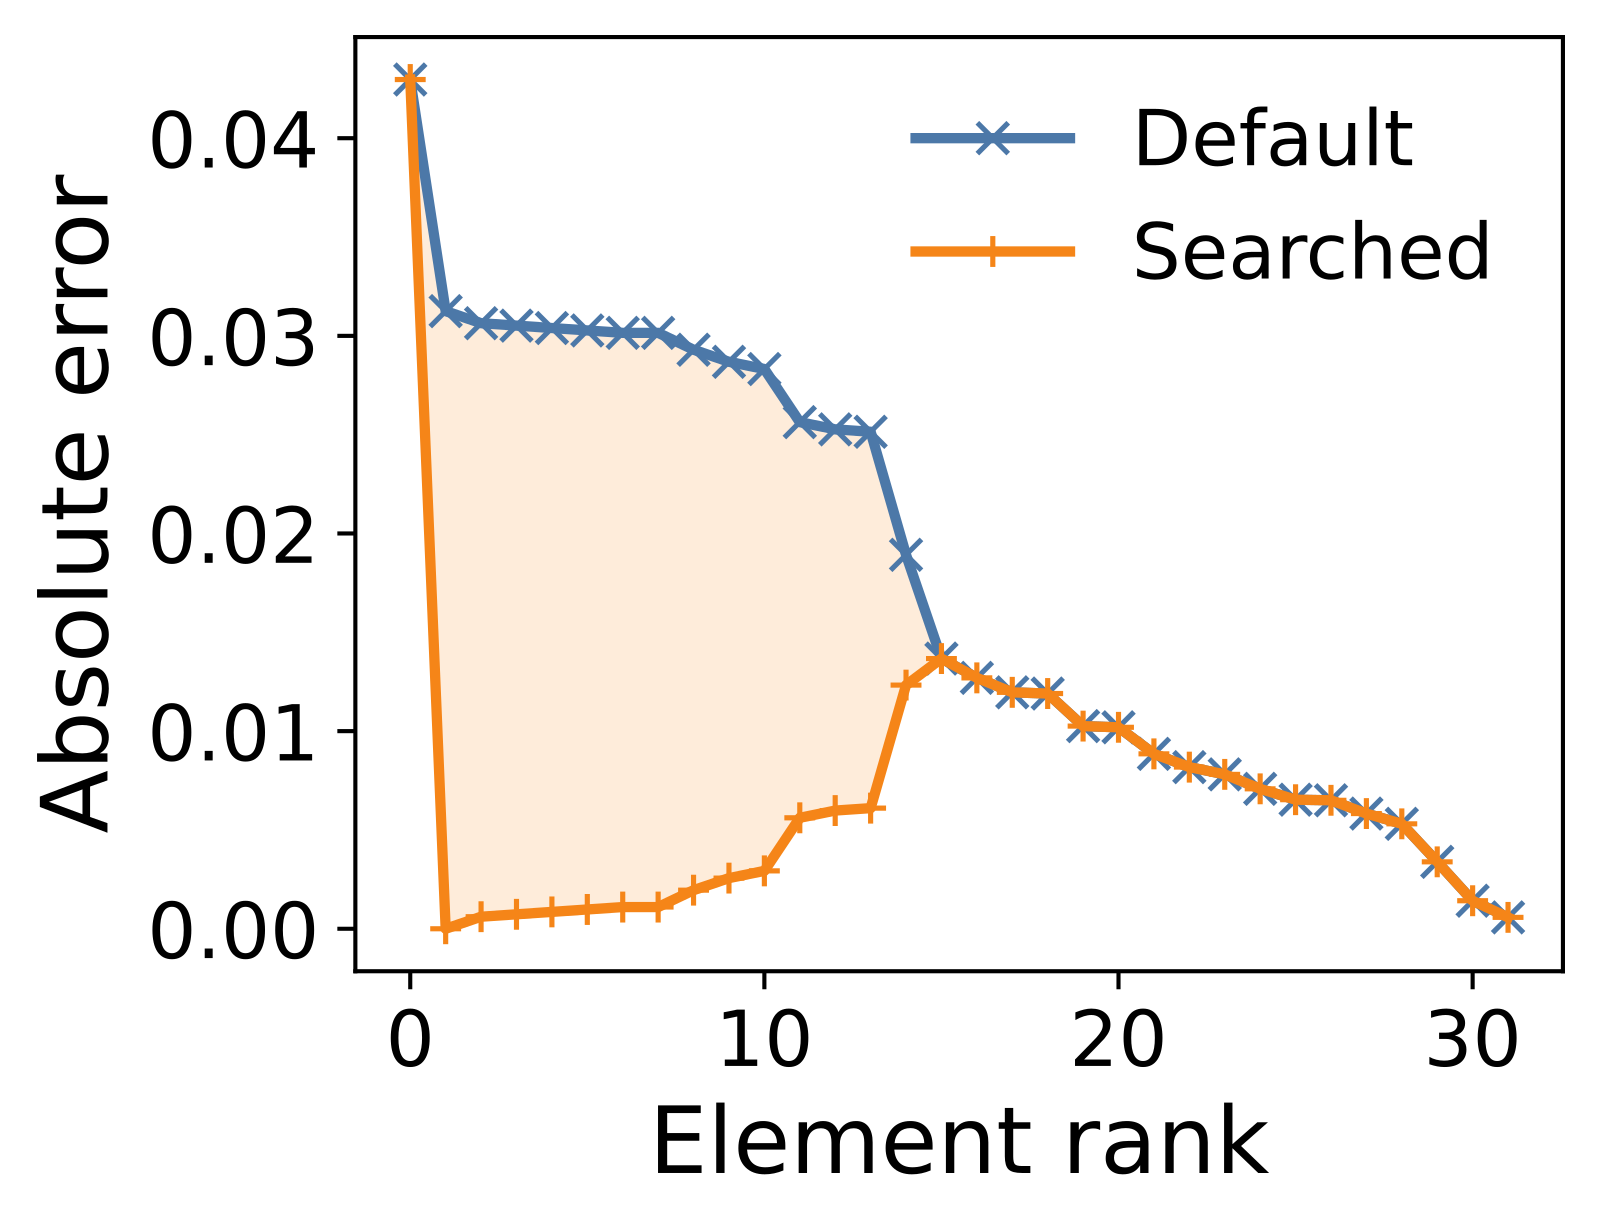
第三步,试 0.0625。可选值变成 0、0.03125、0.0625、0.09375、0.125、0.1875、0.25、0.375。离群值 −0.4 被截到 −0.375,和默认时落在同一个值上,所以误差不变。0 附近多了 ±0.03125 两个格子。示意:一个 0.03 的权重,默认时只能取 0,误差 0.03;现在取 0.03125,误差约 0.001。论文图 1 的误差曲线就是这样:离群值的误差没变,一大批接近 0 的数,误差从 0.03 左右掉到接近 0。
第四步,打分。每个候选的误差向量 e 都算一遍 eᵀH_b e,误差落在常被激活的输入通道上,扣分就重。均方误差只看误差本身多大,所以两种打分可能选出不同的 scale;SoScale 选 eᵀH_b e 最低的那个。
第五步,补误差。这块量化后剩下的误差,按 H 的逆折算到后面那些列上,修改工作副本里还没量化的权重。下一块的候选再在修改后的权重上打分。
实验结果
实验在 Qwen3-8B 和 Qwen3-14B 上做 W4A4:Transformer 块里线性层的权重和激活都压到 FP4,embedding、输出层和归一化层留在 BF16。激活用一条每个 token 在线算 scale 的轻量规则。评测用 7 个下游任务的平均准确率。
两个模型、三种格式,一共 6 组,每组平均分最好的都是 SoScale 或它加上块 Hadamard 旋转的版本。比每组最强的非 SoScale 方法高 0.21 到 0.77 个百分点,比 ScaleSearch 高 0.47 到 1.10。MXFP4 上提升最大。论文的解释是,因为它的 scale 只能按 2 倍跳,离群值最容易把格子撑得太粗。
拆开看搜索和补偿各起什么作用,论文在 Qwen3-8B 上做了消融:
| 格式 | 默认量化 | ScaleSearch | 均方误差 + 补偿 | SoScale |
|---|---|---|---|---|
| MXFP4 | 69.71 | 70.56 | 70.61 | 70.92 |
| NVFP4 | 72.62 | 72.81 | 72.70 | 73.56 |
| HiF4 | 72.11 | 72.42 | 72.63 | 72.95 |
(数字来自论文表 4,7 个任务的平均准确率,单位 %)
只给均方误差搜索加上误差补偿,效果时好时坏,NVFP4 上还降了。换成 Hessian 打分再配补偿,三种格式都是最好。这说明光把补偿接上去不够,打分标准换成按层输出才是这组消融里稳定的那一步。
块 Hadamard 旋转单独用时有好有坏,有时还不如默认量化。和 SoScale 叠加,在 MXFP4 上两个模型都拿到最好成绩;但 Qwen3-8B 的 NVFP4 和 Qwen3-14B 的 HiF4,单用 SoScale 更好。论文还试了激活直接用默认量化的版本,SoScale 的权重搜索在 6 组里仍然都比 ScaleSearch 的权重搜索好,差距在 0.08 到 1.92 个百分点之间。
这对做模型部署的人意味着什么
如果硬件已经支持 MXFP4、NVFP4 或 HiF4,SoScale 量化出来的仍是原格式,推理 kernel 不用为它改,离线算一次就能拿到这部分精度。
存下来的仍然是标准的 FP4 数值加合法的 scale 码,推理时不再搜权重的 scale。权重这边的计算都在离线量化阶段:每层要算 H,每块要把几个候选各量化一遍、各算一次 eᵀH_b e,再做误差补偿。激活在主实验里仍按在线规则给每个 token 选 scale;激活直接用默认量化的版本连这一步也省了。
想先试,从 MXFP4 开始,那里提升最大,也最值得叠加 Hadamard 旋转。已经在用 GPTQ 的团队,改动集中在挑 scale 的那一步:在补偿后的权重上,用 eᵀH_b e 给候选打分,补偿流程照旧。表 4 也提醒,单把 GPTQ 的补偿接到均方误差搜索后面,收益不稳定。
局限
实验只覆盖 Qwen3 的 8B 和 14B 两个尺寸,校准集只用 WikiText。提升以零点几个百分点为主,NVFP4 和 HiF4 本来就接近 BF16,剩下的空间不大。SoScale 只搜权重的 scale,激活仍用简单的在线规则,两边没有联合优化。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…