 已录用 SIGIR 2026 Workshop
目录 · 5 节
1一句俄语怎样变成向量:查正负号,乘长度,再平均2词表和正例从哪里来3训练时就让损失看见正负号4比静态模型高 8 分,离最小的 Transformer 差 2.6 分5RuMTEB 检索和长截断上 BM25 更强,短截断上 StaRSE 更高
StaRSE 把俄语句向量压成一张 11.3 MiB 的词表:每个 token 只存 512 个正负号和一个长度,查表求平均就得到句向量,比所有对比过的静态模型高 8 分;但在 RuMTEB 检索均值和长文档长截断上,用同一分词器的 BM25 仍然赢它,只有长文档截断较短时 StaRSE 更高。
先看一个场景。一个俄语知识库要做语义搜索,用户输入「Как заварить зелёный чай」(怎么泡绿茶),库里有一句「Зелёный чай заваривают водой 80 градусов」(绿茶用 80 度的水泡)。系统要把查询和库里每一句都编码成向量,再按余弦相似度找最近的句子。这两句俄语只是示意,后文会一直用它们。
难处在编码这一步。用 Transformer 句向量编码器,查询要跑一次前向,库里的每一句也要各跑一次。只要句向量必须在 CPU 上算、要频繁刷新、延迟预算很紧,或者语料特别大,这一次次前向就成了瓶颈。
现有的便宜做法是静态模型:每个词或 token 在词表里有一个固定向量,句向量就是这些向量的平均再归一化,推理只剩查表。它的缺口也在同一个例子里看得到。「как」(怎么)几乎出现在每个问句里,却和「чай」(茶)按同样分量进入平均,两个问句只要都以「как」开头就会被拉近。平均还丢掉了词序和语境,「заварить」在哪句话里都是同一个向量。所以真正的问题是:静态模型能不能在低得多的成本下,给出够用的句向量质量。
StaRSE 的回答分两半。训练时,它从 ruBERT-base 的输入 embedding 出发,用俄语句子对做对比学习。部署时,它只留下一张「符号词表」:12 万个 token,每行是 512 个正负号加一个长度。在 RuMTEB(俄语版 MTEB,23 个任务)上,它的均值是 51.16,比最强的静态基线高 7.98 点,只比上下文编码器里最小的 ruBERT-tiny-turbo 低 2.60 点。这说明它在静态模型和 Transformer 之间占了一个新位置,代价却还是查表:CPU 上编码一句平均 0.08 ms,ruBERT-tiny-turbo 要 1.43 ms。
一句俄语怎样变成向量:查正负号,乘长度,再平均
部署时一句话的处理只有四步:分词、查表、按范数(向量长度)加权求平均、归一化。符号词表的一行长这样(示意):
token "чай"  → 符号位: + + − + − − + … (共 512 位)   范数 ρ = 2.0
token "как"  → 符号位: + − − − + + − … (共 512 位)   范数 ρ = 0.5
符号位记的是这个 token 方向上每一维是正还是负。范数 ρ 是这个 token 原本向量的长度,决定它在平均时说话多大声。查表时,每一维取 +1 或 −1,除以 √512,再乘上 ρ。查询里的所有 token 这样处理后求平均,最后做 L2 归一化,得到的句向量仍是实数。
用 4 维算一遍(示意,√4 = 2)。「чай」的符号是 (+,+,−,+),ρ = 2,贡献 (1, 1, −1, 1)。「как」的符号是 (+,−,−,−),ρ = 0.5,贡献 (0.25, −0.25, −0.25, −0.25)。两者平均得 (0.625, 0.375, −0.625, 0.375),方向主要跟着「чай」走。这说明范数决定了每个 token 在平均里占多少分量:示意里虚词「как」的 ρ 小,就被压了下去。
为什么不用更简单的做法?第一种简单做法是只存符号、不存范数。上面的例子里两个 token 都按 0.5 计,平均是 (0.5, 0, −0.5, 0)。因为两个 token 分量一样,第二、四维被抵消,「как」和「чай」拉得一样用力。
在真实模型上,去掉范数让 RuMTEB 少了 8.42 点,这意味着它退回了普通静态模型的水平。
第二种更省的做法是在这张符号词表上照常池化,最后再把句向量也取符号,以前一些检索系统就这样压缩句向量。例子里的 (0.625, 0.375, −0.625, 0.375) 会变成 (+,+,−,+),0.625 和 0.375 的差别没了。论文在最终的符号词表上试过:保留范数、再把池化后的句向量取符号,掉 3.84 点;既去掉范数、又把句向量取符号,掉 12.10 点。StaRSE 因此只对 token 的方向取符号,句向量保持实数。
范数才是这张表的关键:它只占每行一个数,去掉它比把句向量取符号伤得多。
这张表的大小可以心算:12 万个 token 乘 512 位,大约 7.3 MiB;每个 token 再加一个范数,和实测 11.3 MiB 的包是同一量级(推算)。同样的表如果每维存一个 32 位浮点数,就要 200 多 MiB(推算)。
词表和正例从哪里来
这张符号词表经过四个阶段才得到,前三个阶段只在训练时存在:
| 步骤 | 输入 | 操作 | 产出 | 只在训练时? |
|---|---|---|---|---|
| 1 初始化 | ruBERT-base 的分词器(120,138 个 token)和输入 embedding 矩阵 | 按 token 做 PCA 到 512 维,丢掉最主导的前几个方向,再按词频降权 | 实数初始词表 | 是 |
| 2 造正例 | Cultura 俄语网页文档、mMARCO、ru-HNP、回译句对 | 相邻句按原形词重合度过滤,和其他三类句对按来源均衡采样 | 训练句对 | 是 |
| 3 连续训练 | 初始词表 + 句对 | 双向 InfoNCE,20,000 步后再续 10,000 步 | 实数词表 E⁽⁰⁾ | 是(之后当作冻结的老师) |
| 4 符号投影后训练 | E⁽⁰⁾ + Cultura 句对 | 前向用符号词表算损失,另加一项向老师看齐 | 符号词表:每行 512 位 + 1 个范数 | 否,部署只用它 |
第 1 步里的两个处理都针对平均。丢掉前几个主方向(论文称 ABTT,即只保留主方向以外的成分)是因为这些方向几乎所有 token 都有,会主导余弦相似度。按词频降权用的是 SIF(越常见的 token 权重越小的平滑加权),目的是让「как」这类高频词在平均里分量变小。
第 2 步要回答一个现实问题:俄语里大规模、可靠标注的句对不多。StaRSE 的主要正例是同一文档里前后相邻的两句。相邻两句不一定是复述,所以作者只把它当弱正例,并用一个便宜的词法过滤去掉断句错误和毫不相干的跳转。
过滤用的是 Dice 重合度:两句各取去掉停用词、还原成原形的词,重合度 = 2 × 共同词数 ÷ 两句词数之和,至少 0.20 才保留。示意:「Зелёный чай заваривают водой 80 градусов」和下一句「Слишком горячая вода делает чай горьким」(水太烫会让茶变苦)各有 5 个原形词,共享「чай」「вода」两个,重合度 2×2÷10 = 0.4,保留;和另一篇文档里一句毫无共同词的句子配对,重合度 0,丢掉。
这个过滤确实挑出了更像的句对。作者用一个不参与训练的外部编码器 USER2-small 各抽 3 万对,算中位余弦:随机跨文档 0.573,未过滤的相邻句 0.726,过滤后 0.820。这说明相邻句比随机配对相似得多,过滤又把它往上推了一截。
为什么不直接蒸馏一个现成的强编码器?论文在一组更小预算的单次实验里试过:从两个俄语句向量编码器(BERTA 和 USER2-small)蒸馏出的静态学生只有 42.0 和 44.2 RuMTEB,用相邻句对比学习的是 48.2,加上原形词过滤和其他来源混合是 49.9。两组预算不同、只跑一次,只能说明在这个设定里对比学习这条路更好走。
训练时就让损失看见正负号
最省事的做法是训完实数词表 E⁽⁰⁾ 之后直接取符号。问题在于,损失函数从来没见过取完符号的表,取符号时丢掉的信息没人替它补。
StaRSE 的最后阶段把取符号放进前向。优化器更新的仍是一张实数表 E,但每次前向都先把每行拆成长度 ρ 和方向 u,再用 ρ × sign(u)/√512 代替原行去算句向量和损失。sign 本身没有梯度,作者用直通估计器:反向传播时把它当成恒等函数,梯度照常回到 E,于是方向和长度都会被更新。
这一阶段的损失有两项。一项是和前面一样的双向 InfoNCE:一个 batch 里有 k 对句子,每句要把自己的配对打分排在另外 k−1 句前面,两个方向各算一次。另一项让符号词表向冻结的 E⁽⁰⁾ 看齐:在同一个 batch 里,老师对每一行、每一列算出一个 softmax 相似度分布,学生的分布用 KL 散度贴近它。直观地说,老师告诉学生这一批里谁和谁该更像。
几种得到符号词表的路线,论文在同一个 512 维架构上比过:
- 对比训练完直接取符号(不做后训练):49.33
- 再续一段普通对比训练,然后取符号:50.09(+0.76)
- 符号投影后训练(最终配方):51.16(+1.83)
这说明单纯多训练只解释了 0.76 点,剩下的 1.07 点出现在让损失看到符号的那条路线上;这条路线同时换成只用 Cultura 句对、加了老师项,几项拆不开。最终配方的超参是按 RuMTEB 全均值用 Optuna 选出来的,而且只跑了一个种子,所以这 1.83 点偏乐观。
比静态模型高 8 分,离最小的 Transformer 差 2.6 分
把主结果放在一起看(RuMTEB 各列为任务族均值,大小和单句 CPU 延迟来自论文 Table 4):
| 模型 | 类型 | RuMTEB 均值 | 分类 | 聚类 | 检索 | STS | 大小 MiB | CPU ms/句 |
|---|---|---|---|---|---|---|---|---|
| GigaEmbeddings | 上下文 | 74.16 | 76.66 | 67.48 | 81.41 | 75.75 | 6580(估算) | 773.61 |
| ruBERT-tiny-turbo | 上下文 | 53.76 | 55.08 | 49.62 | 48.82 | 71.73 | 55.7(估算) | 1.43 |
| StaRSE | 静态 | 51.16 | 56.81 | 51.80 | 39.09 | 62.17 | 11.3 | 0.08 |
| Potion multilingual | 静态 | 43.18 | 50.12 | 41.39 | 22.03 | 59.00 | 507 | 0.07 |
| fastText wiki+lenta | 静态 | 42.85 | 51.87 | 42.52 | 18.78 | 55.53 | 1853 | 0.05 |
和静态模型比,StaRSE 的均值高 7.98 点,包却小了一个数量级以上,单句延迟和它们相当。除了句对分类(TERRa 蕴含任务,几个静态模型基本打平),它在每个任务族都领先。这说明同样是查表求平均,换一套训练方法就能把分数推高一大截,表还能小得多。
和 ruBERT-tiny-turbo 比,均值只差 2.60 点,分类和聚类 StaRSE 反而略高;差距集中在检索(低 9.73)、重排和 STS。CPU 上每句 0.08 ms 对 1.43 ms,大约快 18 倍。回到开头的知识库:示意 1,000 万句的语料在单核上编码一遍,按这两个延迟分别约 13 分钟和 4 小时。
这组数字有两个口径要记住。上下文模型的大小是参数量乘 2 字节的估算,静态模型是实测包大小。延迟只测了编码一句话,包括分词、池化和归一化,不含建索引和搜索。51.16 本身是按 RuMTEB 选参、单种子跑出来的,不是留出集上的估计。离大模型的距离也仍然很远:GigaEmbeddings 比 StaRSE 高 23 点。
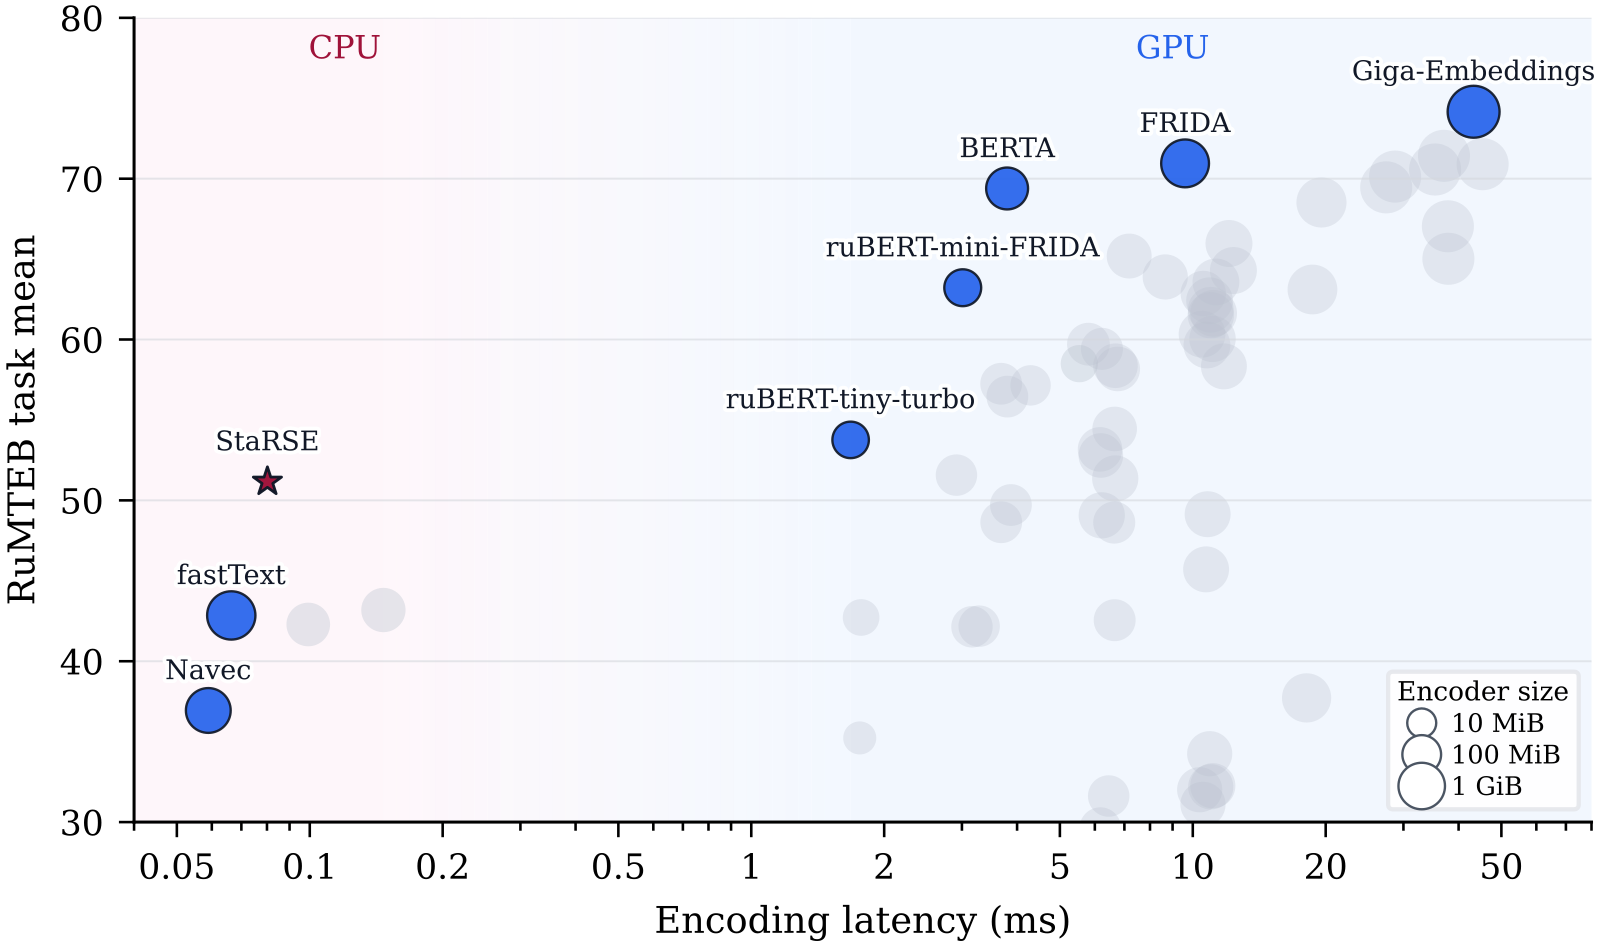
图里左右两边设备不同,只能看大致位置:StaRSE 在静态模型那一侧明显高出一截,高度略低于 ruBERT-tiny-turbo。
RuMTEB 检索和长截断上 BM25 更强,短截断上 StaRSE 更高
摘要里「强于静态基线」的说法,不等于强于词法检索。论文在同一张表里加了几种词法排序器,用的正是 StaRSE 的 ruBERT WordPiece 分词,不做词干化,参数固定。
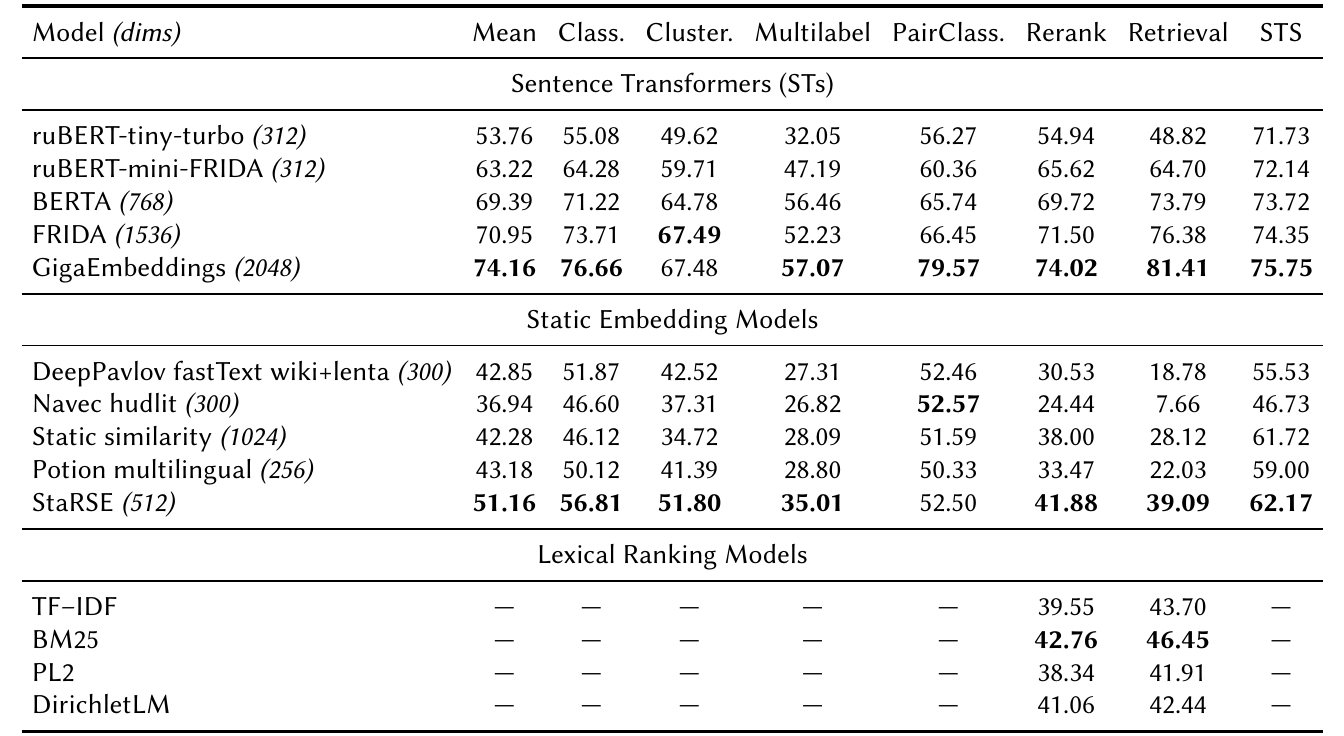
BM25 在检索上是 46.45,StaRSE 是 39.09,低 7.36 点;重排 42.76 对 41.88,也低 0.88 点。这说明在 RuMTEB 的检索任务上,StaRSE 单独上场还不如一个参数固定的 BM25。
长文档上的结果分两段。MLDR-RU 是一个俄语长文档检索集,作者用 1 万篇文档、200 个查询。静态编码器不跑自注意力,所以长文档可以边查表边累加进同一个平均,不受上下文窗口限制。StaRSE 的 nDCG@10 从每篇只留 128 个 token 时的 32.11,升到留 4,096 个 token 时的 52.01,说明多读的文档内容确实被用上了。截断在 128 到 2,048 个 token 时,StaRSE 一直高于 BM25,例如 128 个 token 时是 32.11 对 28.34;BM25 到 4,096 个 token 才跳到 68.12。
留 8,192 个 token 时,StaRSE 是 51.66,和小号上下文编码器 USER2-small 几乎一样,不过后者的数字抄自模型卡。同一设定下 BM25 是 69.97,这意味着截断放长到 4,096 个 token 以后,BM25 反超并拉开了一大截。两者融合到 73.07,但融合权重是在同一个测试集上挑的,只能当作描述。
平均池化还有一个由结构决定的边界。「Собака укусила человека」(狗咬了人)和「Человека укусила собака」(人被狗咬了)由同样的 token 组成,查表求平均后得到完全相同的向量。词序和语境,StaRSE 从设计上就放弃了,作者也用这一点解释它在蕴含任务 TERRa 上为什么没有优势。
在 RuMTEB 检索均值和 MLDR-RU 长截断(4,096 个 token 以上)上,参数固定的 BM25 高于 StaRSE;截断在 128 到 2,048 个 token 时,StaRSE 更高。
作者把两者看作互补,什么样的查询和领域里互补,留给后续工作。
回到开头那句判断:一张只存正负号和长度的 11.3 MiB 词表,确实让俄语静态句向量往上走了 8 分、追到最小 Transformer 的 2.6 分以内;可它的主分数是在 RuMTEB 上选参得到的,在 RuMTEB 检索和长截断的 MLDR-RU 上,它仍低于同一分词器、参数固定的 BM25。换到其他语言,分词器、过滤阈值和数据配比都要重新验证。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…