
长上下文解码时,每生成一个 token 都要把整个 KV cache 从 HBM 读一遍,所以上下文越长,注意力越慢。稀疏注意力只读其中一小部分 token,但压到 50 倍稀疏时,现有方法和稠密注意力差得很远:Llama-3.1-8B 在 RULER-HARD 32K 上,稠密注意力得 88.76,PQCache 式的 top-k 只有 72.51。这篇论文提出 SSA(Stratified Sparse Attention),思路是分数高的 token 一定保留,剩下的长尾按代理分数抽样,抽中的 token 再按“被抽中的概率”放大权重。同样 50 倍稀疏,Llama-3.1-8B 的分数回到 83.67;Qwen3.5-9B 做 AIME 2025,SSA 得 59.8,PQCache 只有 36.7。作者还写了专门的 CUDA kernel,1M 上下文时解码注意力比 FlashInfer 快 2.96 倍。
1. 问题:top-k 丢了长尾,均匀采样又浪费预算
预算是 个 token,现有方法分配它的方式有三种。第一种只做检索,Quest、PQCache 用代理分数挑分数最高的 个,Tactic 做的是 top-p。注意力集中在少数 token 上时这很好用;可一旦分布比较散,集合之外那些 token 的注意力权重就全部丢了,代理分数再有一点偏差,真正重要的 token 会刚好落在边界外。第二种只做采样,MagicPig 用 LSH 近似抽样再做重要性校正,覆盖面广,但预算小时方差很大。第三种是混合,vAttention 保留 top-k,再从剩下的 token 里均匀抽样。它比前两种都好,可在激进稀疏下离稠密注意力还是有明显差距。
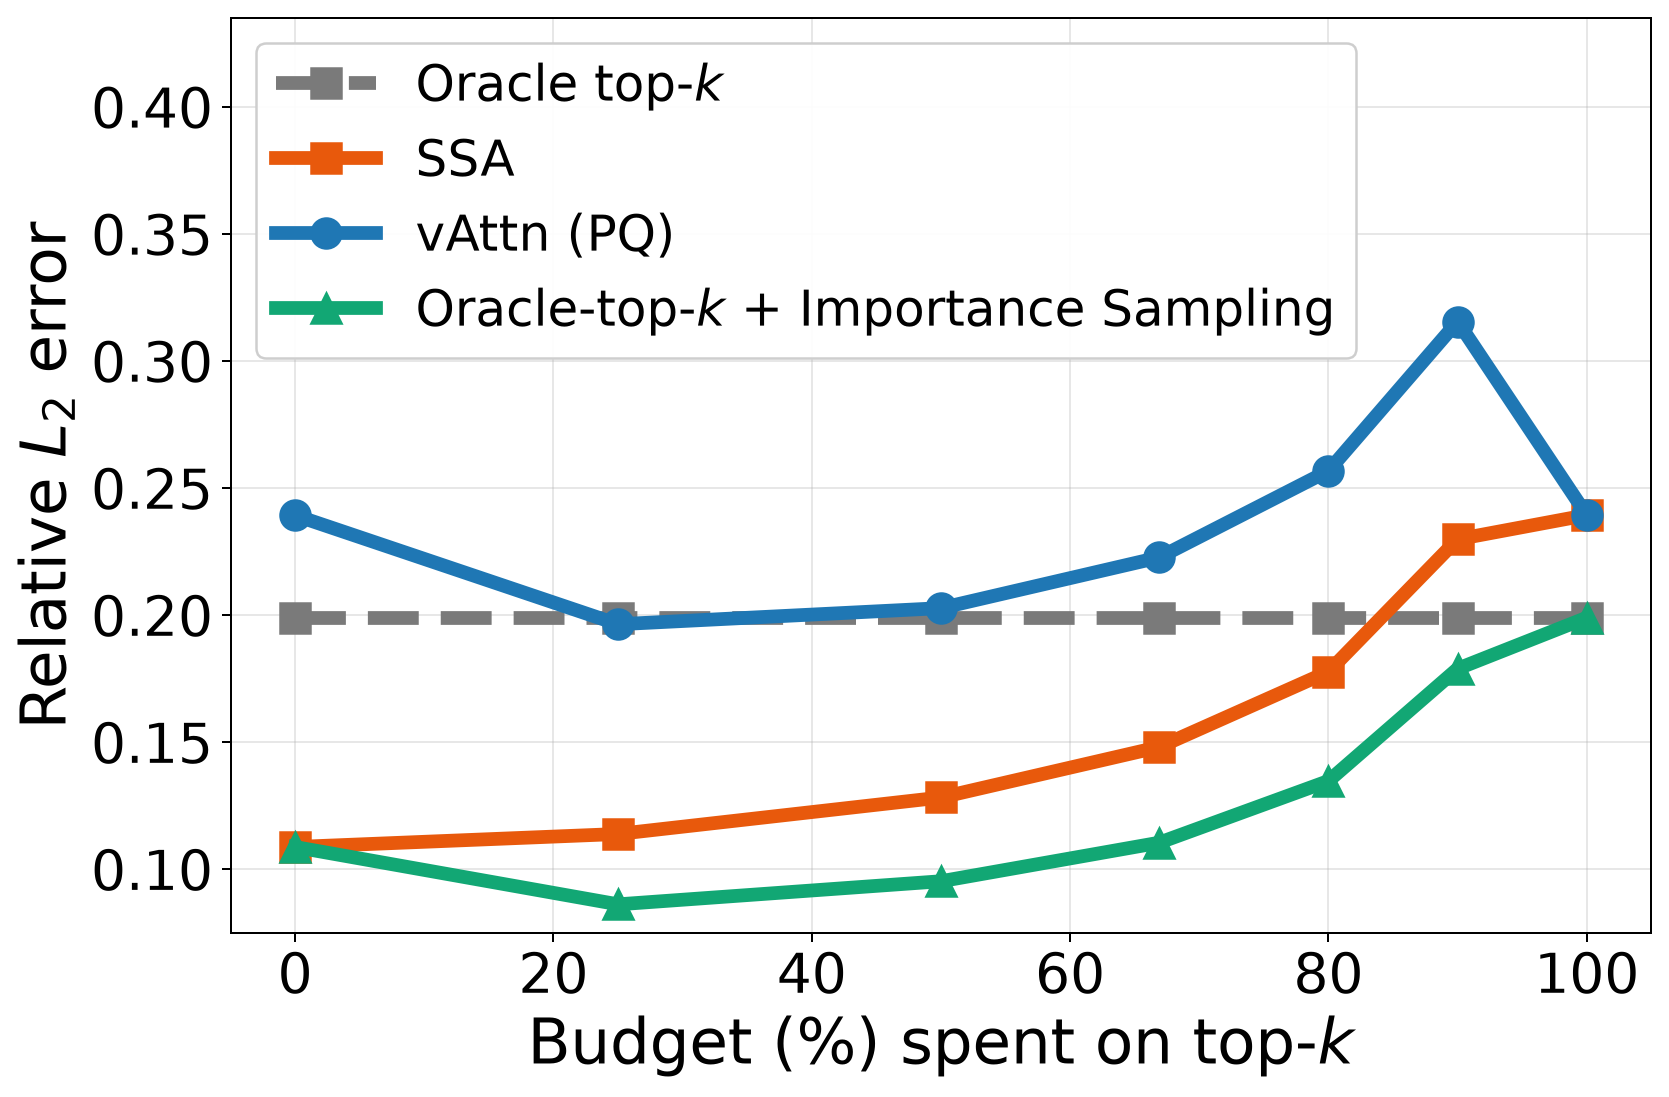
作者认为问题出在“均匀”。top-k 之外剩下的 token,注意力权重有大有小,差别很大,均匀抽样会把同样多的预算花在几乎没贡献的 token 上。他们先做了一个小实验:同样的预算,比较稀疏近似算出的注意力输出相对完整注意力输出的相对 误差。按代理分数抽样的相对误差在各种预算比例和稀疏度下都低于均匀抽样(下图)。这就是 SSA 的出发点。
2. 方法:先分层,再抽样,最后按概率修正
先看采样式稀疏注意力的基本写法。记 ,。如果每个 token 以概率 被选进集合 ,就给它乘上 :
直观地说,一个本来很难被抽中的 token 抽中了,它就要替一大片没被抽中的同类说话,所以权重要放大。SSA 在这个写法上分三步。
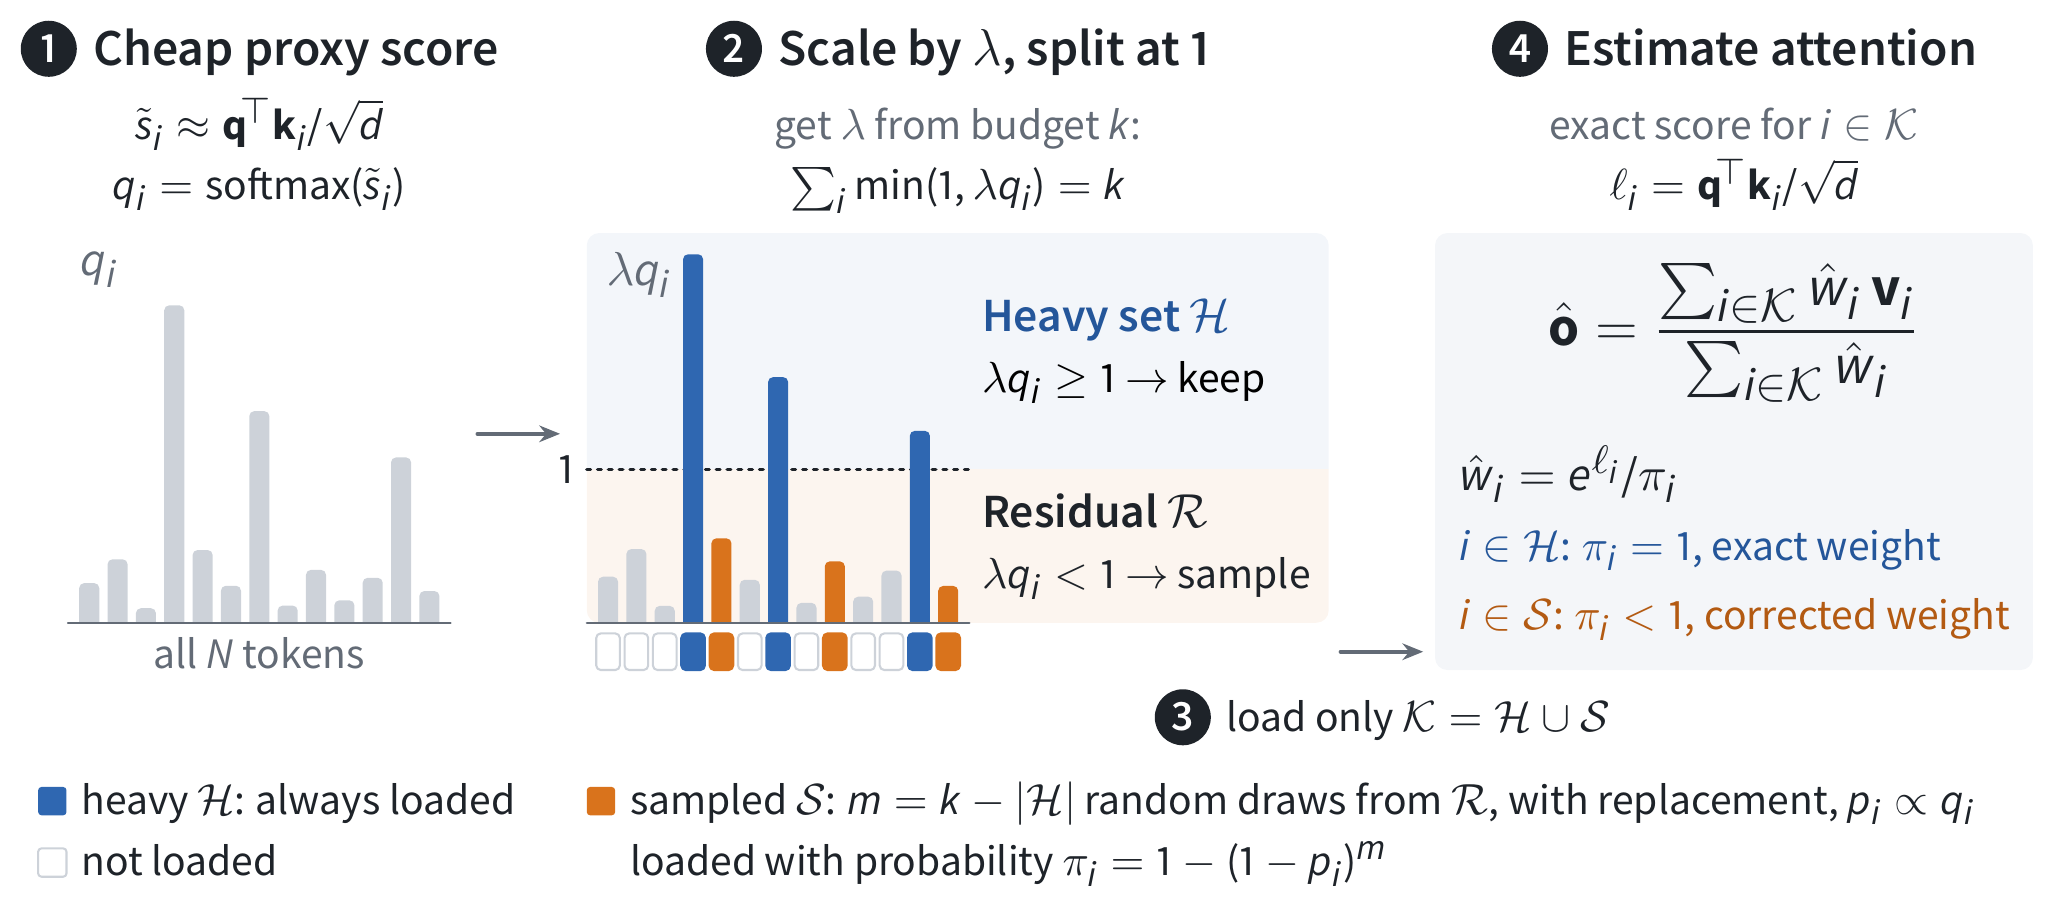
先决定哪些 token 一定保留。把代理分数 (实验里用 PQCache 的乘积量化分数)做 softmax 得到 ,再找一个 ,让 。凡是 的 token 进入重集合 ,直接保留;剩下的预算 留给其余 token(残余集合 )去抽。这样重集合多大不用手调,由代理分布决定:分布越尖,重集合越大。
然后在残余集合里抽样。把 上的 重新归一化成 ,有放回地抽 次,去重得到 。一个残余 token 至少被抽中一次的概率是 ,重集合里的 token 则是 。 Hoot 说

top-k,k = 3(对照)
- 代理 q
- 0.5、0.2、0.1、0.1、0.1
- 真实 w
- 5、2、1、1、1,和 = 10
- 保留前 3 个
- 5 + 2 + 1 = 8
- 结果
- 每次都少 2,长尾永远缺席
分母偏小,留下的 token 权重被系统性放大。
SSA,同样 k = 3
- λ = 4
- λq = 2、0.8、0.4…;min 之和 1 + 0.8 + 1.2 = 3
- 分层
- 第 1 个 λq ≥ 1,进重集合直接保留(π = 1),剩余预算 m = 2
- 残余 p → π
- 0.4 → 0.64;0.2 → 0.36
- 抽到第 2、4 个
- 5 + 2 ÷ 0.64 + 1 ÷ 0.36 ≈ 10.9
第 4 个乘上 1 ÷ 0.36 ≈ 2.78 是统计补偿:平均下来,它替没抽中的同类补回份额。
全部数字是示意:代理分数 q 和真实权重 w 都是假设的。λ 是把 q 放大的倍数,取到 min(1, λq) 加起来正好等于预算 3;π 是一个 token 被抽中的概率。“平均下来不偏”指按 1/π 加权的求和(分子、分母各自)的期望等于真值,这是“按被抽中概率的倒数加权”的一般性质;分子、分母各自无偏,不代表两者之比(归一化后的输出)也无偏,论文正文写的是误差界。 出处: 论文 §2:Σ min{1, λq_i} = k 定重集合,m = k − |H|;残余上按 p_i 有放回抽 m 次去重,π_i = 1 − (1 − p_i)^m;权重 exp(ℓ_i)/π_i 后归一化
最后只对 算精确的注意力分数 ,权重取 ,归一化后加权求和。重复抽中的 token 只算一次,所以实际读的 token 不会超过 个。
举个示意的例子(数字是假设的)。上下文 100 万 token,50 倍稀疏,预算 。假设有 8,000 个 token 满足 ,它们直接保留;剩下 12,000 次抽样在大约 99 万个残余 token 里按 进行。一个 很小的 token 被抽中后, 很大,它代表的是一大片分数都低、但加起来仍有不少注意力权重的长尾。top-k 会把这片长尾整个扔掉,均匀抽样则把大部分次数花在几乎为零的 token 上。
已有的几类方法都是这个框架的特例:只有重集合,就是 top-k 或 top-p;重集合为空,就是纯采样;提议分布换成均匀分布,就是 vAttention 那种混合。
作者还证明了一个误差界,它说明预算该怎么分。记 为残余集合里真实的注意力权重, 是 token 的真实注意力权重在残余集合内重新归一化后的值, 表示提议分布和真实残余分布差多远(,两者一致时取等号)。定理 2 说,以至少 的概率,输出误差 和 同阶,去重只多一个常数因子。所以多留重 token 能降低 ,多留抽样预算能增大 ,两者要权衡;而代理分数一旦低估了某个重要的残余 token, 就会变大,误差随之上升。
这个框架和用哪种近似检索无关。任何能给出代理分数的 top-k 方法(PQCache、Quest 等)都能直接拿来当 SSA 的提议分布,检索方法变好,SSA 也跟着变好。
3. 实现:让抽样不拖慢解码
长上下文解码受显存带宽限制,SSA 要省的是读 KV 的流量。为了跑得快,实际 kernel 没有用自适应的 ,而是固定重集合占预算的比例 ,作者报告这样和理论版本的结果很接近。解码一步分四个阶段,前三个阶段要扫完整个上下文,但每个 token 只读几个字节。
第一阶段算代理分数。每个 key 存成 16 字节的 PQ 码(16 个子空间、256 个中心),而 head 维度 256 的 fp16 KV 对要 1 KiB,所以扫一遍 PQ 码比读 KV 便宜得多。开头 128 个 sink token 和最近 128 个局部 token 无论如何都会保留,它们的分数在同一个 kernel 里顺带屏蔽掉,免得再被选一次,不用再扫一遍。
第二阶段用 radix top-k 选出重集合:按分数的二进制位从高到低逐段统计落在每个桶里的 token 数,几轮就能定出第 k 大的分数门槛,不用把百万个分数整体排序。返回的下标不排序,因为上面的估计量和顺序无关。
第三阶段在残余里抽样。直接在百万个 token 上建分布、抽样太慢,所以作者分层抽:先把整段上下文按顺序切成每 1024 个 token 一大段(论文叫 chunk),每段再切成 32 个 token 一小块。每次抽样先选一大段,再在段里选一小块,最后在这不到 32 个 token 里选一个;一大段被选中的概率等于它里面所有 token 的 之和;选定大段之后,小块按它在这一段里所占的 份额来选,token 再按它在小块里所占的份额来选。三级概率相乘,每个 token 最终被抽中的概率正好是 ,和直接在全部残余 token 上抽一样。同一个 query 的多次抽样可能抽到同一个 token,所以每个 query 配一个哈希表去重,每个去重后的样本按 重新加权。 最小截断到 ,防止个别权重大到失控,代价是带进一点偏差。随机数用基于计数器的 RNG,这样能兼容 CUDA graph。
第四阶段从分页 KV cache 里取出选中的 K、V,用 online softmax 算注意力,K、V 只读一遍,不用先存下全部分数。为了多用并行度,每个 query head 拆给多个 thread block,最后用 log-sum-exp 合并。拆多少份有讲究:1M 上下文、batch 1 时,拆 64 份比 32 份快 1.58–1.71 倍,但拆到 128、256 份反而变慢,因为启动和合并的开销超过了并行带来的收益。
4. 实验:激进稀疏时优势最大,代理分数质量仍是瓶颈
对照组有三个:PQCache、vAttention(用 PQ 分数),以及 Oracle-top-k。Oracle-top-k 先算精确分数再挑 top-k,本身没法加速,只当作“确定性检索最多能做到多好”的参考。所有方法都留 128 个 sink token 和 128 个局部 token。模型有 Llama-3.1-8B、Qwen3.5-4B/9B、Ministral-3-3B/8B,LongBench 上另加 Qwen3.5-27B。
先看 RULER-HARD,50 倍稀疏。PQCache、vAttention(PQ)和 SSA 用的是同一份 PQ 分数和同样的预算,区别只在预算怎么分,所以下表的差距可以直接归到分配方式上。
| 模型 | 长度 | 稠密 | PQCache | vAttn(PQ) | Oracle-top-k | SSA |
|---|---|---|---|---|---|---|
| Llama-3.1-8B | 32K | 88.76 | 72.51 | 66.71 | 78.80 | 83.67 |
| Llama-3.1-8B | 128K | 71.26 | 39.73 | 39.45 | 56.10 | 47.53 |
| Ministral-3-3B | 32K | 86.69 | 70.81 | 69.26 | 72.81 | 82.05 |
| Ministral-3-8B | 32K | 89.33 | 81.83 | 78.69 | 86.61 | 84.17 |
| Ministral-3-8B | 128K | 81.45 | 62.99 | 63.78 | 75.83 | 69.25 |
SSA 在每一行都超过 PQCache 和 vAttention(PQ)。在 Ministral-3-8B 上,它在 32K 和 128K 分别保住了稠密注意力 94% 和 85% 的分数。但也要看到,128K 的两行和 Ministral-3-8B 的 32K 那行,Oracle-top-k 仍然比 SSA 高,说明代理分数本身不够准,这是 SSA 绕不开的上限。Qwen3.5 系列上所有稀疏方法都和稠密相差不到 2 分,SSA 没什么可赢的。
AIME 2025 要生成 32K token 的长推理,这里稀疏度越高,SSA 的优势越明显。Qwen3.5-9B 稠密得 66.3;50 倍稀疏时,SSA 得 59.8,而 Oracle-top-k 只有 48.3,PQCache 36.7。到 100 倍稀疏,SSA 还有 51.5,vAttention(PQ)已经掉到 3.5。反过来,只有 5 倍稀疏时 vAttention(PQ)更好,65.4 对 61.0,所以 SSA 的收益集中在激进稀疏的区间。
重集合比例 是预算里分给确定性 top-k 的份额,剩下的给抽样。同样在 AIME 2025 上、10 倍和 20 倍稀疏下做的消融说明两部分都不能少: 在 0.2 到 0.8 之间,得分都在 61.0–64.0;全部预算拿去抽样()只有 40.2–42.5,全部给 top-k()是 49.4–53.8。
LOFT 和 LongBench 上看不出差别。LOFT 上 SSA 的注意力误差在所有设置下都是非 oracle 方法里最低的,但任务指标 subspan-EM(标准答案作为子串出现在模型输出里就算对,满分为 1)在各方法之间最多差 0.04;LongBench(Qwen3.5-27B)上所有稀疏方法都在稠密 1 分以内。也就是说,误差变小不一定变成任务分数的提升,要看任务本身对稀疏有多敏感。
速度在单张 H200 上测(16 个 query head、4 个 KV head、head 维度 256、fp16 KV)。上下文短时 SSA 反而慢,因为前三个阶段的固定开销摊不开:batch 1、128K 时,它只有 FlashInfer 速度的 0.60–0.74 倍。上下文越长越划算,到 1M 时,50 倍稀疏快 1.79 倍,20 倍快 1.39 倍,10 倍只快 1.07 倍。batch 变大收益更高,1M、batch 16、50 倍稀疏时到 2.96 倍。
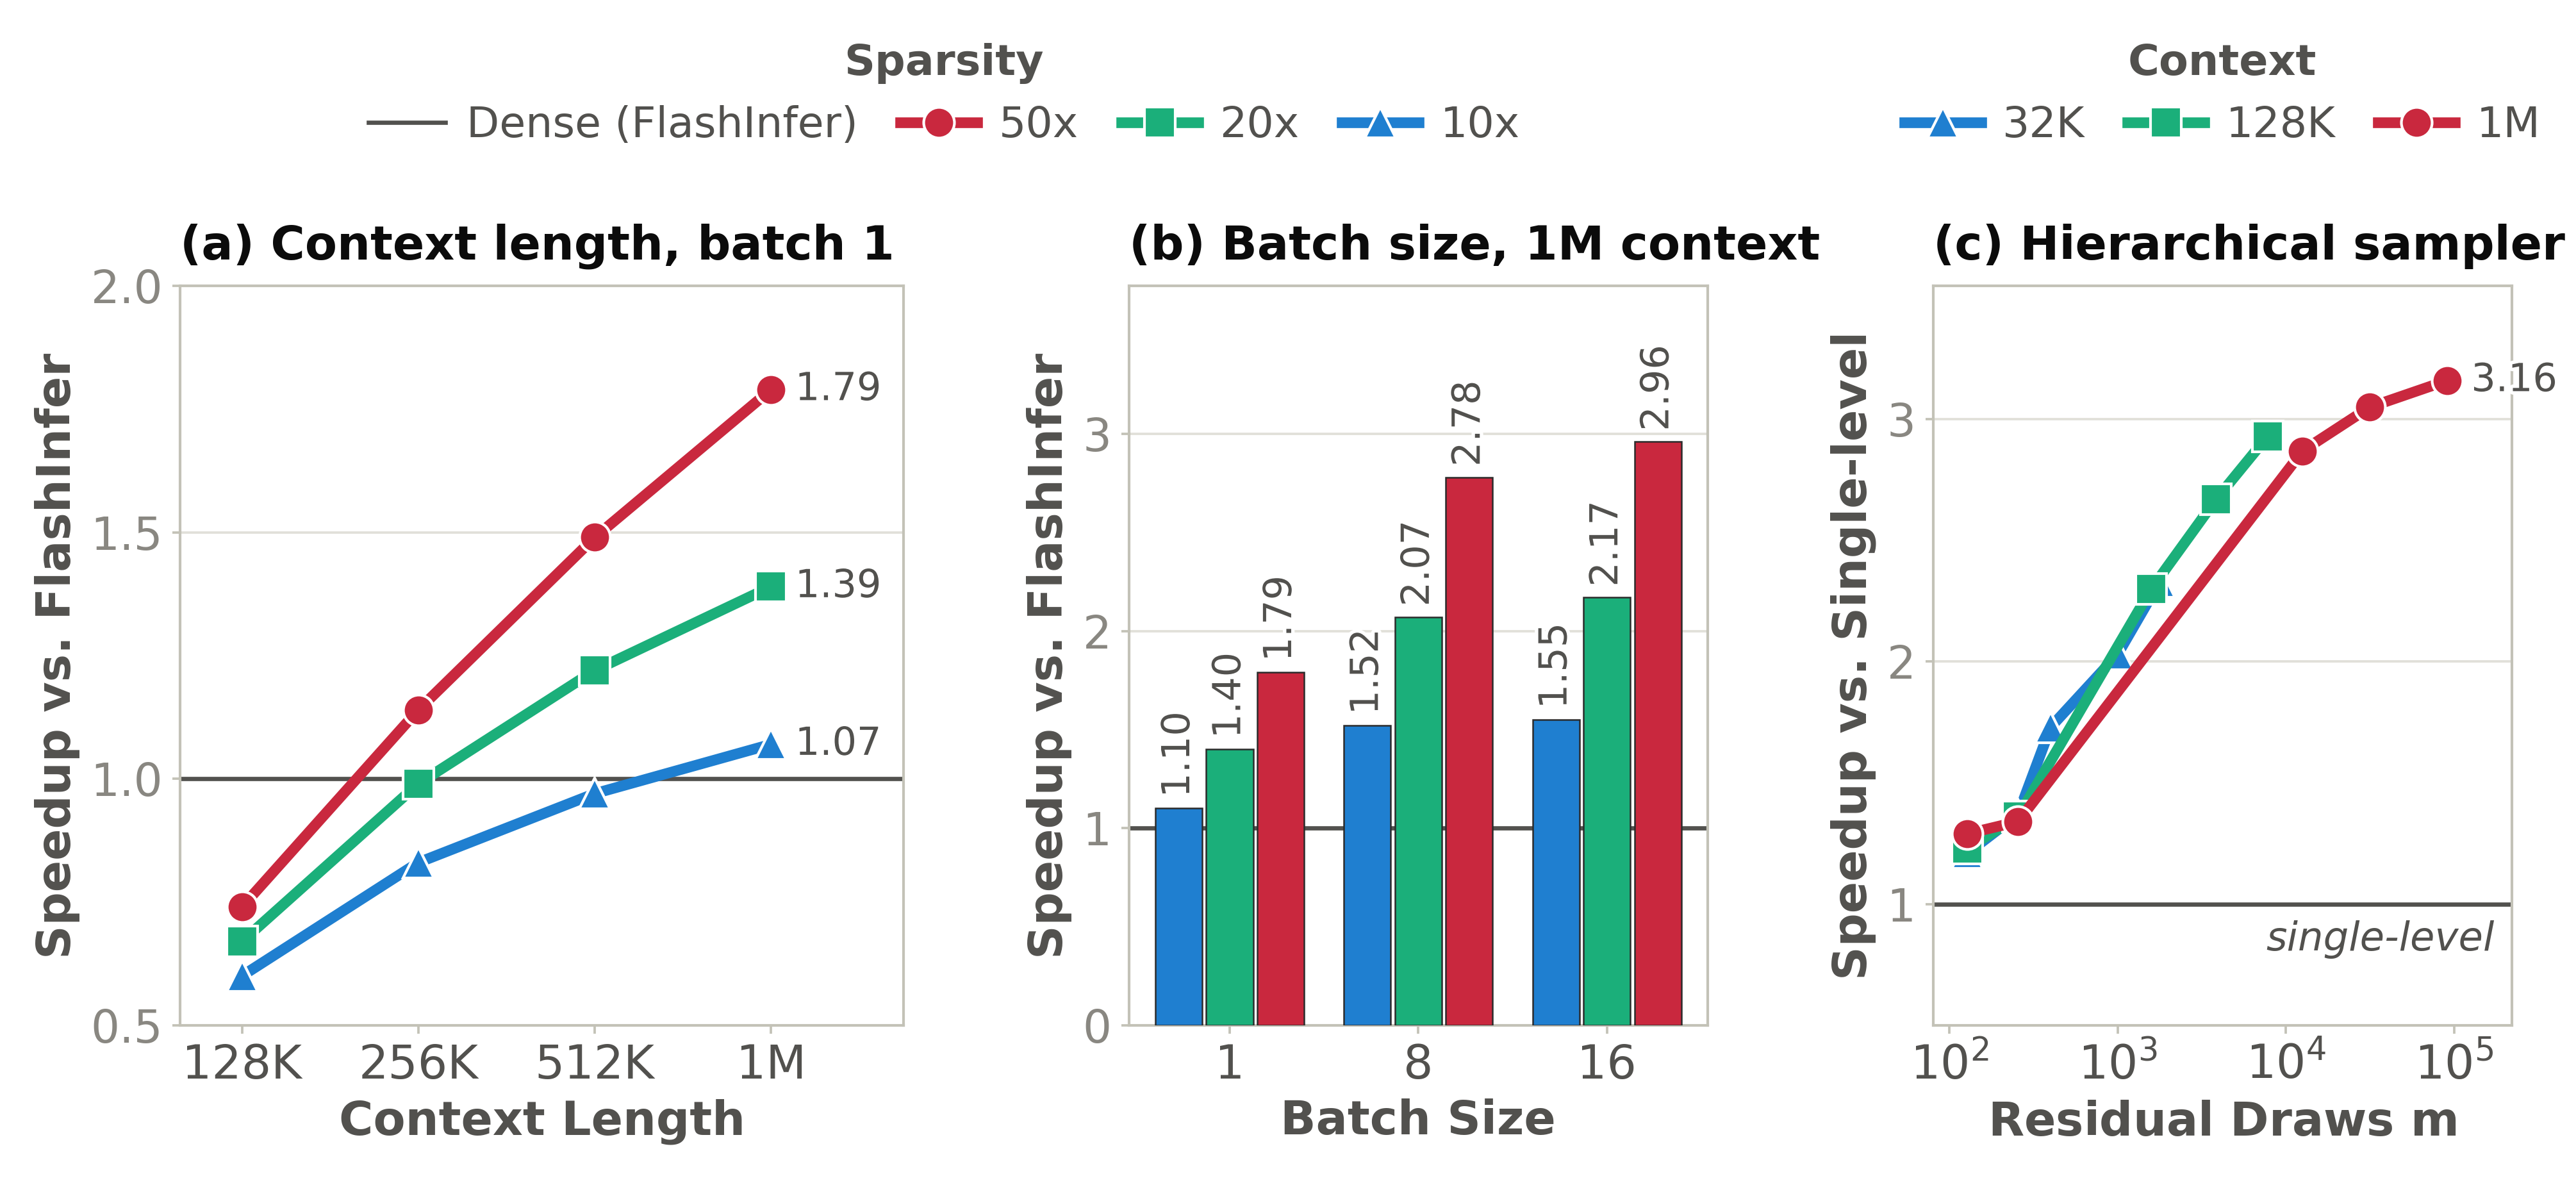
kernel 优化是 batch 1 也能比稠密快的原因。不做第 3 节那些优化的参考实现,同样的算法只有 FlashInfer 的 0.37–0.47 倍,到 batch 8 才追上;优化后快了 2.95–3.80 倍。抽样这一步的对照是只分一级:选定 1024 token 的大段之后,直接在这 1024 个 token 上抽,不经过 32 token 小块这一级。加上小块这一级后,抽样快了 1.21–3.16 倍(抽的次数越多,差距越大),1M 上下文、 时抽样本身只花 0.30–1.18 ms。
5. 局限与实践意义
局限有几条。实际 kernel 用的是固定比例 ,自适应分配还没有同样高效的实现。 截断会带来少量偏差。抽样有随机性,同一个请求解码两次,注意力输出不完全一样,需要可复现时要固定随机种子。128K 以下、batch 1 时 SSA 比 FlashInfer 慢。在 Qwen3.5、LongBench 这种稀疏本来就不怎么掉点的设置下,SSA 也没有明显优势。作者提到下一步想让用户自己设定可接受的近似误差,系统保证输出不超过这个误差,但论文没有给出具体做法。
对工业界,SSA 适合的场景很明确:百万级上下文、batch 较大,而且要压到 20–50 倍以上稀疏的解码服务,比如长时程智能体的会话历史、超长文档问答、长推理链生成。如果系统里已经有 PQCache、Quest 这类 top-k 检索,接 SSA 的改动不大:检索索引原样复用,只是把一部分预算从 top-k 挪给按代理分数的抽样,再加上 修正。上线前先在自己的任务上扫一遍 ,论文里 0.2–0.8 都不错,纯 top-k 和纯抽样都明显更差。如果你只需要 5–10 倍稀疏,现有的 top-k 或 vAttention 大概已经够用,SSA 的收益主要在更激进的区间。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…