
推荐精排要同时预测点击、点赞、评论、深聊等多个目标,常见做法是先把用户行为序列和其他特征压成一份共用的表示,最后才交给每个任务各自的预测塔。问题是不同任务需要从历史里读的东西不一样,共用表示一旦在前面把某个任务需要的信号丢掉,后面的任务塔再怎么拆也找不回来。陌陌这篇论文提出 MORE(Multi-task cO-evolving Ranking modEl):在整个模型里放进几个随层更新的小向量,一部分所有任务共用,一部分每个任务各有一个,让每个任务从第一层起就按自己的需要读历史、混特征,并用掩码保证各任务的私有向量互不串扰。在七个任务上它都超过同类统一骨干,两周线上实验时长提升 3.0%,而单个样本的计算量比参考模型还低。
做多任务排序的团队值得读,因为它给出一个具体问题的答案:多任务的信息应该在哪一步分开。证据来自一个社交推荐场景的工业数据,消融把每个部件的贡献拆得比较清楚。但没有公开数据集上的结果,部分训练细节也没给全。
它到底在解决什么问题?
同一个用户的历史行为里,点击可能更看近期曝光和封面吸引力,评论更看主题兴趣,深聊(至少五轮对话)还涉及社交匹配。现在流行的统一骨干,比如 HyFormer、MixFormer、OneTrans,把序列建模和特征交叉放进同一个可堆叠的模块里,但每一层都不知道下游有哪些任务。
论文给了一个直接的证据:把参考模型的序列编码器换成 HSTU,点击 GAUC 相对提升 0.09%,其他六个任务却都下降。只把某个模块做强,不能保证所有任务一起受益。
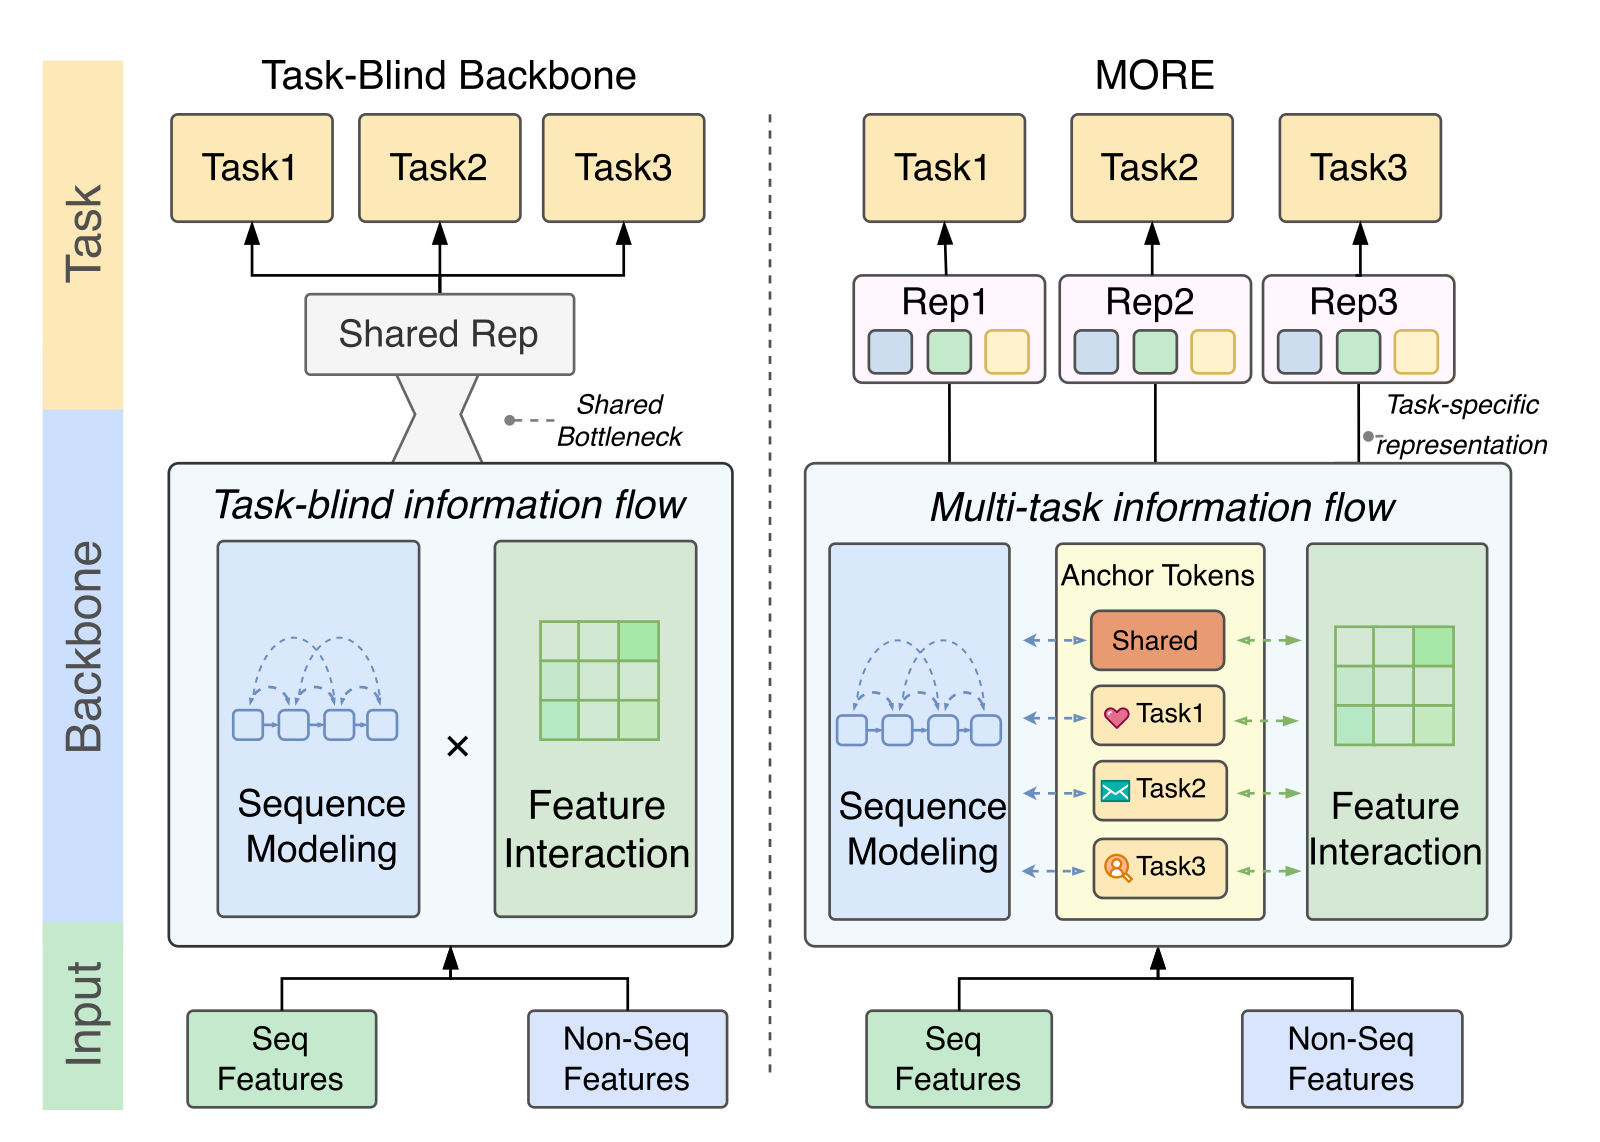
方法:让任务信息贯穿每一层
MORE 的输入有两类 token:一类是用户行为序列,每个行为由物品、位置和动作组合编码而成(点击、点赞、评论是否发生拼成一个组合编号,所以同一物品上的不同反馈不会混成一样);另一类是非序列特征,包括用户画像、候选物品属性和请求上下文,共 15 个 token。
在这两类输入之外,MORE 另造了 17 个小向量,论文叫锚点(Anchor Token)。它们的作用像每个任务随身带的笔记本:一层层往下传,每层都往里写新读到的信息,最后交给预测塔。其中 8 个所有任务共用,叫共享锚点;9 个每个任务各一个,叫私有锚点。锚点的初始值来自行为序列的平均和全部非序列特征,拼起来过一个 MLP 得到;私有锚点再各加一个可学习的任务向量,让不同任务从一开始就不同。
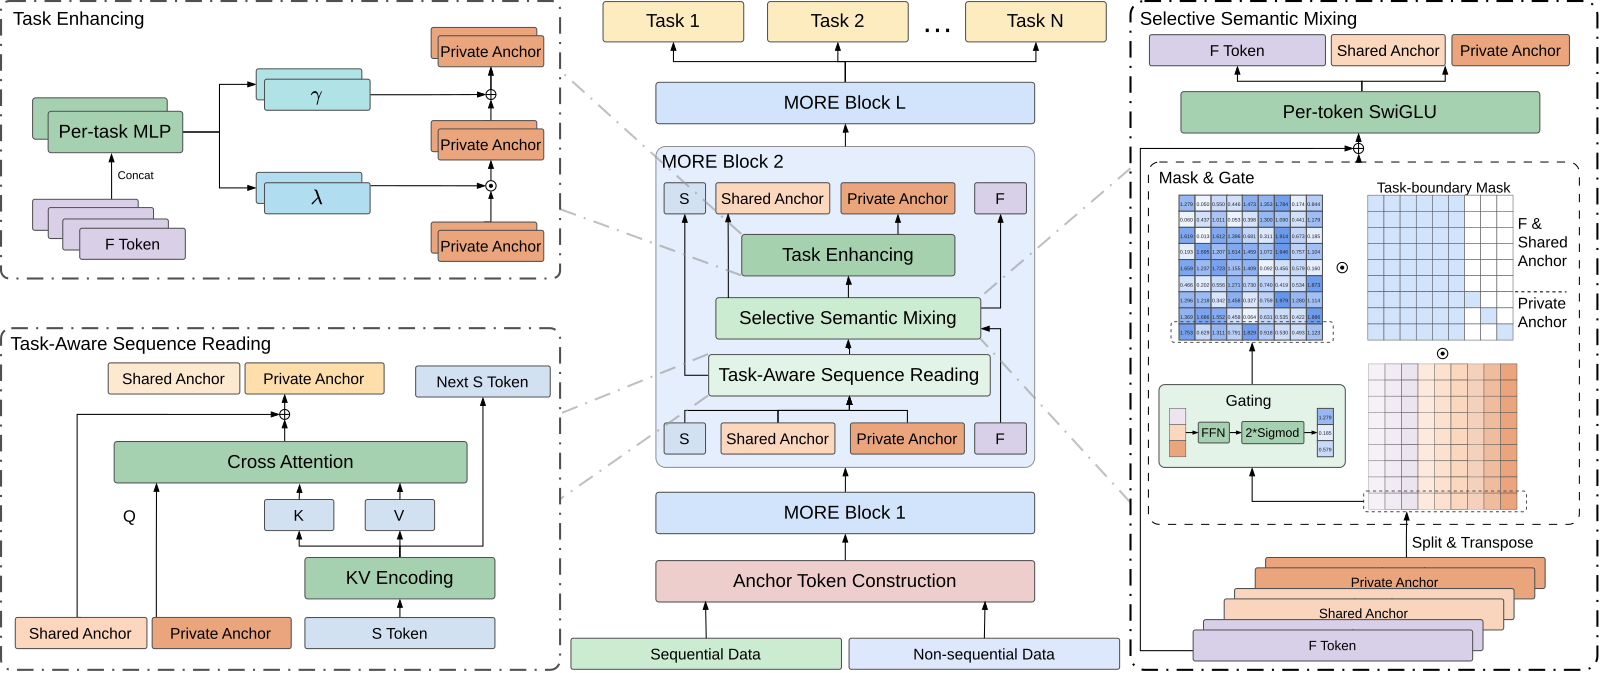
每个 MORE 模块按顺序做三步:
| 步骤 | 做什么 | 防止什么问题 |
|---|---|---|
| 读序列 | 锚点用交叉注意力读行为序列;共享锚点读通用信息,私有锚点读和自己任务有关的部分 | 所有任务读到同一份历史摘要 |
| 混合特征 | 锚点和非序列特征一起做 token 混合,掩码挡住私有锚点之间的信息交换 | 一个任务的信号冲淡另一个任务 |
| 任务增强 | 每个任务一个独立 MLP,从非序列特征算出一组缩放和平移系数,作用到自己的私有锚点上,再加残差 | 私有锚点容量不够 |
读序列这一步还有一个跨层的序列记忆:一个初始为 0 的向量,每层结束时把这一层序列表示的平均过一个 MLP 后加进去,再做层归一化。每个锚点读完序列后,通过自己的一个门控小网络(SwiGLU)从这个记忆向量里取一部分加到自己身上,所以同一份记忆,不同锚点取用的方式不同。
混合特征这一步借鉴 RankMixer。设 token 总数为 H(15 个特征加 17 个锚点),把每个 token 的向量切成 H 小段。混合后第 i 个位置的新向量,由所有 token 的第 i 小段拼成,每一小段先乘一个权重,权重由一个小网络根据这些小段算出。掩码决定哪些权重强制为 0:非序列特征和共享锚点对所有位置可见,每个私有锚点只对它自己可见。这样共享信息可以流到所有地方,私有锚点之间却始终看不到彼此。之后再过两层逐个 token 的前馈网络。
堆完所有模块后,每个任务的预测塔拿到自己的私有锚点、共享锚点和非序列特征,用二元交叉熵按任务加权训练。默认 2 个模块,隐藏宽度 256。
工程上还有一点:行为序列只和用户有关,不依赖候选。所以同一请求下的所有候选可以共用一次序列计算,候选之间的差别只体现在非序列特征和锚点上。论文说按这种方式组织训练和服务,线上评分的 P99 延迟比逐个候选计算降低约 30%。
实验结果
数据来自 90 天线上日志,在随后一天上评估。下表摘自论文表 1 的部分列,参考模型一行是 GAUC 绝对值,其余是相对它的变化:
| 模型 | 点击 GAUC | 评论 GAUC | 深聊 GAUC | 稠密参数 | 单样本前向计算量 |
|---|---|---|---|---|---|
| Transformer+RankMixer(参考) | 0.7863 | 0.6979 | 0.8444 | 77.85M | 1.92G |
| MixFormer | +0.29% | +0.89% | +0.15% | 98.68M | 4.65G |
| HyFormer | +0.43% | +1.09% | +0.08% | 153M | 2.16G |
| OneTrans | +0.38% | +0.80% | +0.11% | 108.65M | 1.73G |
| MORE | +0.44% | +1.26% | +0.33% | 132M | 1.85G |
点击上 MORE 只比 HyFormer 多一点点,差距主要在评论、深聊这类互动更深的任务上,因为这些任务更需要按自己的方式读历史。参数比 OneTrans 多,计算量比 OneTrans 高 0.12G,但比参考模型和 HyFormer、MixFormer 都低。
消融表里,“交互”一栏是点赞、评论、打招呼三项 GAUC 的平均,“平均”是点击、交互、深聊三栏的算术平均:
- 去掉掩码,平均下降 0.21%,交互下降 0.34%,是单项里损失最大的。
- 去掉私有锚点各自读序列,平均下降 0.15%;去掉任务增强下降 0.14%。
- 去掉跨层序列记忆,平均只降 0.05%,但深聊降 0.13%,平均值会掩盖单个任务上的差别。
- 全部去掉、退回不区分任务的骨干,平均下降 0.33%。各项损失不能简单相加,因为部件之间有依赖。
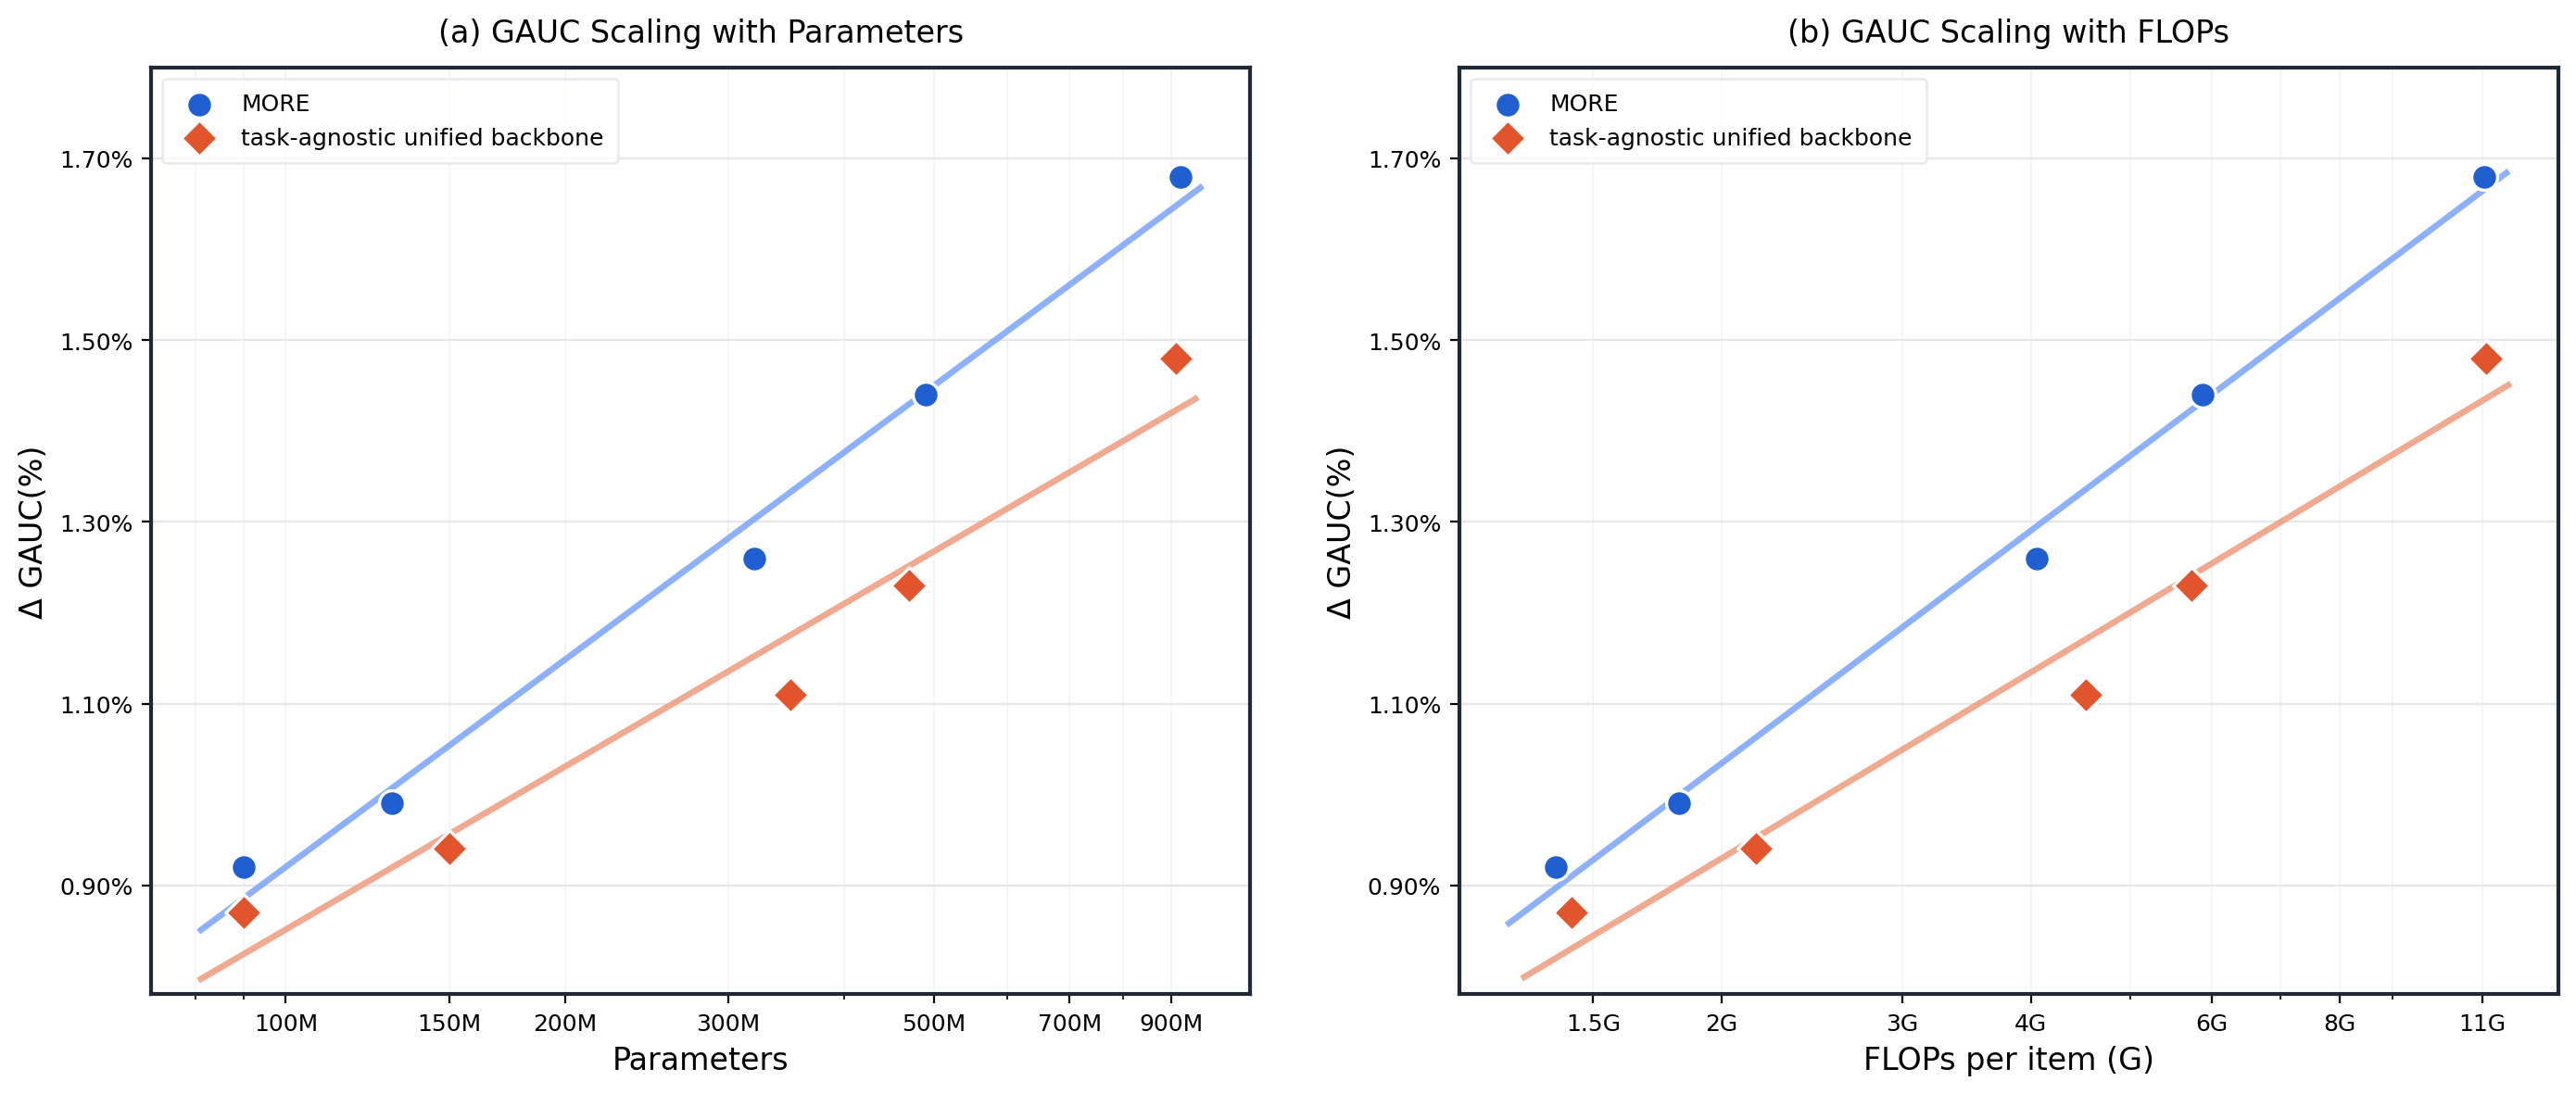
在约 1 亿到 9 亿参数的范围里,MORE 在相近参数和计算量下的平均 GAUC 都高于不区分任务的统一骨干。
两周线上实验,对照是生产环境里的排序模型:时长 +3.0%,点击 +2.8%,点赞 +2.0%,评论 +3.6%,打招呼 +2.5%,深聊 +2.0%,论文称都在 p<0.05 下显著。评论涨得最多,和离线表里评论提升最大一致,说明离线优势确实转化到了线上。
局限
- 只有一个社交推荐场景的工业数据,没有公开数据集上的复现。
- 论文前后写的任务数不一致:联合优化 13 个任务,默认结构有 9 个私有锚点,主表展示 7 个任务,三个数字分别对应哪些任务需要读者自己去核对。
- 学习率、训练步数、GPU 型号等没有给全,难以估算训练成本。
- 掩码只挡住私有锚点之间的直接信息交换,它们仍共用底层的序列表示,不能说任务冲突被完全消除。新增任务时私有锚点怎么初始化、样本很少的任务会不会过拟合,论文没有实验。
怎么借鉴
最值得先复现的是掩码这一项:保持其他结构不变,比较“只在最后接多任务塔”“锚点全共享”“锚点带掩码”三种设置,看稀疏的互动目标有没有被点击目标挤压。请求内共用序列计算是独立的工程收益,可以单独测;30% 的延迟下降是论文自己的服务实现,换一套系统要重新测。如果只有一个点击目标,或者深层互动的标签很少,这套多任务骨干的额外复杂度未必划算。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…