目录 · 9 节
1它到底在解决什么问题?2整体流程3设计一:表格要先还原成忠实的网格4设计二:打分时补全上下文,打印时合并上下文5设计三:保留前 k-1 项,只替换最后一项6主要结果7我认为它的局限8一个推荐或搜索团队可以怎么试9一句话结论
问维基百科《欢乐糖果屋》的制片人是谁,答案就在页面信息框的制片一行,可文本抽取把这一格里的两个名字弄丢了,读者模型只看到导演,于是答错。这篇论文在整个英文维基百科上把答案证据从网页源码一路追到读者输入,发现这种丢失很普遍:7.6% 的问题证据根本没完整进索引,其中 81% 是表格单元格、表头或图注。Tessera 检索照旧,只在读之前把排名靠前的网页重新拆成一行表格、一个列表项这样的小单元,补上标题、章节和表头,再挑相关的装进同样的 token 预算。文本和截图两类流水线的答对率都提高 5 到 6 个点,3K token 的 Tessera 上下文能到 76.1%,比 12K token 的原始分块还高。
做网页 RAG 或搜索问答的团队值得读这篇,因为它把“找对了页面、却把错的那一段交给模型”这个问题量化得很清楚,而且给出的解法不用重建索引、不用训练、不换检索器和读者模型,只在检索结果和读者之间加一层。它在同样预算下胜过 14 种常见改法,在多步搜索 agent 里也让多跳问答基准 FRAMES(需要多篇维基文章才能回答的问题集)答对率从 59.2% 升到 64.4%。需要留意的是,实验全部在维基百科上做,那里的表格和信息框结构规整;关键词预筛选还会漏掉一部分证据单元。
它到底在解决什么问题?
标准的网页 RAG 先用抽取器把网页压成纯文本,再切成固定长度的块,检索、重排后把前几块交给读者模型。截图路线则把渲染后的网页切成图块。两条路线有一个共同点:同一个块既是建索引的单位,也是排序的单位,还是读者阅读的单位。
论文在 7,378 个问题上把答案证据从源码追到读者输入,丢失主要发生在两处。
| 丢失位置 | 占比 | 后果 |
|---|---|---|
| 证据完整存在某个块里,但没进前三 | 9.7% 的问题 | 把这一块放进第三个位置,这批问题的答对率从 49.1% 升到 78.5% |
| 证据从来没完整进入索引 | 7.6% 的问题 | 其中 81% 是表格单元格、表头或图注,任何检索器都找不回来 |
| 表格单元格进了块,却和表头分开了 | 31% 的此类单元格 | 数字失去了含义 |
用开头的例子看(示意)。
| 读者拿到的内容 | 回答 |
|---|---|
| 抽取后的信息框:导演 Mel Stuart,编剧 Roald Dahl,制片这一格为空 | “Mel Stuart”,错 |
| Tessera 单元:页面标题 › 海报,导演:Mel Stuart;制片:Stan Margulies;David L. Wolper | 两个制片人,对 |
原因是抽取器丢掉了信息框里“列表形式”的单元格。块的大小是为检索调的,1,024 token 的块检索效果好,可答案往往只占一句话或一行表格,预算里只放得下三块,装证据的那块常常排在外面。前十个重排块覆盖到正确页面的比例有 92.7%,真正把证据交到读者手里的只有 59.5%:页面找对了,交出去的却是错的部分。
常见补救都不够:更好的抽取、扩展相邻块、给块加结构前缀、把读者预算扩大四倍、换成截图,每一种最多只加 2.2 分,而前面那个把正确块放进第三位的实验说明这里有 29.4 分可拿。
整体流程
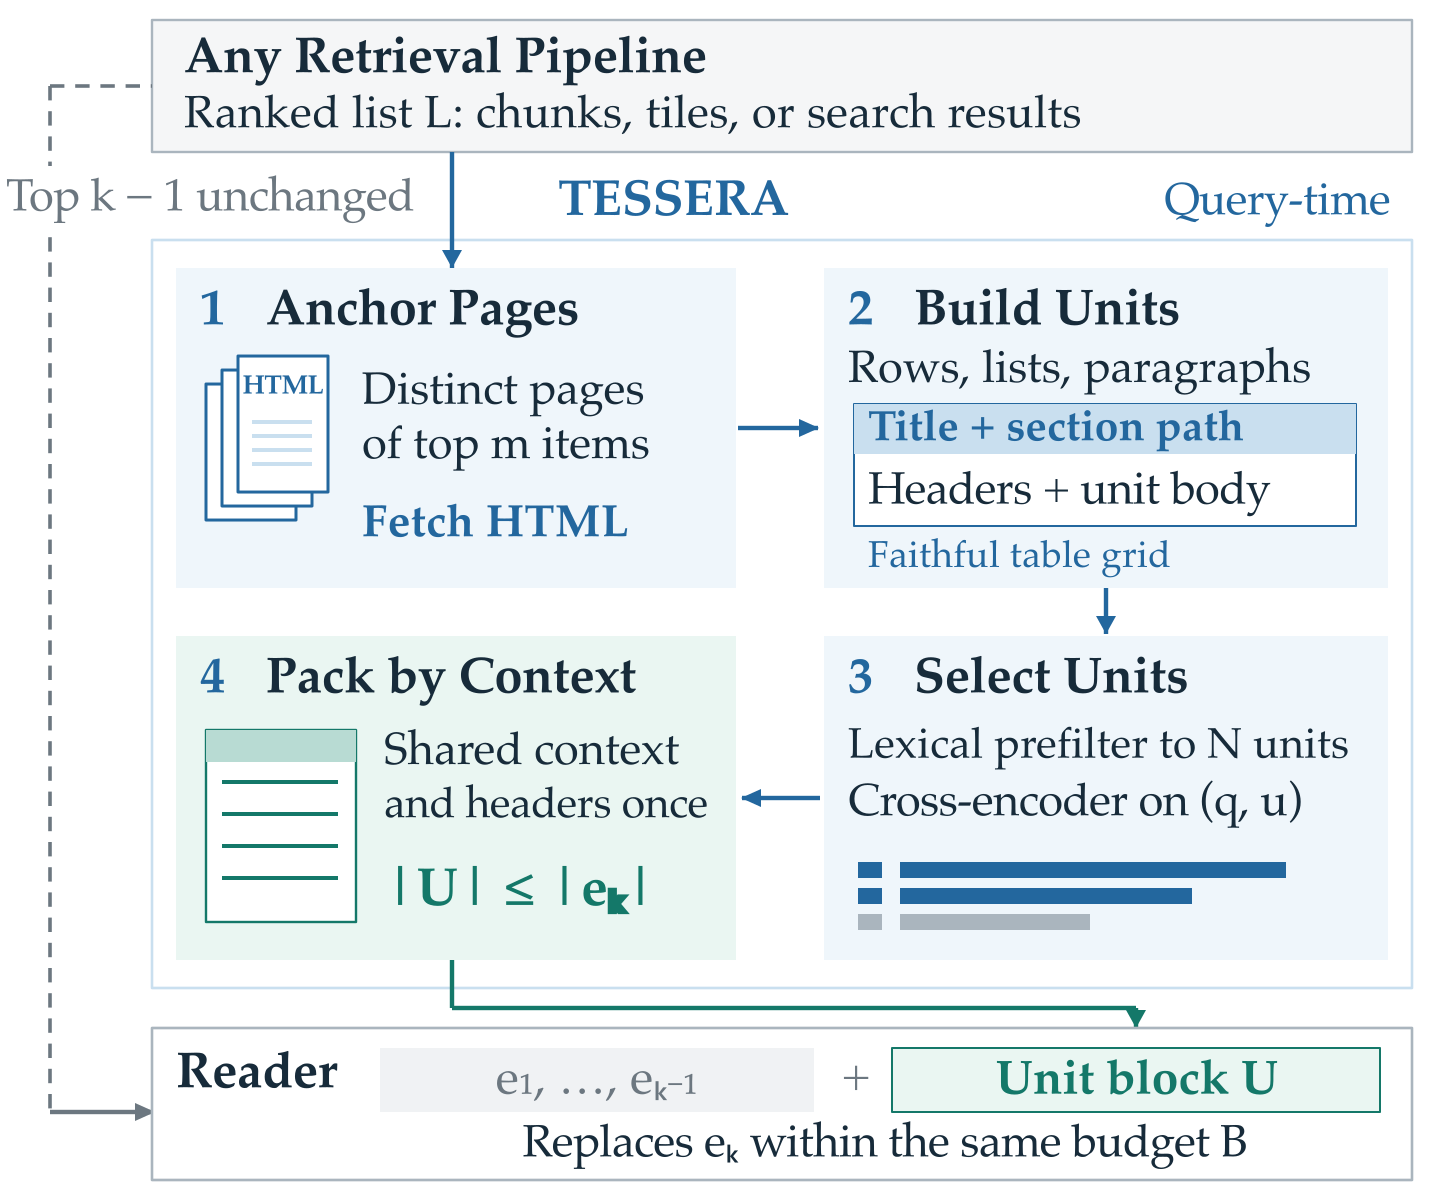
这张图看左边那条虚线:前 k-1 项完全不动,Tessera 只替换最后一项,所以读者的总预算不变。下文的“合并答对率”指把三个问题集的题目放在一起逐题统计的答对率,不是三个数据集答对率的平均。
| 步骤 | 做什么 | 默认设置 |
|---|---|---|
| 锚定页面 | 取排序列表前 m 项,去重得到它们所在的网页,从建索引用的那份抓取快照里拿回 HTML | m=10 |
| 构建单元 | 遍历网页的标签结构,每个段落、列表项、图注是一个单元,每行表格或信息框是一个单元,都补上页面标题、章节路径和表头 | 每页约 150 个单元 |
| 选择单元 | 所有锚定页面的单元合在一起(约一千个),先按与问题共享的实词数留下 100 个,再用流水线自己的重排模型 BGE-reranker-v2-m3 打分 | N=100 |
| 打包 | 按分数从高到低装入第 k 项的 token 预算,同一上下文的行只打印一次标题和表头 | 预算用读者自己的分词器计算 |
形式上,原来的读者上下文是 ,Tessera 构造 ,并保证 。
设计一:表格要先还原成忠实的网格
为什么需要:网页表格常有合并单元格、多行表头、标题行和分组行,按网页源码里单元格出现的先后顺序把一行里的单元格和第一行表头一一对应,很容易配错。论文统计,在实验用到的 290 万行表格里,这种简单配法有 32.5% 的行配错表头或丢掉一格。
怎么做:先按 rowspan 和 colspan 把每个合并单元格复制到它覆盖的所有格子里;占满整行的开头几行当作表标题;紧接着的表头行组成列名,多行表头从上往下拼接;表体中间占满整行的分组行,给下面的行当上下文;没有列头、每行以表头格开头的表格(比如信息框)把第一格当键;单元格里的换行和列表项保留为分隔符,所以多值单元格不会丢。
小例子(论文的示意表):州长表的表头是“姓名 | 任期(上任、卸任)| 党派”,党派一格跨两行合并。
| 做法 | B. Okafor 这一行变成 |
|---|---|
| 按源码顺序配第一行表头 | 姓名:B. Okafor;任期:2004;党派:2010 |
| 忠实网格 | 州 › 历史 › 州长:姓名:B. Okafor;任期 › 上任:2004;任期 › 卸任:2010;党派:Liberal |
这说明不还原网格,读者会把卸任年份当成党派,而且合并到上一行的党派信息直接丢失。
设计二:打分时补全上下文,打印时合并上下文
为什么需要:单独一行“Harbhajan Singh | not out | 6 | 3 | 0 | 1 | 200.00”看不出是哪场比赛、哪一列是击球率。重排模型必须看到完整上下文才能判断这行和问题是否相关;可如果每一行都重复一遍标题和表头,预算很快就被吃掉。
怎么做:打分用补全后的文本,即“页面标题 › 章节 › 小节”加上每个值对应的列名。打包时按上下文分组,每组只印一次上下文路径和列头,下面跟着选中的行,按原页面顺序排列。计算成本时,一组的第一个单元要算上上下文行和表头行,后面的只算行本身。 Hoot 说

每行重复上下文
- 第一行
- 上下文 + 表头 + 行 = 40 + 20
- 第二行
- 上下文 + 表头 + 行 = 40 + 20
- 合计
- 120 个 token
读者把同样的标题和列名读了两遍。
Tessera:按组打印
- 第一行
- 上下文 + 表头 + 行 = 40 + 20
- 第二行
- 只算行本身 = 20
- 合计
- 80 个 token
省下的预算能多装几行,所以一个位置能放约 14 行而不是约 11 个单元。
示意:上下文行加表头行算 40 个 token,每个数据行 20 个 token,同一组选中两行。 出处: 打包规则见正文“怎么做”一段;token 数为示意值
小例子(来自 SimpleQA):问题是“2015 年 IPL(印度板球超级联赛)决赛里 Harbhajan Singh 的击球率是多少”。原来前三块里有钦奈队的击球行却没有表头,孟买队的击球行在第四块以后,读者回答“他没有击球”。Tessera 把“2015 IPL 决赛 › 计分表 › 孟买队击球”这一组放进第三个位置,列头印一次,下面是三名击球手的行,读者答出 200.00。
| 单元形式 | 合并答对率变化 |
|---|---|
| 不补全上下文的裸单元 | +1.8 |
| 补全上下文的单元 | +4.6 |
这说明增益主要来自补全上下文,而不是单元变小本身。分组打印让一个位置能装下约 14 行,若每行都重复上下文只能装约 11 个单元。
设计三:保留前 k-1 项,只替换最后一项
为什么需要:排在最前面的块带着连贯的正文,这是表格行和列表项替代不了的;而且检索器的排序信号也在这些块里。
怎么做:读者上下文只把第 k 项换成单元块。对截图流水线,按图像处理器给那个图块的 token 数打包,单元块可以作为文本输入,也可以渲染成图片。对搜索 agent,每次搜索调用都单独套一层,工具返回前 k-1 项加一个单元块,agent 的提示词和停止规则不变。
| 读者上下文 | 结果 |
|---|---|
| 只用单元 | 每个预算下都比混合方案低 0.6 到 1.9 分 |
| 块和单元混合 | 与只用块相比,在 51 组对比里全部胜出,领先 1.8 到 6.7 分 |
这说明单元是补充,不是替代。成本方面,构建一个页面的单元在一个 CPU 核上要 15 毫秒,打分每个问题在 A100 上约 0.2 GPU 秒,不需要新索引、不需要离线处理整个语料。
主要结果
评测用 2025 年 8 月的英文维基百科快照,共 706 万篇文章,问题来自 NQ(Natural Questions,谷歌搜索真实问题)、NQ-Tables 和 SimpleQA,共 7,851 题;默认读者模型是 Qwen3.5-4B,读者拿前三项。
| 流水线 | 合并答对率变化 |
|---|---|
| 自建混合文本检索 + BGE 重排 | +5.0 |
| PixelRAG 文本索引 + BGE 重排 | +6.2 |
| PixelRAG 截图索引 + Qwen3-VL 重排 | +5.6 |
| 换成 Gemma 4 31B 读者,文本 | +4.7 |
| 换成 Gemma 4 31B 读者,截图 | +5.9 |
这说明增益不依赖于索引形态和读者大小。截图本来就保留了表格的渲染样子,换掉第三张图块仍然加 5.6 分,说明瓶颈在于交付单位而不在模态。SimpleQA 上增益最大,有 6.9 到 8.2 分,因为长尾事实常常藏在信息框和表格里。
同样预算下与 14 种改法的对比(混合文本流水线,3K 证据 token):
| 方法 | 合并答对率 | 变化 |
|---|---|---|
| 前三块 | 70.70 | — |
| Query2doc(检索侧最好的一种) | 71.60 | +0.89 |
| RAPTOR | 71.91 | +1.21 |
| HtmlRAG | 70.30 | -0.41 |
| Docling 作为单元构建器 | 74.97 | +4.27 |
| Tessera | 75.74 | +5.03 |
| Query2doc + Tessera | 76.65 | +5.95 |
这说明改检索侧只是给块重新排序,读者读的仍然是 1,024 token 的窗口,增益不超过 1 分左右;Docling 也按行带表头序列化,所以也很有效,但 Tessera 再高 0.8 分,解析速度比 Docling 快 500 倍以上。
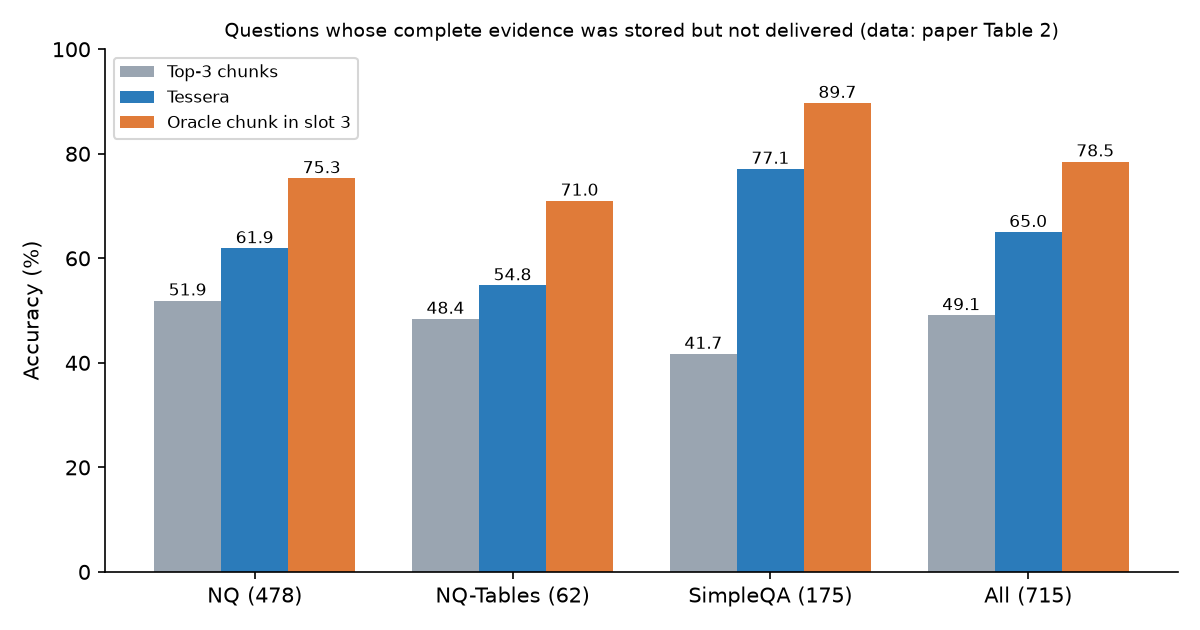
图里看蓝柱和橙柱之间的距离:合并来看,Tessera 从 49.1% 升到 65.0%,补回了理想增益的 54%;SimpleQA 上已经很接近理想值。
在多步搜索 agent 里(Qwen3.5-4B 开启思考,最多搜 8 次),每次搜索只把最后一篇结果换成单元块。
| 每次搜索返回 | FRAMES | MuSiQue | 平均搜索次数 | 最终上下文 |
|---|---|---|---|---|
| 前三块 | 59.22 | 32.40 | 2.41 | 12.8K |
| 前四块 | 59.22 | 32.30 | 2.18 | 14.5K |
| 前两块 + Docling | 57.65 | 32.10 | 2.65 | 13.6K |
| 前两块 + Tessera | 64.44 | 33.50 | 2.19 | 11.7K |
这说明结构完整的证据让 agent 搜得更少、上下文更短、答得更准;FRAMES 上的表格推理题涨了 9.3 分。MuSiQue 的问题大多来自段落正文,前两块已经覆盖,只涨 1.1 分。
我认为它的局限
第一,实验只覆盖维基百科。维基的表格和信息框标记规范,290 万行表格里简单配法错 32.5% 已经是在规整网页上的数字;电商详情页、论坛、PDF 转出的 HTML 结构更乱,忠实网格的规则需要重新验证。
第二,关键词预筛选会漏证据。在那 715 个理想块问题上 Tessera 仍比理想情况低 13.4 分,相当于有 96 道题理想情况答对而 Tessera 答错。这 96 道题里有 20 道的证据就在锚定页面内,却被按实词重合的预筛选挡掉;把预筛选数量调大只影响 0.3 分以内,说明问题出在按字面匹配本身,需要换成语义匹配。
第三,锚定页面依赖检索器。上面那 96 道题里有 61 道的证据页面不在前十个锚定页里;在正确页面没被锚定的问题上,Tessera 只把答对率从 39.9% 提到 43.7%,单元交付救不了检索失败。
一个推荐或搜索团队可以怎么试
- 在自己的问答流水线上抽一批问题,记录每个问题前十个检索结果所在的页面,以及这些页面的原始 HTML 或结构化源数据。
- 用一个强大模型标出支持答案的原文片段,按字符串匹配查它们停在了哪一步:抽取、分块、检索、重排还是读者输入,先确认损失主要在哪里。
- 若损失集中在表格、规格参数、属性列表上,写一个按页面构建单元的模块:段落和列表项各一单元,表格每行一单元,带上页面标题、章节路径和列名。
- 用现有的重排模型给单元打分,只替换读者上下文的最后一项,token 预算保持不变。
- 在同样的问题集上对比答对率,并按“证据只在表格里”和“证据在正文里”分组看增益。
- 有搜索 agent 的,把同样的单元块接到每次搜索工具的返回里,同时看答对率、搜索次数和最终上下文长度。
一句话结论
一层不用训练、不动索引的交付层,把检索到的网页按结构重新拆小再交给读者,在维基百科问答上稳定多出 5 到 6 分。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。网页问答里大量事实在表格和信息框中,分块流水线系统性地丢掉它们 |
| 方法创新性 | 中高。单元化和表头补全本身不新,新在把检索单位和阅读单位拆开,并用溯源实验量化损失 |
| 实验证据 | 高。三条流水线、多种检索器和读者、14 种对照方法、agent 场景和分组分析;不足是只有维基百科 |
| 工程成本 | 低。查询时解析少量页面,复用现有重排模型,每页 15 毫秒 |
| 是否值得尝试 | 值得,尤其是答案常在表格、规格或属性列表里的搜索问答系统 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…