
DeepSeek-V4.1-Flash、GLM-5 系列这类模型用的是按索引挑选的稀疏注意力:每步解码先由一个打分模块从全部历史里挑出一小部分位置,注意力只读这些位置的 KV cache。这样每步读的数据少了,但存储并没有省下来,因为这一步没被挑中的历史,下一步可能就会被挑中,所以全部历史都得留着。上下文一长、请求一多,显存能装下多少历史,就决定了能同时解码多少请求。Scitix.AI 的 UlaCache 把所有 GPU 的 KV 池和可选的 CPU 内存编进同一个“逻辑地址空间”:推理引擎只按逻辑地址分配和选取 KV,数据实际放在哪张卡、在 GPU 还是 CPU 上,由 UlaCache 负责搬运和改映射。它的核心不是“多用 CPU”,而是让每一份内存都存不同的历史,不再存副本。在 SGLang 上用 GLM-5.3 跑 64K–128K token 的长文摘要请求,开启投机解码、内存预算相同时,峰值吞吐比 HiSparse 高 1.16 到 2.51 倍。从论文自己的曲线看,这些收益几乎全部来自“能同时装下更多请求”,同样批大小下的单步速度并没有变快。
1. 问题:内存大多被重复的副本占掉
作者先统计了 GLM-5.3 在 8×B300 上的 KV 分配,发现现有两种做法都有大量重复存储,来源有两个。
第一个来源是跨卡重复。GLM-5.3 用 MLA,它把所有注意力头的 KV 压成一份共享的表示。常规的张量并行(TP)按注意力头把计算分到各卡,可这份共享表示没法按头切开,于是每张卡都存一份完整的。8 卡 TP 下,只有 12.5% 的空间存的是不重复的历史,其余 87.5% 都是副本。也就是说,8 张卡的显存只发挥了 1 张卡的存储容量。
第二个来源是 GPU 和 CPU 之间的重复。HiSparse 是目前用 CPU 扩展稀疏注意力 KV 的代表做法:完整历史放在 CPU,每步把被挑中的那部分搬到 GPU 并缓存起来。问题是 GPU 上缓存的每一条在 CPU 上也都还在。图中它一共用了 5330 万个物理槽,却只存了 3000 万个不同的历史位置。GPU 那 2330 万个槽只让访问变快,并没有让能存的历史变多。
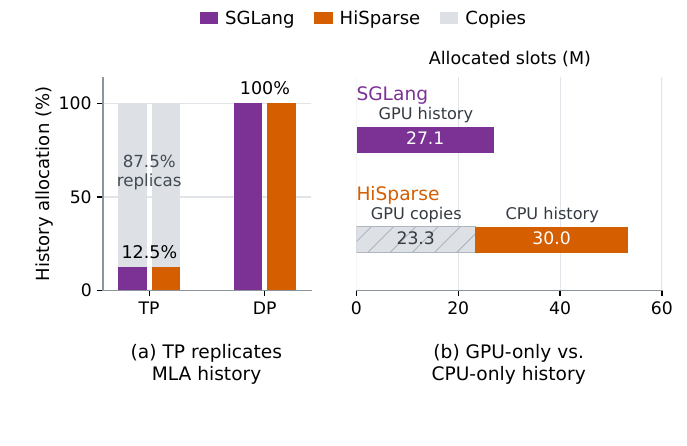
HiSparse 还有一个分配上的问题:它给每个请求一块固定大小的 GPU 缓存。请求少的时候,空出来的显存别的请求也用不上。作者举的例子是 8×B300、DP 模式(数据并行:每张卡各自跑完整的模型、各自服务一批请求,后文还会细说)、开投机解码、只有 1 个请求时,GPU 本来装得下全部历史,但单个请求的缓存配额装不下,于是仍然不断从 CPU 取数据。结果它每生成一个 token 的时间(TPOT)比纯 GPU 的 SGLang 高 23.5%。
2. 统一逻辑地址:引擎只管“第几号”,不管“放在哪”
UlaCache 的做法是给每条 KV 一个固定的逻辑地址,再用一张映射表记录它当前实际在哪个 GPU 槽或 CPU 槽。数据在 GPU 和 CPU 之间搬动时只改映射表,逻辑地址不变,所以推理引擎那一侧的代码不用知道数据被挪过。这和 PagedAttention 把逻辑块映射到显存物理块是同一个思路,只是范围从一张卡扩大到了多张卡加 CPU。
在 DP 模式下,每张卡负责自己的请求,管理自己的 GPU 池和 CPU 池,一个请求可用的容量就是两者之和。这里去掉的是 GPU 和 CPU 之间的重复:一条 KV 要么在 GPU,要么在 CPU,不会两边都有。
TP 模式的变化更大。所有卡的 GPU 池合成一个分布式地址空间,每张卡只存每个请求历史的一部分:逻辑地址 t 放在第 t mod P 张卡上,P 是卡数。这样 8 张卡存的是 8 份不同的历史,而不是 8 份同样的副本。代价是计算时要从别的卡取数据,所以负责计算的卡另外留一块本地缓冲区,存最近挑中过的 KV。稀疏注意力连续几步挑中的位置重合度很高,所以缓冲区命中率高,大部分时候只需要补取少数缺的条目。
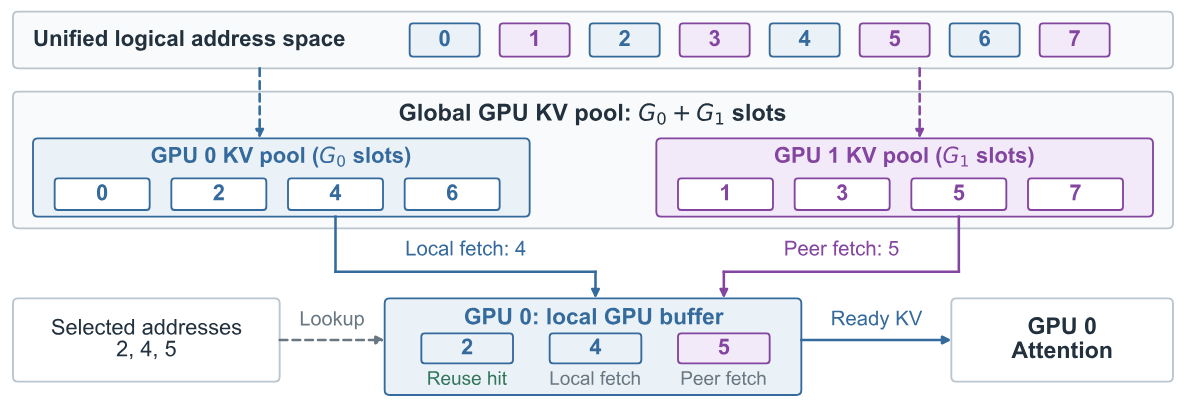
还有两个细节值得一提。GLM-5.3 里有些层共用同一次稀疏选择的结果,UlaCache 对这组层只做一次地址查找和去重,并在当前层计算时,用单独的 CUDA stream 预取后面几层要用的数据。另外,打分模块用到的索引键也按同样规则分散到各卡:每张卡只给本地的键打分,再用一次 all-gather 汇总。这一步省掉了重复打分,但在低并发时会带来额外的通信等待。
3. PB-LRU:共享的 GPU 池里先换出谁
开启 CPU 存储后,GPU 池不再按请求切块,而是所有请求共享,最近用过的留在 GPU,久没用的换到 CPU。这就需要一个替换策略。标准 LRU 要给每个槽记时间戳,选替换对象时要扫描整个池。每步解码、每一层都要做一遍,开销会落在解码的关键路径上。
PB-LRU(作者提出的并行分桶 LRU)用一个近似来避免扫描。它不再给每个槽排精确的先后,而是把同一轮调度里被访问的槽都放进同一个“桶”。每组层维护一圈最近的桶,外加一个冷桶。每轮调度当前桶往前挪一格,即将被复用的旧桶里剩下的槽归入冷桶,只改标记,不搬数据。需要腾位置时,先用空槽,再从冷桶里挑,再按从旧到新的顺序挑最近的桶。当前桶不参与挑选,因为里面的数据正要被这一步的注意力用到。
每个桶用位图表示,一位对应一个 GPU 槽。上面再叠几层汇总位图,每一位表示下面一段里有没有被占用的槽,挑选时可以直接跳过整段空白。命中检测、更新访问时间、去重都由 GPU 线程并行完成。数据搬运也有顺序要求:先把数据搬完,再更新映射表并发出完成信号,注意力等到信号才去读新位置,这样不会读到搬到一半的数据。
4. 实验:容量翻几倍,吞吐跟着涨
实验用 GLM-5.3(权重和 KV cache 都是 FP8),在 8×H200 和 8×B300 上测。对照组是 KV 全放 GPU 的 SGLang 和用 CPU 存历史的 HiSparse,投机解码用模型自带的多 token 预测头(MTP)先猜 2 步,再由主模型验证。为了公平,三个系统分到的显存相同,CPU 内存预算也相同(每张 H200 配 128 GB,每张 B300 配 192 GB)。负载是 Multi-LexSum 长文摘要,输入 64K 到 128K token,上下文足够长,KV 存储是主要压力。
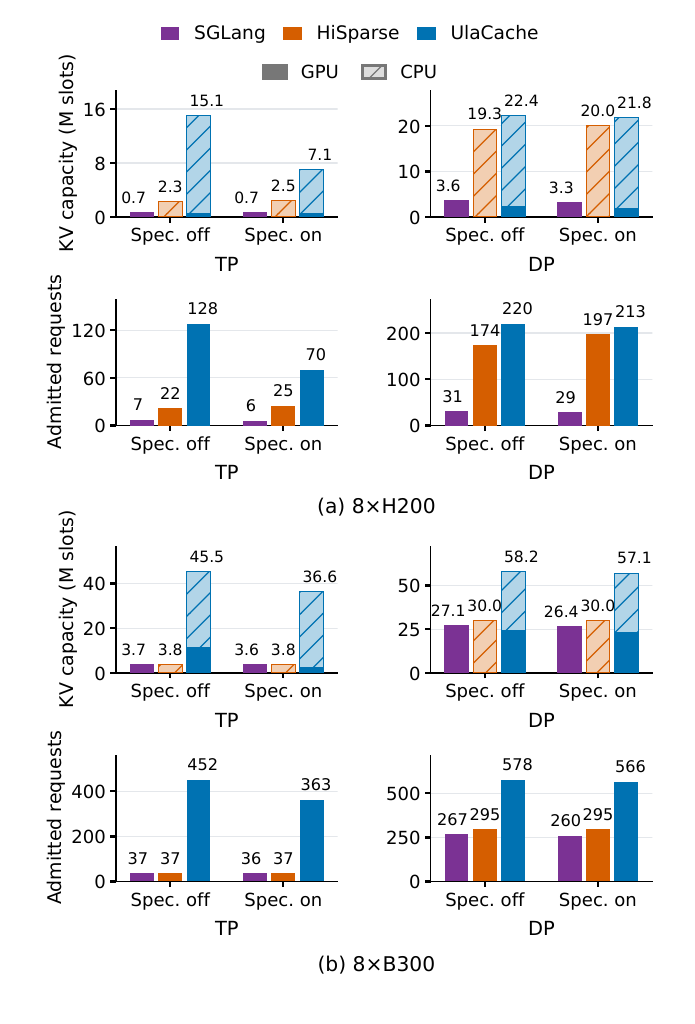
先看能同时装下多少请求。下表是论文 Figure 8 里的可接纳请求数(开投机解码):
| 配置 | SGLang | HiSparse | UlaCache | UlaCache 比 HiSparse |
|---|---|---|---|---|
| 8×H200 TP | 6 | 25 | 70 | 2.8 倍 |
| 8×H200 DP | 29 | 197 | 213 | 1.1 倍 |
| 8×B300 TP | 36 | 37 | 363 | 9.8 倍 |
| 8×B300 DP | 260 | 295 | 566 | 1.9 倍 |
TP 模式下的差距最大,因为那里去掉的是 87.5% 的跨卡副本。DP 模式下 HiSparse 本来就把历史放 CPU,所以 H200 上只多了一成。B300 DP 多出近一倍,是因为 B300 的显存大,GPU 和 CPU 不再互相重复后,多出来的空间相当可观。
容量多出来以后,要看它能不能变成吞吐。开投机解码时,峰值吞吐比 HiSparse 高:H200 DP 1.16 倍、H200 TP 1.70 倍、B300 DP 1.73 倍、B300 TP 2.51 倍。不开投机解码时,B300 TP 的峰值是 SGLang 的 3.51 倍。
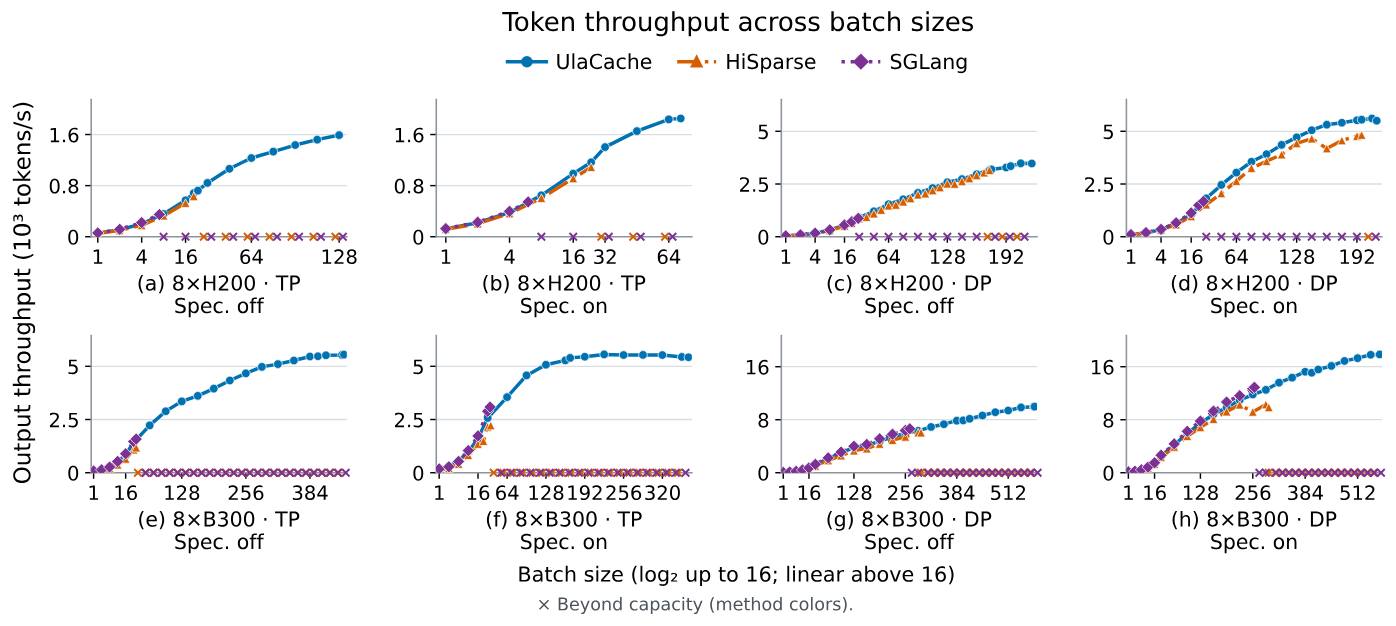
这张图比峰值数字更能说明问题。在两条曲线都存在的批大小上,UlaCache 和 HiSparse 几乎重合,所以单步速度并没有变快。差距出现在 HiSparse 曲线到头之后:它装不下更多请求,UlaCache 还能接着往上走。B300 TP 的请求数多了近 10 倍,吞吐只高 2.51 倍,因为批大到一定程度后吞吐曲线就平了,更多请求不再换来等比例的速度。唯一的例外是 H200 DP 开投机解码:请求数只多 8%,吞吐却高 16%。从曲线看,HiSparse 在大批量时有一段下滑,这符合它固定配额导致命中率下降的解释。
低并发时(批大小为 1),在八种配置下(两种 GPU × DP 或 TP × 开或不开投机解码),UlaCache 的 TPOT 都比 HiSparse 低,但比纯 GPU 的 SGLang 高。原因是多了地址查找、调度和 TP 下的跨卡通信。PB-LRU 的单独测试在 8×H200 DP 上回放同一组访问记录:它和精确 LRU 的 GPU 命中率相差不到 0.1 个百分点,说明分桶近似几乎不损失缓存效果。在较大批量下它的调度快 1.5 到 2.3 倍。但需要替换很少时,精确 LRU 反而更快,因为 PB-LRU 仍要维护桶的标记。
5. 局限与适用范围
- 只测了一个模型、一种负载:GLM-5.3 加长文摘要。不同的稀疏选择模式(每步重合度更低的任务)会影响缓冲区和 GPU 池的命中率,论文没有覆盖。
- 吞吐比较取的是各系统在所有批大小中的最高值,而各自的最高点出现在不同的批大小上。所以“2.51 倍”反映的是“能装下多少请求”,不是同样负载下更快。如果你的线上并发本来就到不了基线的容量上限,这个收益基本拿不到。
- 低并发下比纯 GPU 的 SGLang 慢。对延迟敏感、并发低的服务,纯 GPU 方案仍然更合适。
- 论文没有测精度。UlaCache 不改变注意力挑选哪些位置,理论上输出不变,但跨卡取数和换出换入的正确性只能靠实现保证,没有给出一致性验证。
- 没有报告 CPU 与 GPU 之间的带宽占用,也没有和同期其他稀疏注意力 KV 卸载系统做对比。
6. 实践意义
如果你在 SGLang 上部署 MLA 加稀疏注意力的模型,比如 GLM-5、DeepSeek-V4.1 一类,请求上下文很长,并且瓶颈是“显存装不下更多并发”,那么这篇论文最值得借鉴的是先查重复存储。用 TP 部署 MLA 模型时,先算一下每张卡上有多少 KV 是别的卡也有的。按论文的统计,8 卡 TP 下这个比例是 87.5%,去掉它带来的容量提升比加 CPU 内存还大。
其次,用 CPU 扩容时,要让 GPU 和 CPU 存不同的东西,并让所有请求共享 GPU 池,而不是给每个请求固定配额。最后,评估这类方案时要看同样批大小下的曲线,而不只看峰值倍数。前者告诉你单步有没有变慢,后者只告诉你能多装多少请求。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…