
在 RAG、上下文示例选择和智能体记忆里,同一个查询通常要过两遍模型:先由 embedding 模型编码成向量去检索,再由生成模型重新读一遍来作答。两个模型分开训练,对同一个查询的理解从不互通。腾讯微信 AI 和四川大学的作者认为,生成模型为了写出连贯的答案,隐状态里本来就要有一份“和答案相关的查询理解”,而这正是好的 embedding 该有的东西。他们提出后训练框架 ULME:在因果解码器的查询后面插几个可学习的 token,专门用来读出 embedding(论文叫 slot,下文叫槽位),再用一个带 stop-gradient 的损失,让生成侧的信息反过来塑造 embedding。在 Qwen2.5 和 Qwen3 两个家族、0.5B 到 8B 共 8 个规模上,同一个 ULME 检查点在 MTEB 上比同骨干最强的开源基线高 3.3–4.1 分,同时在 MMLU、GSM8K、MMLU-Pro、HumanEval 上和只做生成微调的模型持平或更好。
1. 问题:现有的“统一模型”只统一了参数
把 LLM 改造成 embedding 模型已经很成熟。E5-Mistral、NV-Embed 用对比学习微调因果 LLM,取最后一个 token 的隐状态;LLM2Vec 干脆去掉因果掩码,把它变成双向编码器。它们证明了解码器的隐状态足以做出很强的 embedding,但微调完的模型就不能再拿来生成了。
把检索和生成放进同一个模型也有人做过。GritLM 让一个 LLM 同时训练对比损失和语言建模损失;另一个方法 GEM 通过额外的 token 和自监督对比学习,给生成模型加上 embedding 能力。作者认为这些做法只统一了一半,缺口有两处。
第一处在机制上。GritLM 做 embedding 时切到双向注意力,生成时再切回因果注意力,所以 embedding 读出来的东西,和生成时的隐状态不在同一条计算路径上。
第二处在训练目标上。两个损失在共享的参数上各练各的,互不监督:生成不依赖学到的 embedding,embedding 也收不到来自生成侧的直接信号。参数共享本身并没有在两者之间建立联系。
还有一个更具体的冲突,出在从哪个位置读 embedding。因果 LLM 做 embedding 的常规做法是取查询最后一个 token 的隐状态,可在统一模型里,这个位置恰好要负责预测答案的第一个 token。作者把这叫作表示冲突:检索要的是一个整句级别、彼此之间用内积可以比较的状态,语言建模要的是一个能喂给 LM head、只管下一个词的状态,同一个隐状态被要求同时干两件事。
2. 方法:一串槽位,三个损失
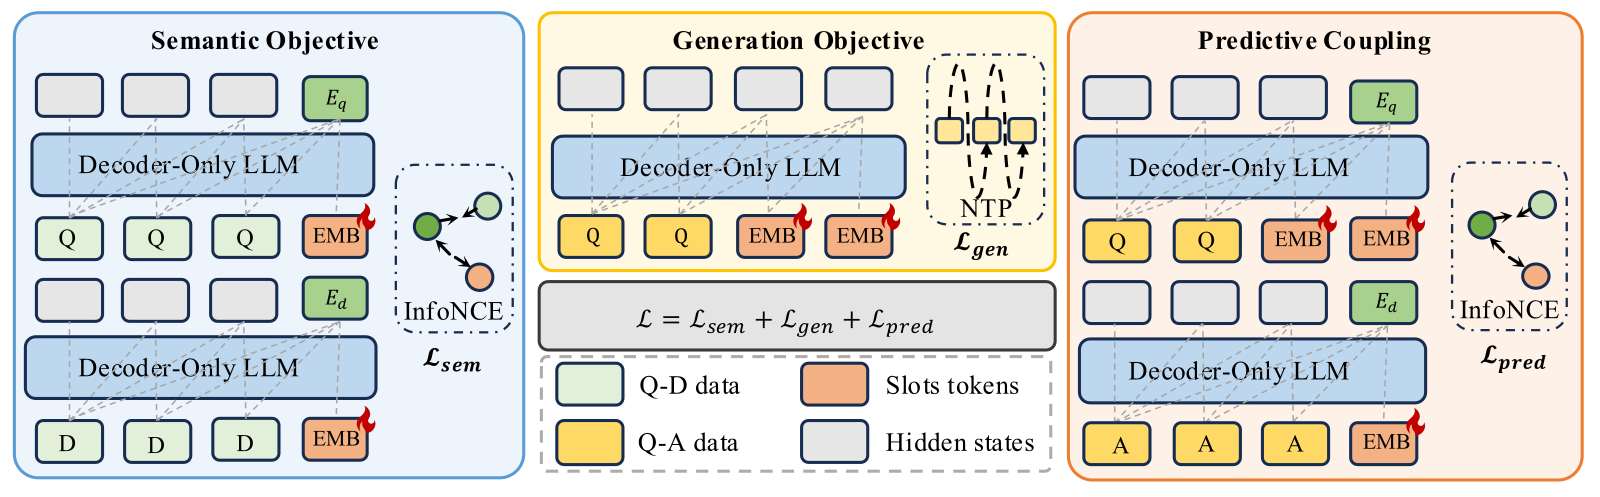
ULME 的第一步是给 embedding 单独留出读出位置。它借鉴 Coconut、pause token 这类隐式思维链的做法,在查询 和答案 之间插入 个可学习的槽位,训练样本写成 ,文档则编码成 。这些槽位就是因果前向里的普通位置:每个槽位能看到查询和更早的槽位,答案的每个 token 能看到所有槽位。掩码一点不改,也不加旁路,全程因果注意力,一次前向就同时得到 embedding 和答案。第一个槽位(slot 0)用作语义 embedding,最后一个槽位(slot )用作推理 embedding。
训练时同时用三个损失。前两个是常规的:一是对 slot 0 上的查询表示和文档表示做对称的 InfoNCE,负样本取跨卡的批内样本;二是普通的下一 token 交叉熵,只在答案部分计算。槽位本身不算 token 损失,但槽位链就在生成答案的因果路径上,所以语言建模的梯度会顺着答案对槽位的注意力传回来。
作者指出,只用这两个损失,其实就是以往统一模型的“各练各的”:语义损失只把 slot 0 拉向文档,不管答案说了什么;生成损失虽然以槽位为条件,却从不要求某个槽位表示什么特定的东西。
所以 ULME 加了第三个损失,叫预测耦合,它在两边之间搭了一座桥。具体做法是把查询侧最后一个槽位的隐状态 ,和同一次前向里答案部分隐状态的池化 (默认取均值)对齐。对齐用单向的批内 InfoNCE,并且对答案侧做 stop-gradient :
stop-gradient 放在答案侧是有意为之。 同时看到了查询和答案,比只看到查询和槽位的 信息更多,所以应该让信息少的一侧去够信息多的一侧。如果梯度也流回 ,答案侧的表示就会被推向“在批内好区分”的方向,干扰生成损失要监督的隐状态。这相当于把答案侧的表示单向蒸馏进推理时就能拿到的查询槽位里。三个损失加权求和,,,默认 。
用一个例子看三个损失各管什么。查询是“怎么让 Python 列表去重并保持顺序”,训练时的答案是一段用 dict.fromkeys 的代码加解释。语义损失让 slot 0 靠近对应文档的 embedding;预测耦合让 slot 3 靠近这段答案隐状态的均值。到了推理时,不用生成答案,只跑查询加 4 个槽位,就能读出 embedding:检索时取 slot 0 的语义 embedding 当查询向量,和文档一侧的向量做内积;slot 3 的推理 embedding 也能单独读出来用,后面的图 2 比较了两者。
3. embedding 结果
embedding 侧的训练数据是 LLM2Vec 格式的 E5 对比数据,生成侧是 OpenThoughts-114k。每个配置只训一次,报告最终检查点;评测时不关掉任何能力,也不单独微调任何 head。基线数字取自 LLM2VEC-GEN 论文在同样骨干上的报告。
MTEB(eng, v2) 平均分:
| 骨干 | LLM2Vec | LLM2VEC-GEN | ULME |
|---|---|---|---|
| Qwen3-1.7B | 54.8 | 58.6 | 61.9 |
| Qwen3-4B | 56.8 | 60.6 | 64.1 |
| Qwen3-8B | 56.8 | 61.9 | 66.0 |
三个规模上,ULME 比最强基线 LLM2VEC-GEN 高 3.3–4.1 分,比 LLM2Vec 高 7.1–9.2 分,而且模型越大领先越多,说明这个做法在更大的骨干上收益不会消失。
按任务类别拆开看,优势主要来自检索、摘要和成对分类,比 LLM2VEC-GEN 分别高约 8–9、7–8.6、5.3–5.7 分。作者注意到,提升最大的检索和摘要,恰好都是“要找的目标本身是一段生成文本”的任务,这说明用答案来塑造查询表示,对这类任务帮助最大。不过提升并非处处都有:聚类和分类在部分规模上比 LLM2VEC-GEN 略低,最多低 1.5 分。
在需要推理的检索上,ULME 也没有拿一个能力换另一个。BRIGHT(nDCG@10)上它比 LLM2VEC-GEN 高 0.7–1.2 分,8B 为 21.4。AdvBench-IR 衡量模型会不会检索出有害内容,越低越好,ULME 比 LLM2Vec 低 20–25%,比 LLM2VEC-GEN 再低 1.3–1.8 分。两个方向同时变好,说明检索能力的提升没有以安全性为代价。
4. 生成结果:没有变差,代码和数学还更好
对照组是在同样的 OpenThoughts-114k 上只做生成微调的模型(下称 Gen-only),所以差别只来自 ULME 多出来的 embedding 目标。知识和数学题(MMLU、GSM8K、MMLU-Pro)上,ULME 除了 Qwen3-8B 的 MMLU 低 0.1,其余都持平或更好;最明显的是 8B 的 GSM8K,89.5 对 78.6。代码上每个规模都更好,HumanEval 高 2.4–4.9 分,8B 的 HumanEval+ 是 67.7 对 62.8。作者的解释是,让查询槽位提前概括模型将要生成什么,对代码这种结构化、可以跑测试验证的输出尤其有用。ULME 和 Gen-only 有时都比原始骨干略低,作者认为这是继续在 OpenThoughts-114k 上训练带来的分布偏移,不是联合目标造成的。
5. 消融:三个损失确实互相牵连
消融都在 Qwen2.5-7B-Instruct 上做,embedding 用 10 个任务的 MTEB-lite,生成用 MMLU 和 GSM8K。
先看要不要槽位。不加槽位、直接取查询最后一个 token 时(),MTEB-lite 是 58.6,比 的 63.8 低 5.2 分,MMLU 也低 2.0 分。这说明第 1 节说的读出位置冲突是真实存在的代价。加一个槽位就补回大部分差距, 最好, 略降,作者推测是槽位链太长,每个槽位分到的梯度被稀释了。
再看逐个去掉损失。去掉语义损失,MTEB-lite 从 63.8 崩到 31.2,生成不受影响;去掉生成损失,MMLU 掉 14.7、GSM8K 掉 15.8。这两条在意料之中。值得注意的是去掉一个损失后,另一边的分数也跟着变:去掉生成损失,embedding 也掉了 2.8 分,说明语言建模塑造出的答案侧隐状态确实在给查询槽位提供信号;去掉预测耦合,生成持平,embedding 掉 3.6 分。后一个数字最干净地衡量了耦合本身的贡献,也就是退回到以往“各练各的”范式要付出的代价。
预测耦合的对齐目标怎么取,也有影响。用答案隐状态的均值得 63.8,按长度加权的均值(论文没有说明权重怎么按长度取)得 62.7,只取答案最后一个 token 得 61.9。最后一个 token 同时要负责预测下一个词,拿它当目标,会把局部的生成压力带进 embedding。三种取法下生成分数几乎不变,说明两种能力是在共享计算里通过不同的通道被监督的。
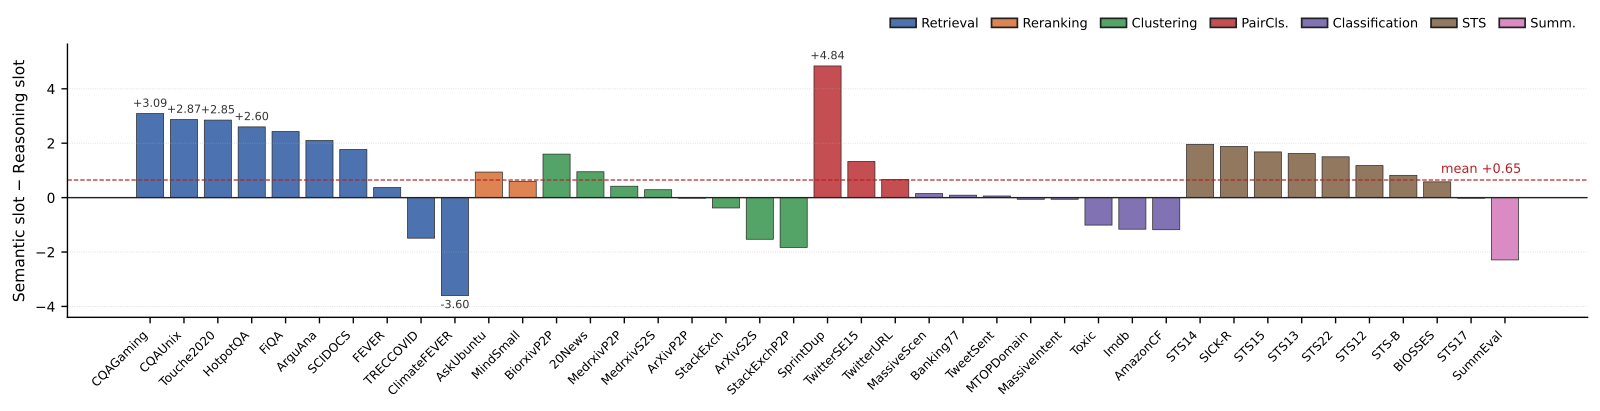
最后,两个槽位学到的东西确实不一样。slot 0 领先最多的任务,比如 SprintDup(+4.84)和 HotpotQA(+2.60),相关性主要靠词汇或实体重合;slot 领先最多的任务,比如 ClimateFEVER(+3.60)和 SummEval(+2.29),需要理解文档实际在主张、概括或表达什么。所以 slot 0 更像传统的语义匹配,slot 更接近“读懂了答案之后的查询理解”。
6. 局限与实践意义
论文正文没有专门的局限一节,下面几点是从实验设置里读出来的。主表只展示了 Qwen3 的三个规模,另外五个骨干放在补充材料里。所有消融只在一个骨干(Qwen2.5-7B)和 10 个任务的子集上做。每个配置只训一次,没有报告方差。基线数字引自 LLM2VEC-GEN 的论文而不是重新跑的,没报告过的骨干就空着,所以有些规模上缺少完整的横向对比。和 GritLM、GEM 这些统一模型没有放在同一张表里直接比。槽位带来的推理开销,以及在真实 RAG 或智能体系统里的端到端收益,也都没有报告。
对工业界,这篇论文的意义在于部署形态。RAG 和智能体记忆系统现在普遍要并排部署一个 embedding 模型和一个生成模型,各占显存、各自维护。ULME 给出了一条可行的路线:一个检查点、全程因果注意力、不用切模式,embedding 和生成都不输专用模型,而且算 embedding 只要跑查询加 4 个槽位,不用先生成答案。有两个工程细节值得借鉴:给 embedding 读出留专门的位置,不去挤占预测下一个 token 的位置;用 stop-gradient 把“更懂答案的一侧”蒸馏进推理时就能拿到的查询表示。至于能不能真的省掉一套 embedding 服务,还要看它在自家检索语料上的召回,以及槽位带来的额外延迟。
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…