
推荐排序每天都算了大量最终没有展示的候选。这篇工作把其中的高分候选重新用于发现新类目:把这些候选按用户累计一个月,筛出近期没有展示过的类目,再接回召回。在淘宝信息流的在线实验里,按实际展示计数的发现类目数相对增加 3.47%,完整观看次数增加 2.62%;两项都达到统计显著。总观看次数没有显著变化。这里改的是候选的保存和使用方式,排序模型不用重训。
排序分数已经算了,候选却没机会展示
一次信息流请求经过召回、排序和重排,能展示的内容远少于模型打过分的内容。有些候选分数较高,仍会因为展示位置有限、与其他候选竞争而落选。下一次请求到来时,常规召回未必再找回它们。URED(Unexposed Recycling for Efficient Discovery)保存的就是这部分结果。
用一个过程示意:某用户的一次请求里,一条园艺视频已经经过排序,分数较高,但最后没有展示。之后的请求如果能再召回它,仍由现有排序和重排决定是否展示。保存候选不等于预定一个展示位置,也没有把未曝光当作用户不喜欢它的反馈。
这条视频是否属于“发现内容”,还要单独检查。本文所有在线实验都用 15 天作为发现窗口:过去 15 天没有向该用户曝光的类目,算发现类目。系统中的窗口长度可以配置。它衡量近期曝光范围是否扩大,不要求视频刚发布,也不等于用户从未对这类内容感兴趣。
这就把两件事分开了:排序分数用来筛选较有希望的候选,曝光历史用来检查它能否增加近期没见过的类目。若只做第二件事,随机挑新类目加入推荐,候选未必适合这个用户。
一条未展示的视频怎样回到召回
这条通道不引入新的预测模型,但要新增数据管道和召回通道。它复用候选,不省掉后续请求原有的排序与重排计算。原图的绿色部分是既有推荐流程,蓝色部分保存落选候选,并在后续请求中重新提供给召回。
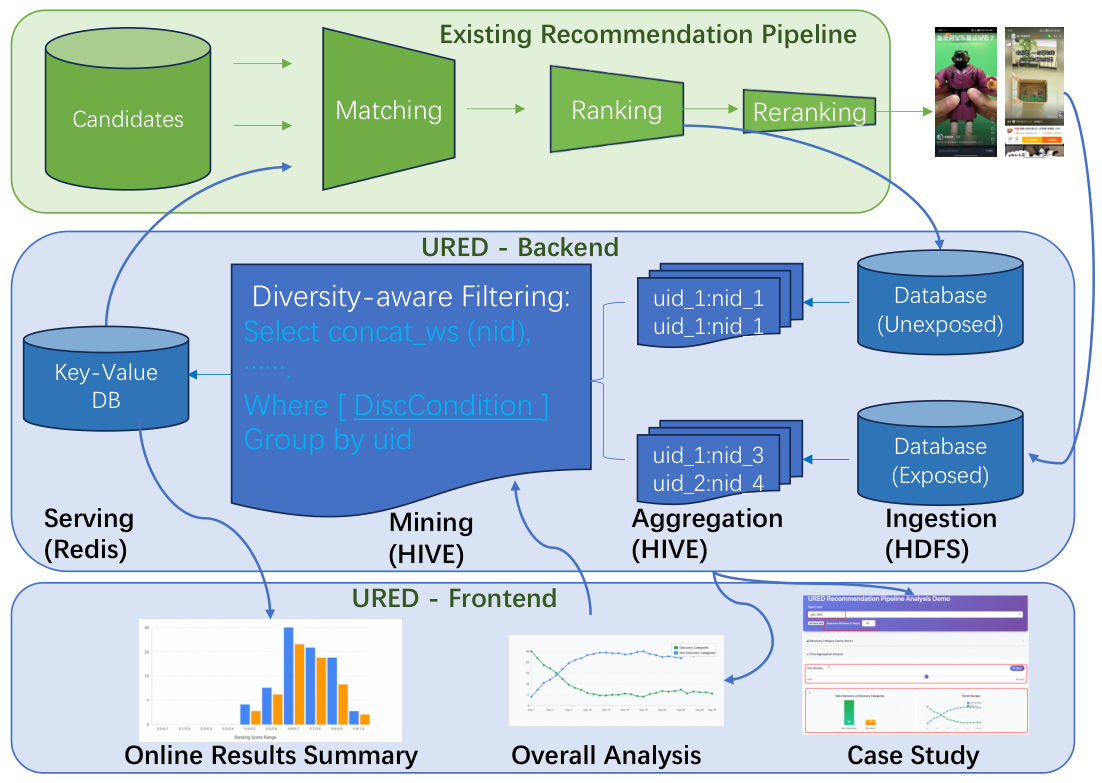
排序结束后,系统识别已打分但未展示的内容,按 session 保留分数最高的前 200 个,连同类目和时间等信息异步写入离线存储。这里收集的是排序后未展示的候选,不是过去展示过、现在准备重复推送的视频。曝光日志另行保存,后面用它检查发现条件。
每天的批处理把同一用户过去 30 天的候选合并。重复的视频只保留一次,按最近时间排列,每个用户最多保存 10,000 个。这里的截断依据是时间,不能理解成把一个月内所有请求的原始分数直接混排。
接着,系统把候选类目与该用户近期的曝光类目做比较。沿用实验配置,它留下过去 15 天没曝光过的类目。前面那条园艺视频只有通过这一检查,才会进入发现候选池。池子按用户编号写入线上 key-value 存储;新请求到来时,最多取回 1,000 个候选,与其他召回通道的结果合并,再交给现有排序和重排。 Hoot 说

过程示意,不是实验样本。高分未展示只使候选被保存;类目过滤决定能否进池,后续排序决定能否展示。
出处
论文§2.1、§3.1–3.4;15天来自§5这些数字分别限制了每次采集量、累计时间、每用户存储量和线上取回量。1,000 是加入召回池的上限,不是向用户展示 1,000 条视频。模型不重训,仍有日志采集、离线任务、存储和候选合并需要维护。
为什么要累计一个月
一次请求能留下多少高分且符合发现条件的候选,取决于用户已有行为和本次排序结果。只收集一天,供给可能太少;扩大单次取回上限,也取不出池子里不存在的内容。
论文用同期并行的在线实验改变累计窗口,检查收益是否随候选积累而增长。窗口为一天时,发现类目数只增加 0.55%,没有统计显著性。累计到 30 天,增加 3.47%;继续延长到 60 天,只到 3.51%。作者据此把一个月作为收益与存储开销之间的工作点。
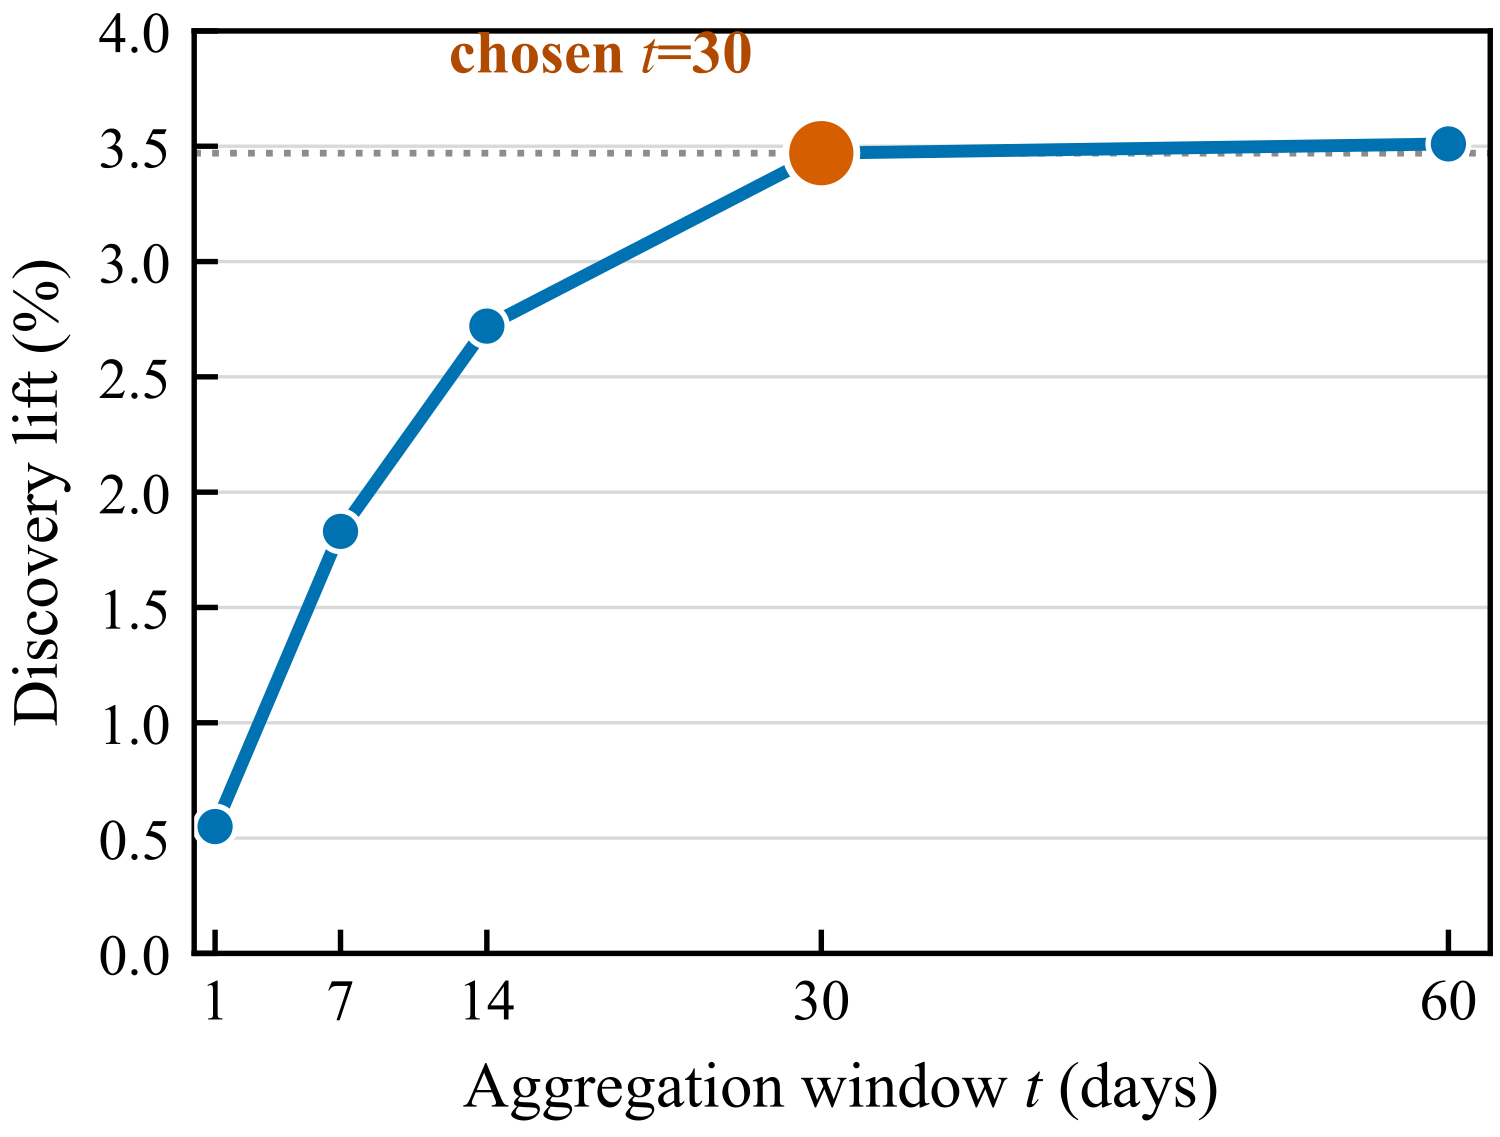
另一个部署数字是候选覆盖率:30 天窗口下,88.3% 的日活用户有非空候选池,意味着通道对这些用户有候选可取回。这描述了候选的供给范围,与实际新增展示类目的收益是两种统计。
这些结果解释了本系统为什么使用月度积累,而不是给所有业务一个固定窗口。作者提到更长窗口会增加旧候选;现有排序能留下多少合格候选,也影响有效供给。论文的人群分析也与这一点一致:高活跃用户的发现比例变化更大,低活跃用户基本没有变化。
在线收益来自哪种比较
主实验按用户随机分组:对照组使用原推荐流程,实验组增加 URED 召回通道。对照流量为 10%,实验桶为 5%–10%,每项报告的实验都运行超过一周。论文用 Z 检验评估显著性。下面摘出表 2 的三项相对变化,不是绝对增加的百分点。
| 指标 | 相对变化 | 统计结果 |
|---|---|---|
| 发现类目数 | +3.47% | 显著 |
| 完整观看次数 | +2.62% | 显著 |
| 总观看次数 | +0.36% | 不显著 |
原表还报告内容多样性显著改善。这里关注的完整观看与总观看,回答的是不同问题。实验支持增加发现类目、改善完整观看,不能据此宣称总观看次数已经提高,也没有直接测量用户形成了长期新兴趣。
表 3 则检查候选来源和窗口是否重要。一组保留高分筛选,把累计窗口缩成一天。另一组保持注入配额,取消模型分数筛选,随机选择符合发现条件的物品,其中包括从未给该用户打分的冷启动物品。已向该用户展示过的物品仍排除。它不再局限于完整方案日志里那些已打分的候选。
| 相对无 URED 对照组 | 发现类目数变化 | 总观看次数变化 |
|---|---|---|
| 高分未曝光候选,累计 30 天 | +3.47%,显著 | +0.36%,不显著 |
| 高分未曝光候选,累计 1 天 | +0.55%,不显著 | +0.02%,不显著 |
| 随机发现候选,包含冷启动内容 | +0.12%,不显著 | −0.17%,不显著 |
在这些设置里,只有完整方案的发现类目增幅达到显著。随机注入没有复现这个收益,但其总观看下降也不显著,不能写成已经证明随机探索伤害观看。对工程选择更有用的判断是:本实验支持保存高分候选并长期积累,未支持仅增加随机发现内容。
高分是选择条件,不是可靠性的保证
作者的设计假设是,已有排序在部分未曝光候选上仍有足够的个性化信号,高分可以用来选出这部分内容。
不过,一个候选分数高,不能单独证明其预测误差小。URED 的在线收益支持这个选择策略在该系统有效;它没有证明排序对每个高分未曝光候选都已校准。原模型不擅长的类目和用户,仍可能留下质量较差或数量很少的候选池。作者把低活跃用户收益接近零解释为候选供给稀少;这一人群差异本身不能单独确定成因。
另一个容易误读的数字来自通道对比:URED 展示内容中,85.9% 属于发现类目,平台整体为 6.2%。这是各通道展示内容的组成比例,不能解释成每位用户的发现收益增加了十几倍。该通道的有效观看率,即观看超过指定时长的比例,为平台平均值的 1.03 倍;它与随机分组得到的发现类目数增幅,衡量的不是同一件事。离线过滤到线上服务之间有延迟,论文用这段时间差解释发现占比为什么没有达到 100%。
工程团队可以从候选日志开始
URED 已在千万级日活的淘宝信息流运行超过半年。线上增加的是按用户查询候选的操作,论文测得端到端服务延迟开销低于 1%。离线仍要累计、去重和过滤一个月的日志;作者利用已有批处理空闲容量,不能把这部分理解成没有计算和存储成本。
试做时,可以先统计高分未曝光候选的类目、数量与年龄分布,看近期没见过的类目是否确实有足够供给。接着比较不同累计窗口的非空池覆盖率和每用户候选数,避免只增加线上取回上限。具备供给后,再增加小流量召回实验,同时检查发现、完整观看和总观看,分别报告显著性。这些是由论文机制得到的试用建议,不是额外实验结果。
它可借鉴的地方,是保留已经付过排序成本、却没获得展示机会的候选,让它们在后续请求里继续参与竞争。
| 维度 | 判断与理由 |
|---|---|
| 问题重要性 | 高。扩大曝光类目时,要同时控制候选质量。 |
| 方法创新性 | 中。主要贡献在候选复用和数据流程,不是新排序结构。 |
| 实验证据 | 较强。有在线随机实验及窗口、来源对照,总观看收益不显著。 |
| 工程成本 | 中低。免模型重训,但需要按用户积累候选与线上存储。 |
| 是否值得尝试 | 有条件。适合已有可靠排序、且高分落选候选供给充足的系统。 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…