
微信搜索的 WeSearch 用一个模型替掉了原来并行的多路召回:先按 query 找出相关的文档簇,再在这些簇里逐篇给文档打相关分,把粗筛和精细判断分开。它不像生成式检索那样给每篇文档一个固定的层级 Semantic ID,那种做法默认一篇文档只走一条语义路径,可一篇文章常常同时讲好几件事。索引可以增量更新,模型从原来的每月更新变成每周、必要时每天刷新。它已作为微信搜索的主召回上线,一个月全量 A/B 里 CTR 提升 0.68%,检索资源成本降了 41%。多取一些簇来保召回,谁更相关交给逐篇打分。
这篇值得细看,因为它是少见的在十亿级内容搜索里把多路召回收成一个模型、而且成本下降的实践。思路本身不新,就是先分簇再在簇里找、文档向量做乘积量化、最后加一个小排序网络。新的是把这几样都当成模型参数一起训练,再配上增量挂载和定期整体刷新,让它能长期在线跑。
一个具体场景:多主题文章走哪条路
先看 Semantic ID 的麻烦(示意)。假设一篇公众号文章前半讲周末带娃去北京哪些博物馆,后半讲怎么在小程序上抢门票。层级 Semantic ID 要给它一串编码,比如第一位定在「亲子出行」,后面几位再细分。用户搜「博物馆门票怎么预约」,如果解码第一步走向「票务和工具」这一支,这篇文章就永远解码不出来。
| 示意 | 文章内容 | 层级 Semantic ID 的处理 | WeSearch 的处理 |
|---|---|---|---|
| 文章 A | 带娃逛博物馆 + 抢票攻略 | 只能挂在一条路径上 | 落在某个簇里,簇只负责把它带进候选 |
| query「博物馆门票怎么预约」 | 偏票务 | 第一位走错就整篇丢失 | 一次取上万个簇,A 所在簇大概率在内,再逐篇打分 |
WeSearch 的关键观念是:簇不是文档的身份,只是一个装候选的篮子。每篇文档只属于一个篮子,它的篮子没被选中,这篇就进不了候选。WeSearch 的办法是一次取上万个篮子,让相关文档所在的篮子大概率被选中。它也不用像 Semantic ID 那样一位一位地解码,前一位走错不会把后面整条路径带偏。篮子分得粗一点、杂一点都没关系,只要相关文档大概率在被选中的篮子里;真正判断谁更相关,交给后面逐篇打分的那一步。
整体流程:先挑篮子,再逐篇排
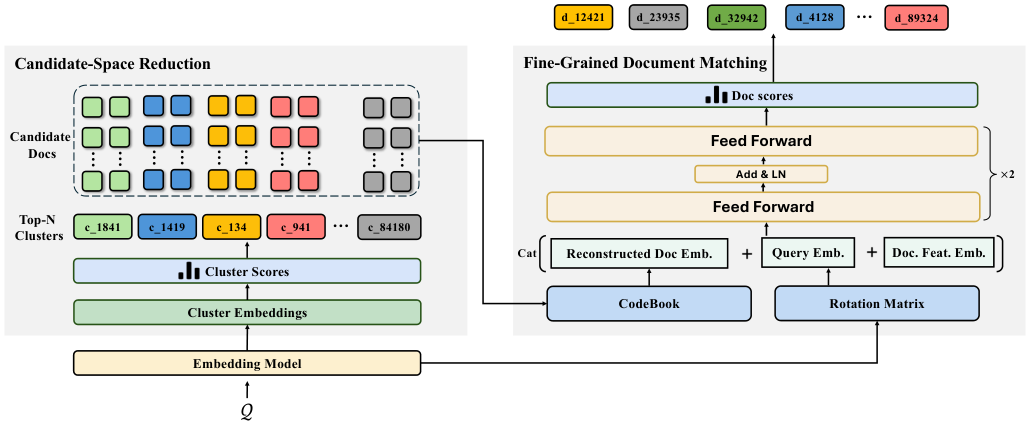
线上一次请求分三步。第一步,query 编码器把 query 变成一个向量,和所有簇的中心比距离,取最近的 N 个簇,把簇里的文档合起来当候选。第二步,用压缩过的文档向量快速算一遍距离,留下前 P 篇。文档向量在内存里是用 OPQ 压缩存的:先乘一个旋转矩阵,再切段存编号,细节下一节讲;query 向量也乘同一个旋转矩阵,两边才能比距离。
第三步,压缩时每篇文档的向量被切成 m 段,每段只存了码本里最接近的那一小段向量(码字)的编号;现在按编号把这 m 小段取出来,拼回一个近似向量(它和旋转后的 query 向量在同一个空间,不用转回去),一个小的前馈网络把旋转后的 query 向量、这个还原的文档向量和文档特征拼起来打分,输出最终的前 K 篇。训练和线上用的都是这种还原向量。文档特征包括质量、点击等行为统计和时效,每个原始特征先分桶,再查各自的 embedding 表,这些表是模型参数,随模型一起训练,拼起来就是文档特征 embedding。
为什么要三步而不是两步?候选集很大,带特征的前馈网络对每篇都算一遍太慢;只用向量距离又分不出质量、时效和用户反馈的差别。所以先用最便宜的距离粗筛,再在少量候选上用贵一点的网络精排。
N 取多大,论文在亿级的 Base 语料上扫过:簇数增加时候选覆盖先涨,到 1 万个左右后几乎不再涨,推理成本却继续上升,于是定在 1 万。
簇和压缩:都是模型参数
簇是离线用两层残差聚类(RQ-KMeans)得到的:第一层先把文档向量分成粗类,第二层再对每个文档减去粗类中心后剩下的部分继续聚类。一个簇的中心就是两层中心相加。这样分得比单层 k-means 更细,训练成本却差不多。
文档向量要全部放进内存,十亿篇存原始向量放不下。WeSearch 用 OPQ 压缩,每篇文档只存 m 个码字编号。
先看离线建索引。query 编码器由一个预训练好的双塔模型初始化,全库文档的向量就用这个初始化后的编码器算出。聚类、旋转矩阵、码本和每篇文档的 m 个编号,都在这些向量上离线算好,和模型参数一起存进 checkpoint。
再看训练。论文把旋转矩阵和码本都当成模型参数,跟着检索目标一起训,压缩带来的误差直接按检索效果优化,而不是事后单独压一遍。论文把文档编号当作建索引时存好的东西,只在发布新版本时重算,所以我的理解是:训练中编号不变,文档一侧按存好的编号去码本里取向量拼起来,被训练的是码本里的向量;旋转矩阵作用在 query 向量上。 Hoot 说

- 示意:这篇文档存的编号是 (#2, #1),意思是“第 1 段去码本取 #2,第 2 段取 #1”,文档自己不存向量。
- 训练前取出 (0.4, 0.1 | 0.3, 0.5)。和旋转后的 query (0.5, 0 | 0.3, 0.4) 逐段算平方距离:第 1 段 0.01+0.01,第 2 段 0+0.01,合计 0.03。
- 一步训练把第 1 段的 #2 码字从 (0.4, 0.1) 挪到 (0.5, 0.1)。编号还是 (#2, #1),取出的向量却变成 (0.5, 0.1 | 0.3, 0.5),平方距离变成 0+0.01+0+0.01 = 0.02。
- 解读:训练中编号固定,是从论文“发布时才按这一版参数重新生成编号”推出来的。新版本上线时,模型、簇、码本和编号一起验证、一起切换。
示意:文档只切 2 段(论文是 m 段),每段码本只画 3 个码字,向量和数值都是编的。“训练中编号固定”是从论文“发布时按这一版参数生成编号”推出的解读。 出处: 论文 §3.2.2(旋转矩阵和码本是模型参数,文档向量由编号从码本取码字拼回)与发布流程一节(不在每次训练更新后重建,发布时按该版本参数生成编号);数字全部为示意。
最后是发布。新版本模型上线时,按这一版的文档向量和簇中心重算每篇文档的簇分配,用这一版的旋转矩阵和码本重算编号。模型、簇、码本和编号作为一个版本一起验证、一起切换。两次发布之间新来的文档,用当前上线版本的编码器算向量,再用这一版固定的簇和码本挂进去。
| 簇结构 | 文档表示 | Recall@300 |
|---|---|---|
| 2k×1k | OPQ(32 段, 码本 256) | 46.66% |
| 2k×1k | OPQ(32 段, 码本 512) | 47.10% |
| 2k×1k | OPQ(64 段, 码本 256) | 51.54% |
| 10k×200 | OPQ(64 段, 码本 256) | 51.34% |
| 2k×1k | 直接存 32 维向量 | 33.07% |
这张表说明两件事。簇怎么分(2k×1k 还是 10k×200)几乎不影响结果;文档表示的容量影响很大。直接存 32 维向量的 Recall@300 是 33.07%,比 OPQ(64 段, 码本 256) 低了 18 个点左右。论文的解释是直接降维会丢掉细粒度信息,分段量化的表示容量更大。
粗排时怎么快速算距离?对每个 query,先算出它每一段和那段码本里每个码字的距离,存成一张查表。之后每篇文档的距离就是把它 m 段编号对应的表项加起来,只做查表和加法,不做向量乘法。这张表每个 query 只算一次,所有候选共用。
训练:三种损失和多来源样本
训练同时要教会两件事。一是选对簇:用簇级交叉熵,让 query 向量离正样本所在簇的中心更近。二是在候选里挑对文档:在前 P 个候选上做 listwise 交叉熵,训练时会强制把正样本放进候选;再加一个 pairwise 间隔损失,让强相关的文档排在弱相关的前面。
正样本来自三处:人工或老师模型打的高相关分、搜索会话里的高满意度、长停留和有效点击。负样本主要找同一个 query 下的「近似但不够好」的文档,比如相关等级更低的、曝光了却没被有效点击的、被检索系统排得很高但被判为不相关的。论文特别说明,没点击不直接当负样本,要结合曝光和位置一起看。
模型按滚动方式训练:每轮把新收集的 query、文档、标注和反馈,和一批历史上的高质量样本混在一起,从上一个 checkpoint 接着训。新数据让模型跟上新话题,老数据防止忘掉长尾知识。
新文章怎么进索引
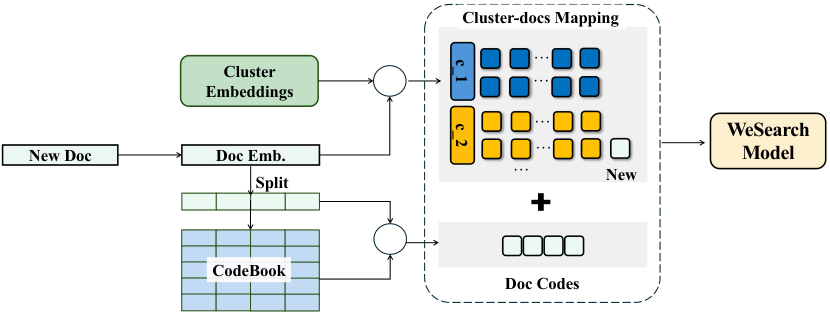
这里能看出不用 Semantic ID 的另一个好处。新发的文章不需要改任何模型参数:用当前上线版本的编码器算出向量,分到最近的簇,用现有码本量化,把编号挂到那个簇下面就行,后台持续做,新内容很快就能被搜到。论文给的原因是簇只用来缩小候选范围,不是文档完整的层级编号,所以新文档挂进去不牵动别的文档。
线上效果
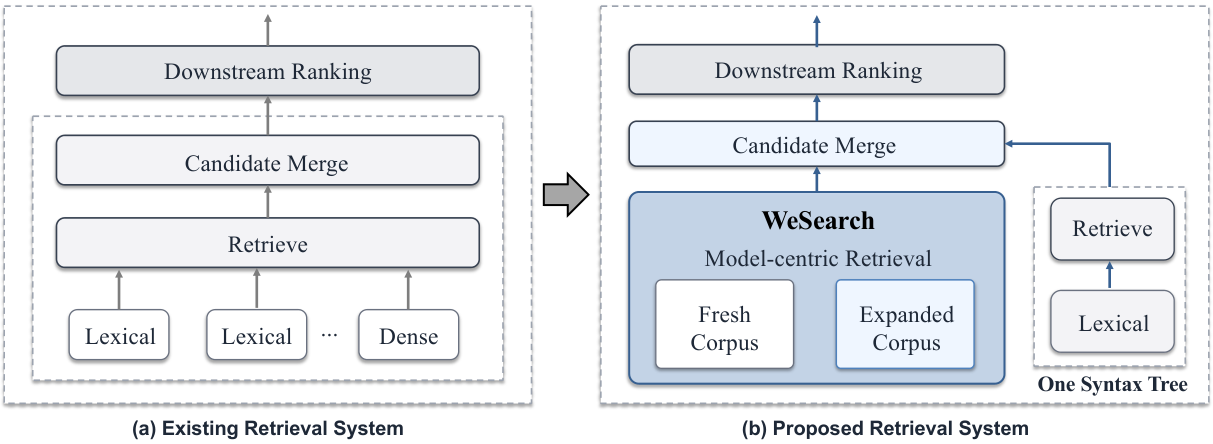
上线时,WeSearch 替掉了原来并行的多路文本匹配和向量召回,只留一路语法树做精确词匹配,两路结果合并去重后交给下游排序。
在十亿级语料上,论文让一个满意度老师模型给每个 query 返回的结果逐条评级,统计被评为高质量的结果占多少。原来的线上系统是 0.1732,WeSearch 单独用是 0.1871,加上语法树后到 0.2088。结果支持保留一路语法树补充精确词匹配。
人工盲评里,标注员并排比较 WeSearch 和原系统的结果列表。三种语料规模下,人工判断都偏向 WeSearch,和线上 A/B 的方向一致。
一周 A/B 在三种语料规模下 CTR 都涨,幅度 0.27% 到 0.61%,长 query 流量上的 CTR 涨了 1.10%,长 query 更依赖语义理解,这个结果合理。
一个月全量 A/B 里 CTR 涨 0.68%,结果页停留时长涨 0.71%,人均文章点击涨 2.27%,说明一周的提升在一个月里没有消退。与此同时,检索资源成本降了 41%,图文检索延迟少了 19 毫秒。成本下降我认为主要来自多路召回合成了一个模型,延迟还得益于论文第 5 节的推理加速和去掉多余序列化。
我认为它的局限
- 和 Semantic ID 的对比只在一张图上。Base 语料上 Semantic ID 方法在所有截断位置都不如线上基线,但这组对比没有放到十亿级语料上做,很难判断是方法本身不行,还是没调好。
- 线上 A/B 的收益没法拆到结构、特征和样本挖掘各自身上。离线的十亿级消融里,只用语义向量时 Recall@100 在两个相关性子集上超过线上,但在长停留子集上低于线上(0.4323 对 0.4407)。行为指标上的提升主要来自文档特征和样本挖掘,这些也能加到别的召回方案上;而且加了样本挖掘后,其中一个相关性子集反而略降(0.3865 到 0.3794)。
如果要试
- 先看自己的语料里多主题文档多不多。如果大部分文档主题单一,Semantic ID 的问题不明显。
- 用现有双塔的文档向量做两层残差聚类,扫一遍每个 query 取多少个簇时召回饱和,确定篮子的规模。
- 把文档向量用 OPQ 压缩,和直接降维对比召回,确认压缩没吃掉太多效果。
- 在候选上加一个带文档特征的小前馈网络,用 listwise 加 pairwise 损失训练,样本里加入同 query 下的低等级和曝光未点击负样本。
- 离线召回过关后,先替一路向量召回做 A/B,保留精确匹配通道,再看能否逐步合并其他通路。
评价
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高:十亿级内容搜索的召回成本和效果是核心问题 |
| 方法创新性 | 中:各部件都是成熟技术,贡献在于组合成一个可训练、可增量更新的模型 |
| 实验证据 | 中高:有一个月全量 A/B 和成本数据,但和 Semantic ID 的对比太简略 |
| 工程成本 | 中高:需要分布式训练、量化和在线查表优化 |
| 是否值得尝试 | 值得,特别是多路召回维护成本高、文档多主题的内容搜索 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…