目录 · 9 节
1它到底在解决什么问题?2整体流程3两路检索各是什么?4模型到底在预测什么?5阈值怎么定,成本怎么算?6结果:证据找得省,答案没变好7我认为它的局限8一个搜索/RAG 团队可以怎么试9结论
RAG 里多加一路检索,到底值不值?这篇论文先用向量检索加重排拿到一批证据,再用一个小线性模型读这一轮检索留下的分数,比如第一名的相似度多高、和第二名差多少、重排前后的前十条重合多少,预测换成 BM25 加向量的混合检索能不能多找回证据,只有预测收益够大时才切换。在科研论文问答数据集 QASPER 里没参与训练的 60 篇论文上,它只给 24.5% 的问题换了混合检索,证据命中率就和每题都用混合检索一样,都是 78.70%。可是让一个 4B 小模型据此生成答案后,答对率和忠实度都没有变好。证据找得更省,不等于答案更可靠,检索指标的提升不能直接当成问答质量的提升。
做 RAG 和搜索的团队值得花十分钟读,但读它的理由不是方法。方法很朴素,一个六特征的岭回归加一个阈值,作者自己也说不主张算法新意。值得读的是它把三件常被混为一谈的事拆开测了:找到对的证据、决定什么时候花钱多检索一次、答案真的更对更有据。前两件在它的实验里成立,第三件不成立。实验规模很小,是单作者的研究,置信区间全部跨过 0,所以我把它当成一个做得很规矩的反例,而不是一个可以直接搬的方案。
它到底在解决什么问题?
设想一个科研论文问答助手,用户针对一篇论文提问,系统在这篇论文内部找段落,再交给大模型作答。下面三个问题(示意)走的都是同一套基线检索:
| 问题(示意) | 基线检索的样子 | 多跑一次混合检索会怎样 |
|---|---|---|
| 这篇论文的主要贡献是什么? | 第一名相似度很高,前几名分数拉得开 | 大概率找到的还是同几段,白花一次检索 |
| 表 3 里 BLEU 提升了多少? | 第一名分数不高,前几名挤在一起 | BM25 能按“BLEU”“Table 3”字面命中,可能救回来 |
| 作者用了哪几个数据集? | 命中了一段,但重排后换了第一名 | 新候选可能把原来命中的段落挤出前 10,反而帮倒忙 |
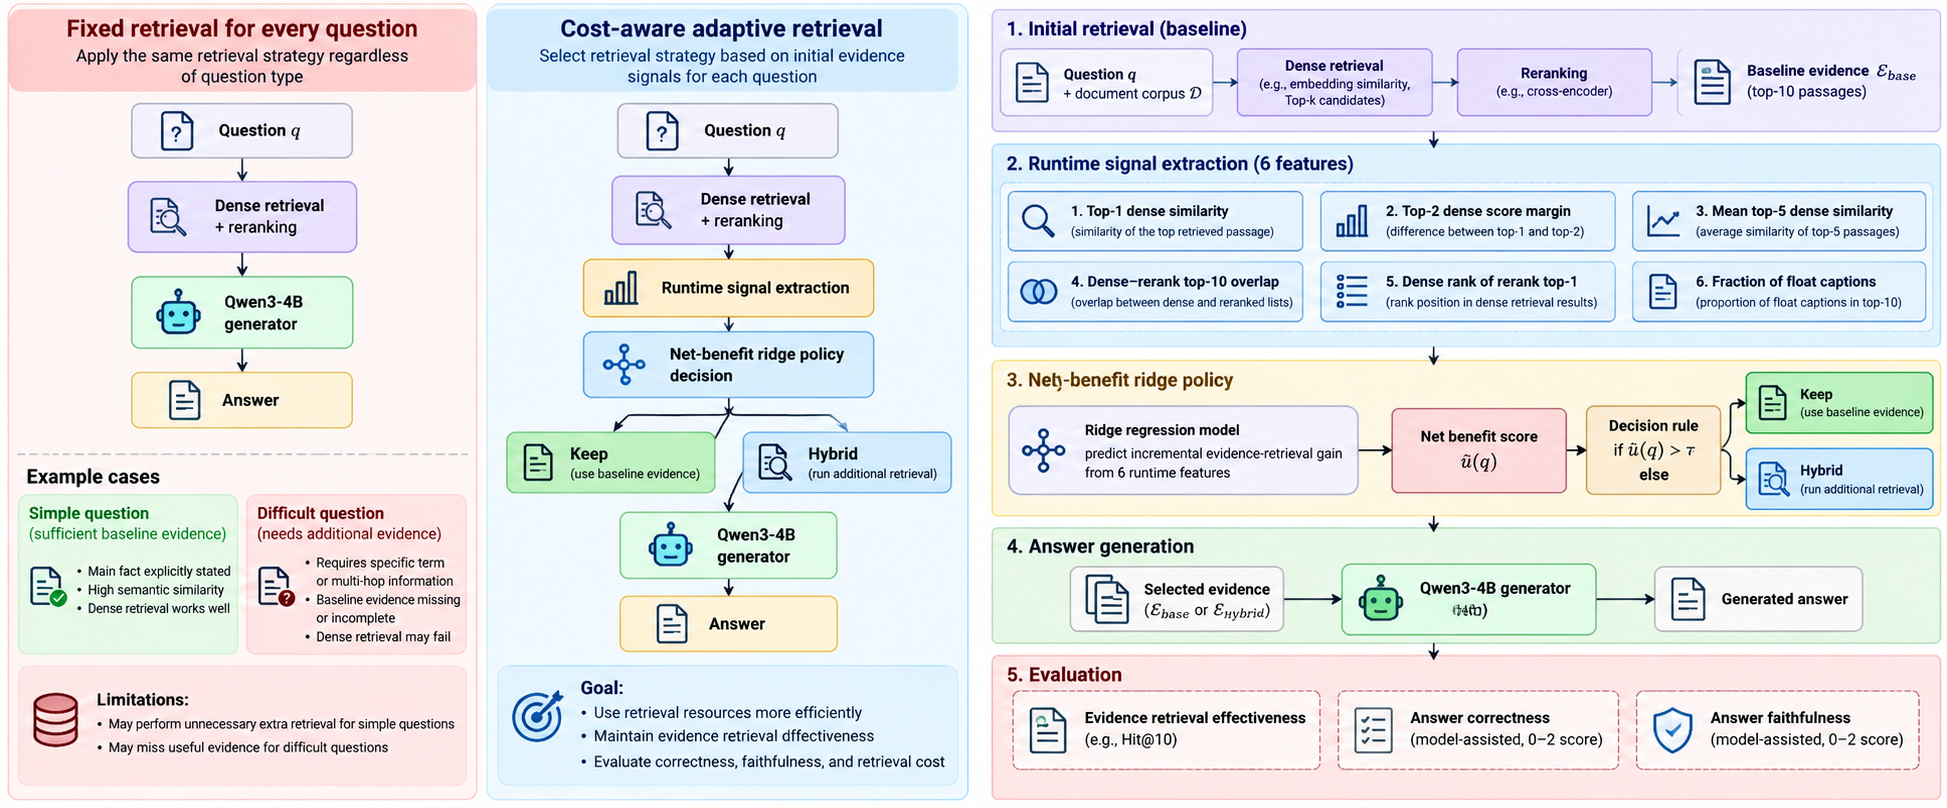
固定策略只有两种选法:每题都只跑向量检索,会漏掉第二类问题;每题都加混合检索,第一类问题白花钱,第三类还可能变差。论文要回答的是:能不能只看基线检索的结果,就猜出哪些问题值得多花这一次检索;如果能,答案会不会因此更好。
整体流程
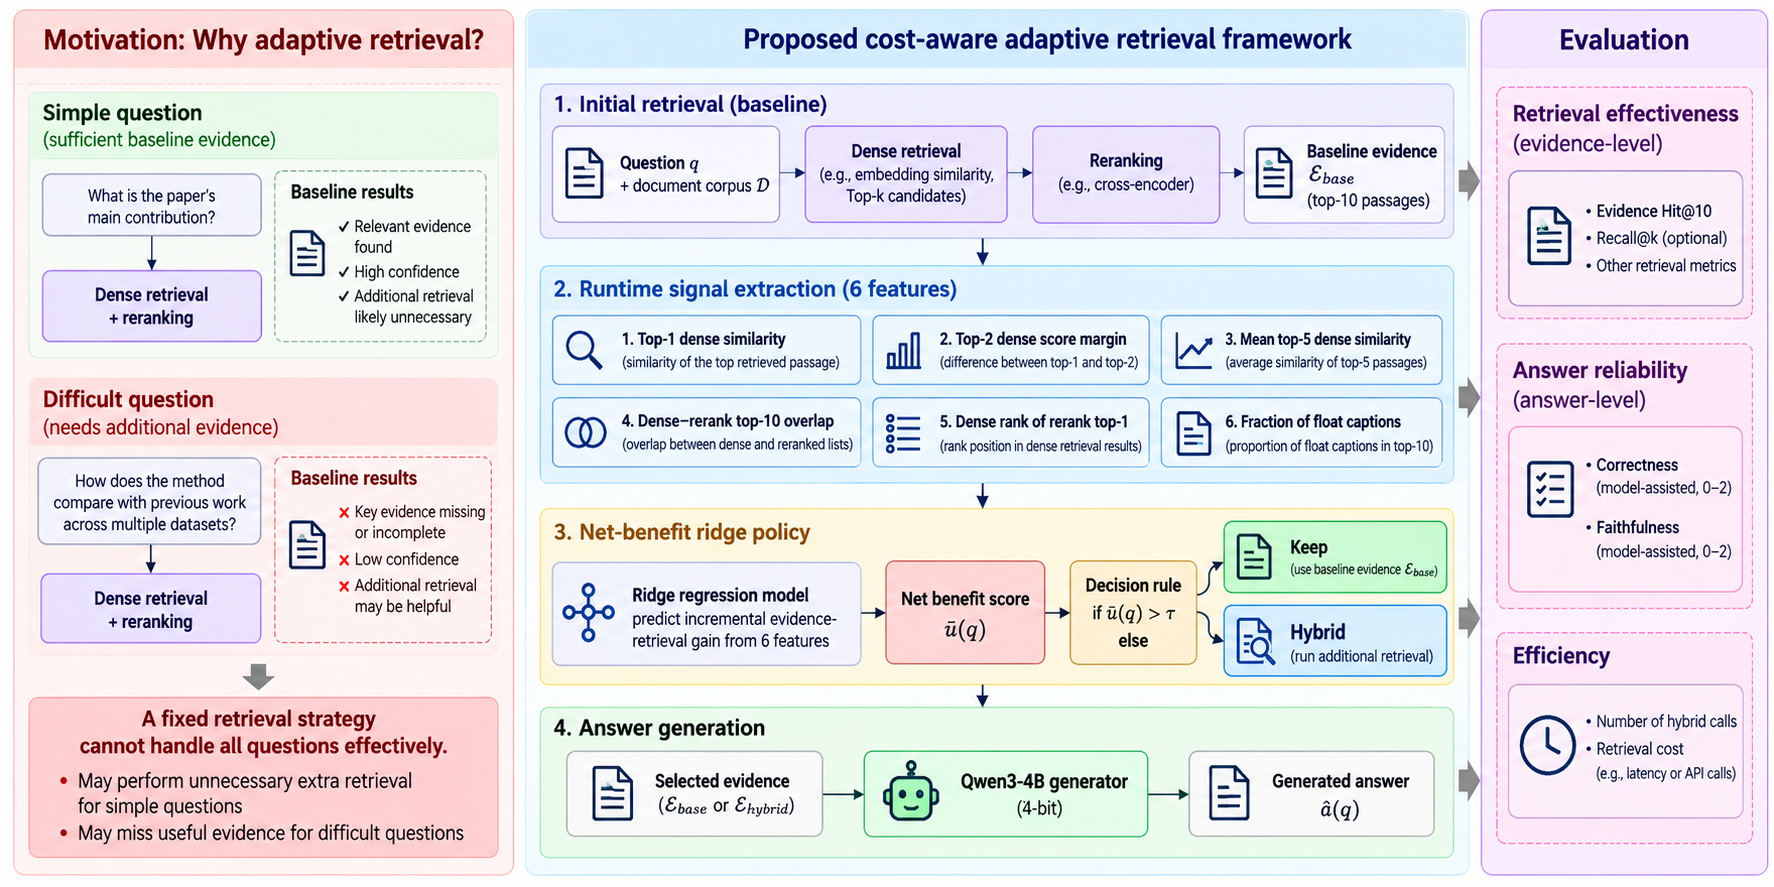
| 步骤 | 做什么 | 产出 |
|---|---|---|
| 1. 基线检索(Keep) | MiniLM 向量检索取前 30,cross-encoder 重排,留前 10 | 基线证据和一串检索分数 |
| 2. 算特征 | 只用第 1 步的分数和名次算 6 个数 | 一个 6 维向量 |
| 3. 预测收益 | 岭回归输出“换成混合检索后命中会变好多少” | 一个预测值 |
| 4. 决策 | 预测值不低于 0.0310 就跑混合检索(Hybrid),否则保留基线证据 | 最终的前 10 条证据 |
| 5. 生成 | Qwen3-4B 读这 10 条证据作答,证据不够就回答 Insufficient evidence. | 答案 |
关键分工是:基线检索每题都跑,模型只决定要不要再多跑一次。下面拆开讲。
两路检索各是什么?
两路都只在提问的那一篇论文里找。论文被切成三种小单元:正文段落、章节标题、图表标题。图表本身的数值拿不到,只有标题文字,这一点后面会影响结果。
Keep 路用 all-MiniLM-L6-v2 把问题和每个单元编码,按余弦相似度取前 30 个,再用 ms-marco 的 MiniLM cross-encoder 重排,留下前 10 个。Hybrid 路多一个 BM25 字面排序,然后用 RRF 把向量排序和 BM25 排序合成一个列表,同样取 30 个候选、用同一个 cross-encoder 重排、留前 10 个。RRF 的常数取常用的 60。
要注意,Hybrid 不是在 Keep 的 10 条后面追加几条,而是另出一份完整的前 10。新进来的候选会挤掉旧的,所以换路既可能救回一题,也可能把原来命中的证据弄丢。
模型到底在预测什么?
训练目标不是“基线检索失败了没有”,而是“换成混合检索,命中情况会变好还是变坏”。对每个问题,先看每一路的前 10 条里有没有至少一条标注过的证据,有记 1,没有记 0;两路相减得到 Δ。Δ 为正是救回,为负是帮倒忙,为零是两路一样。
为什么不直接预测“基线失败”?因为基线失败时混合检索也常常救不回来,基线成功时混合检索还可能把它弄丢。预测差值才对应“值不值得换”。代价是标签极不平衡:开发集 690 个问题里只有 16 个救回、7 个帮倒忙,其余两路都一样,所以模型能学的正例很少。
输入的六个特征全部来自 Keep 路:第一名的向量相似度、第一名和第二名的相似度差、前五名相似度均值、向量排序和重排结果的前十条有多少重合、重排后的第一名在向量排序里排第几(排不进前十就记 11)、Keep 路最终返回的十条证据里图表标题所占的比例。比如第一名相似度低、前几名挤在一起、重排把向量排序很靠后的段落提到第一,都意味着向量检索可能没抓准,换路才可能有用。
模型是标准化后的岭回归,L2 系数取 20。因为特征只来自 Keep 路,Keep 路必须完整跑完才能做决定,这套策略省下的只是多余的 Hybrid 调用,基线检索和重排的成本一分不省。论文没说 Hybrid 路是否复用 Keep 路已经算好的向量排序和重排分数,所以触发一次 Hybrid 到底多花多少,也没法从论文里算出来。 Hoot 说

- 决策前已付:向量检索和重排每题都要跑,因为六个特征就是从它们的结果里算出来的。
- 触发后多付:BM25、RRF 融合和又一次重排。论文没说这一步能否复用左边算好的向量排序和重排分数,所以一次触发实际多花多少,没法从论文里算出来。
左列每个问题都要跑,右列只在预测值过阈值时才跑。右列不是在基线证据后面追加,而是另出一份前 10 条替换它。 出处: 论文 §3(两路检索)、§4(六个特征全部来自 Keep 路,Δ̂ 过阈值才执行 Hybrid)、图 2 图注(离线评测两路都算,上线只需所选的一路)
阈值怎么定,成本怎么算?
作者给每次触发 Hybrid 记一个抽象成本 0.02,策略的效用 = 命中(0 或 1)− 0.02 ×(是否触发)。手算一下(示意):100 个问题里触发 25 次、命中 79 题,效用 = 0.79 − 0.02 × 0.25 = 0.785。
阈值 0.0310 不是直接取 0.02,而是在开发集上扫出来的:开发集按论文分组做交叉验证,得到每个问题的预测值,再挑一个让平均效用最高的阈值,并列时选触发更少的。模型和阈值都在打开留出集标注之前冻结,之后也没有再调。预测值 0.05 的问题会换路,0.01 的问题保留基线(示意)。
0.02 这个成本是一个单位,不是实测的毫秒、token 或钱。作者在文中反复强调这一点。
结果:证据找得省,答案没变好
留出集是 60 篇训练时没见过的论文,188 个问题,其中 169 个的标注证据能对齐到单元上,用来算命中率。
| 策略 | Hit@10 | 触发混合检索 | 效用 |
|---|---|---|---|
| 一律 Keep | 76.92% | 0 / 188 | 0.7692 |
| 一律 Hybrid | 78.70% | 188 / 188 | 0.7670 |
| 冻结后的自适应策略 | 78.70% | 46 / 188 | 0.7819 |
一律 Hybrid 相对基线救回 5 题、弄丢 2 题;自适应策略救回 4 题、弄丢 1 题,净多 3 题,和一律 Hybrid 一样,但少跑了 142 次混合检索。这说明那 6 个分数确实带着“该不该换”的信号,能把大部分无用的触发筛掉。
可这个优势在统计上站不住。按论文为单位做 bootstrap,自适应减一律 Hybrid 的效用差,95% 区间约为 −0.0021 到 0.0328,和基线比的区间同样包含 0。因为 169 题里净差只有 3 题,样本太小,说明不了自适应真的更好。
答案这边分两项打分,满分都是 2 分,所以下表的均分越接近 2 越好。正确性对照 QASPER 的参考答案:答错、没有依据或不该拒答却拒答得零分,部分正确或漏了要点得一分,答对得满分。忠实度只看答案里的说法有没有被生成器当时看到的那十条证据支持:不支持得零分,部分支持得一分,完全支持得满分;直接拒答的答案没有说法可查,不算忠实度。
两项的题数不同。正确性只比三种策略都有分数的题,参考答案之间互相矛盾、还没裁定的题被去掉,剩 181 题;忠实度还要再去掉任一策略拒答的题,剩 128 题。
| 策略 | 正确性(181 题) | 忠实度(128 题) |
|---|---|---|
| 一律 Keep | 1.127 | 1.844 |
| 一律 Hybrid | 1.133 | 1.813 |
| 冻结后的自适应策略 | 1.127 | 1.820 |
自适应和基线的正确性完全一样,差值 0.000,区间约 −0.029 到 0.024;忠实度还略低一点。更值得注意的是,人工辅助复核之前,只用模型裁判打出来的分数显示自适应有一点正向优势,复核后就没了。这说明这么小的差距,换一种判法结论就会翻。
为什么证据多命中了,答案没跟着变好?论文给了几个原因。Hit@10 只要求前 10 里有一条标注证据,答案可能需要好几条;生成器拿到足够证据也可能答错或拒答;图表标题能命中,但答案要的数值不在标题里。我再补一个量级上的原因:净救回 3 题只占 169 题的不到 2%,就算每一题都从全错变成全对,正确性均分的变化也会淹没在裁判误差里。
我认为它的局限
第一,样本太小。留出集只有 60 篇论文、169 个可评测问题,训练标签里只有 16 个救回和 7 个帮倒忙,岭回归几乎是在一堆 0 上拟合,作者自己也说预测可能识别得很弱。
第二,答案质量的打分不够可靠。裁判和生成器是同一系列的 Qwen 模型,只有一部分经过助手辅助复核,没有独立的人工盲评。复核前后结论从“略有优势”变成“没有差别”,本身就说明打分会左右结论。
第三,成本没有实测。0.02 是抽象单位,论文只记录了 289 个不同 prompt 的总生成时间约 1,814 秒,没有分策略的检索延迟。另外实验是在单篇论文内部检索,而且用的是 QASPER 官方训练集里划出来的部分,没有在官方测试集或第二个数据集上验证。
一个搜索/RAG 团队可以怎么试
- 先离线把两路都跑一遍,统计救回和帮倒忙各占多少。如果救回不到 3%,加不加路由都不重要,先别做。
- 只用基线检索已有的分数做特征,训一个线性模型预测两路命中差,阈值按真实成本扫。这一步要把成本换成实测的延迟或调用费用,而不是抽象单位。
- 上线判断时同时看检索命中率和答案指标。答案指标要有独立的人工抽检,因为这篇论文显示,检索多命中几题,答案分数可能纹丝不动。
- 如果路由主要价值是省钱,就按省下的调用和延迟算账;这篇论文的实验里答案没有变好,所以能不能提升答案质量,要靠自己的答案评测来确认。
结论
检索指标和答案质量是两件事。在这个实验里,路由省下了四分之三的混合检索,但没有带来可确认的答案改善。这篇论文的价值在于用一个规矩的冻结式实验把这件事摆了出来。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。什么时候值得多检索一次,是每个 RAG 系统都要算的账 |
| 方法创新性 | 低。六特征岭回归加阈值,作者也不主张算法新意 |
| 实验证据 | 偏弱。60 篇论文,区间都跨过 0,答案打分没有独立人工验证 |
| 工程成本 | 低。特征来自现有检索分数,模型是线性的 |
| 是否值得尝试 | 值得做离线统计,先看救回比例再决定要不要上路由 |
| 适用场景 | 有多套检索可选、且贵的那套只对少数 query 有用的 RAG 或搜索系统 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…