
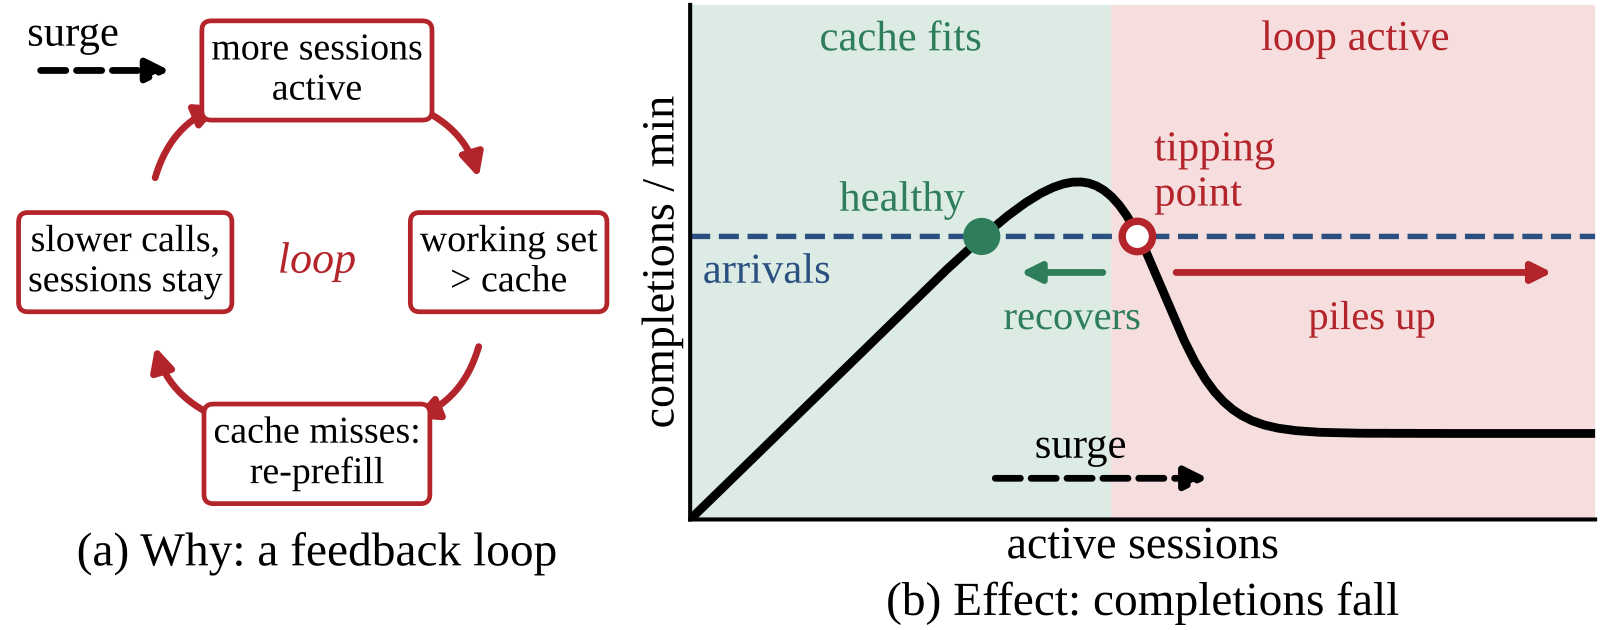
一阵十分钟的流量高峰,就能让 prefill 和 decode 分离部署的 agent 推理服务一直恢复不了。高峰过去、流量回到原来扛得住的水平以后,在 SGLang 上之后一小时的有效吞吐(按时完成的会话数)仍下降约 88%,而且故障前利用率和队列长度几乎看不出征兆。agent 每次调用都要把越来越长的对话重新发给模型,靠前缀缓存省掉重算。背后是一个循环。缓存不够导致重算,调用变慢,会话结束得更晚,同时在线的上下文变多,缓存就更不够。作者据此做了 Basin,它预估每个会话最长会用到多少上下文,按这个量从一个随命中率调整的总额度里预留,额度不够就让新会话先排队。在真实 H200 上,一个不带预测器的简化原型,有效吞吐已是此前最强方案 Continuum 的 1.20 到 1.70 倍。
做 agent 推理服务的团队值得读。这篇论文的主要贡献不是又一个调度器,而是先把一种故障讲清楚:平时的负载并没有超过服务能扛的水平,服务却在一次短暂高峰后卡在坏状态里出不来。作者在真实系统上做干预实验找到原因,用一个简单的模型说明哪些部署容易出事,再按模型的结论设计 Basin。核心思想一句话:别让同时在线的会话把缓存撑爆,宁可让新会话在门口多等一会儿。
它到底在解决什么问题?
先说 agent 的流量长什么样。一个编程 agent 会话会交替做两件事:调用模型,然后跑工具(编译、跑测试、读文件),再把工具结果接到对话后面,发起下一次调用。所以每次调用的 prompt 都包含之前的全部对话。论文回放的 216 条 Terminal-Bench 轨迹里,prompt 中位数 25.6K token,其中 98.2% 的 token 上一次调用已经发过。
这种流量非常依赖前缀缓存。论文说,前缀命中时 prefill 工作量最多能省到 1/50。
问题在于一个会话要跑很多轮,中间跑工具的时候它不占算力,但它的上下文还得留在缓存里,下一轮才能命中。论文把所有在线会话(包括正在跑工具的)的上下文加起来叫工作集。工作集小于缓存时一切正常;一旦超过,缓存开始把别人的前缀挤掉。
用一个示意场景演一遍:
| 时刻(示意) | 在线会话 | 工作集和缓存 | 发生了什么 |
|---|---|---|---|
| 高峰前 | 40 | 工作集小于缓存 | 几乎每次都命中,调用很快 |
| 高峰中 | 110 | 工作集超过缓存 | 前缀被挤掉,回来的调用要重算没缓存的部分 |
| 高峰后 | 仍在增长 | 工作集仍超过缓存 | 调用慢,会话迟迟结束不了,新会话照常进来 |
关键在第三行。到达速率已经回到高峰前,但完成速率被重算拖低了,比到达还慢,在线会话只增不减。这就是分布式系统里说的亚稳态故障:一个短暂的触发把系统推进坏状态,之后有一个自我维持的循环让它待在那里。
真实系统上的证据
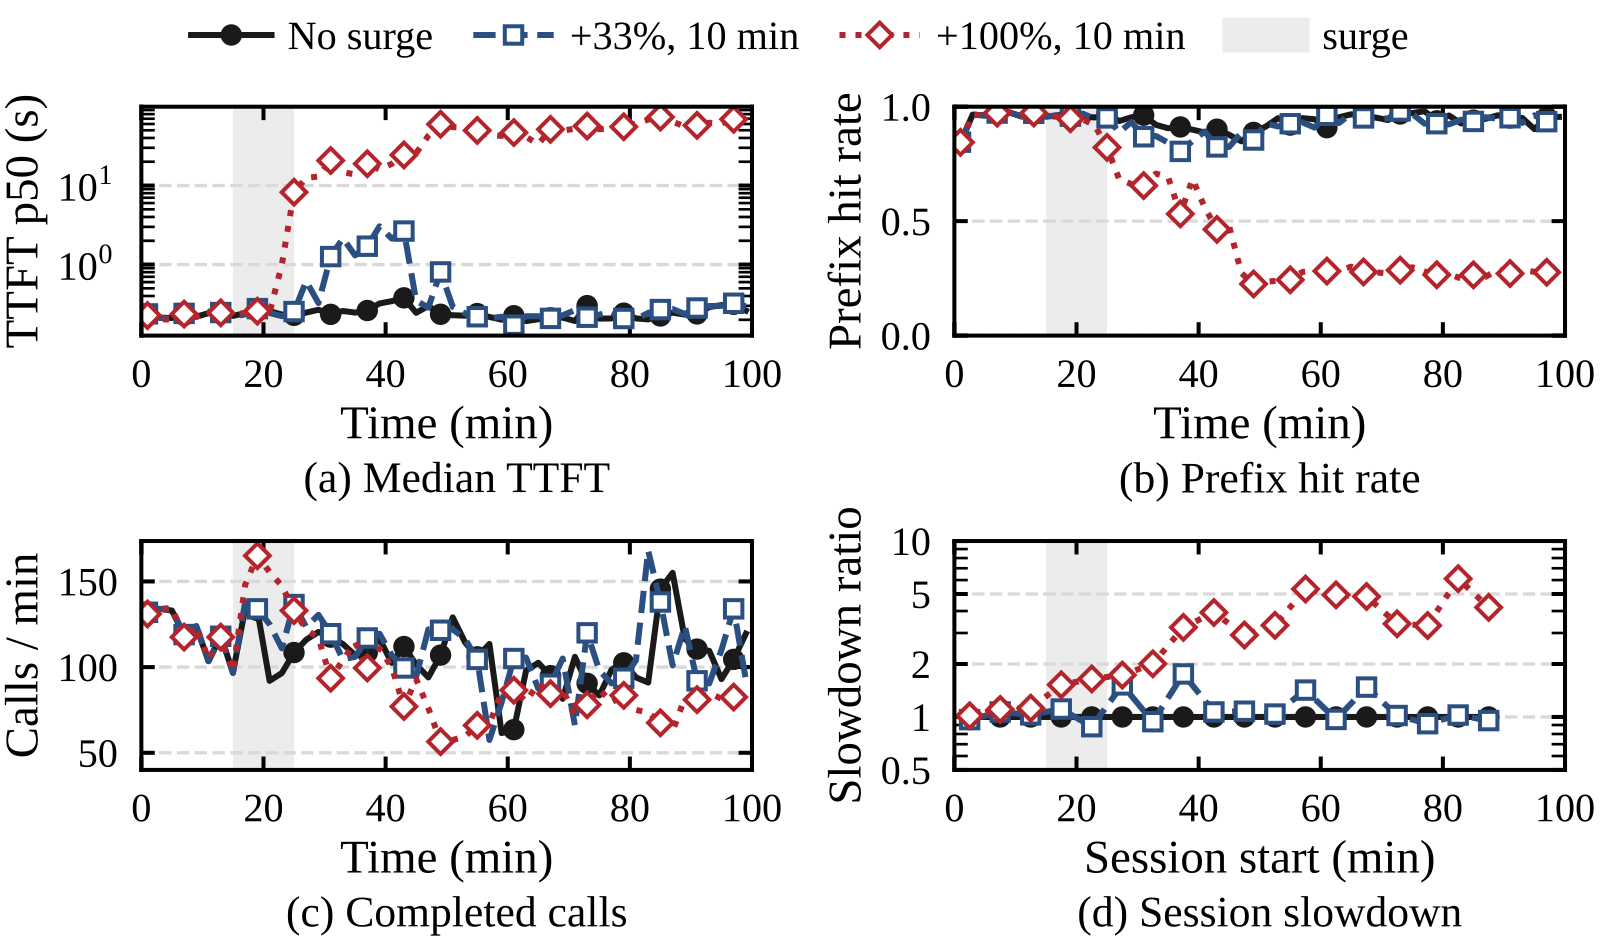
作者在 SGLang 上用一张 H100 做 prefill、一张做 decode,跑 Qwen3.6-35B-A3B,按 3.3 个会话每分钟的速率回放轨迹。没有高峰时,prefill 只用了饱和吞吐的十二分之一,首 token 时间中位数约 0.2 秒,看起来余量很大。
在第 15 到 25 分钟把到达速率翻倍(+100%),之后恢复到 3.3。结果服务再没好起来:首 token 时间中位数涨到约 60 秒,前缀命中率从 0.95 掉到 0.27。高峰之后一小时里到达的会话,按时达标完成的每小时只有 17 个,没有高峰时是 138 个。换成小一点的 +33% 高峰,二十分钟内就恢复了。这说明故障有门槛,过了门槛才会卡住。
怎么证明是"高峰留下的会话"在维持故障?作者做了一个对照干预。在第 15 到 25 分钟按 4 倍速率塞进一批短会话,这些会话在健康的引擎上五分钟内就能跑完。一组让它们自己跑完,另一组在第 25 分钟把它们全部终止。两组的常规到达完全相同。
终止那一组两分钟内就恢复了。不终止那一组,高峰会话又拖了最多 25 分钟才走完;而且到第 50 分钟,在线的常规会话已经是无高峰时的 1.7 倍。也就是说,高峰会话走光以后,故障还在,因为常规会话已经被拖慢、积压起来,接着维持这个循环。
为什么利用率指标看不出来?
常见的扩容和过载控制看 GPU 利用率、队列长度、KV 占用。论文指出,故障前这些指标都显示余量很大。原因是跑工具的会话不占算力、也不在 decode 里占 KV,但它们的上下文仍在争缓存。所以真正该看的量是工作集和命中率,而不是"现在有多少请求在算"。
作者用一个流体模型把这件事写成公式。它把在线会话数 N 当成一个连续变化的量:
是会话到达速率, 是在线会话为 N 时每秒完成的调用数,K 是一个会话平均调用几次,所以 就是会话完成速率。会话少时,完成速率随 N 上升;在缓存先于 decode 成为瓶颈的部署里,工作集超过缓存后,每次调用要重算的部分变多,prefill 跟不上,完成速率反而下降。这条先升后降的曲线和一条水平的到达速率线交于两点,就是图 1 里的绿点和红圈。
模型还给出一个判断条件。在线会话增多时,会先后碰到两个上限。一个是缓存拐点:在线会话的上下文总量超过缓存容量约 1.9 倍时,命中率开始崩。另一个是 decode 显存被占满。占用它的除了正在生成的请求,还有等 prefill 的请求,因为 SGLang 在 prefill 开始前就为它们预留了 decode 显存。论文把这两个上限都换算成在线会话数。缓存拐点对应的会话数,约等于缓存容量的 1.9 倍除以每个会话的平均上下文。decode 显存对应的会话数,等于 decode 的 KV 容量除以每个会话的平均上下文,再除以正在被服务的会话所占的比例,因为在跑工具的会话不占 decode 显存。两个数哪个更小,哪个就先限制服务。decode 实例越多、工具时间越长,越容易缓存先到,也就越容易出这种故障。在 36 个模拟部署里,模型把 17 个"缓存先到"的部署全部标了出来,也把 19 个"decode 先到"的部署里的 8 个误标了,总体判对 78%。
模拟还显示一个反直觉的现象:缓存一旦崩过,恢复时命中率回不去。在带主机缓存层的 1P3D 模拟里(1 个 prefill 实例、3 个 decode 实例),工作集同为缓存容量的 1.6 到 1.7 倍时,没崩过的运行命中率 0.81 到 0.93,崩过的只有 0.26 到 0.37。原因是被挤掉的前缀要重新算一遍才能再次被复用,论文叫它缓存滞后。另一组模拟固定高峰结束时的状态,只改之后的到达速率。这里的参考速率是该部署不加高峰时开始过载的到达速率,高峰前的到达是它的一半。+300% 高峰之后,只用 GPU 缓存的部署在到达降到参考速率的一成时全部恢复,两成时全部卡住。带主机缓存层的部署在两成时全部恢复,回到高峰前的五成则全部卡住。这说明恢复要把到达压到远低于高峰前的水平。
Basin 怎么做
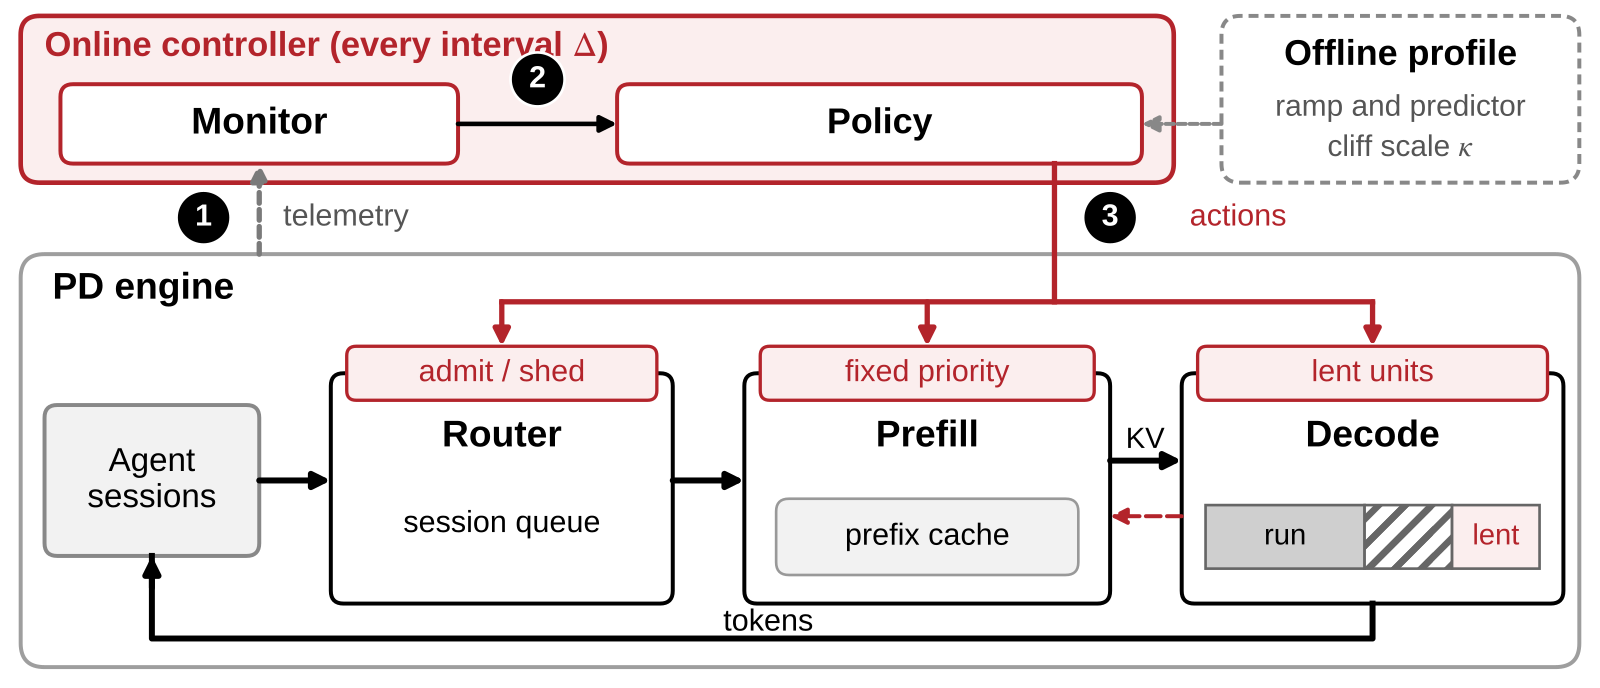
Basin 在 SGLang 的路由前面加了一个会话网关,用三种手段对付这个循环。
为什么要按预估峰值准入?
论文的模型说明,先服务已在线的会话,本身就能放慢新会话进入的速度、保住命中率,代价是新会话在外面排起很长的队。Basin 再加一道显式准入,直接按预估需求约束在线会话的总量。Basin 在会话第一次调用时,根据任务文本和第一个 prompt 的长度,预估它整个过程中上下文最长会到多少。预测器是离线拟合的岭回归,输入是任务文本的 TF-IDF 特征,以及任务文本和第一个 prompt 各自的长度。工作集超过参考额度时准入启动。启动后,一个新会话要进来,所有在线会话的预估峰值加上它自己的不能超过总额度,超过了就在网关排队等。已经进来的会话会一直跑完;如果一个在线会话都没有,排在最前的会话即使超额也会放进来,保证服务有进展。示意:额度 100 万 token,在线会话的预估峰值合计 95 万,一个预估 8 万的新会话就要等,直到有会话结束、释放出额度。总额度有一个参考值,取两者中较小的一个:离线测出的缓存拐点打九折,以及缓存的实际容量。测拐点时,Basin 一级一级加负载,记下命中率从高而平稳的一段掉到低位的位置。上线后,额度只在参考值附近小幅浮动:有会话在排队、命中率仍在测出的那段高位上,就略微放宽;命中率跌出那段高位,就收紧。收紧时,已经在线的会话照常跑完。 Hoot 说

示意:额度、各会话的预估峰值都是编的整数,单位万 token。论文在模拟里评估这套按峰值的准入;硬件原型按当前上下文准入。 出处: 论文 §6(准入:在线会话预估峰值之和加上队首会话的预估峰值不超过额度 B 才放行;无在线会话时队首可超额进入);数字全部为示意,与正文示意一致。
固定优先级:谁先被服务
每个会话进来时拿到一个优先级 。 是到达时间, 是预估峰值上下文,r 把 token 数换算成秒(论文取 30 token/秒)。数值小的先服务,所以小会话能适度插队,但晚到太久的会话插不到早到的前面。这个值从进来到结束都不变,准入队列、prefill 队列和 decode 显存队列都按它排。固定不变的好处是会话等待或上下文变长时,服务顺序不会被反复打乱。
借 decode 的空闲显存当缓存
这一招的作用是抬高完成速率曲线的峰值。一次调用的 KV 本来就要从 prefill 传到 decode,调用结束后,decode 实例把这份 KV 留下来。下一轮调用时,如果这份留存比 prefill 本地缓存覆盖的前缀更长,就把缺的部分按层写回 prefill,边传边算。decode 自己要用显存时先收回借出去的页,借出量最多占 decode 显存的一半。
容量真不够时丢掉一部分
如果长期平均到达速率超过离线测出的峰值完成速率,排在最前的会话又等了 15 分钟,Basin 就丢掉优先级最低的一个排队会话。这是承认容量真的不够,只能拒掉一部分。
实验结果
评估指标是有效吞吐:每小时完成的会话数,只算总耗时不超过无负载时 4 倍、且至少 95% 的 decode 步满足 50 毫秒逐 token 延迟目标的会话。被拒和被丢的会话算失败。
真实硬件用一台 4 卡 H200,1 卡 prefill、3 卡 decode。需要注意,硬件原型实现了按到达时间排序、按当前上下文准入、借显存和丢弃,没有峰值预测器和按大小排序;完整版本只在模拟器里评估。
| 设置(H200,1P3D) | Basin 相对 Continuum | Basin 相对只用 HiCache |
|---|---|---|
| 真实硬件,四个高峰场景 | 1.20 到 1.70 倍 | 2.35 到 3.59 倍 |
| 模拟,三个缓存先到的场景 | 1.33 到 2.05 倍 | 3.13 到 4.17 倍 |
真实硬件上,只用 HiCache(SGLang 的分层缓存,用主机内存扩容)在四个场景里全部卡住,只完成 28% 到 54% 的会话,Terminal-Bench 上命中率从 0.97 掉到 0.33 左右。这说明光加一层主机内存缓存挡不住这个循环。
Continuum 按会话排序并在工具调用间保留 KV,它没卡住,但命中率比高峰前低 10 到 15 个点,新会话要等 3 到 6 分钟才开始。在这三个 Terminal-Bench 场景里,Basin 的首次调用等待中位数最多 18 秒。这是 Basin 几个部件合起来的效果,不能单独记在准入上。差距最大的是只有 GPU 缓存的场景,论文把原因归到借显存:那里除了 prefill 显存,只有借来的 decode 显存能当缓存。
SWE-bench Pro 的会话更长,峰值上下文中位数 107K token。在这组上 Basin 每小时完成 126.7 个会话,Continuum 是 106.0 个,Basin 的首次调用等待中位数是 68 秒。
我认为它的局限
第一,硬件和模拟之间有落差。最能体现设计的按峰值预留和按大小排序只在模拟器里评估,硬件原型用的是更简单的版本。预测器本身也不太准:预测和真实峰值的排序相关在 Terminal-Bench 上是 0.64,在 SWE-bench Pro 上是 0.56。
第二,在 decode 先到的部署上,硬件原型几乎没有收益。在一张卡做 prefill、一张卡做 decode 的部署上,decode 先成为瓶颈,Basin 和 Continuum 的有效吞吐分别是 56.7 和 55.3 个会话每小时。这说明缓存不是瓶颈时,借显存和准入帮不上多少忙。模拟里加上按大小排序后,收益回到最强基线的 1.20 到 1.48 倍,但这部分没在硬件上验证过。
第三,模型的判断偏保守。36 个部署里,它把 19 个 decode 先到的部署误标了 8 个,拿它做容量规划会多报风险。
一个推理服务团队可以怎么试
- 先确认风险。离线做一次阶梯加压,记录工作集和命中率,找到命中率从高位掉下去的拐点。再按论文的判断条件,比较缓存拐点和 decode 显存上限哪个先到。
- 加监控。把"所有在线会话的上下文总量"和命中率放进告警,因为利用率和队列长度在故障前看不出问题。
- 先上最便宜的准入。按当前上下文给在线会话设一个总额度,超过就在网关排队,用一次 +100% 的高峰回放看能否恢复。
- 再考虑借 decode 显存。它要改 prefill 到 decode 的 KV 传输和显存分配路径,适合 decode 实例多、缓存先到的部署。
结论与评价
最关键的启发是:agent 推理服务的容量不只看算力,还要看所有在线会话的上下文能不能留在缓存里;一旦留不下,短暂高峰就能把服务推进一个靠它自己走不出来的状态。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。agent 流量越来越依赖前缀缓存,这种故障在常用指标上没有征兆 |
| 方法创新性 | 中上。准入、工作集原理和分层缓存都是老思路,新意在于把亚稳态故障的成因讲清楚,并据此组合 |
| 实验证据 | 较强。有真实系统上的终止干预、36 个部署的模型检验和硬件对比,但完整策略只在模拟中评估 |
| 工程成本 | 中高。网关和准入较简单,借 decode 显存要改传输和分配路径 |
| 是否值得尝试 | 值得。至少先把工作集和命中率加进监控,并用一次高峰回放检查自家部署会不会卡住 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
相关论文RELATED
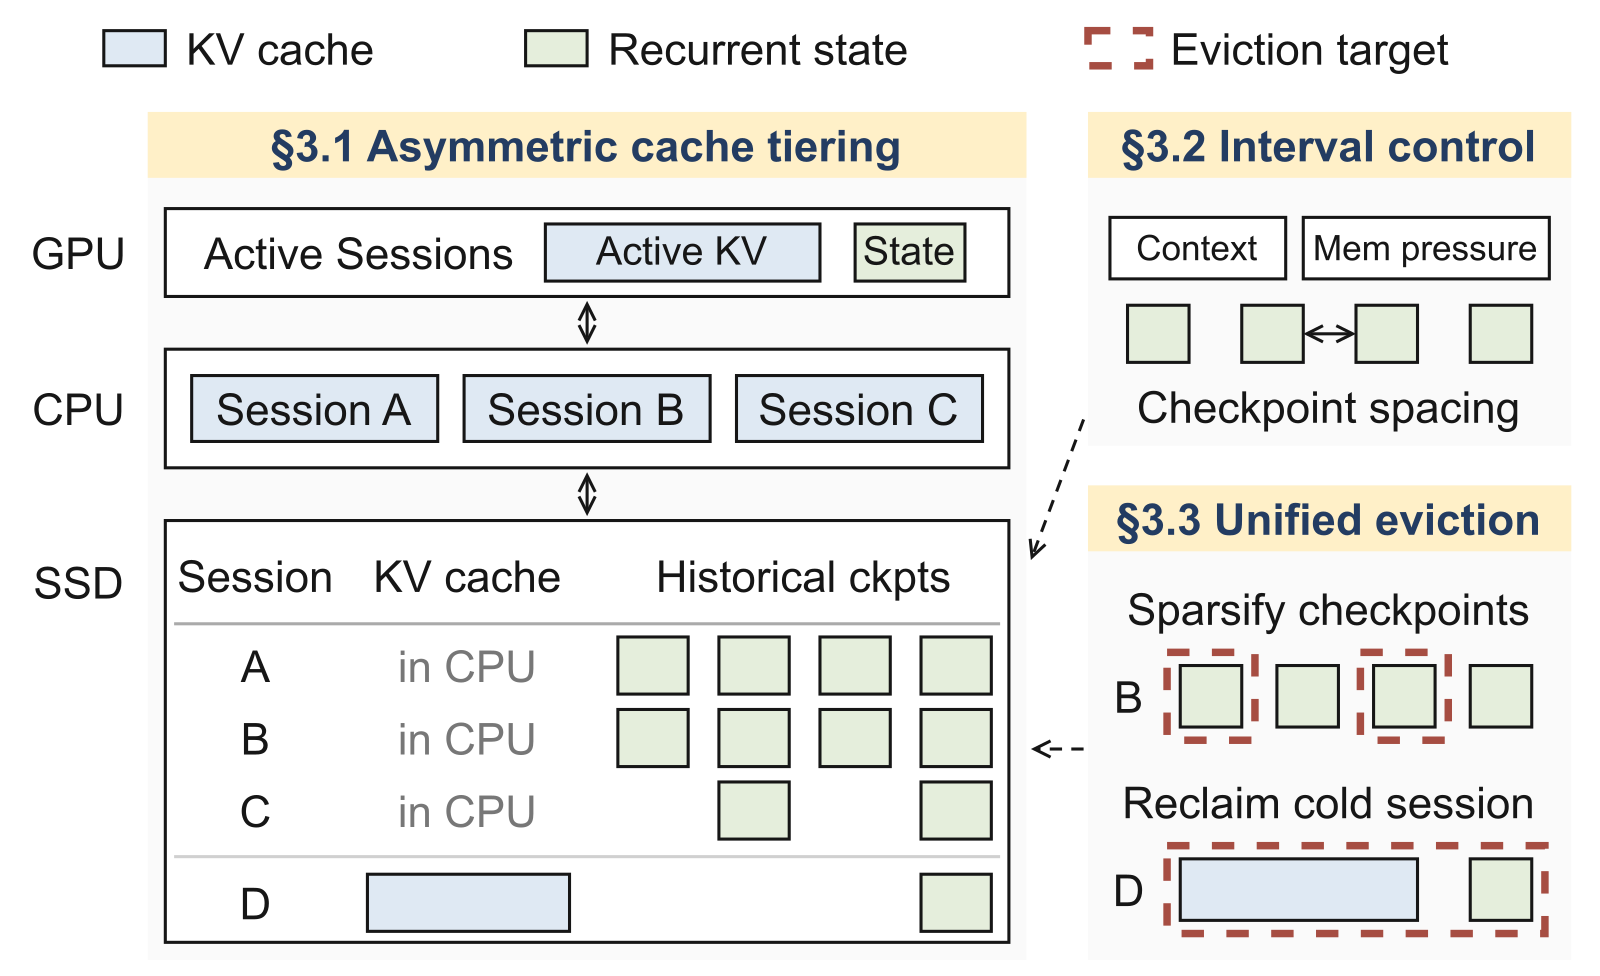 Infra · 2026-11-03HiState: Hierarchical Prefix Cache Management for Hybrid LLM Serving in Agentic Workloads混合模型的循环层会把整段前缀压成一个固定大小的快照,没法截短回更早的位置。所以 KV 明明还在,只要匹配位置的快照没存过或已被淘汰,就要从更早的快照甚至从头重算一大段。HiState 抓住一个不对称:一次缓存命中要读所有匹配的 KV,却只读一个快照,而且快照大小和上下文长度无关。所以它把大量历史快照放到 SSD,把内存留给 KV,并把快照和 KV 放进同一个淘汰队列。队列里每一项的分数是最近访问时间,加上删掉它后要多重算的 token 数除以它能腾出的空间,分数最低的先删。在两份公开的编程 agent 请求记录上,p99 TTFT 相对基于 vLLM 的 Marconi 最多加速 5.73 倍。快照多存不占快内存,每次命中也只从慢存储读一个。
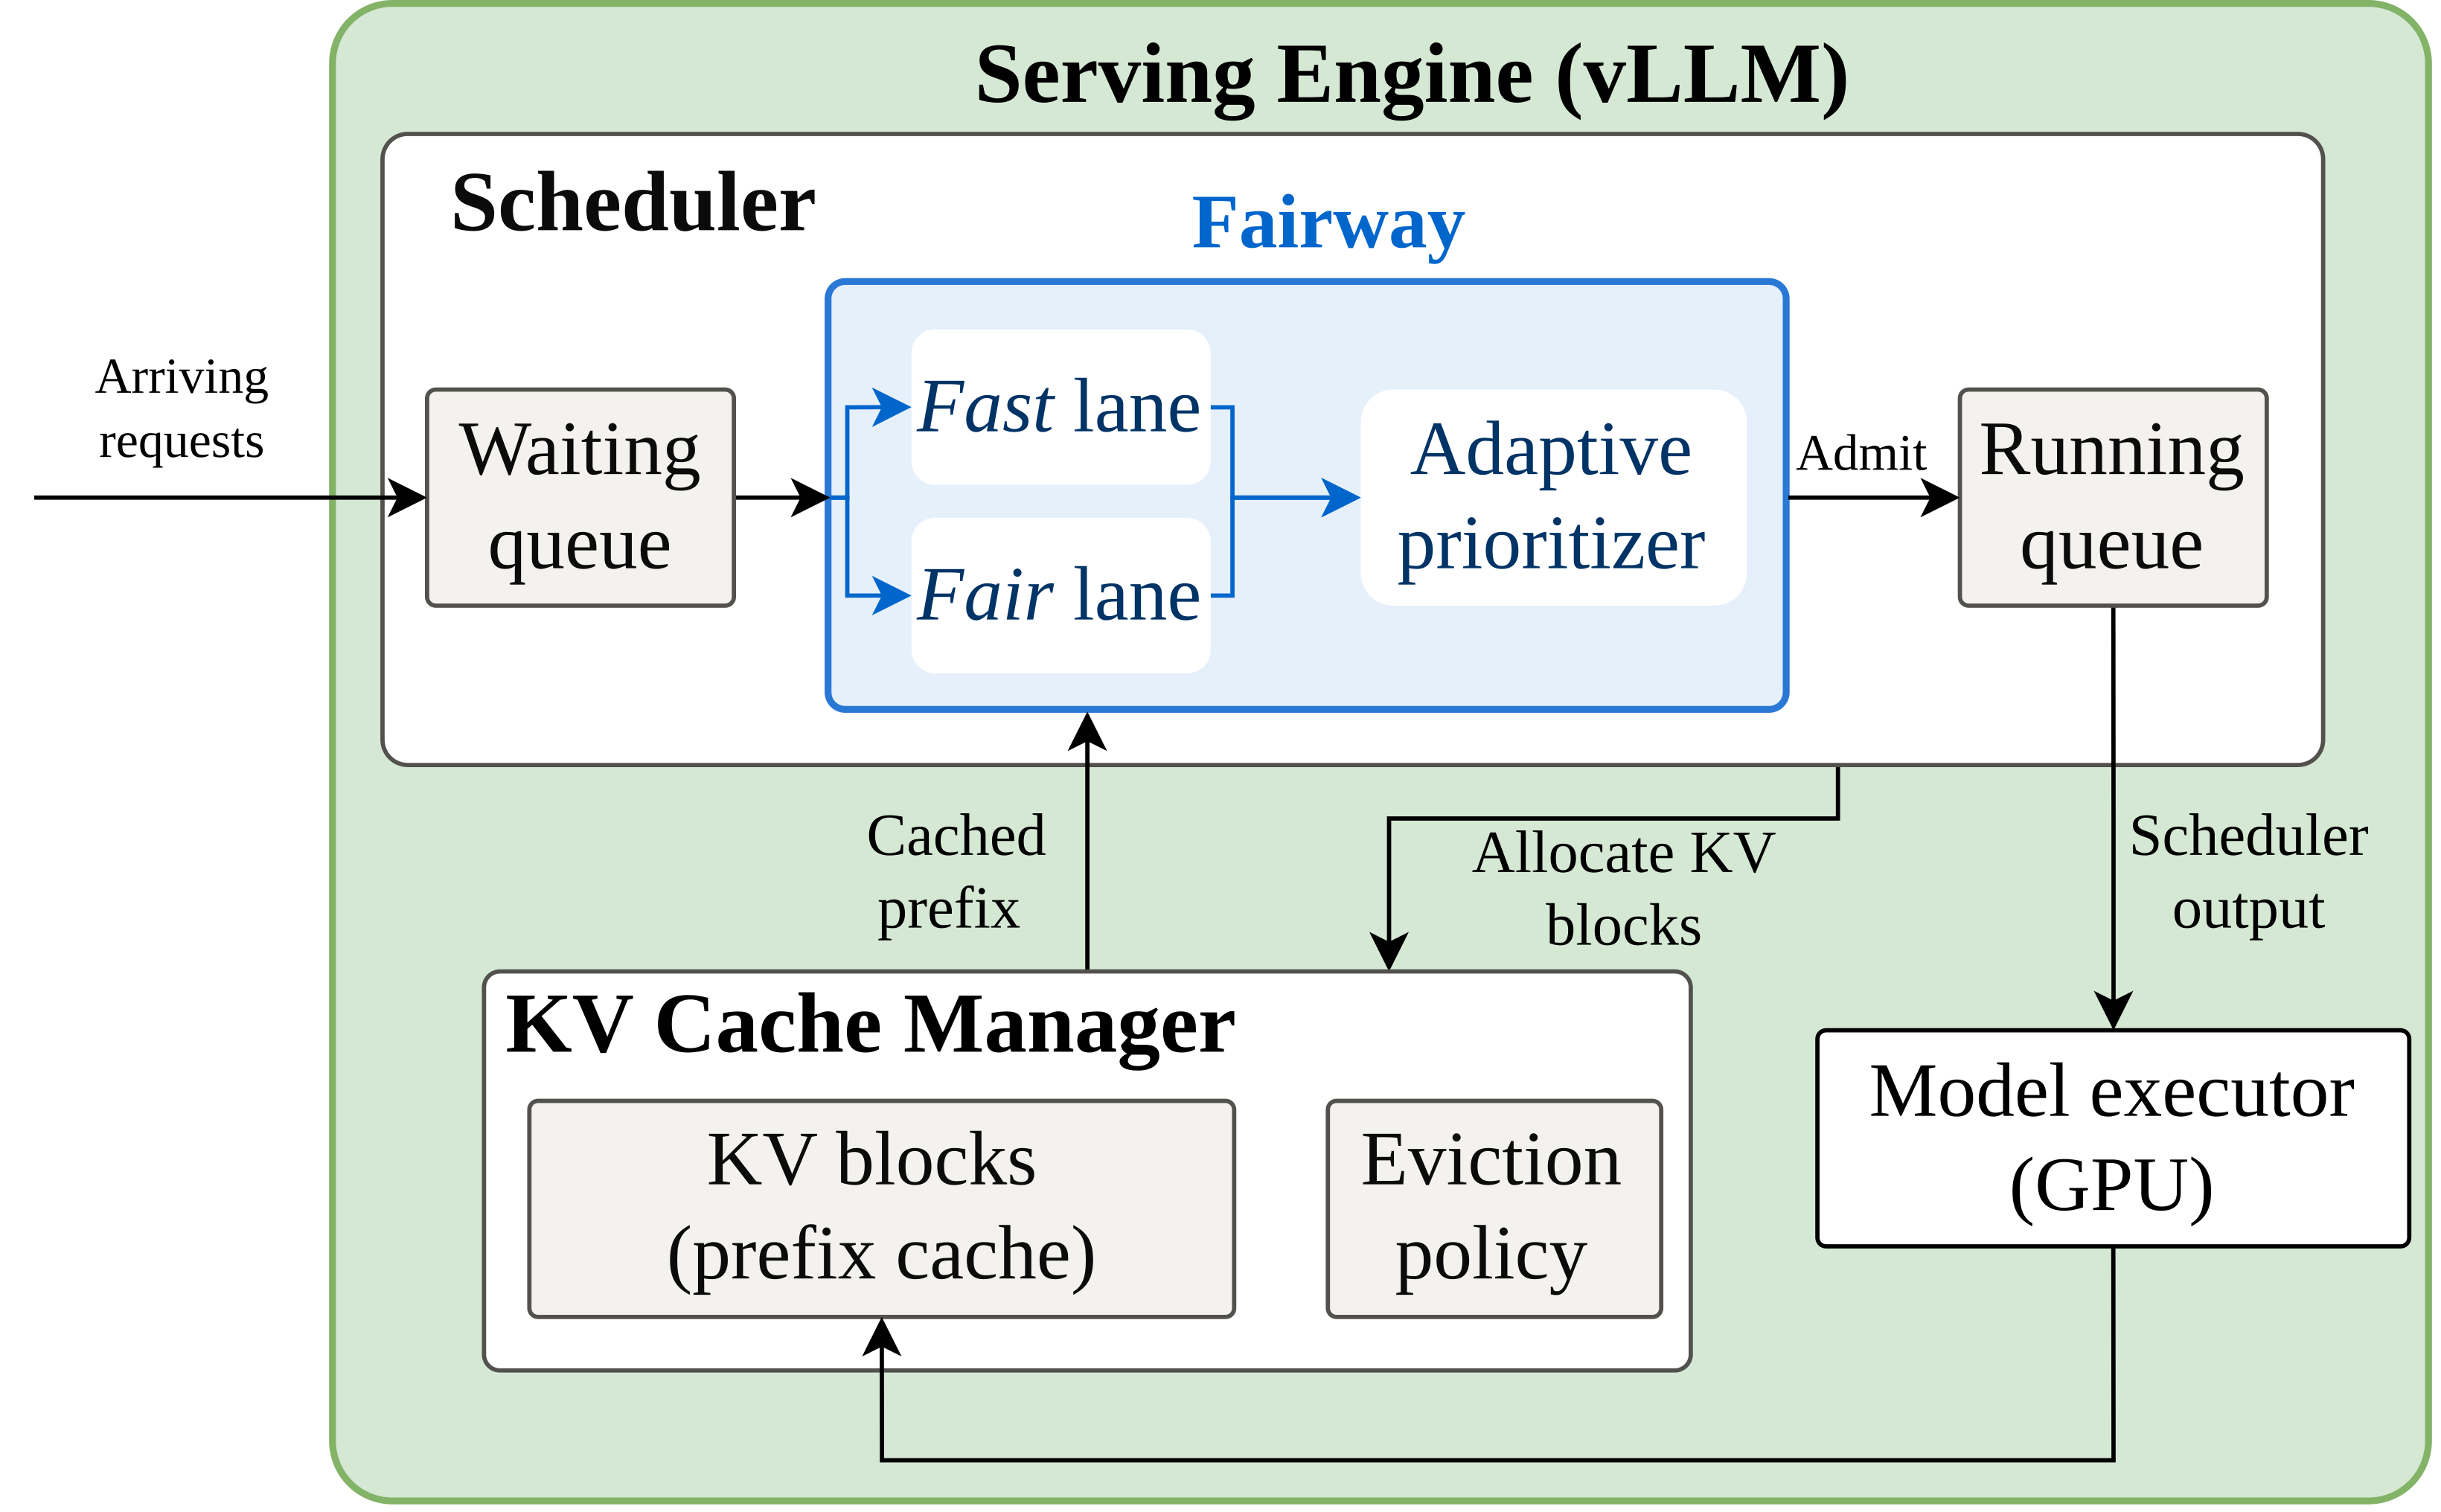 Infra · 2026-11-04Fairway: Load-Aware KV Cache Reuse for LLM Prefill Scheduling前缀缓存下的 prefill 排队,可以同时做到中位延迟低、长尾也短:队列短时优先跑命中多的便宜请求,一个请求等得越久(和它自己的 prefill 时长相比)就排得越靠前,同时限制便宜请求最多能插到最老请求前面多少计算量。这就是 Fairway 的做法。agent 和 RAG 的请求常共用一段前缀,同一队列里各请求剩下的计算量能差上百倍,先跑谁就决定了每个请求等多久才出第一个 token。在流量尖峰里,Fairway 的中位首 token 延迟是 0.82 秒,p99 接近先来先服务;偏向命中的排法 p99 则到了 11 到 50 秒。
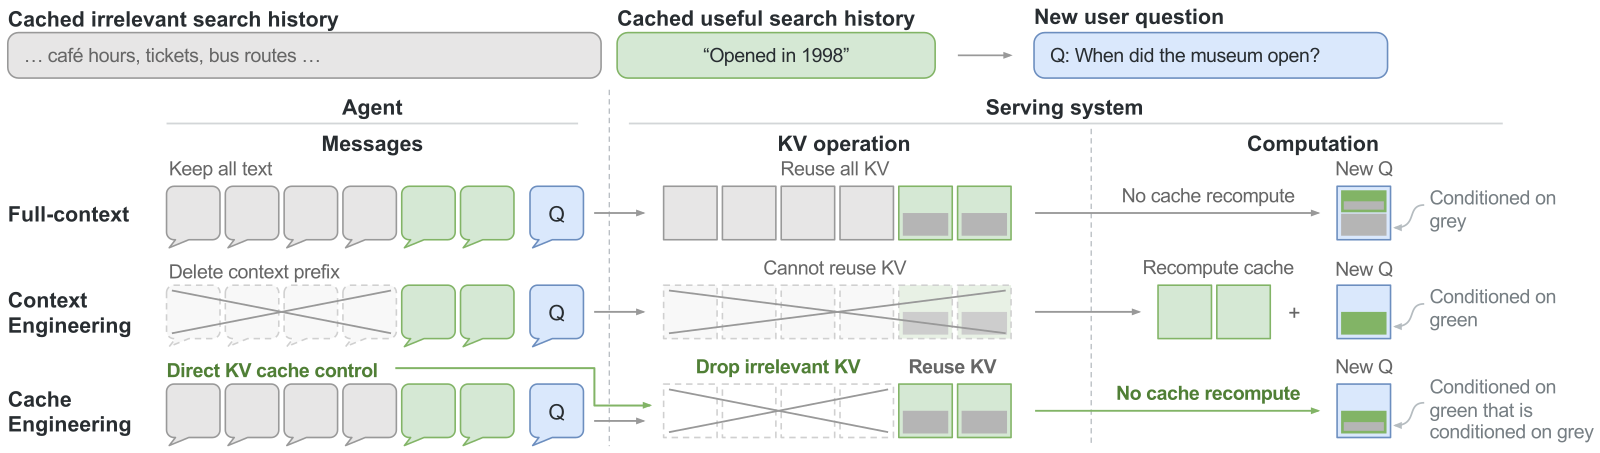 Infra · 2026-10-25Cache Engineering for Agents智能体和搜索、网页、代码执行等工具来回几百轮时,每一轮模型都要把之前所有内容的 KV cache 重新读一遍,读这些旧缓存占了总调用费用的 82.4%。常见的省钱办法是删掉或摘要旧消息,但只要改动了前面的文字,后面所有缓存都作废,得从改动处重新算一遍。作者换个层面来做:文字记录一个字不动,只在缓存里把选中的部分丢掉,留下的部分原样接着用。一个简单的策略只保留最近 12 次工具返回的缓存,和常用的到长度上限就摘要相比,在四个智能体测试上平均通过率高 1.7 个百分点,平均费用低 27.7%。
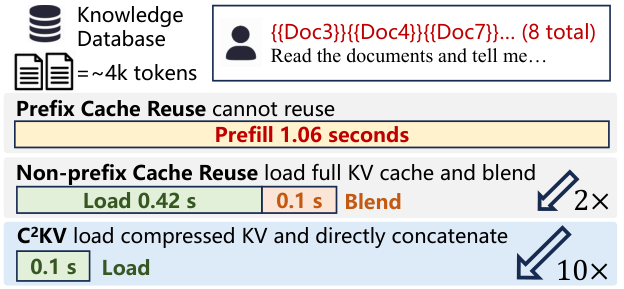 Infra · 2026-07-22C 2 KV: Compressed and Composable KV Cache Reuse for Efficient LLM Inference检索增强生成要把多篇检索到的文档拼进上下文,每次都从头算这些文档的 KV 缓存很贵,于是有方法把每篇文档的 KV 缓存存起来、用时直接拼接。但长文档的 KV 缓存很大,存储和读取本身成了瓶颈,直接压缩后再拼接,准确率又会明显下降。上海交大和阿里巴巴的这篇论文提出 C2KV,在冻结的原模型旁加一个轻量提取器:把几个可学习的压缩 token 接在文档后面一起读,只留下这几个 token 的 KV 当作这篇文档的缓存。缓存存的时候不带位置,拼接时再按新位置补上位置编码,所以能像积木一样任意组合。在长上下文下,推理最多快 17 倍,生成质量基本不变。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…