目录 · 9 节
1它到底在解决什么问题?2怎么知道丢在了哪一步?3宽度怎么重新分配?4实验:挪宽度真的有用吗?5输出完全一样,能省多少时间?6输出变多以后呢?7我认为它的局限8一个推荐团队可以怎么试9结论
做生成式推荐、正在为束搜索的延迟和召回发愁的团队值得读。生成式推荐用束搜索逐位生成 SID,想少漏好结果,通常的做法是把每一步的宽度一起调大。这篇论文在 TIGER 的六组完整测试设置里逐个排查:按模型自己的打分本该进前 10、却被剪掉的结果,全都是在第一步就丢掉的。所以更划算的做法是把宽度集中给第一步,后面几步收窄。模型、SID 和打分都不动,改的只是每一步留多少个前缀。
这样分配后,只用约一半的前缀预算(所有步骤保留的前缀总数),就复现了宽度翻倍的束搜索给出的前 10 名,连顺序都一样:三个 RQ-VAE 数据集的 77,373 个测试用户全部一致,预算从 301 降到 151。同样的预算下,把宽度挪到第一步,模型自己的前 10 名能多找回 0.96 到 10.90 个百分点。解码耗时只降了 6.35% 到 6.39%,因为大部分时间花在每一轮的前向调用和缓存管理上,这部分开销没有变。束宽应该花在最容易丢结果的那一步。要验证这一点,只需离线抽一批用户算一次精确打分,不用动线上服务。
它到底在解决什么问题?
先看前缀是什么。每个商品编成一串 4 个 token 的 SID,例如 <a><b><c><d>。模型看着用户历史,一个 token 一个 token 地往下生成。生成到一半的那段 SID 叫前缀,比如只生成了第一个 token 的 <a>。一个前缀下面挂着一组商品,越靠前的前缀挂的商品越多。前缀一旦在某一步被剪掉,它下面挂的所有商品也就跟着出局了。
麻烦在于,前缀的打分只算到当前这一步。一个前缀第一个 token 的概率不高,但它下面可能有一个后面几个 token 概率都很高的商品,整条 SID 加起来的总分反而最高。束搜索在第一步看不到后面的分数,就可能把它剪掉。下面是一个示意:
| 前缀(示意) | 第一个 token 的对数概率 | 下面最好那个商品后三个 token 的对数概率 | 整条 SID 总分 | 宽度 1 时第一步 |
|---|---|---|---|---|
| A | -1.0 | -3.0 | -4.0 | 保留 |
| B | -2.0 | -0.5 | -2.5 | 剪掉 |
按整条 SID 的总分,B 下面的商品才是第一名;但宽度只有 1 时,第一步只看 -1.0 和 -2.0,B 就被剪掉了。后面几步再宽也救不回来,因为 B 这一支已经不在束里了。
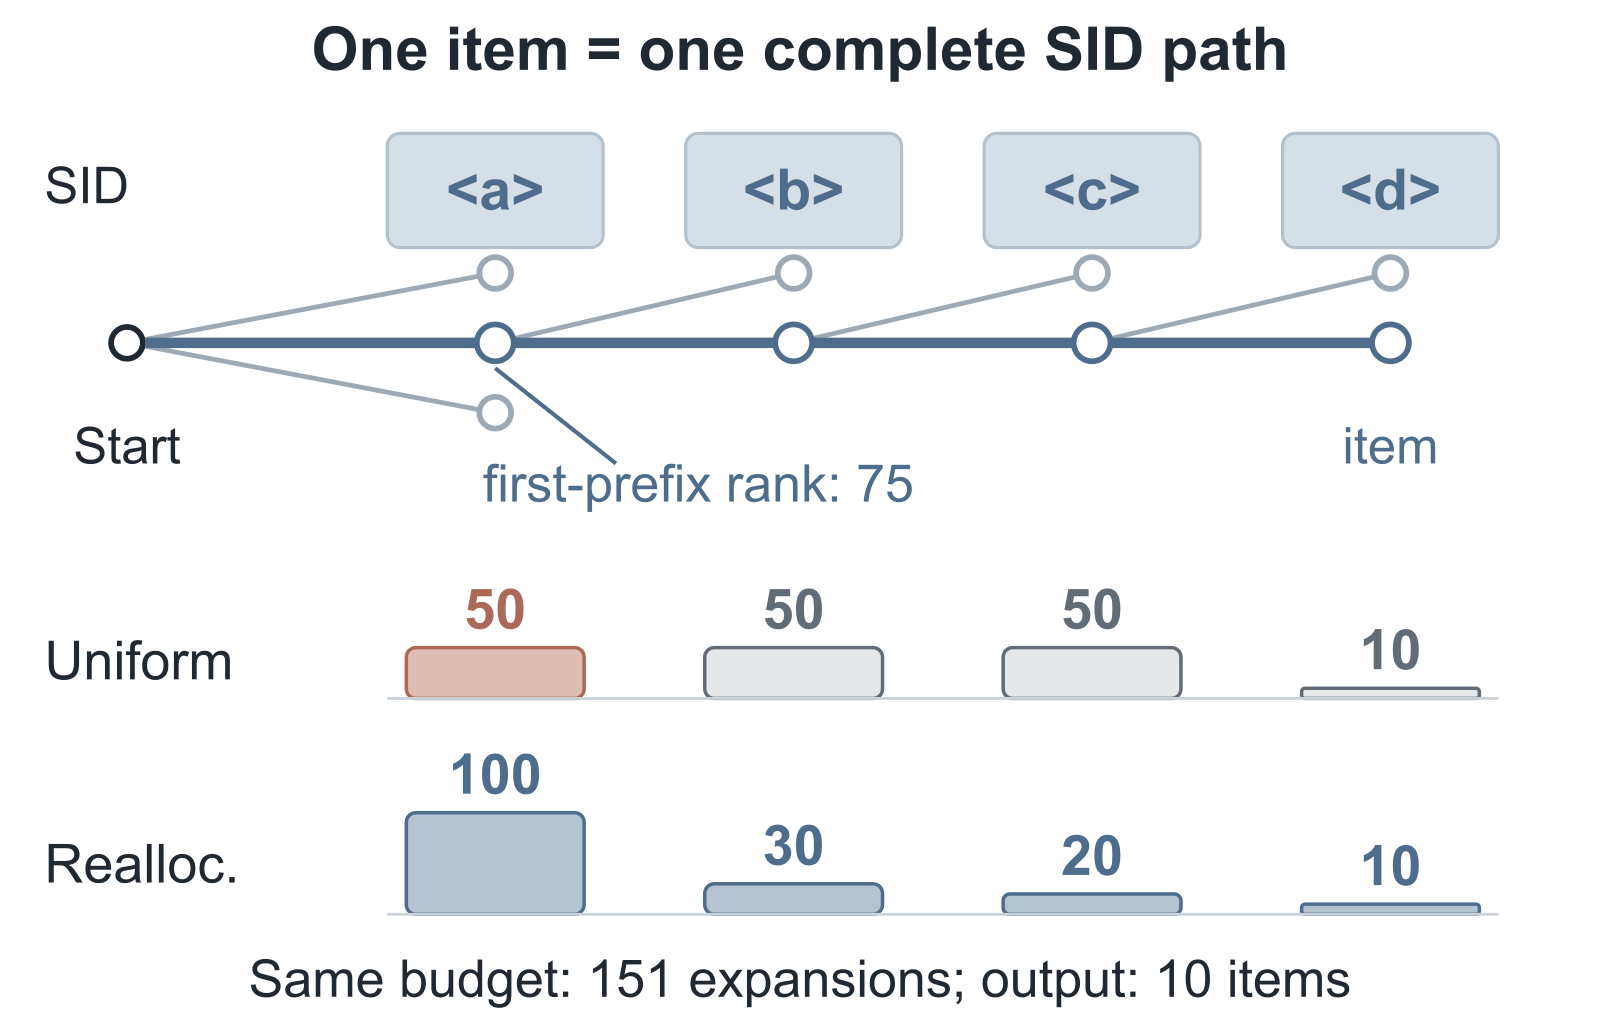
上图就是论文的例子:一个商品的第一个前缀在第一步排第 75 名。每步留 50 个时它被剪掉;第一步留 100 个时它能留下来,而总预算一样。
怎么知道丢在了哪一步?
要找到丢失的位置,先得知道“本该找到什么”。作者做了一个只在离线评测时用的参照。他们让模型给目录里每个商品的完整 SID 都打一遍分,分数是 4 个 token 的对数概率之和。总分最高的 10 个,就是模型自己心目中真正的前 10 名,论文叫精确前 10(exact top-10)。线上推理时没有这个参照,它只用来诊断束搜索漏了什么。
有了参照,就能分出两种错误。用户真实下一次点击的商品没被推荐出来,可能是模型本身打分不准,也可能是束搜索剪掉了。拿精确前 10 来比,就只看搜索造成的损失。作者用一个指标衡量它,叫搜索召回(Search Recall@10):束搜索给出的前 10 里,有几成落在精确前 10 中。
然后对每个被漏掉的精确前 10 商品,查它的 SID 前缀是在第几步第一次掉出束的,论文叫首次剪除深度。下图是 Beauty 数据集、RQ-KM 编码(编码方式见实验一节)、每步留 50 个时的一次结果:
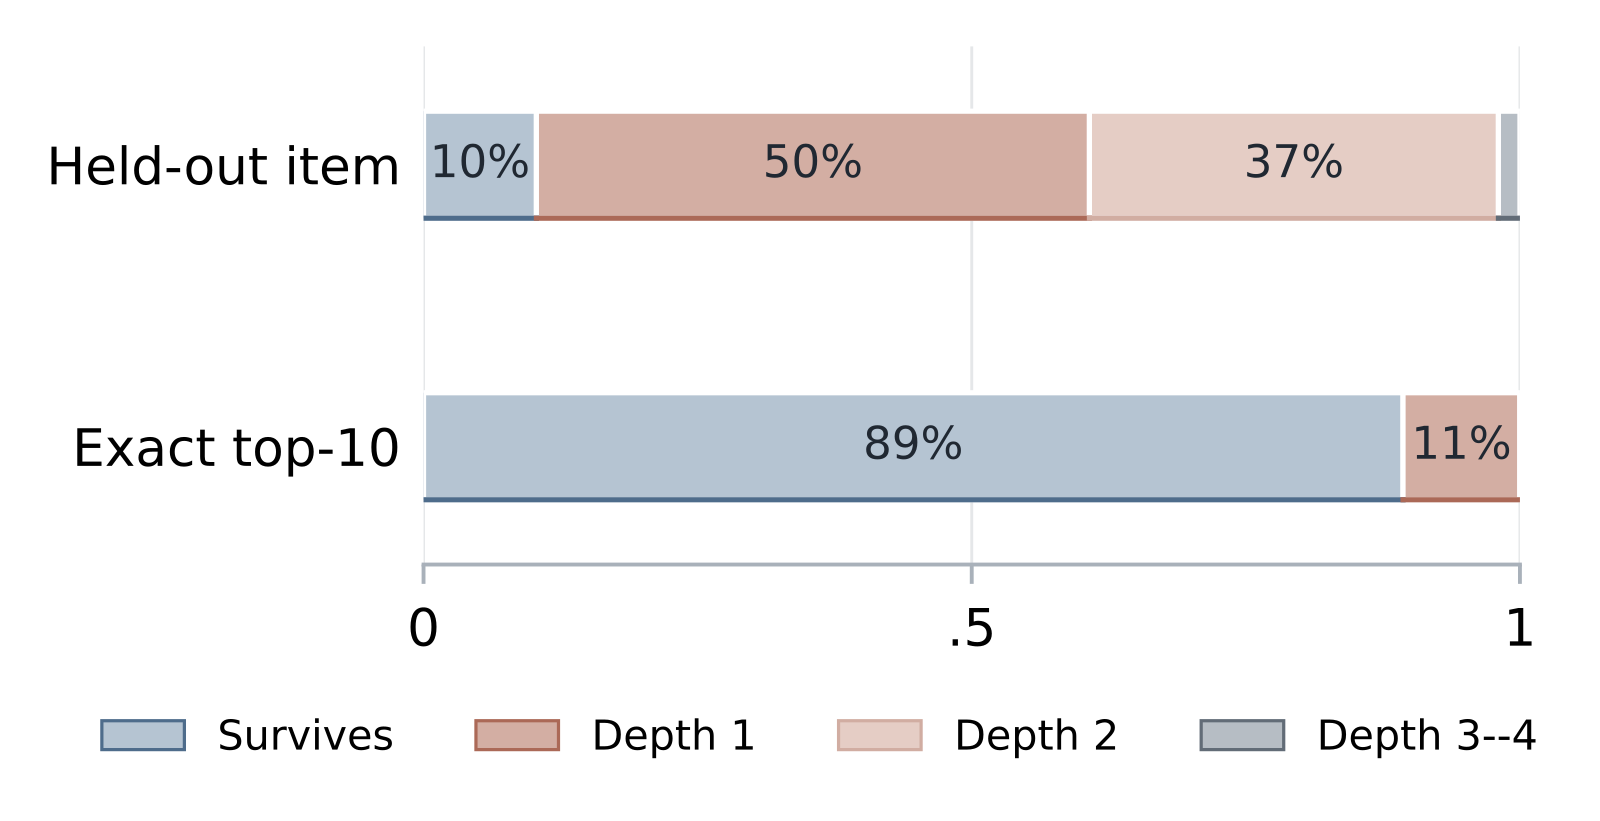
两条对比很能说明问题。用户真实点击的商品,丢失分散在第 1 步和第 2 步,因为里面混着模型本身打分不准的那部分。模型自己的精确前 10,89.34% 留到了最后,被剪掉的全部在第 1 步。作者在三个数据集、两种 SID 构造方式的六组设置里都查了一遍,结论都一样。被剪掉的精确前 10 全部丢在第一步,原因是第一步的前缀下面挂的商品最多,这时还看不到后面 token 的分数。
宽度怎么重新分配?
既然问题在第一步,就把宽度往第一步挪。为了公平比较,作者先定义了前缀预算:除最后一步外,每一步保留的前缀个数加起来,再加上起点的 1 个。最后一步留下的是完整的 SID,不再往下扩展,所以不算。
用论文的配置手算一下。每步留 50 个(记作 Beam-50),预算是 1 + 50 + 50 + 50 = 151。每步留 100 个(Beam-100),预算是 1 + 100 + 100 + 100 = 301,所以宽度翻倍,预算也翻倍。
作者提出的 Front-151 是第一步留 100、第二步 30、第三步 20、最后留 10,预算是 1 + 100 + 30 + 20 = 151。这意味着 Front-151 和 Beam-50 花的预算一样多,只是花在了不同的步骤上。
每一步怎么挑前缀,和普通束搜索一样:把上一步留下的所有前缀各往后接一个 token,只接能对应到真实商品的那些;所有接出来的新前缀放在一起,按截至这一步的累计对数概率排序,取前 b 个,b 就是这一步的宽度。Front-151 改的只是每一步的 b。 Hoot 说

示意数字。每一步把留下的前缀各接一个 token,所有新前缀按累计对数概率放在一起排,取前几名。 出处: 论文 §2.1 式 (2):每一步把留下的前缀各接一个合法 token,按截断到这一步的累计分数取前 b 个;数字为示意
这里的预算是一个计数,不是耗时。它是要扩展的前缀个数的上限:某个分支下面可选的 token 不够多时,实际扩展的会更少。实际耗时后面单独测。整个改动只在解码时生效:模型参数、SID 和每个 token 的打分都不变。
实验:挪宽度真的有用吗?
实验用开源工具包里的 TIGER 实现,数据是 Amazon 的 Beauty、Sports、Toys 三个品类,每个品类各用两种方式构造 SID:残差 K-means(论文记作 RQ-KM)和 RQ-VAE,一共六组。搜索召回和输出是否一致,都在完整测试集上算;耗时只抽了每个模型 512 个用户来测。
第一个问题:同样的预算下,Front-151 能比 Beam-50 多找回多少精确前 10?
| 数据集 / SID 构造 | 测试用户 | Beam-50(预算 151) | Front-151(预算 151) | 提升 | Beam-100(预算 301) |
|---|---|---|---|---|---|
| Beauty / RQ-KM | 22,363 | 0.8934 | 0.9813 | +0.0879 | 0.9814 |
| Sports / RQ-KM | 35,598 | 0.8947 | 0.9882 | +0.0935 | 0.9898 |
| Toys / RQ-KM | 19,412 | 0.9856 | 0.9999 | +0.0143 | 0.9999 |
| Beauty / RQ-VAE | 22,363 | 0.9466 | 0.9950 | +0.0483 | 0.9950 |
| Sports / RQ-VAE | 35,598 | 0.8839 | 0.9929 | +0.1090 | 0.9929 |
| Toys / RQ-VAE | 19,412 | 0.9903 | 0.9999 | +0.0096 | 0.9999 |
六组全部提升,而且 Front-151 基本追平了预算翻倍的 Beam-100。Toys 提升小,是因为 Beam-50 在 Toys 上已经找回了 98% 以上,没什么可补的。
第二个问题:提升真的来自“宽度给了第一步”,而不是别的什么?作者在 Sports / RQ-VAE 上做了对照,预算都是 151,只换宽的那一步的位置。Front-151 是 100、30、20、10,找回 99.29%。把 100 挪到第二步(30、100、20、10)或第三步(30、20、100、10),都只找回 74.92%,差了 24.37 个百分点。这说明光是宽度放在哪一步,就足以造成 24 个百分点的差距:后面的步骤只能在已经留下的分支里挑,挑不回第一步丢掉的分支。
第三个问题:找回的是不是只是第 6 到第 10 名这些边缘结果?作者把同样的比较换成前 5 名,六组仍然全部提升,Sports / RQ-VAE 在前 5 名上提升 6.48 个百分点。也就是说,最靠前的几个推荐也会被第一步剪掉。
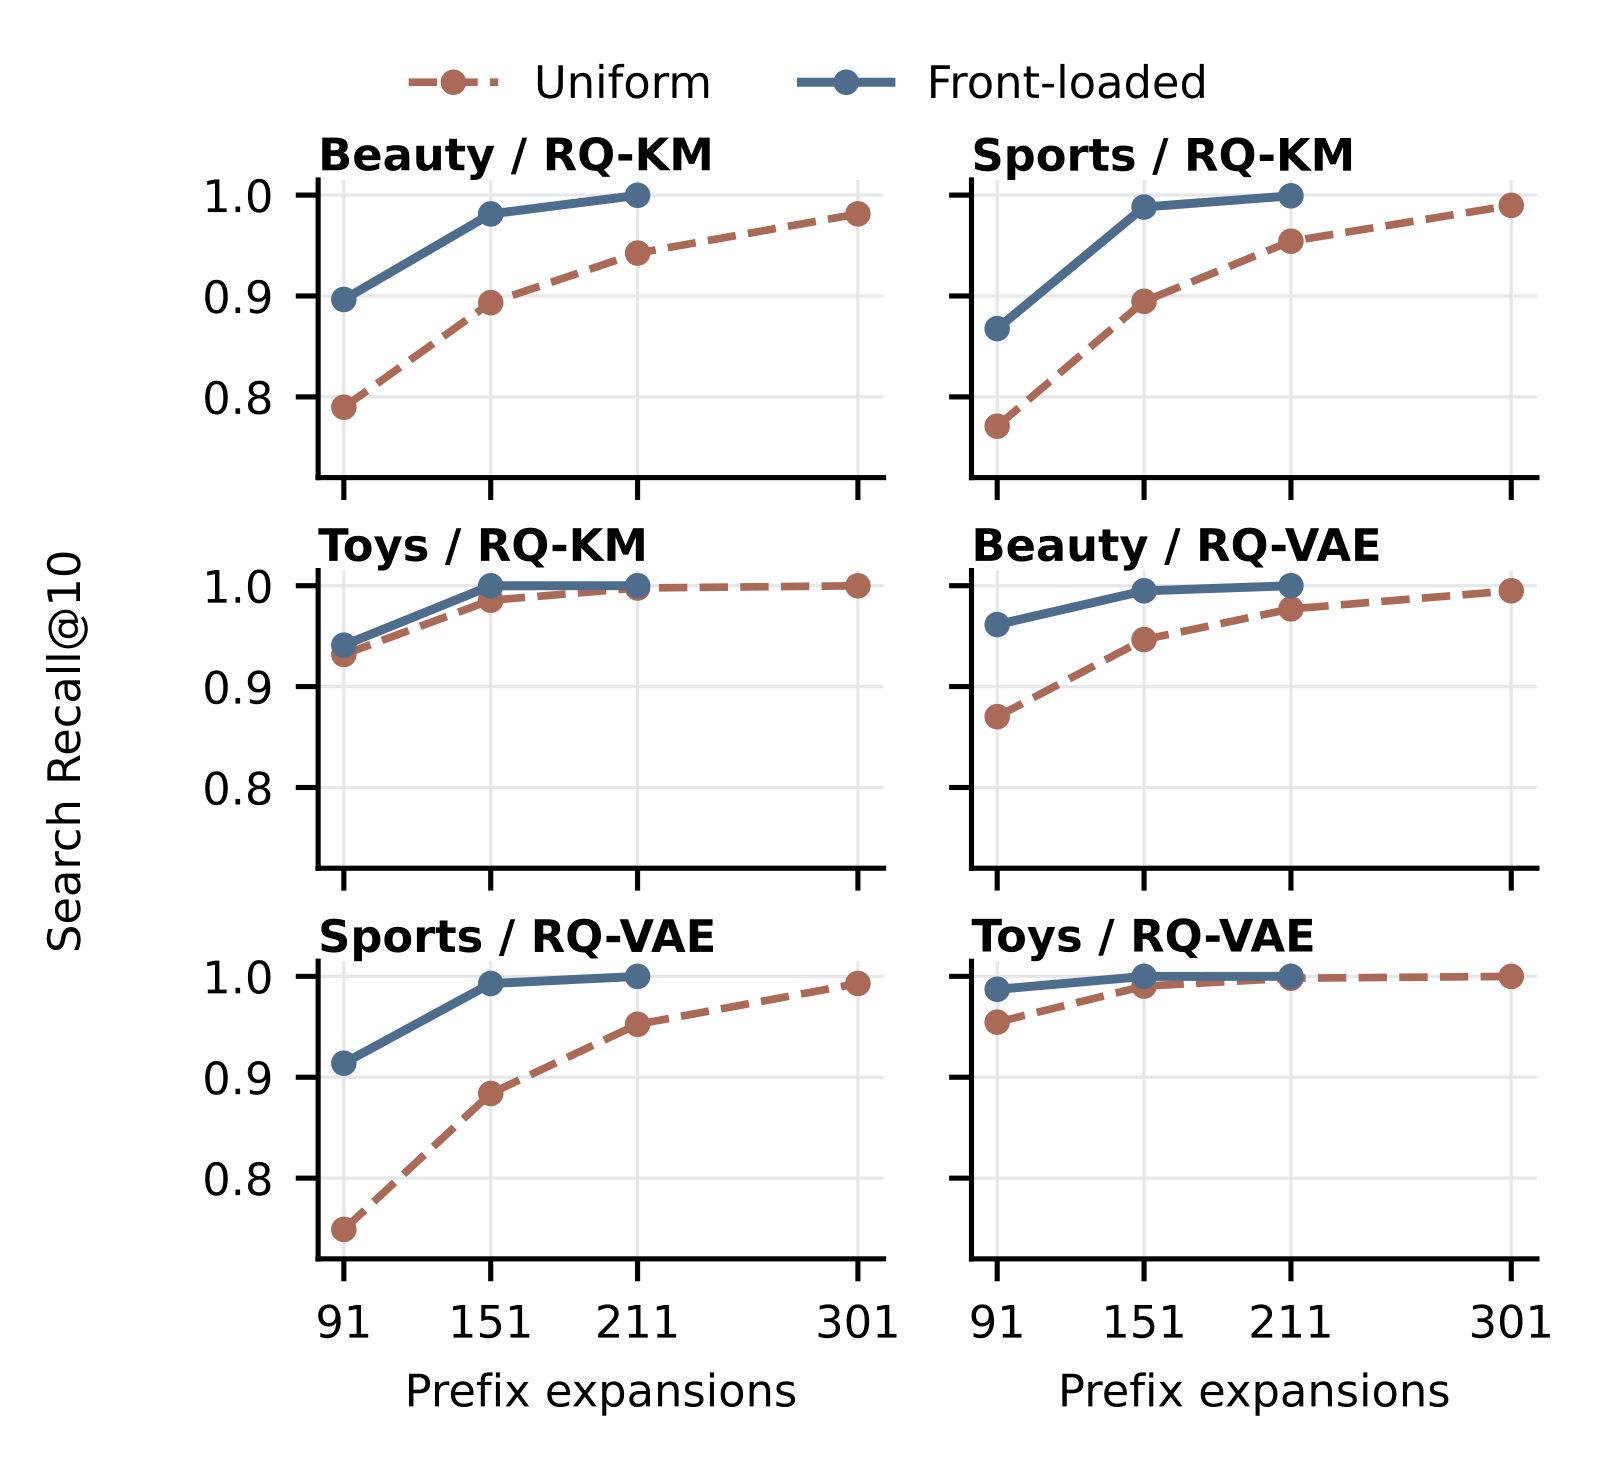
再看不同预算下的表现,如上图。作者又试了一个稍宽的安排 Front-211,第一步留 140 个,后面依次是 40、30、10。它在六组设置里的搜索召回都超过了 Beam-100,预算却少了约 30%。这说明把宽度集中在前面,用更少的预算就能达到均匀加宽的水平。
输出完全一样,能省多少时间?
最有工程价值的结果是这一条:在三个 RQ-VAE 数据集的全部 77,373 个测试用户上,Front-151 和 Beam-100 给出的前 10 名完全相同,顺序也一样。对下游来说,换成 Front-151 拿到的输入和原来没有任何区别,不用重新评估排序效果。
耗时上,作者拿 Front-151 和“每步留 100、最后一步也只留 10”的安排比解码器时间。最后一列来自另一次单独的性能剖析,看的是这个对照安排里前向调用和缓存管理占了多少时间:
| 数据集 / SID 构造 | 每步 100、最后 10 的耗时(ms) | Front-151 耗时(ms) | 节省(%) | 前向和缓存管理占比(%) |
|---|---|---|---|---|
| Beauty / RQ-KM | 16.63 | 15.42 | 6.61 | 79.15 |
| Sports / RQ-KM | 17.68 | 16.21 | 7.00 | 77.83 |
| Toys / RQ-KM | 17.40 | 16.26 | 6.01 | 79.63 |
| Beauty / RQ-VAE | 17.45 | 16.33 | 6.35 | 77.32 |
| Sports / RQ-VAE | 17.41 | 16.27 | 6.39 | 76.78 |
| Toys / RQ-VAE | 17.05 | 15.90 | 6.35 | 78.33 |
输出逐个核对过完全一致的只有三行 RQ-VAE,节省 6.35% 到 6.39%;RQ-KM 三行的输出和对照并不完全一样,比如 Sports / RQ-KM 上 Front-151 的搜索召回是 0.9882,对照是 0.9898,所以这三行只能当耗时参考。
预算减半,耗时却只少约 6%。原因在最后一列:前向调用和缓存管理占了 76.78% 到 79.63% 的时间。论文的剖析显示,后面几步变窄,减少的是候选和挑选的工作;4 轮前向调用,以及每轮的调用和缓存开销都还保留着。这些保留下来的开销,限制了整体能省多少。
搜索找得更全,对真实点击的预测帮助却不大。在 Sports / RQ-VAE 的 35,598 个用户上,前 10 命中用户真实下一次点击的次数,从 Beam-50 的 659 次增加到 Front-151 的 677 次。Recall@10 只从 0.0185 升到 0.0190。这说明复现模型排序和预测准用户行为是两件事:复现排序靠搜索,预测准行为还得靠模型本身。
输出变多以后呢?
前面都是只要前 10 个。作者在每个模型 256 个用户上做了探索性实验,宽度安排是在 Sports 上先试过再定的。看输出变多时会怎样。每步宽度固定 100,在 Sports 上要的结果从 10 个增加到 100 个,搜索召回从约 99% 降到 86%。这说明要的输出多了,后面几步也会开始丢结果,宽度安排得重新调。作者给的调法是:第一步保留全部可能的第一个 token,第二、三步各留输出数的 1.5 倍,最后一步留输出数。要 100 个结果时,拿每步宽 200 的束做对照;要 200 个时,拿每步宽 400 的束做对照。两种情况下,这样安排给出的候选和对照束完全一样。
反过来,如果输出仍是 10 个、只是拿来对照的束更宽,就有很多工作是多余的。作者让第一步保留全部可能的第一个 token,第二、三步各留 20 个,最后留 10 个。这样复现了每步宽 200 到 800 的束给出的前 10 名,比宽 200 的束省 10.59% 到 11.89% 的时间,比宽 800 的省约一半。省得多,是因为多出来的宽度对输出没有任何影响。
我认为它的局限
第一,宽度安排是在 Beauty 的测试集上摸索出来的,再固定下来用到 Sports 和 Toys。Beauty 的结果有在测试集上调参的成分,Sports 和 Toys 的结果更可信,好在后两者同样有效。
第二,实验规模和线上差得远。三个品类的目录只有 11,924 到 18,357 个商品,模型是 TIGER。目录到千万级、SID 结构更深时,丢失是否还都集中在第一步,要在自己的系统上重新查。输出 100 个时召回降到 86% 就是一个信号:条件一变,瓶颈位置也会变。
第三,时间收益和实现方式绑在一起。6% 左右的节省是在作者的硬件上测的:每次调用只处理一个用户,用 FP32 精度,编码用户历史的时间不算在内。线上多个用户合批解码时,前向和挑选候选各占多少时间都会变,能省多少要在自己的系统上测。
一个推荐团队可以怎么试
- 先离线建精确参照。抽一批用户,用现有模型把目录里每个商品的完整 SID 都打分,取前 K 名。这一步只用于诊断,不进线上链路。
- 统计首次剪除深度。用线上现有的束宽跑一遍,看被漏掉的精确前 K 主要掉在第几步。如果也集中在第一步,就值得往下做;如果分散在各步,说明瓶颈不同,挪宽度不一定有用。
- 在相同预算下把宽度挪到丢失最多的那一步,比较搜索召回和输出是否与更宽的束一致。输出完全一致时,下游排序不用重新评估。
- 最后在线上实现里测真实耗时,同时看前向计算占比,判断能省多少。
结论
这篇论文的价值在方法论:加宽之前先查清楚结果丢在哪一步。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。束宽直接决定生成式推荐的召回和延迟,几乎每个团队都要调 |
| 方法创新性 | 中。思路简单,贡献在把损失定位到具体一步,并用对照实验证明 |
| 实验证据 | 中。六组设置、完整测试集、逐用户核对输出一致,但数据集小,宽度安排在其中一个测试集上调出 |
| 工程成本 | 低。只改每步的宽度,不重训、不改 SID |
| 是否值得尝试 | 值得。诊断只需抽样用户离线算一次精确打分,成本随目录变大而增加,但不碰线上服务 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…