目录 · 10 节
1它到底在解决什么问题?2舍入位置不一致是怎么回事?3整体方案:只对齐三个区域4怎么衡量两边差多少?5真的能让训练稳住吗?6为什么偏偏是这三个位置?7为什么不直接把训练端也编译?8我认为它的局限9一个大模型训练团队可以怎么试10结论与评价
做大模型强化学习训练基础设施的团队值得读。它回答了一个很多人踩过却说不清原因的坑:推理引擎和训练框架用同一份 BF16 权重,算出的 token 概率却对不上,训练跑着跑着就崩了。核心思想一句话:不必让两套系统逐位一致,只要找出“在哪一步把中间结果舍入成 BF16”这件事两边不一样的地方,让训练端照推理端的做法对齐就够了。论文在四个 Qwen 系列模型上,用这个办法让原本会崩的 BF16 训练全部稳住;只对齐 RoPE 这一处,训练耗时只多 0.90% 到 2.04%。
它到底在解决什么问题?
大模型强化学习通常拆成两套系统:vLLM 这样的推理引擎负责生成回答,Hugging Face Transformers 这样的训练框架再把同一批回答过一遍,重新算每个 token 的概率并更新模型。理论上两边是同一个策略,但数值实现不同,算出的概率会有细小差别。
这个差别的后果是:本该“用自己生成的数据训练自己”的同策略更新,悄悄变成了“用另一个略有不同的策略生成的数据训练”。差别积累起来,训练就可能崩溃,准确率先升后降。
作者用一个简单实验说明问题出在两边是否一致,而不是精度高低。推理端和训练端各自可以开或不开编译(torch.compile 一类的图编译,会把多个算子融合成一个),组成四种组合:
| 推理端 | 训练端 | 结果 |
|---|---|---|
| 编译 | 编译 | 稳定 |
| 不编译 | 不编译 | 稳定 |
| 编译 | 不编译 | 先升后崩 |
| 不编译 | 编译 | 先升后崩 |
两边模式一致就稳,不一致就崩。训练端保持不编译、精度不变,只把推理端从编译改成不编译,训练就恢复稳定。这说明稳定性取决于两边算法是否一致,而不是训练端精度够不够高。
舍入位置不一致是怎么回事?
编译会把几个算子融合进一个计算核。融合后,中间结果可以一直留在 FP32 里,到最后输出时才舍入成 BF16;不融合时,每个算子算完都要把结果存成 BF16,下一个算子读到的是已经舍入过的值。作者把这种差别叫作“舍入位置不一致”。
用一个能手算的例子说明(示意)。BF16 只有 8 位有效精度,在 1 到 2 之间能表示的相邻两个数相差 0.0078125,在 2 到 4 之间相差 0.015625。假设第一个算子算出 1.003,第二个算子把它乘以 3:
| 做法 | 第一步结果 | 第二步输入 | 第二步结果 | 最终 BF16 |
|---|---|---|---|---|
| 中间先舍入(不融合) | 1.003 → 1.0 | 1.0 | 3.0 | 3.0 |
| 中间留 FP32(融合) | 1.003 | 1.003 | 3.009 | 3.015625 |
两种做法输出的都是 BF16,但结果差了一格。单看一个数很小,可这样的差别出现在每一层、每个 token 上,最后就体现为两边对同一个 token 给出不同的概率。
整体方案:只对齐三个区域
作者对比 vLLM 编译前后的计算图,在 Qwen2 和 Qwen3 里找到三个融合改变了舍入位置的区域:
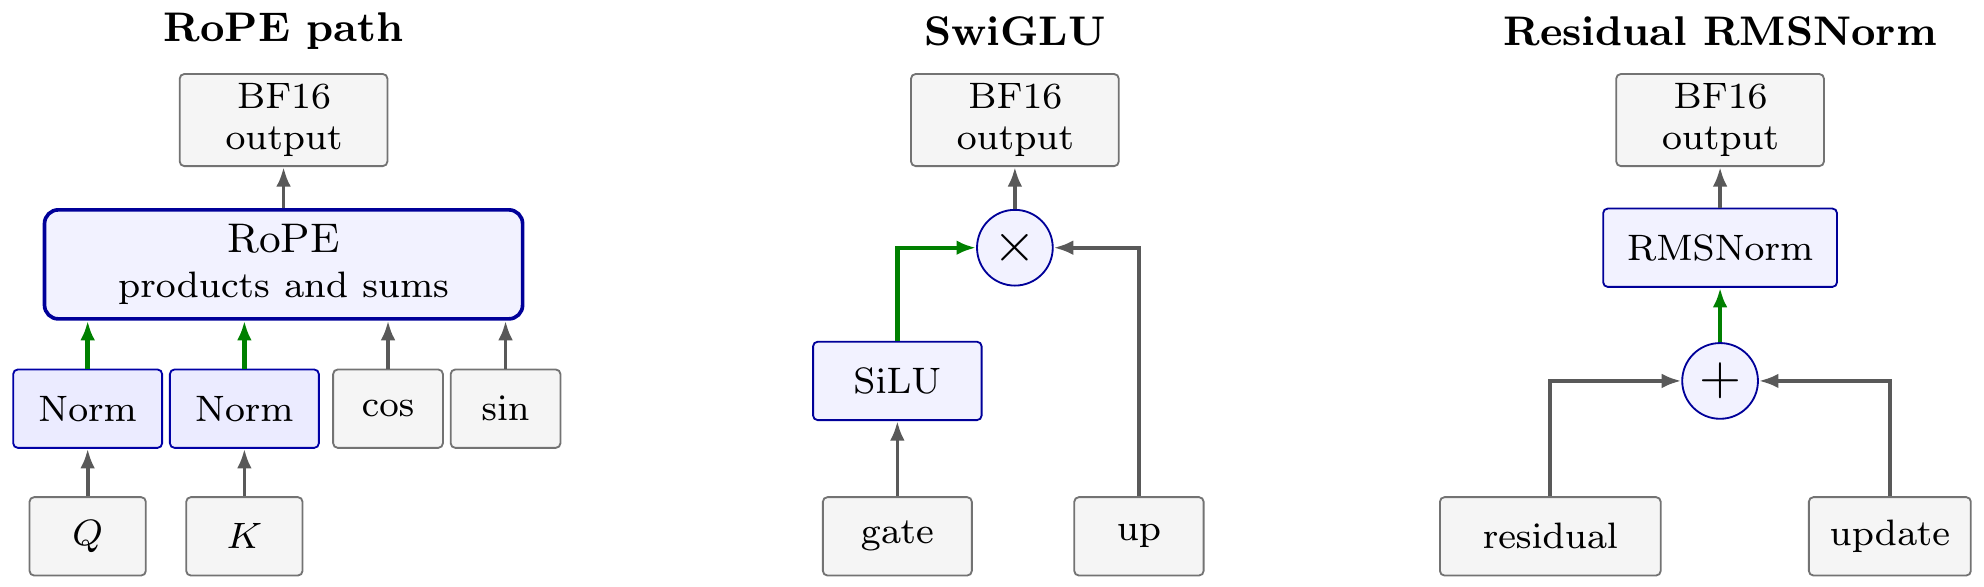
- RoPE 路径:融合时,Q/K 归一化和旋转位置编码的乘加都在 FP32 里完成,只有旋转后的 Q/K 存成 BF16。
- SwiGLU:融合时,SiLU 的结果留在 FP32 里和 up 投影相乘,乘完才存成 BF16;不融合时 SiLU 输出先被舍入。
- 残差 RMSNorm:融合时,RMSNorm 直接读未舍入的残差和;不融合时残差和先舍入再做归一化。
做法是在训练端把这三处的中间结果也留在 FP32,每个区域的输出照旧转回 BF16。推理引擎、矩阵乘法和注意力的计算核、训练目标都不动,改的只是逐元素运算和归一化这些很轻的部分。
怎么衡量两边差多少?
作者用同一份权重,让 vLLM 生成回答,再让两边分别算这些 token 的对数概率,用“推理端对数概率减训练端对数概率”在所有生成 token 上取平均,作为从推理端到训练端、每个 token 的 KL 散度估计。这个数越小,两边越一致。下表摘自论文表 1,单位是 10⁻⁴:
| 训练端留 FP32 的区域 | DeepSeek-R1-Distill-Qwen-1.5B | Qwen3-1.7B | Qwen3-8B-Base |
|---|---|---|---|
| 无(BF16 基线) | 6.5416 | 7.4461 | 3.7599 |
| 只有 RoPE 路径 | 5.0951 | 7.1912 | 3.4247 |
| 三个区域全部 | 4.8741 | 6.7689 | 3.2891 |
| 三区域相对基线的降幅 | 25.5% | 9.1% | 12.5% |
三个区域都对齐时差距最小,但只降了一到两成多。作者用 Shapley 归因(把三项改动按所有可能的先后顺序加入,平均每一项带来的降幅)拆分贡献:RoPE 路径在三个模型上分别占 81.5%、91.8%、76.9%。SwiGLU 在两个 Qwen3 模型上的贡献是负的,也就是单独提高这一处的精度反而让两边差得更多。这说明“精度越高越好”不成立,关键是和推理端在同一个位置舍入。
真的能让训练稳住吗?
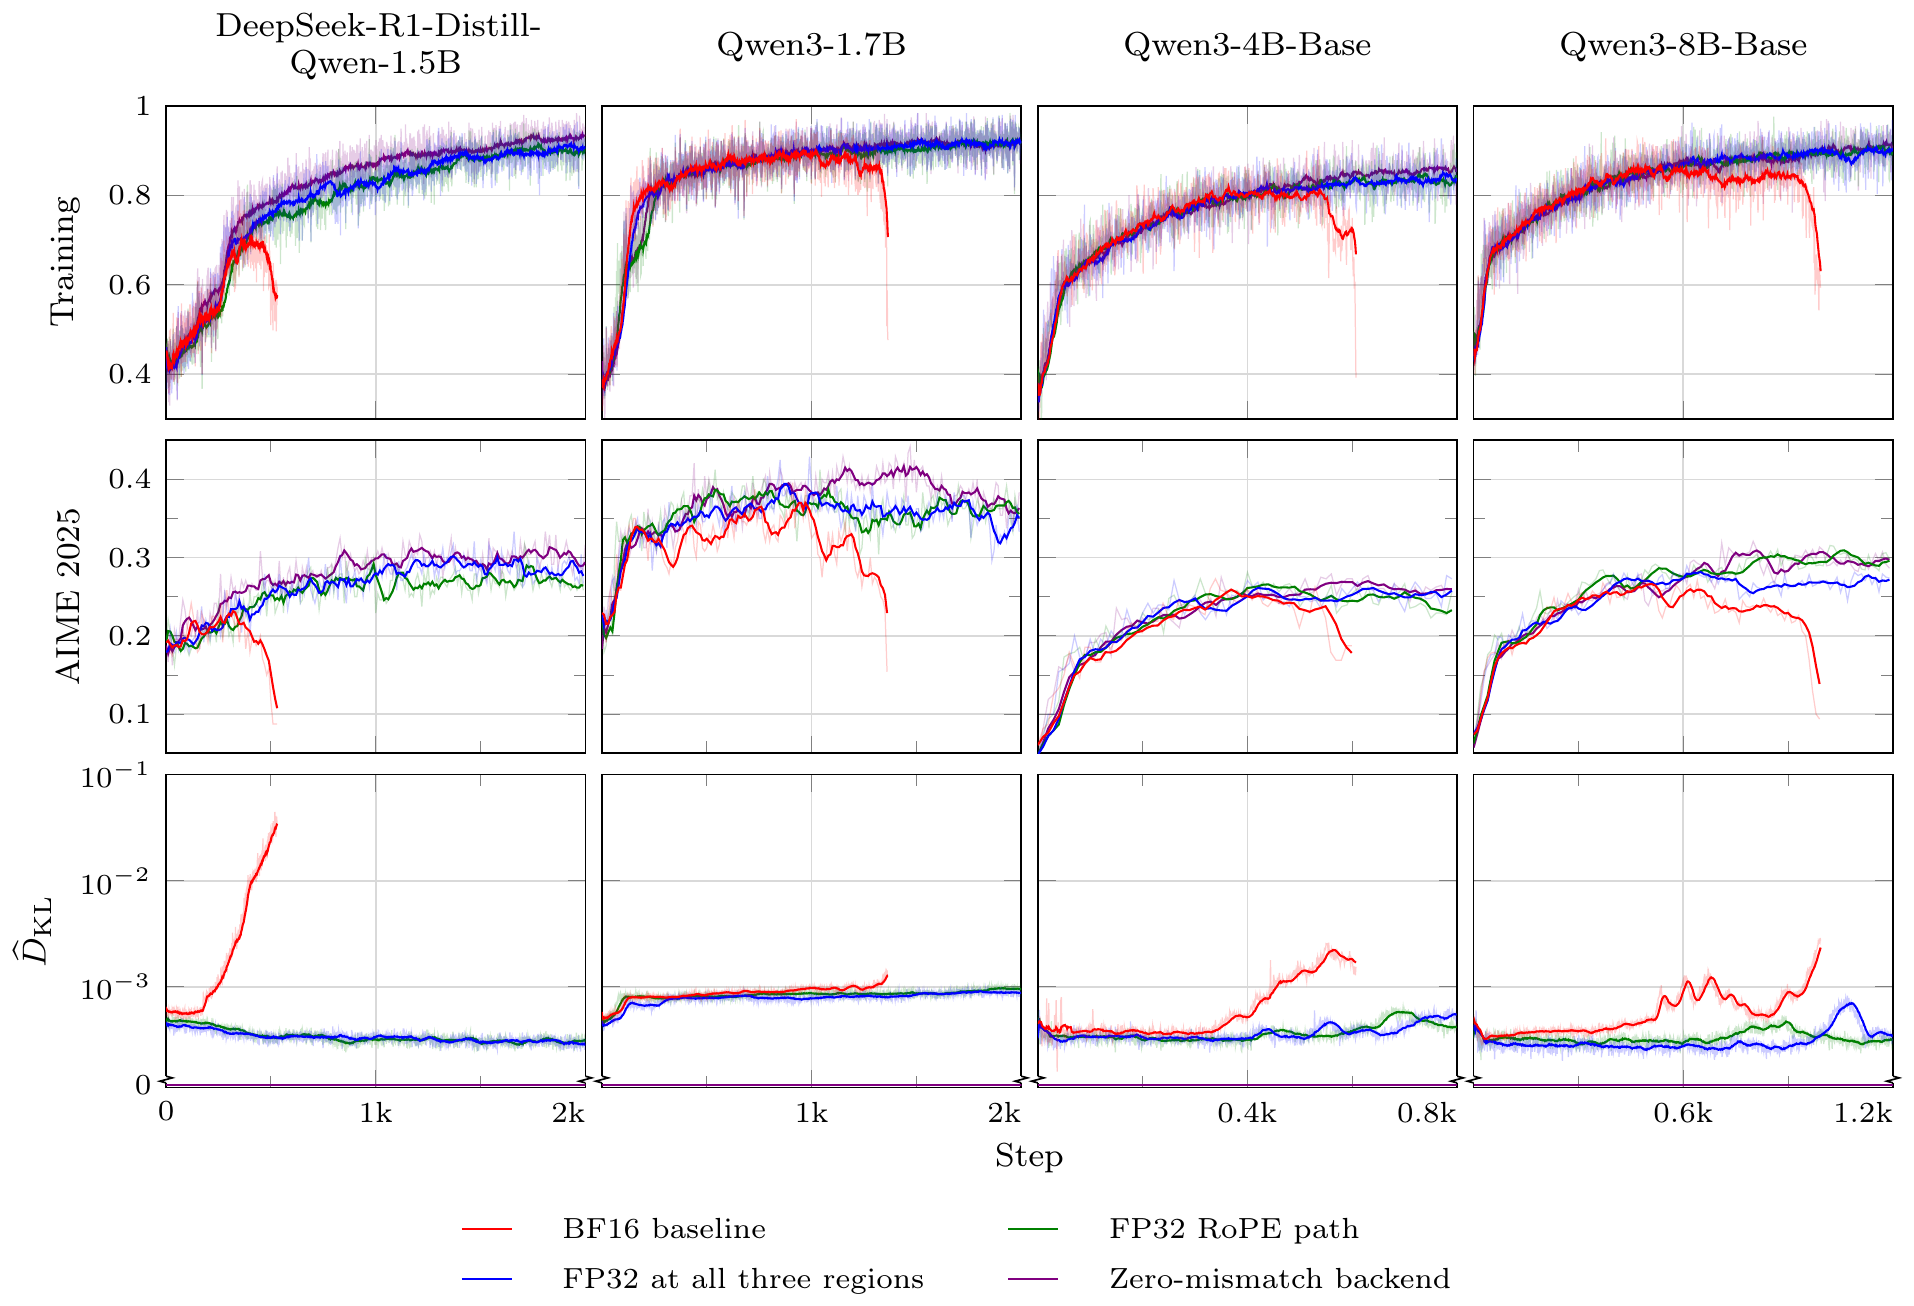
训练用数学题数据,算法是带截断的 GRPO,不加任何纠正两边差距的额外项。四个模型分别是 DeepSeek-R1-Distill-Qwen-1.5B、Qwen3-1.7B、Qwen3-4B-Base、Qwen3-8B-Base。默认 BF16 在四个模型上都先升后崩,崩的时候两边概率差距明显上升。只对齐 RoPE 或对齐三个区域,四个模型都没有崩,AIME 2025 准确率也保持在更高水平。
最值得注意的是,对齐之后两边仍然有小而不为零的差距,可训练已经稳住了。这说明不需要把数值差距消到零,消掉“敏感位置”的差距就够了。作者在另一个数学数据集 DAPO-Math-17k 上重复实验,结论相同。
对齐的额外开销很小,因为改动只落在逐元素运算上。只对齐 RoPE 时,训练计算耗时增加 0.90% 到 2.04%,峰值显存不变。
三个区域都对齐时,前向加反向的耗时增加 5.33% 到 10.92%,所以如果只改 RoPE 就能稳住,没必要三处都改。强化学习的大部分时间花在生成回答上,算上这部分,额外开销在整体里的占比会更小。
为什么偏偏是这三个位置?
作者还从数值本身找了一个旁证。一个数在 BF16 里会被舍入到最近的可表示值,它落在两个相邻可表示值之间的哪个位置,决定了舍入误差往哪边偏、偏多少。如果大量数值总是落在相近的位置,舍入误差就不是随机抵消的,而是朝同一个方向积累。
作者统计了这个“落点”分布有多不均匀:把落点(0 到 1 之间的相对位置)的分布做傅里叶变换,取前 16 个频率分量幅度的均方根,再取各层的中位数。落点完全均匀时这个值接近 0,越大说明落点越扎堆。投影、注意力和 RMSNorm 输出的不均匀程度在 1.5×10⁻⁵ 到 8.0×10⁻⁴ 之间,几乎是均匀的;而 SiLU 输出、RoPE 乘积和残差和这三类中间结果在 0.038 到 0.472 之间,明显更集中。这说明正是这三个位置的舍入误差带有系统性,所以在这里舍入还是不舍入,对最终概率的影响最大。
为什么不直接把训练端也编译?
这是读者最自然的疑问。编译确实能让两边一致,但代价不小:训练端编译要覆盖前向和反向,首次编译耗时长;回答长度不固定会触发重新编译;分布式切分和自定义计算核还要专门适配。而且 Hugging Face 编译后也不等于 vLLM 编译后,计算核和累加顺序仍可能不同。相比之下,只改几处逐元素运算的精度,改动小、容易验证。
我认为它的局限
第一,只覆盖一个模型家族和两个数学数据集。三个区域是针对 Qwen2/Qwen3 的计算图找出来的,换成别的架构,需要重新对比两边的计算图,找出新的舍入位置。
第二,为什么差距只降一两成就能稳住,论文只给了一个推测:不同位置的数值误差对训练更新的影响不同。在 Qwen3-1.7B 上,只对齐 RoPE 让差距只降了 3.4%,训练却同样稳住,这个现象背后的机制还没有被解释清楚。
第三,训练时长有限。图 3 里各模型只训练了几百到两千多步,对齐后的曲线和“零差距”对照很接近,但在更长的训练、更大的模型上能否一直稳住,需要自己验证。
一个大模型训练团队可以怎么试
- 先确认问题:在现有训练里记录推理端和训练端对同一批 token 的对数概率差,看它是否在训练崩溃前明显上升。
- 只改 RoPE:在训练端把 Q/K 归一化和 RoPE 的乘加放在 FP32 里算,输出转回 BF16。成本只有百分之一二,先看能否消除崩溃。
- 仍不稳定,再对比推理和训练的计算图,找出其他融合改变了舍入位置的地方,逐个对齐,并用上面的 KL 估计验证每一处是否真的缩小了差距。
- 换推理引擎版本或开关编译后,重新做一次计算图对比,因为融合方式一变,舍入位置也会变。
结论与评价
最关键的启发是:训练和推理不一致时,先查两边在哪里舍入,而不是一味提高精度。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 高。推理和训练分离是强化学习后训练的标准做法,训练崩溃代价很大 |
| 方法创新性 | 中。舍入位置对齐在其他追求逐位一致的工作里出现过,新意在证明只对齐少数位置就足以稳住训练 |
| 实验证据 | 中。四个模型、静态归因加训练曲线、额外数据集复现,但只有一个模型家族 |
| 工程成本 | 低。只改训练端几处逐元素运算,不动推理引擎和主要计算核 |
| 是否值得尝试 | 值得。用 vLLM 加 Hugging Face 做 BF16 强化学习、遇到过训练崩溃的团队可以先改 RoPE 一处 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…