
做向量检索预训练的团队值得读这篇,因为它找到了一个不用任何标注的新监督来源:同一篇网页里,哪几段在讲相关的事。xPRT 先在每篇文档里挑出能代表全文主题的段落(下面叫“代表段”),再给每个代表段找出同一文档里和它最相关的四段(下面叫“相关段”),然后训练 embedding 做两件事:代表段要在一批混着其他文档段落的候选里,认出同一文档里和它最相关的那一段;相关段被遮掉大部分词后,一个单层的小解码器要借助代表段的向量,把这些词补回来。在已经做过大规模对比预训练的 E5 上继续预训练,语料、步数和流程都固定、只换训练目标,三个语料规模下,五种已有方法在 MTEB 41 个任务上的平均分最多涨 0.38 分,xPRT 稳定涨 1.80 到 1.87 分。起作用的主要是正样本怎么选,新加的补词项只贡献一小部分。
它到底在解决什么问题?
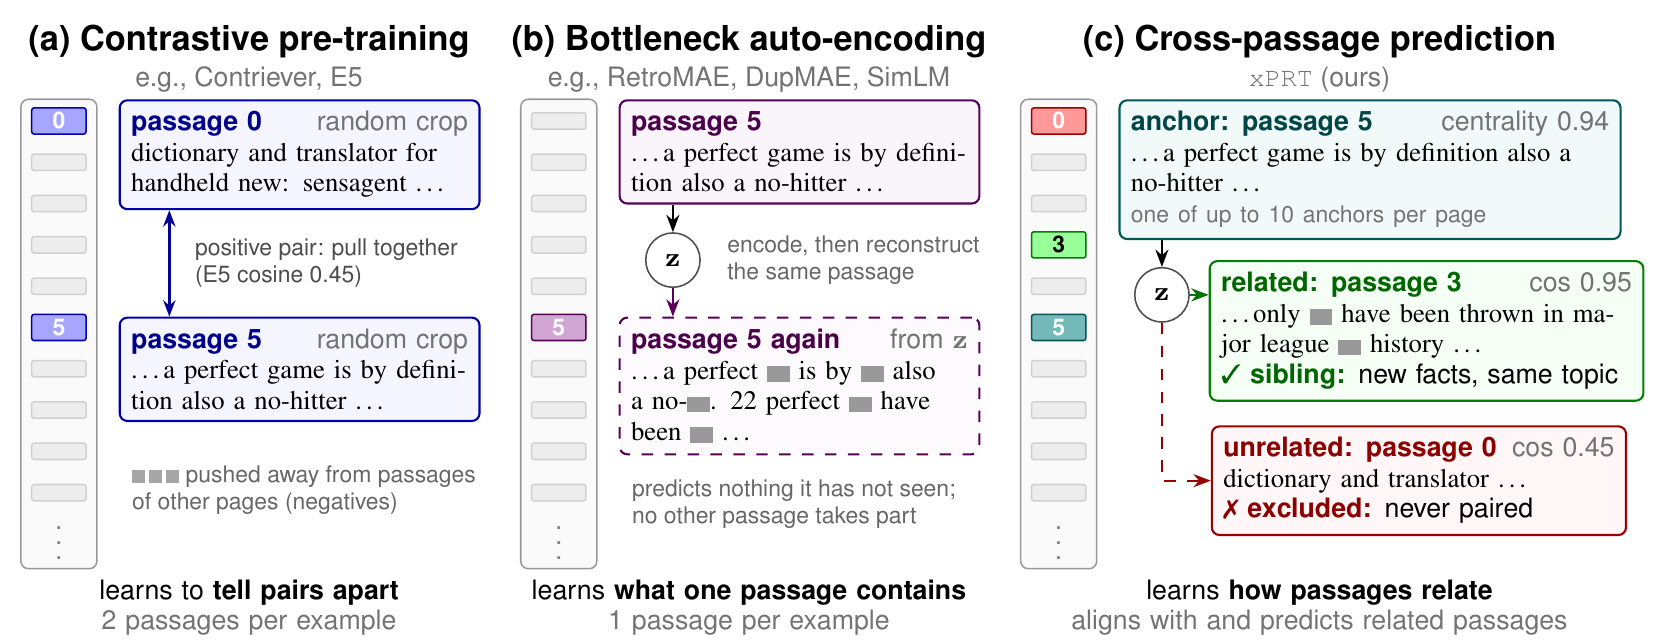
xPRT 改的是正样本:从“随机两段”换成“代表段配同文档里最相关的段”。原因是已有做法里,对比学习从同一文档随机切两段当作一对,RetroMAE、SimLM 这类自编码方法只让向量重建自己那一段,而网页里混着大量和主题无关的东西,随机配对会把正文和这些东西硬拉到一起。
论文图 1 用的是一个真实的 FineWeb 网页,讲棒球里的“完全比赛”。我们按它的数字列一下这页里的三段:
| 段落 | 内容 | 和全文的接近程度 | 和第 5 段的相似度 |
|---|---|---|---|
| 第 5 段 | 完全比赛按定义也是无安打比赛 | 0.94 | — |
| 第 3 段 | 大联盟历史上一共只投出过多少场完全比赛 | — | 0.95 |
| 第 0 段 | 一个“词典和翻译器”小部件 | — | 0.45 |
“和全文的接近程度”是这一段的 E5 向量和全文各段平均向量的余弦,论文叫 centrality。随机配对时,第 5 段的搭档可能是同页任意一段,包括第 0 段的词典小部件,模型就被要求把一段棒球规则和一个网页挂件看成“相关”。xPRT 的做法是只让第 5 段这样的代表段当提问的一方,只把第 3 段这样真正相关的段落当答案,第 0 段永远不进训练对。
这和检索要学的关系一致:query 和回答它的段落讲的是同一件事,但内容并不重复,第 3 段给出了第 5 段没有的新事实。
整体流程
整个方法分两步:训练前一次性挑好训练组,训练时用这些组更新编码器。
| 步骤 | 做什么 | 产出 |
|---|---|---|
| 切段 | 文档切成 128 token 一段,少于 5 段的文档丢掉 | 每篇文档的段落列表 |
| 挑代表段 | 用冻结的 E5 算每段和全文平均向量的余弦,超过 0.825 才合格,再把 centrality 排名和“段内各个词的平均 IDF”排名用 RRF 融合,每篇最多留前 10 个 | 代表段 |
| 挑相关段 | 对每个代表段,把同文档其余各段按 E5 余弦和 TF-IDF 两个排名融合,取前 4 | 一组 = 1 个代表段 + 4 个相关段 |
| 训练 | 对比损失 + 补词损失 + 几个正则项 | 更新后的编码器 |
| 部署 | 解码器、投影层、MLM 头全部扔掉 | 和原来一样的 BERT-base 检索器 |
在 10 万篇文档的语料上,99% 的文档能挑出训练组,平均每篇 7.0 组,覆盖了全部段落的 68%。部署时只用编码器加平均池化,所以线上推理成本不变。
怎么挑代表段和相关段
为什么要先挑代表段?因为提问的一方如果是导航栏或联系方式,文档里根本没有能回答它的段落,这样的训练对只是噪声。论文附录表 5 列了几个例子:讲福特皮卡的文章里,和代表段最不相关的一段是一串音乐视频链接;碳捕集政策报告里是一串媒体联系人。这些段落和代表段的余弦只有 0.38 到 0.45,而同页最相关的段落有 0.85 到 0.95,它们自己的 centrality 也只有 0.46 到 0.51,过不了 0.825 的门槛。
相关段的排序同时看两种相似度:E5 向量余弦和 TF-IDF。两个排名用 RRF 融合,E5 排名的权重是 TF-IDF 的两倍。举个示意:候选甲在 E5 余弦里排第 1、TF-IDF 里排第 6,候选乙两边都排第 2,按论文附录的公式算,甲得 0.244、乙得 0.250,两者很接近,乙略靠前。相关段可以来自文档的任何位置,不要求和代表段相邻。
训练目标:主损失换了正样本
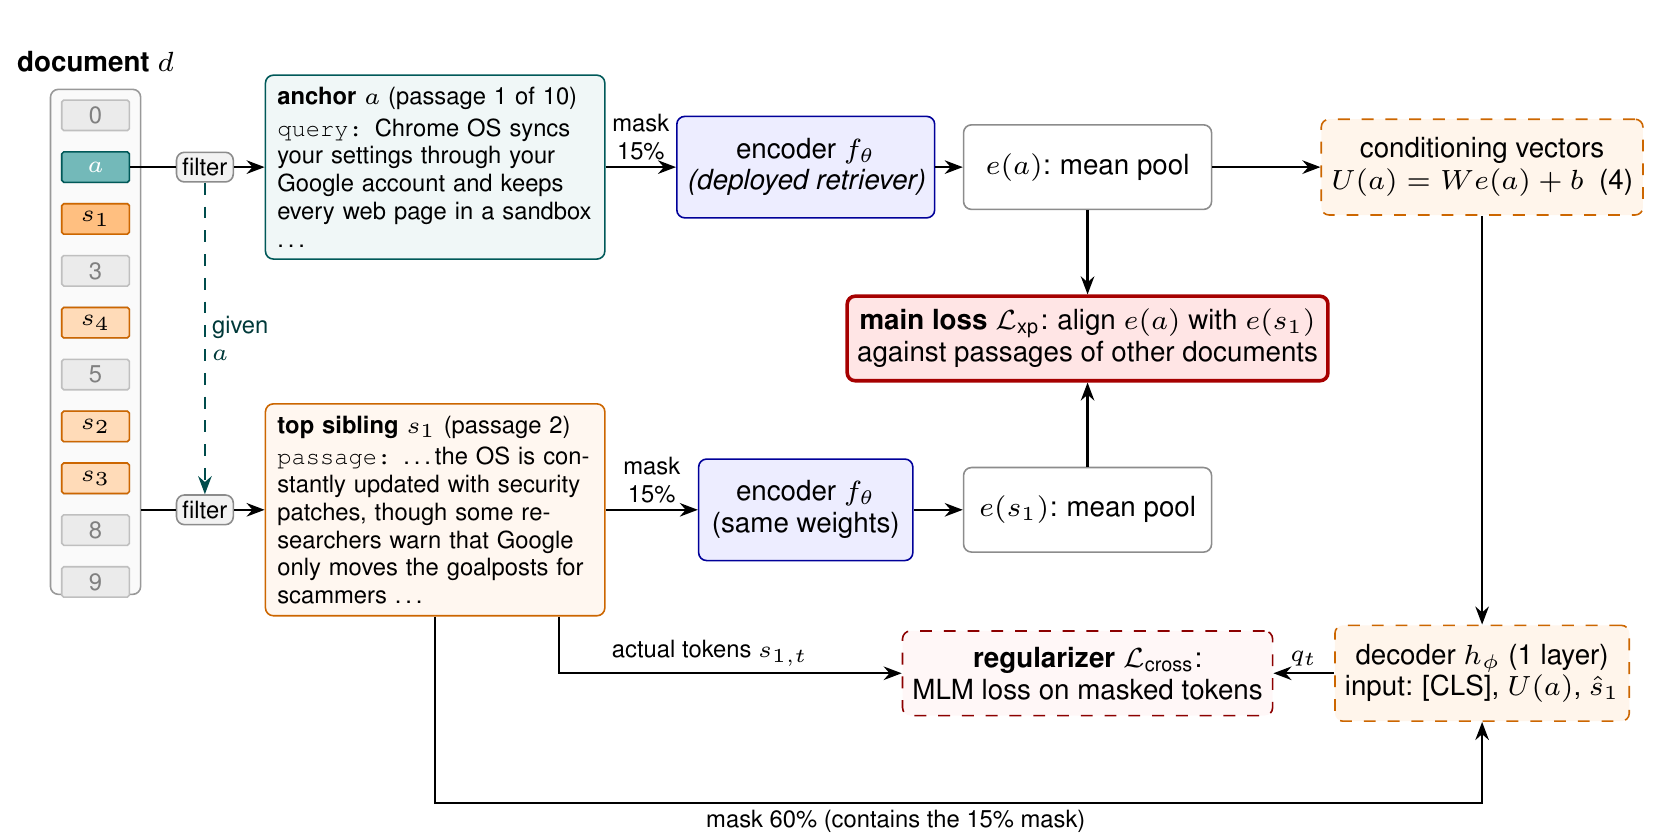
主损失 是常见的对称 InfoNCE,形式和 Contriever 这类对比预训练一样,变的是正样本:代表段 的正样本是它排第一的相关段 ,负样本是同一个 batch 里其他组排第一的相关段。每组另外三个相关段不进这一项,只在后面的补词损失里用到。
这里 、 是两段的平均池化向量,分母对 batch 里每一组 的排第一的相关段 求和,温度 。论文实际用的是对称版本:反过来让 在其他组的代表段里认出自己的 ,两项取平均。同一文档的其他组被排除在负样本之外,因为它们其实也相关。一个能手算的示意:batch 里只有 3 组, 和自己的 余弦 0.8,和另外两组的余弦都是 0.5,除以 0.05 后是 16 对 10,正样本的概率约为 。温度这么低,余弦差 0.3 就足以拉开。
只有对比损失时,向量只被要求“离对的段落近”,不要求装下对方的内容。补词损失 补的就是这一点:先把代表段的向量线性映射成 4 个条件向量。相关段遮掉 60% 的 token 后,用和编码器共用的 token embedding 表变成一串向量,4 个条件向量插在 [CLS] 后面。这串输入交给只有一层的解码器,解码器用和编码器共用的 MLM 头预测被遮的词。一层 Transformer 光看剩下 40% 的词补不回来,只能依赖代表段的向量,于是这个向量要装下两段共有的内容。方向也反过来做一遍,用每个相关段的向量补代表段。这一项的权重是 0.1。
另外三项是辅助: 只对代表段和排第一的相关段 做,让同一个解码器凭一段自己的向量补这段自己的词,目标是编码器在只遮 15% 时给出的词分布; 拿编码器的词分布当老师,所以还要加一项 MLM(),免得老师本身跑偏; 是 Wang 和 Isola 提出的均匀性损失:batch 里任意两个代表段的归一化向量离得越近,惩罚越大,这样所有向量不会挤成一团。每一组训练要过 5 次编码器(代表段和 4 个相关段都遮掉 15% 后各过一次,补词用的向量和自我补词的老师分布都取自这 5 次前向),10 次单层解码器(双向补词 8 次,加上 和 的自我补词 2 次)。继续预训练时,保留项还要再跑一次冻结的 E5。
继续预训练还有一个容易被忽略的风险:把 E5 原来学到的东西冲掉。作者给所有方法(包括基线)加了同样的保留项。对 xPRT,取 batch 里的代表段和排第一的相关段,当前模型和冻结的 E5 各算一张“代表段对相关段”的相似度矩阵,矩阵的一行对应一个代表段,把它和 batch 里所有相关段的相似度做 softmax,就得到“这个代表段更像哪些相关段”的分布。矩阵的列方向(相关段找代表段)也同样做一遍 softmax;两个方向各算一次“E5 的分布到当前模型的分布”的 KL,再取平均,让当前模型向 E5 靠拢;冻结的 E5 在训练时另跑一遍,读的是不遮词的原文。这一项的权重从 40 随训练降到 0。
实验:结果说明什么
主实验要回答的是:一个已经很强的检索器,还能不能从文档内部的段落关系里学到东西。做法是从 E5-base-unsupervised 出发,在 FineWeb 的 10 万、50 万、100 万篇文档上各训一遍,学习率 。五个基线用官方实现,语料、训练组、步数、batch、学习率和保留项都和 xPRT 一样,评测时都不做微调。各方法读的段落不完全相同:四个只在段内学习的方法只用每组的代表段,Revela 每组除了代表段和 4 个相关段,还加进 11 个其他文档的代表段。
| 语料 | 方法 | MTEB 平均(41 项) | 相对 E5 | 检索 nDCG@10 |
|---|---|---|---|---|
| — | E5(起点) | 53.06 | — | 43.26 |
| 10 万篇 | RetroMAE | 52.92 | −0.14 | 42.41 |
| 10 万篇 | DupMAE | 52.97 | −0.09 | 42.44 |
| 10 万篇 | SimLM | 51.01 | −2.05 | 36.93 |
| 10 万篇 | BoW-DPR | 53.14 | +0.08 | 43.11 |
| 10 万篇 | Revela | 53.02 | −0.05 | 42.99 |
| 10 万篇 | xPRT | 54.86 | +1.80 | 45.78 |
| 50 万篇 | xPRT | 54.93 | +1.87 | 45.67 |
| 100 万篇 | xPRT | 54.89 | +1.83 | 45.33 |
(论文表 1;分数 ×100。)10 万篇时,xPRT 在 41 个任务里的 34 个上超过 E5,而五个基线中有四个比起点还低。这说明在 E5 这种已经吃过上亿文本对的模型上,“自己重建自己”的目标基本学不到新东西;同样的数据换成跨段落的监督,收益就出来了。Revela 用的也是这些训练组:一个小语言模型(Qwen2.5-0.5B 加 LoRA)逐段预测文字,预测时 attention 可以看到组里的其他段落,检索器算出的两段相似度越高,给那一段的 attention 权重越大。检索器只能从“哪段帮语言模型预测得更准”里得到训练信号,段落之间的关系没有直接作用在 embedding 上。Revela 三个规模下都低于 E5 起点,低 0.05 到 0.26 分;段内方法最多也只提高 0.38 分。
从 BERT 直接起训(10 万篇训 6 轮),差距更大:xPRT 平均 47.12,最强基线 SimLM 是 42.73,检索 nDCG@10 是 29.21 对 20.68。这说明收益不依赖 E5 这种对比学习起点。
消融在 BERT 设置下做(论文表 3),能看出各部件的分量:
| 变体 | MTEB 平均 | 检索 nDCG@10 |
|---|---|---|
| 完整 xPRT | 47.12 | 29.21 |
| 去掉补词损失 | 46.67 | 28.46 |
| 去掉补词损失,正样本换成同文档随机一段 | 42.22 | 19.87 |
| 正样本换成另一篇文档里、那篇的代表段排第一的相关段 | 40.80 | 18.03 |
| 只用自我重建,五段全用 | 42.62 | 19.20 |
| 相关段只按 E5 余弦排 | 44.82 | 25.88 |
| 相关段只按 TF-IDF 排 | 47.10 | 29.89 |
去掉补词损失只掉 0.45 分,正样本换成随机段落却掉 4.9 分,跌到 SimLM 以下。补词目标是锦上添花,挑对正样本才是主要收益。给自我重建喂同样多甚至更多的文字、训 5 倍的步数,检索分也停在 18.8 到 19.2,说明缺的是跨段落的信号,不是数据量。相关段的排序方式影响小一些,但也不是无关紧要:只用 E5 余弦排会掉 2.3 分,只用 TF-IDF 排则和融合排序持平、检索分略高。
收益落在哪里?10 万篇时,STS 涨 3.5 分、检索涨 2.5 分,reranking 几乎没变。检索里涨得最多的是 query 和目标之间靠论点联系的任务:ArguAna 涨 5.8,Touché-2020 涨 6.6。ArguAna 的目标是 query 的反驳论点,作者把 query 按和反驳论点的词面重合分成三档,xPRT 在每一档都比 E5 高 3.7 到 8.8 分;只学词面的 BoW-DPR 在重合最低那一档反而掉 10.3 分。这说明 xPRT 学到的是“这段在回应那段”,不只是共享了哪些词。
我认为它的局限
第一,离网页越远的领域越可能吃亏。检索里有两个任务掉分:TREC-COVID 掉 1.4、FiQA 掉 1.1,都是医学、金融这类和网页文本差得远的专业领域;语料从 10 万篇加到 100 万篇时,检索 nDCG@10 反而从 45.78 降到 45.33,主要是 TREC-COVID 和 FiQA 继续下滑,说明多喂网页语料补不回这些专业领域;整体收益不再随语料增长,作者归因于很低的学习率和逐步衰减的保留项。
第二,挑训练组这一步离不开一个现成的好模型。代表段和相关段都是用冻结的 E5 选的,连从 BERT 起训的实验也用这批组,所以“只靠无标注文档”是在已有 E5 的前提下成立的。代表段过滤看的也只是代表性,不是质量:表 5 里一个网站政策页的免责声明 centrality 有 0.95,照样被选成代表段。
第三,验证范围窄。只测了 BERT-base 大小的编码器,评测全部不微调。实际检索系统一般还会在有标注的数据上微调,而 xPRT 的 1.8 分是在完全不微调的条件下测出来的,微调会不会把这部分差距抹平,是上线前最该先测的事。
一个搜索团队可以怎么试
- 先只换正样本:拿现有的对比预训练流程,把随机切段换成“代表段配最相关段”,挑选只用现成 embedding 模型加 TF-IDF。消融里这一步占了绝大部分收益,成本只是一次离线挑选。
- 用自己的语料检查过滤效果:抽几十篇文档,看代表段和被排除的段落是不是分别对应正文和导航、页脚,门槛 0.825 是在 FineWeb 上定的,换语料要重调。
- 在领域内检索集上比较“继续预训练后再微调”和“直接微调”,确认收益在微调后还在;同时盯住离网页文本远的子领域,论文里这类任务掉了分。
- 有效再加补词解码器,它只在训练时存在,不增加线上成本。
结论
最关键的一点:无标注检索预训练的瓶颈常常不在损失函数,而在正样本是怎么来的;从同一篇文档里挑出真正相关的段落配对,比换任何重建目标都管用。
| 维度 | 评价 |
|---|---|
| 问题重要性 | 中高。向量检索的预训练数据几乎都无标注,正样本质量直接决定能学到什么 |
| 方法创新性 | 中。损失形式都是现成的,新在挑哪些段落配对,消融证明这正是关键 |
| 实验证据 | 较强。基线同数据、同步数、同保留项,三个语料规模结果一致,消融细;缺微调后的结果和更大模型 |
| 工程成本 | 低到中。挑选是一次离线计算,训练每组 5 次编码器前向,部署成本不变 |
| 是否值得尝试 | 值得。先做“只换正样本”的版本,代价小,判断标准清楚 |
读完这篇,你觉得
夜读鸮记下了,谢谢你的反馈。

点一下即可,无需登录;再点一次撤回。只统计匿名次数,不记录你是谁。
讨论
欢迎补充实验细节、复现经验或不同看法。需 GitHub 登录。
正在加载讨论…