Gryphon-v2 把生成式召回和轻量排序放进一个模型,再让离线大教师教它怎样排好候选。它想解决的不是“能不能生成物品编码”,而是生成以后,怎样把用户真正喜欢的东西放到前面。论文来自 Yandex Music,实验中用这个模型替换了原先的多级推荐链路。
1. 为什么只会召回还不够
传统推荐链路通常分成召回、粗排和精排。每一层都有自己的模型与特征管道,也可能重复处理同一段用户历史。生成式推荐看起来能把流程缩短:根据用户过去的行为,直接写出下一件物品的短编码,也就是语义 ID。
问题是,生成概率并不等于最终推荐价值。一个编码容易被模型写出来,不代表对应的歌最值得推荐。编码还可能对应多个物品,概率属于整条编码路径,而用户最终接触的是具体歌曲。召回覆盖得好,与候选内部排得好,是两件事。
作者沿用前一版 Gryphon 的共享编码器:用户历史只读一次,生成器与排序头都用这份表示。新工作主要改变排序头的监督来源,让它学习一个更强教师的偏好。线上保留的是小模型,教师的长历史计算留在训练阶段。
2. 两类候选,分别解决什么问题
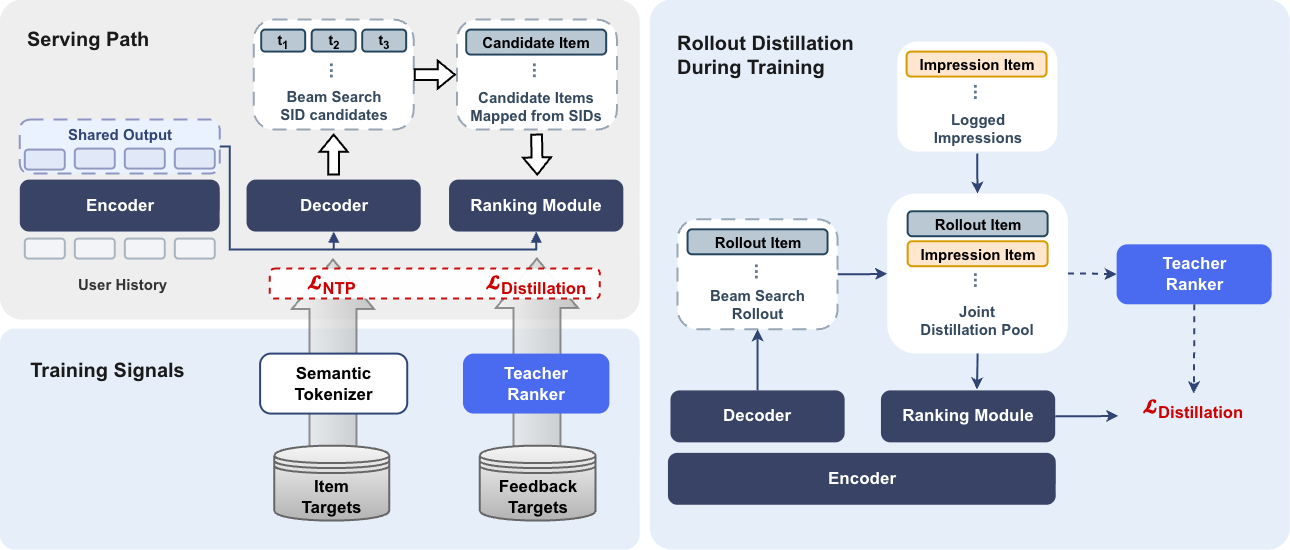
先看服务流程。模型读取用户历史,生成器在有效商品目录构成的前缀树上搜索,只产生合法编码。编码还原成具体歌曲后,排序头让每首候选歌去读取共享的历史表示,再输出各个任务的分数。任务分数按固定权重合成最终排序。
这里没有在生成器后面重新接一套完整精排。排序头复用已经算过的历史,避免另一套大网络再读一遍。整个模型约有 5 亿参数,历史最多保留 2,048 个事件;这是服务模型的预算,教师可以读取更长的历史。
再看训练。生成器仍学习正反馈物品的下一词元预测。排序头则学习教师给候选打的分数。关键问题变成:拿哪些物品给教师打分?
第一类来自当前模型自己生成的候选。每个训练步骤都用当前解码器搜索,没有旧检查点的滞后。这样排序头看到的物品,更接近自己上线后会收到的物品。论文训练时用宽度为 32 的搜索,限制生成与教师打分成本。
第二类来自相应请求的历史曝光。生成器会有自己的盲区,只教它处理自己已经会找的东西,覆盖范围可能越来越窄。曝光日志补上另一种候选分布,让排序头接触真实流量中出现过的物品。
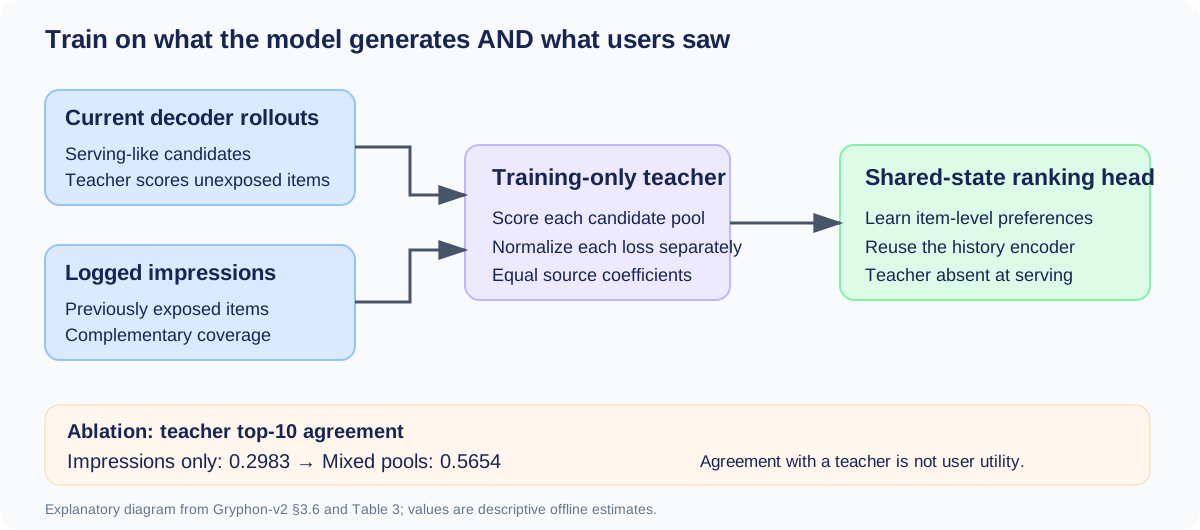
两个来源分别计算平均绝对误差,再等权相加。这个细节很容易读错:生成候选占不同蒸馏物品的九成以上,并不代表它们在总损失里占九成权重。各来源先按自己的候选数量归一化,样本多的一边不会自动淹没另一边。
生成损失更新解码器和共享编码器;蒸馏损失更新排序头和共享编码器。教师只提供目标,不进入服务图。搜索过程也不反向传播梯度,因此这是一种监督蒸馏,不是用奖励直接更新生成策略的强化学习。
3. 真正改变的是训练分布
单独增加一个排序头,并不足以解释效果。论文中,前一版模型已经有相同架构的排序模块,只是用下一物品监督。它与新版本的差距,说明“让排序头学什么”比“有没有排序头”更关键。
教师能对任意用户与候选组合评分,不要求候选先被曝光。这让训练可以覆盖生成器自己带来的未曝光物品。对工业系统来说,这比只在日志曝光池里蒸馏更贴近真实服务分布,也减少了生成与排序彼此脱节的问题。
不过,排序头仍不能救回根本没进候选池的好物品。共享编码器和联合训练会让两条路径交换信息,但论文没有把生成器直接优化成一个追求教师奖励的策略。把它理解为“高召回生成器加共享表示上的学生排序器”,更符合实现。
4. 实验到底证明了什么
离线对照使用同一套分词器、历史特征和生成骨干,按时间切分日志。下面保留最能区分问题的指标:候选召回、与教师前十选择的重合率,以及曝光日志上的加权成对排序准确率。后者会让喜欢与厌恶这类差距大的行为对占更高权重。
| 模型 | Recall@1000 | 教师前十重合率 | 加权成对准确率 |
|---|---|---|---|
| 纯生成式召回 | 0.8643 | 0.0382 | 0.5429 |
| Gryphon | 0.8593 | 0.0392 | 0.5528 |
| Gryphon-v2,仅生成顺序 | 0.8615 | 0.0381 | 0.5478 |
| Gryphon-v2,完整模型 | 0.8615 | 0.5654 | 0.5892 |
最清楚的变化发生在排序上:完整模型与教师的前十选择重合率超过一半。绕过排序头时,它又回到很低的水平。候选召回基本保持,说明蒸馏没有明显牺牲生成池的覆盖。
候选来源消融也支持这个解释。只用曝光候选,前十重合率为 0.2983;混合两类候选后达到 0.5654。只用生成候选虽然接近混合方案的教师一致性,曝光日志上的排序准确率却更低,两种分布确实提供不同信息。
线上实验才是端到端结果。对照组运行完整生产链路,实验组只运行统一模型。实验组活跃用户数相对增长 1.41%;这里的“活跃”指每日听歌至少七分钟。论文还报告总收听时长增长,但这不能拆成某个单独模块的贡献。
服务延迟与原链路相当,作者没有给出可复用的绝对毫秒值。相对“同一生成骨干在线接教师”的方案,统一模型吞吐约高四倍;这个对照不是原生产链路,不能把它写成“生产吞吐提升四倍”。
5. 哪些结论还没有答案
作者首先承认,线上实验同时改变了生成、排序与在线更新,无法隔离蒸馏的边际作用。实验也只覆盖一个音乐推荐入口,两个实验臂各占合格用户的 8%,没有证明全量上线后的长期表现。
长尾歌曲覆盖、艺术家多样性、新颖性与曝光集中度都没有评估。这些缺口对生成式推荐尤其具体:候选池缩小后,头部效果更好,不代表目录探索也更好。
离线指标同样有边界。教师一致性是在模仿训练教师;加权排序准确率来自旧生产策略下的曝光,不能完整评价新模型自己找到的物品。教师与生产排序器还用过更长时间的数据,和学生的短窗口离线结果并非严格匹配的对照。
此外,论文没有控制变量比较强化学习后训练。它展示的是蒸馏能支撑一条可行的统一服务路线,没有证明这种路线在效果、稳定性或计算效率上优于强化学习。
6. 对搜推工程能带走什么
最值得试的是候选分布对齐。已有生成式召回系统,可以固定生成器,分别用曝光样本和生成候选训练小排序头,比较候选召回、教师一致性及独立标注的相关性。这样能判断问题出在生成覆盖,还是候选已经合适、顺序却排错了。
另一个可做的改动是共享历史编码。核算时要把特征构建、网络传输、模型推理与候选解析一起算进去,而不只比较排序头的 FLOPs。论文服务链路仍需要目录约束、编码碰撞展开和候选预算,这些组件决定系统是否真的变简单。
迁移到社区短文本搜索时,查询条件与内容新鲜度是额外要求。音乐无限推荐没有显式搜索意图,教师偏好也不等同于查询相关性;试验应保留查询相关性标注,并观察新帖与长尾帖是否仍能进入候选池。
来源:论文正文第 3–6 节、表 1–4 与附录 A;原图采用论文 CC BY 4.0 授权,补充机制图为依据正文绘制的解释图。