2026-10-19 周一 · Generative

独立报告页 · 在站内浏览(含往期切换)→
Generative生成式推荐 · 10 篇Personalization个性化推荐 · 9 篇AI SearchAI 搜索 · 6 篇Agentic智能体搜索 · 9 篇Infra系统与索引 · 10 篇

今日场景社区搜索 (UGC 短文本搜索): 用户在社区平台搜索帖子、问答、评论等 UGC 内容。 核心指标是搜索相关性 (nDCG) 和点击率 (CTR)。 关注:语义匹配、query 理解、短文本召回、排序模型、LLM 在搜索中的应用。 — 评分 17 篇,入选 10 篇,分数 3.25 – 4.15

本期目录 · 10 篇
  1. 01Gryphon-v2: One Model in Place of a Cascade - Generate-and-Rank Recommender with Rollout Distillation
  2. 02Vela: User Behavior as Supervision Sparks LLM Intelligence
  3. 03When Machines Speak: A Unified Generative Framework for Integrating Machine-Native Symbols into Pretrained Large Language Models
  4. 04LLM-based User-Product Relevance Evaluation for Dynamic Product Advertising
  5. 05PsyBer-Agent: A Psychology-Driven User Agent for Recommender Systems
  6. 06When More Data Is Not Enough: The Context-Sufficiency Frontier in Generative AI Personalization
  7. 07Learning When to Think: Utility-Guided Adaptive Reasoning for Efficient Text Retrieval
  8. 08How Can Recommendation Feedback Evolve Agent Memory?
  9. 09LIFT: A Lifecycle-aware Interaction Factorization Transformer for Unified Retrieval and Ranking
  10. 10Aligning LLMs with Sparse Retrieval via Adaptive Sparse Supervision
LEAD STORY · 今日必读 · Yandex

Gryphon-v2: One Model in Place of a Cascade - Generate-and-Rank Recommender with Rollout Distillation

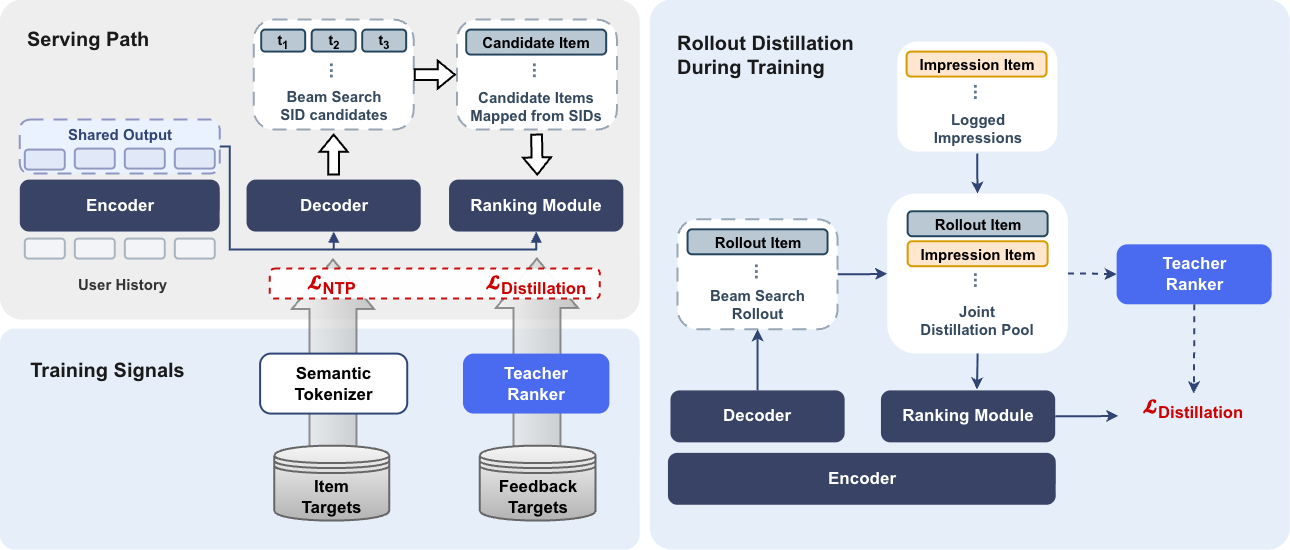
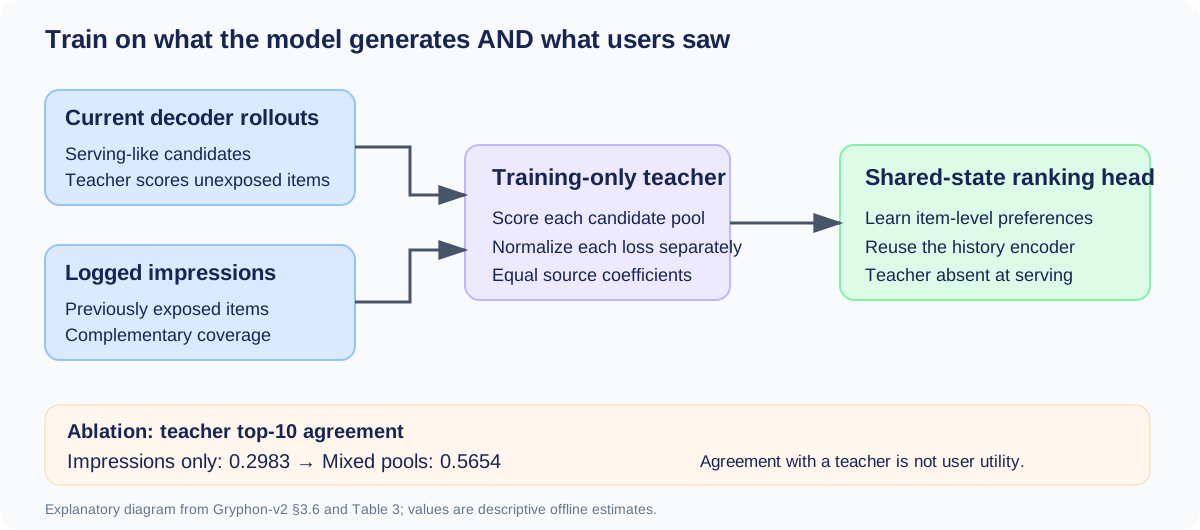
推荐系统可以把召回与排序合并到一个模型里。Gryphon-v2 只编码一次用户历史,先生成语义 ID(物品的短编码),再用轻量排序头打分;教师只参与训练。Yandex Music 线上实验中,活跃用户数提升 1.41%。

相关 4新颖 4实用 5证据 5时效 2
4.15
综合分 / 5
偏好调整 4.45
KEY INSIGHT · 对业务意味着什么蒸馏样本要包含模型自己会召回的物品。仅学历史曝光,排序头仍可能不熟悉生成器的候选;把当前生成候选与曝光日志一起交给教师打分,能在共享历史表示的同时保留精排偏好。
Lipkina, Anna, Tikhonovich, Daria, Yanush, Viktor, Ulianova, Mariia, Sorokin, Oleg, Dodono... · 2026-08-06 · arXiv
独立页面阅读 ↗

今日其余入选

9 篇 · 按综合排名
02 3.65

Vela: User Behavior as Supervision Sparks LLM Intelligence

用户的真实行为也能成为大模型的训练题。Vela 把长期行为记录整理成任务与推理轨迹,再用难度筛选和轨迹验收控制训练质量。以真实行为监督微调后,用户相关任务相对基础模型最高提升 11.5 个点。

INSIGHT行为日志的价值不止是预测下一次点击。把记录改写成可检验的偏好、意图和未来行动任务,可以训练模型读懂一个人;关键在于任务筛选和轨迹验收,避免把行为噪声直接当成正确答案。

Xiao, Yang, Sun, Yusong, Wu, Haoyi, Hui, Wenyang, Hang, Weiqiang, Wang, Luqing, Wang, Zejian, Tu, Zi...
arXiv·2026-10-10·Relevance 4 · Novelty 4 · Practical 3 · Evidence 4 · Timely 3
03 3.55

When Machines Speak: A Unified Generative Framework for Integrating Machine-Native Symbols into Pretrained Large Language Models

Google

物品编码不必先翻译成文字才能交给大模型。UniLang 扩展模型词表,让机器符号和自然语言一起生成,并用有任务含义的向量初始化新增符号。在 MovieLens-20M 上,NDCG@5 相对表中最强基线提升约 151.7%。

INSIGHT把编码当作真正的词元,能减少“结构数据转成文本”这一步的信息损耗。新增符号的初始化与训练目标要一起设计;收益随数据集和指标变化,Beauty 上的 Recall@10 就没有超过最强基线。

Yan, Su, Iyer, Rakesh
arXiv·2026-08-20·Relevance 4 · Novelty 4 · Practical 3 · Evidence 4 · Timely 2
04 3.65

LLM-based User-Product Relevance Evaluation for Dynamic Product Advertising

Snap

广告召回的离线评测容易被稀疏点击误导。这项工作先把用户历史压成若干意图代表,再让大模型判断商品与各类意图的相关性,最后蒸馏给小模型。正文中的一种内容召回方案,线上转化率相对提升 4.98%。

INSIGHT把用户历史压成多种意图,比只取最近行为更能保留需求。评测器的作用是比较候选与这些需求是否匹配;相关性分数和线上收益要分别报告,不能把某条召回策略的转化提升归功于评测器。

Zhang, Wen, Bai, Xiao, Chao, Hsiang-wei, Zhu, Mengfan, Zhao, Tong, Ju, Mingxuan, Liu, Xiaodong, Zhan...
arXiv·2026-10-10·Relevance 5 · Novelty 3 · Practical 4 · Evidence 4 · Timely 3
05 3.55

PsyBer-Agent: A Psychology-Driven User Agent for Recommender Systems

XJTLUUniversity of LiverpoolAlibaba

推荐模拟器需要记住用户为什么会疲劳或改变兴趣。PsyBer-Agent 用随交互变化的心理状态驱动轻量策略,再用真实日志校准状态轨迹;大模型负责少量回退。扩展到 500 万排队任务时,成功率为 95.18%。

INSIGHT让快策略处理常见行为,把大模型留给难以判断的情况,可以控制长周期模拟成本。这里的排队任务规模不等于同时在线用户数;行为贴合度、状态一致性和系统吞吐也需要分开理解。

Zhang, Chong, Shen, Qijie, Zhang, Haichao, Wang, Can, Jin, Xiaobo, Wang, Jia
arXiv·2026-09-26·Relevance 4 · Novelty 4 · Practical 3 · Evidence 3 · Timely 3
06 3.55

When More Data Is Not Enough: The Context-Sufficiency Frontier in Generative AI Personalization

给生成式推荐塞进更多上下文,可能让结果变差。作者把零售场景的相关条件与无关条件组合测试,寻找足以满足当前意图的最小集合。其中一名客户的适当性得分,从较小条件集的 0.94 降至全条件集的 0.88。

INSIGHT上下文的目标是补齐当前意图需要的条件,而不是堆满模型窗口。可以把营业规则、库存等动态条件按意图筛选,同时检查生成结果是否遵守约束;实验仅围绕两名客户画像展开,给出的是设计框架。

Askour, Merieme, Merimi, Ayoub
arXiv·2026-09-30·Relevance 4 · Novelty 3 · Practical 4 · Evidence 3 · Timely 3
07 3.50

Learning When to Think: Utility-Guided Adaptive Reasoning for Efficient Text Retrieval

已录用 EMNLP 2026

检索前的推理不是越长越好。AURA 用相关文档与难负例之间的区分度监督中间推理,再训练轻量估计器判断何时停止。在相同部署条件下,自适应停止把完整推理的延迟从 4.6 秒降到 0.76 秒。

INSIGHT停止推理应由检索收益决定。把每一步产生的表示拿来检查“能否拉开相关与不相关文档”,比只奖励最终命中更能约束过程;适合分析复杂查询,但属于检索赛道的相邻补充。

Luo, Yingtao, Zhao, Kangyi, Du, Shiyi, Li, Yubo
arXiv·2026-10-15·Relevance 5 · Novelty 4 · Practical 4 · Evidence 4 · Timely 4
08 3.30

How Can Recommendation Feedback Evolve Agent Memory?

内容生成代理收到的点击和转化往往来得很晚。TIDE 沿时间和语义轨迹分配反馈,再根据生成时实际调用的记忆估计贡献,决定保留、改写或淘汰哪些经验。电商营销离线回放中,记忆演化增益提升 7.75 个百分点。

INSIGHT记忆好不好,要看它对未来任务增加了多少价值。把延迟反馈拆到实际参与生成的经验上,可以避免反复强化一条碰巧获得高点击的记忆;评估时也要把任务时间分开,防止结果回流到过去。

Mao, Shanwen, Li, Mingming, Zhang, Hao, Li, Zhiheng, Wang, Yige, Yu, Penghua, Zhu, Junxiong
arXiv·2026-09-29·Relevance 3 · Novelty 4 · Practical 4 · Evidence 4 · Timely 3
09 3.35

LIFT: A Lifecycle-aware Interaction Factorization Transformer for Unified Retrieval and Ranking

BUPTSoutheast UniversityXiaohongshu

召回和排序可以共用用户历史,但不能偷看后续信息。LIFT 把一次交互拆成请求、物品、上下文和动作,按发生顺序建模,让不同阶段读取不同状态。在淘宝数据集上,联合得分相对最强对照提升 3.6%。

INSIGHT共享模型时,要先明确每个阶段当时知道什么。用状态边界约束召回与排序读取的位置,可以复用历史表示而不泄漏未来动作;其联合得分体现两项任务的折中,不等同于线上点击率。

Miao, Keji, Cheng, Enhao, Li, Yan, Li, Qun, Zhang, Qi, Yuan, Jie, Li, Xiaoyong
arXiv·2026-09-29·Relevance 4 · Novelty 3 · Practical 4 · Evidence 4 · Timely 3
10 3.25

Aligning LLMs with Sparse Retrieval via Adaptive Sparse Supervision

大模型做召回不一定要保存很大的稠密向量。这项工作让稀疏模型提供随输入变化的词项监督,只保留主要激活,再联合训练检索与稀疏约束。相对 Lion-sp,索引存储缩小 6.4 倍,并保持有竞争力的检索效果。

INSIGHT稀疏程度可以跟着输入难度变化。按累计激活量选监督词项,能避免给每条查询同样的词项预算;比较延迟时仍要把索引规模、查询计算和检索环节一起计入,这属于检索赛道补充。

Chen, Tongna, Li, Minghan, Zhou, Guodong
arXiv·2026-10-15·Relevance 5 · Novelty 3 · Practical 4 · Evidence 4 · Timely 4

其他赛道今日

点击切换
Personalization
9
个性化推荐 · 篇入选
AI Search
6
AI 搜索 · 篇入选
Agentic
9
智能体搜索 · 篇入选
Infra
10
系统与索引 · 篇入选

开源雷达

GitHub / HuggingFace 热门 · 8 个项目
knapcio/GLM-5.3-gr8-4x-DGX-Spark-TP4在四台 DGX Spark 上部署 GLM-5.3 的工程配置。仓库记录推理吞吐对比,适合关注模型部署的人参考;不是推荐算法项目。Python · ★ 5 · 2026-10-15 · GitHubOpenBMB/ChatDev用多个大模型代理协作开发软件的框架。可参考任务协作设计,与生成式推荐的直接关联较弱。Python · ★ 34547 · 2023-08-28 · GitHubxinghuangjun/YiYan通过多个大模型并发与自动优化整理记忆的多模态聊天助手。适合观察个性化记忆实现。Python · ★ 49 · 2026-10-15 · GitHubdeepseek-ai/DeepSeek-V4.1-Flash支持图像和文本输入的对话模型。作为近期模型更新单独列出,未参与论文评分。model · ★ 4637 · 2026-09-10 · HuggingFacezai-org/GLM-5.3-Flash支持图像和文本输入的对话模型轻量版本。作为基础模型项目列出,未核实推荐专项效果。model · ★ 2888 · 2026-08-25 · HuggingFacezai-org/GLM-5.3面向文本生成与对话的模型。近期仓库更新,不代表新论文或推荐效果提升。model · ★ 2258 · 2026-08-25 · HuggingFacedeepseek-ai/DeepSeek-V4.1-Flash-1017支持图像和文本输入的模型版本,仓库于本周新建。可用于模型能力试验,未进行本地部署测试。model · ★ 1341 · 2026-10-17 · HuggingFacestepfun-ai/Step-5-Preview近期更新的预览模型,仓库提供权重与评测标签。未进行推荐专项评测。model · ★ 108 · 2026-09-20 · HuggingFace