LLM 训练吞吐取决于切分、显存-算力交换与通信重叠这套「配方」,换模型/加速器/框架就要重做。固定旋钮搜索只检查能跑,常漏掉空间外杠杆,还可能悄悄改训练语义。Amazon ATTUNE 是编码 agent:在 GPU-小时预算内无人值守改任意能跑配方。H100/H200/B200 上平均吞吐 +1.7×(最高约 3.9×),四条 NVIDIA AutoModel 官方基准配方被它高出 6–17%;留出模型上把写给别的场景的配方最高抬到 2.6×(MiniMax-M2)。吞吐缺口往往在固定旋钮空间之外——让 coding agent 改配方,比在预设网格里搜更对症。
1. 问题
现成自动调参在预设旋钮上贝叶斯/网格搜索,目标只是「跑得动」。真正缺口常在专家容量因子、重叠策略、内核选择等「配方文本」里。ATTUNE 把搜索改成改代码/配置的 agent 循环。
2. 方法
单 agent 做 reason–act:陈述假设 → 改一处 → 跑 profile → 诊断瓶颈。agent 外的确定性门控拒绝会改训练目标的旗标、判定测量是否有效、是否超过当前 leader;搜索结束后再做一致性检查。预算按 GPU-小时封顶,无人值守。
3. 核心贡献
把「调参」升级成「改配方」:搜索空间不再被旋钮表绑死,同时用门控防止 silent training change。可改的是配方文本,不可改的是训练语义——门控把两者拆开。
4. 实验
在多代 NVIDIA 集群上替换生产/基准配方:平均 +1.7×,峰值约 3.9×;对 NVIDIA AutoModel 已发布吞吐高 6–17%。留出模型(开发未见)上,跨场景配方迁移最高 +2.6×;vendor 已精细调过的面提升最小。同 GPU-小时预算下优于含贝叶斯优化在内的自动调参基线。
| 设置 | 观察 |
|---|---|
| H100/H200/B200 平均 | 吞吐 +1.7× |
| 峰值 | 约 +3.9× |
| vs AutoModel 发布配方 | +6–17% |
| 留出 MiniMax-M2 | 最高 +2.6× |
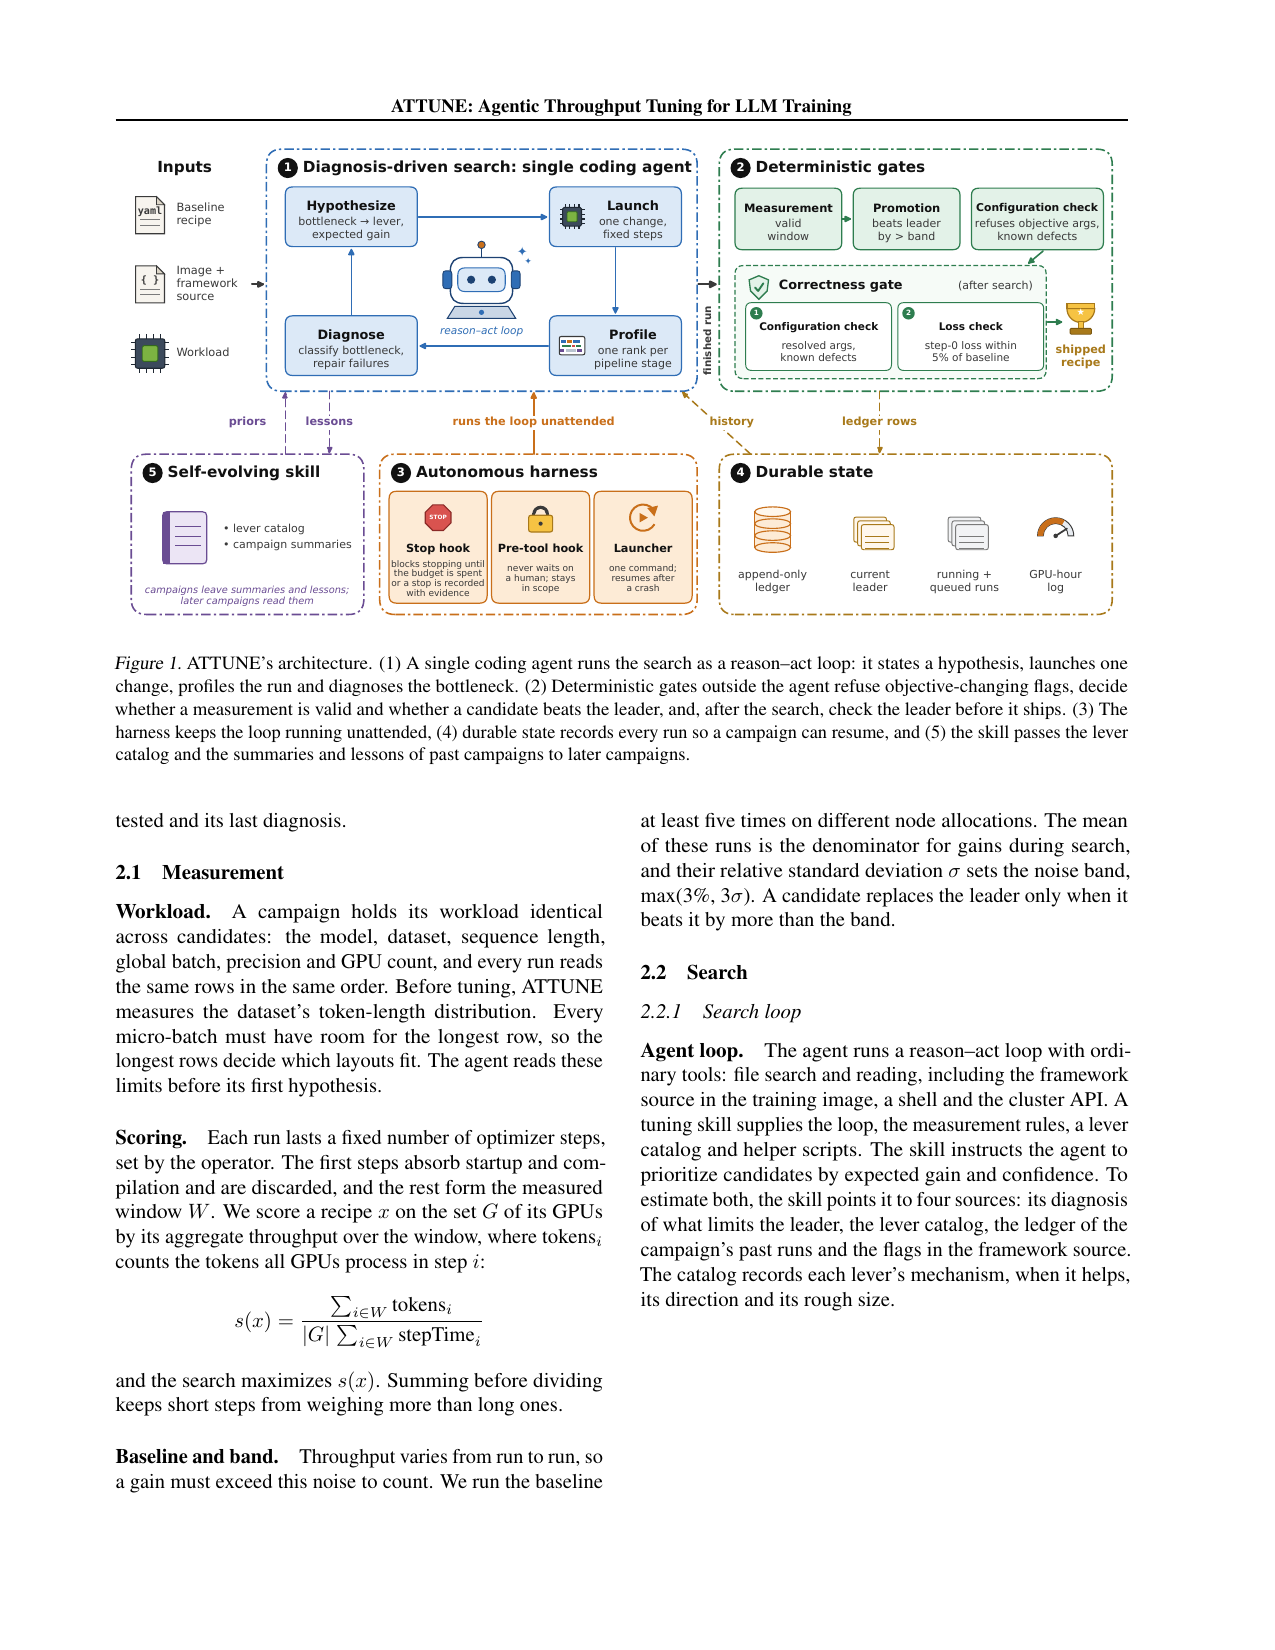
示意走查:一份 MoE 配方在 H100 上卡住通信。agent 假设 expert capacity 过大导致 token 路由不均,改一处 capacity 因子后重跑 profile;门控确认 loss 曲线未偏、吞吐上升则接纳。下一轮再动 overlap。整段搜索耗尽预算后输出最终配方与拒绝日志。
与「只搜并行度/微批」的自动调参相比,ATTUNE 能改到框架脚本里的非旋钮杠杆;代价是必须有强门控,否则 agent 可能打开会改数值结果的旗标。作者在多代集群与留出模型上验证:收益最大的往往是「别人写的配方迁到你的堆栈」,而不是在已 vendor 精调的面上再抠几个点。
5. 局限
依赖可跑的初始配方与可解析的 profile;门控规则需随框架版本维护;吞吐收益不等于收敛曲线不变,需回归 loss。
6. 实践意义
训练平台可把 ATTUNE 类 agent 挂在「新模型×新集群」接入流程;先跑门控白名单,再放 GPU-小时预算。