AGR 让生成式检索模型在需要时再查特征,而不是每次把用户的全部历史都读一遍。它一边生成候选内容的编码,一边决定是否调用意图、位置或历史行为工具。论文来自快手与复旦团队,关注的是工业搜索如何同时利用丰富特征、控制推理开销。
1. 为什么特征多,模型却未必用得好
生成式检索把“从海量内容中找结果”改写成预测一串短编码。语义 ID 就是这串编码:相近内容共享前面的部分,后面的部分再逐步区分具体物品。模型沿着编码树向下走,最终落到某条视频或商品。
工业系统已经积累了大量信息。搜索词表达即时意图,历史点击反映长期兴趣,地理位置和新鲜度要求则影响哪些内容合适。最直接的做法是把这些信息全部放进输入。然而,同一条特征对不同请求的作用并不一样。查询已经明确地点时,再注入位置可能只是增加重复信号;查询含糊时,它才可能改变结果。
时机也很关键。生成还在区分电影与游戏时,意图信息有帮助;已经进入某一类游戏之后,历史偏好才更适合区分具体内容。固定放在输入开头的特征无法显式控制这种差别。AGR 把“查什么、什么时候查”变成模型解码时的选择。
2. 把查特征接到生成过程里
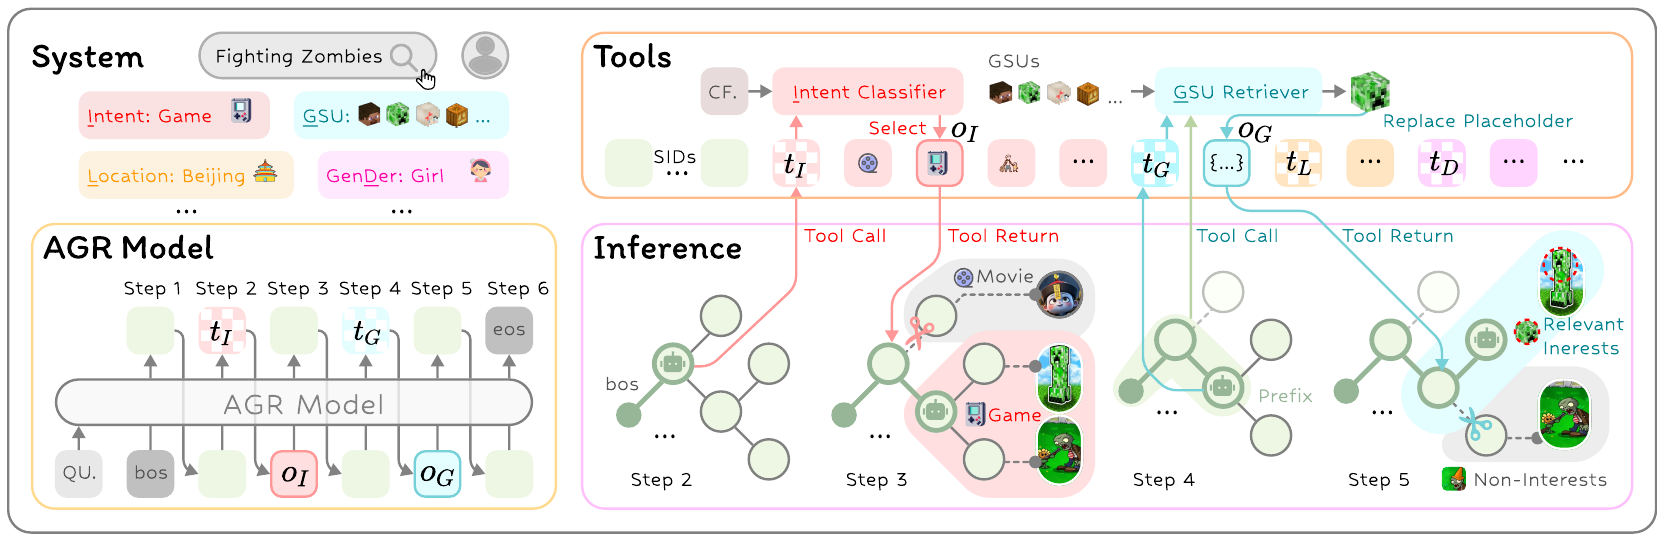
模型的词表增加了工具调用标记。每走一步,它可以继续输出物品编码,也可以输出一个调用标记。后者触发外部函数,返回的特征被压成一个观察标记,供下一步预测使用。调用标记负责发出动作,真正进入下一步上下文的是工具返回的观察。
这个区别避免把一长段工具说明塞回模型。位置、意图等离散属性各自映射到可学习的向量。观察有独立的位置表示,也不会把物品编码的层级向前推进。最后交付的仍然是物品编码,工具标记不会成为检索结果的一部分。
历史行为要复杂一些。它不是单个属性,而是一串已看、已点内容。论文提供两个版本。投票版只取编码前缀与当前生成路径相同的历史物品,统计下一层编码,返回出现最多的那个。注意力版则在向量空间寻找相近历史,再聚合它们的下一层信息,允许语义接近但前缀不完全相同的物品参与。
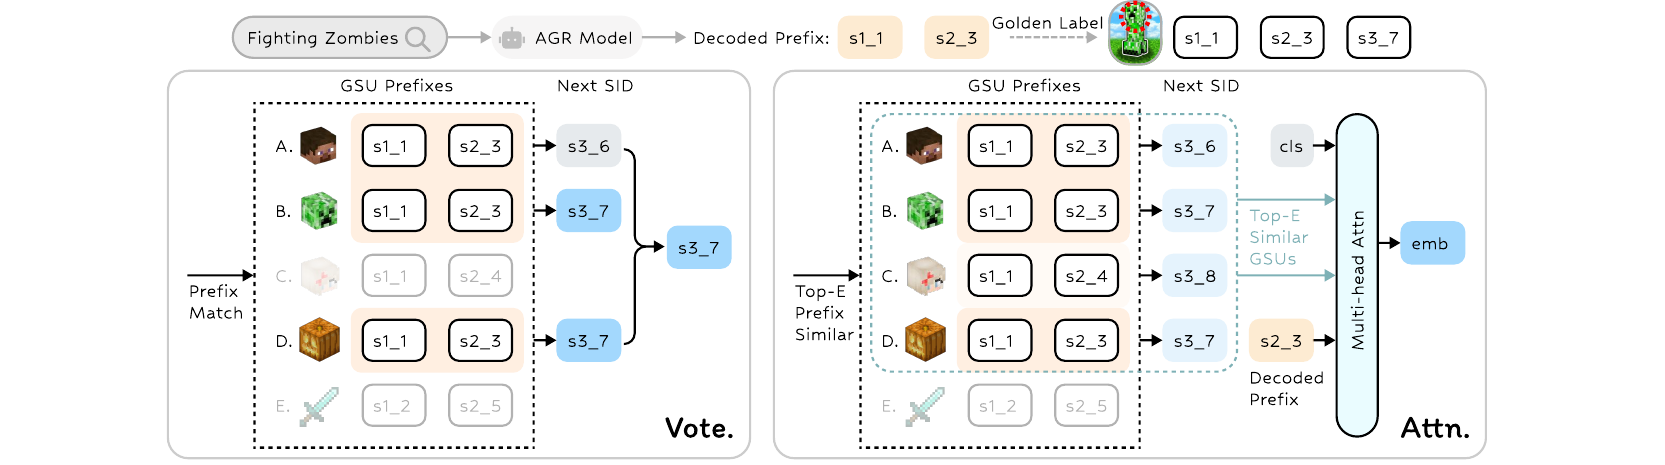
论文默认用投票版。这是一个实用选择:模型需要的未必是完整重读历史,而可能只是“走到这里,用户过去更常选择哪条分支”。工具返回的是针对当前路径压缩过的证据。
训练分为两段。先让模型只学习生成物品编码,再加入工具轨迹。作者用请求与正例的特征是否一致来判断一个工具是否适用,同时排除查询中已经明确表达的信息。插入层级则根据特征在哪一层最能缩小候选范围来确定。
这些调用示范来自规则构造,并不是强化学习自动探索出来的策略。新增工具标记的预测损失最初很大,容易扰动已有编码能力,作者还对工具损失做动态缩放。底座采用约 5.74 亿参数的编码器—解码器模型;注意力工具只取少量相近历史参与聚合。
推理时,每条束搜索路径单独管理调用额度。束搜索就是同时保留若干条尚未完成的候选路径。不同路径可以调用不同工具,甚至在不同深度调用。系统仍须检查编码是否合法,并在比较不同长度路径时做归一化,避免调用次数本身改变排名。
3. 这项工作的贡献落在哪里
最有价值的变化,是把特征使用从输入预处理移到了检索决策内部。同一个请求生成到不同前缀时,所需要的证据可以不同。历史工具也不再只返回一个固定用户向量,而是回答与当前分支有关的问题。
论文还把这套接口落到了训练数据与推理流程。只画出一个会调用工具的模型并不难;难点在于给它提供调用位置的监督,并让外部返回值与物品编码保持不同语义。作者通过两阶段训练、观察位置表示和调用额度,把这些约束写进了系统。
这也解释了它为什么区别于“多加一个意图特征”。特征本身并非新增,变化在于模型能选择什么时候读取它,以及它应当影响哪一步生成。判断这种设计是否成立,需要对比使用相同特征、但注入位置固定的版本。
4. 结果同时看召回和成本
下表汇总工业数据上的主要对照。召回率表示正确结果是否进入返回候选集,数值越高越好;最后两列仅在论文相同配置的历史编码实验内比较。
| 工业数据方案 | Recall@50 | 训练秒/步 | 服务成本:GPU/千请求 |
|---|---|---|---|
| 无特征基线 | 0.2863 | 1.163 | 2.38 |
| 直接编码长历史 | 0.3241 | 10.794 | 8.33 |
| 仅历史工具的 AGR | 0.3237 | 1.969 | 4.76 |
| 完整 AGR | 0.3264 | — | — |
历史工具与直接编码长历史的召回相近,训练时间却明显更低。服务成本从表中的长历史方案降低约 42.9%。这个比例对应的是两种利用历史的方法,不能拿来声称 AGR 比无特征检索还便宜:表中后者的服务成本更低。
另一组消融使用相同的特征,静态注入的召回为 0.3159,自适应注入为 0.3264。固定位置调用工具的版本落在两者之间。这支持“调用时机有用”,而不只是说明新增特征有效。公开数据也覆盖商品搜索与短视频搜索,不过增益大小因数据集和指标而异。
线上实验先做同流量配置的对照检查,再进行正式分流。论文报告平均服务延迟为 35 毫秒。强相关前四结果请求占比提升 0.205%,这是论文所定义的相关性指标,并非 nDCG,也不应改写成点击率增长。
这些结果有不同基线。离线主表对比普通生成式检索,线上则对比生产系统。报告线上收益时,要连同指标定义与基线保留,不能把离线相对增益当成线上收益幅度。
5. 哪些问题还没有解决
作者指出三个主要限制。工具示范依赖预设规则,还没有通过奖励学习联合优化调用收益与成本;工具集合较小;训练轨迹沿正确编码前缀构造,而上线时模型会走到自己生成、甚至已经偏离目标的前缀。
最后一点尤其具体。训练时工具在正确路径上很有帮助,并不意味着模型走错分支后仍能正确判断要查什么。后续可以专门评估模型生成前缀下的调用质量和错误恢复,而不是只在正确路径上统计工具命中。
此外,工业大样本与公开数据能够支持不同强度的结论。线上部署证明这套接口在快手环境可运行;它没有给出任意业务接入相同工具后的固定收益。低流量、历史稀疏或工具调用昂贵的场景,都可能改变成本收益关系。
6. 对搜索系统可以怎么借鉴
社区搜索可以从一个已经存在的特征工具切入,例如查询意图或近期点击。实验保留相同候选目录与编码,比较不使用特征、固定位置注入、自适应注入三组,同时记录相关性与请求耗时。这样能把特征质量和调用策略的作用分开。
历史工具值得单独做小规模验证。使用当前编码前缀筛选历史,返回下一分支投票,工程复杂度低于重新编码完整长序列。观察短历史用户、长历史用户和模糊查询的分组结果,能判断收益是否确实来自需要额外证据的请求。
上线监控还应保留每条生成路径的调用次数、工具耗时和调用后结果变化。论文的重要启发不是让所有检索都变成复杂智能体,而是让已经拥有的特征在最能区分候选的时刻发挥作用。