2026-10-21 周三 · Generative

独立报告页 · 在站内浏览(含往期切换)→
Generative生成式推荐 · 10 篇Personalization个性化推荐 · 10 篇AI SearchAI 搜索 · 10 篇Agentic智能体搜索 · 10 篇Infra系统与索引 · 10 篇

今日场景社区搜索 (UGC 短文本搜索): 用户在社区平台搜索帖子、问答、评论等 UGC 内容。 核心指标是搜索相关性 (nDCG) 和点击率 (CTR)。 关注:语义匹配、query 理解、短文本召回、排序模型、LLM 在搜索中的应用。 — 评分 172 篇,入选 10 篇,分数 3.50 – 4.50

本期目录 · 10 篇
  1. 01AGR: Agentic Generative Retrieval with Tool-Augmented Search
  2. 02Learning Complementary Agent Groups via Task Hypergraphs for Next-POI Recommendation with Missing Modalities
  3. 03Decision4Rec: A Jev-Inspired Framework of Decision Models on Knowledge and Active Graphs for Multi-Agent Recommender Systems
  4. 04Dialogue Generation for Conversational Recommendation Using User Search Interactions and Knowledge Graphs
  5. 05Generative Retrieval for Reverse Target Fishing with a Proteome-Scale Benchmark
  6. 06Evidence Before Sampling: Interpretable Implicit Negative Candidate Discovery for Recommendation
  7. 07Answering While You Type: Optimizing Time-to-Answer with Streaming Generation
  8. 08Token-Set Choice Confounds POPE: A Systematic Audit of Yes/No Extraction in VLM Hallucination Evaluation
  9. 09Kronecker Delta Rule for Long Context Linear Attention
  10. 10Competing Learning in Hybrid Architectures
LEAD STORY · 今日必读 · Kuaishou / Fudan

AGR: Agentic Generative Retrieval with Tool-Augmented Search

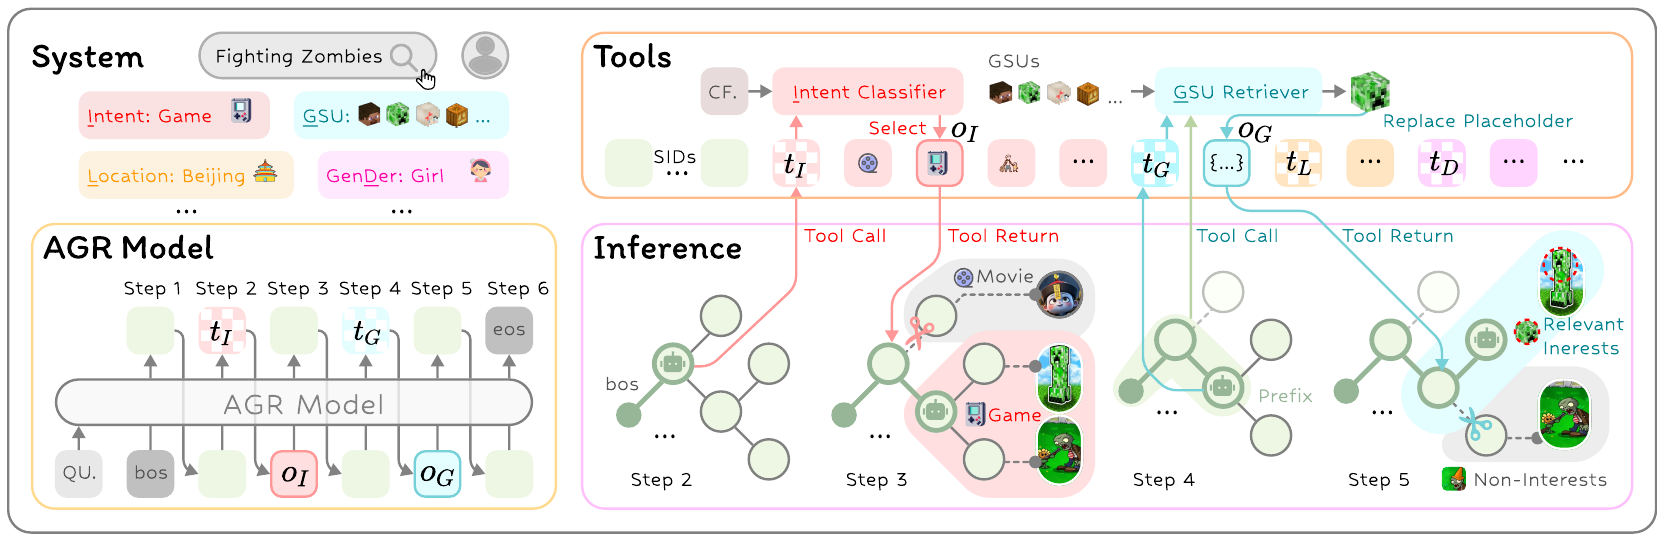
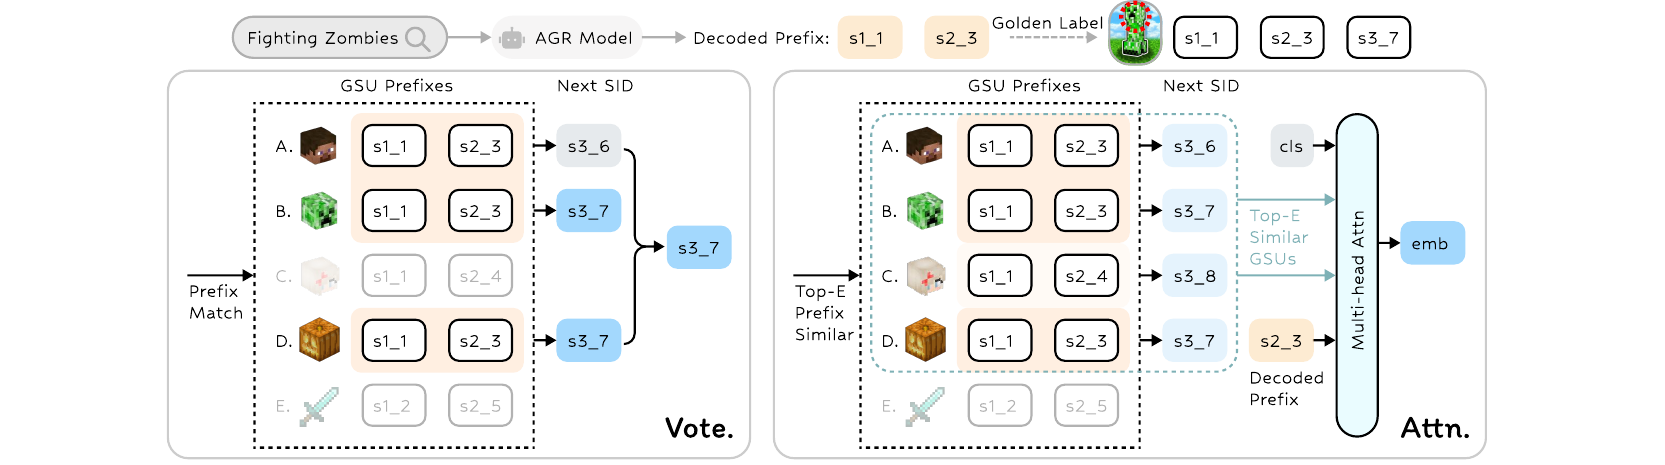
生成式检索不必把全部特征一次塞进模型。AGR 在生成物品短编码时,按当前分支调用意图、位置或历史行为工具,把结果压成观察标记继续解码。快手线上实验中,强相关前四结果请求占比提升 0.205%。

相关 5新颖 4实用 4证据 5时效 5
4.50
综合分 / 5
偏好调整 4.90
KEY INSIGHT · 对业务意味着什么特征是否有用取决于当前生成到了哪一层。把获取特征的时机也纳入预测,可以在保留个性化信号的同时减少长历史重复编码;工具调用成本仍高于完全不用特征的基线。
Ming Yang, Yaqi Yin, Zhibo Wang, Xiaoze Jiang, Jingwei Zhuo, Chao Zhang, Quanzhi Zhu, Weig... · Tue, 20 Oct 2026 00:00:00 -0400 · arXiv
独立页面阅读 ↗

今日其余入选

9 篇 · 按综合排名
02 4.10

Learning Complementary Agent Groups via Task Hypergraphs for Next-POI Recommendation with Missing Modalities

SwinburneAustralian Catholic UniversityUniversity of TennesseeUniversity of TokyoDeakin

地点推荐经常缺少图片或文字,固定的一组智能体容易重复分析。CATH 按当前请求挑选互补角色,让它们共享候选地点的证据,再修正基础排序。在自然缺失的三组数据上,NDCG@20 相对最强已测基线提升 8.4%—9.1%。

INSIGHT智能体数量不是唯一需要优化的变量,角色之间能否补足证据更关键。把组队策略与排序收益、计算开销一起训练,可以把预算花在真正缺信息的候选上。

Jinze Wang, Yuze Liu, Liang Yuan, Gaoyuan Du, Xiaohang Xu, Yong Xiang, Jiong Jin
arXiv·Tue, 20 Oct 2026 00:00:00 -0400·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
03 4.10

Decision4Rec: A Jev-Inspired Framework of Decision Models on Knowledge and Active Graphs for Multi-Agent Recommender Systems

University of BariOtto von Guericke UniversityLeibniz GEI

语言模型可以直接给选项概率,不必先生成推荐解释。Decision4Rec 将行为日志写成知识图谱事实,用智能体补充候选知识,再把决策模型输出与基础排序融合。在三个稀疏商品域,训练后的模型使 NDCG@10 提升 25%—36%。

INSIGHT收益主要来自候选相关知识,而不只是加入更多新候选。保留同一候选池,对比新增知识和模型规模的贡献,能避免把检索覆盖率提升误认为语言模型推理能力。

Marco Polignano, Het Darshan Mehta, Pasquale Lops, Ernesto William De Luca, Giovanni Semeraro
arXiv·Tue, 20 Oct 2026 00:00:00 -0400·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
04 3.75

Dialogue Generation for Conversational Recommendation Using User Search Interactions and Knowledge Graphs

KAISTLG

构造对话推荐数据不一定从人工写剧本开始。SearCl 从真实搜索和点击中确定目标,用可配置状态机约束双方大模型的对话,并通过商品知识图谱提供事实。作者生成了 3,538 段对话,质量比较采用大模型裁判。

INSIGHT真实点击可以约束推荐目标,状态机则控制对话如何推进。这种拆分让数据生成更可控;模型裁判给出的流畅度评价,仍不能替代真实用户是否接受推荐的检验。

Minsung Hwang, Donggyu Yoon, Gowoon Hwang, Kwanghee Jang, Joyce Jiyoung Whang
arXiv·Tue, 20 Oct 2026 00:00:00 -0400·Relevance 4 · Novelty 3 · Practical 4 · Evidence 3 · Timely 5
05 3.50

Generative Retrieval for Reverse Target Fishing with a Proteome-Scale Benchmark

AIPherTsinghuaPeking University

药物靶点检索也会遇到大量“没有记录但未必无效”的关联。GenFish 给蛋白质分配共享短编码,再根据分子信息生成编码,避免把全部未知关联当负例。作者构建的评测目录包含 20,431 个人类蛋白质。

INSIGHT生成式检索的一个价值是改变未知样本的处理方式,而非仅替换检索器结构。这里的蛋白质实验提供了不完整监督下的对照设计;业务对象与社区帖子不同,值得借鉴的是假负例分析。

Zhichao Deng, Haichuan Tan, Xin Hong, Huaizhi Wang, Tao Huang, Bowen Gao, Yanyan Lan
arXiv·Tue, 20 Oct 2026 00:00:00 -0400·Relevance 2 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
06 3.90

Evidence Before Sampling: Interpretable Implicit Negative Candidate Discovery for Recommendation

IntuitMichigan State

没有发生的交互不等于用户不喜欢。作者从已观察行为提取规则,按统计证据筛选潜在负例,再用大模型解释它们与业务目标的关系。工业任务中,每个正例配四个负例时,测试 PR-AUC 比随机选择提升 12.5%。

INSIGHT先判断负例有没有证据,再衡量训练收益,可以区分“模型学得更好”和“标签本身更可信”。对稀疏搜索点击数据,这一拆分尤其适合审查未曝光内容被误标为负例的问题。

Shreya Rajpal, Sonia Sharma, Swapnil Parekh, Lisa Li, Jeyendran Balakrishnan, Nagaraj Janardhana, An...
arXiv·Tue, 20 Oct 2026 00:00:00 -0400·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 3
07 3.75

Answering While You Type: Optimizing Time-to-Answer with Streaming Generation

用户还在输入时,回答计算就可以开始。论文让模型根据不完整请求起草答案,输入更新后验证并改写,把部分计算移到提交之前。ReFusion-8B 在 HumanEval 上的提交后耗时中位数加速 3.68 倍,准确率保持不变。

INSIGHT用户等待时间和总计算量是两个指标。提前计算可以降低提交后的等待,但不同任务收益差异很大;真实对话的收益远小于开头就交代完整要求的代码题。

Nikita Dragunov, Matvey Mikhalchuk, Anton Razzhigaev
arXiv·Tue, 20 Oct 2026 00:00:00 -0400·Relevance 4 · Novelty 3 · Practical 4 · Evidence 3 · Timely 5
08 3.80

Token-Set Choice Confounds POPE: A Systematic Audit of Yes/No Extraction in VLM Hallucination Evaluation

一次评测读取哪些词元,就可能改变模型的幻觉分数。作者发现常用的“是或否”读取漏掉了带前导空格的回答形式,统一后重新评估视觉语言模型。仅修正读取规则,POPE 对抗拆分的 F1 就移动 6.13 个百分点。

INSIGHT测量接口也属于实验设置。比较不同模型或提示词之前,核对答案归一化、空格和词元映射,能排除把评测脚本差异误报成模型能力提升的情况。

Kesav Kumar Jayakumar, Karthigeyan Thilak
HuggingFace·2026-10-18·Relevance 3 · Novelty 3 · Practical 5 · Evidence 4 · Timely 5
09 3.80

Kronecker Delta Rule for Long Context Linear Attention

长上下文模型不断写入新记忆时,也可能干扰已经记住的内容。KronLSTM 用更局部的矩阵更新修正关联,减少对其他记忆的破坏。在长文本事实检索套件上,混合模型的六任务平均准确率达到 37.40%。

INSIGHT记忆更新的影响范围值得单独控制。它提供了长历史建模的底层思路,但论文测的是语言与上下文检索任务,尚未给出商品推荐或搜索点击收益。

Anamaria-Roberta Hartl, Levente Zólyomi, Michael List, Günter Klambauer, Sebastian Böck
HuggingFace·2026-10-18·Relevance 3 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
10 3.80

Competing Learning in Hybrid Architectures

Tsinghua

把循环层和注意力层放进同一模型,不保证它们会自动分工。作者发现先学会检索的层会压低另一类层的学习信号,并用分阶段训练改善分工。在一个 Gated DeltaNet 混合模型实验中,Recall 从 17.33 提升到 32.05。

INSIGHT结构互补不等于优化过程互补。通过冻结阶段和逐层归因,可以检查长历史模型是否真正使用了预期模块,而不是让便宜模块抢走全部训练信号。

Xingyu Shen, Yingfa Chen, Ziqing Qiao, Chaojun Xiao, Xu Han
HuggingFace·2026-10-18·Relevance 3 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5

其他赛道今日

点击切换
Personalization
10
个性化推荐 · 篇入选
AI Search
10
AI 搜索 · 篇入选
Agentic
10
智能体搜索 · 篇入选
Infra
10
系统与索引 · 篇入选

开源雷达

GitHub / HuggingFace 热门 · 8 个项目
TacoTakumi/VoiceManagerA low latency streaming STT / STT server to add a voice to your LLM. Also supports batch mode.Python · ★ 21 · 2026-10-17 · GitHubernie-research/DCoreMore accepted tokens ≠ faster LLMs. This repo reveals how fair comparisons reshape drafter rankings—and when better acceptance pays off in throughput.★ 19 · 2026-10-20 · GitHubEliotAndres/iphone-use-appAn iPhone app where an LLM controls the phone it runs onC · ★ 16 · 2026-10-19 · GitHubdeepseek-ai/DeepSeek-V4.1-Flashpipeline: image-text-to-text; tags: transformers, safetensors, deepseek_v41, text-generation, image-text-to-text, conversational, license:mit, eval-resultsmodel · ★ 4669 · 2026-09-10 · HuggingFacezai-org/GLM-5.3-Flashpipeline: image-text-to-text; tags: transformers, safetensors, glm5_next, image-text-to-text, conversational, en, zh, arxiv:2602.15763model · ★ 2897 · 2026-08-25 · HuggingFacezai-org/GLM-5.3pipeline: text-generation; tags: transformers, safetensors, glm_moe_dsa, text-generation, conversational, en, zh, arxiv:2602.15763model · ★ 2272 · 2026-08-25 · HuggingFacedeepseek-ai/DeepSeek-V4.1-Flash-1017pipeline: image-text-to-text; tags: transformers, safetensors, deepseek_v41, text-generation, image-text-to-text, license:mit, endpoints_compatible, 8-bitmodel · ★ 1930 · 2026-10-17 · HuggingFacestepfun-ai/Step-5-Previewtags: safetensors, step5_vl, license:other, eval-results, fp8, region:usmodel · ★ 118 · 2026-09-20 · HuggingFace