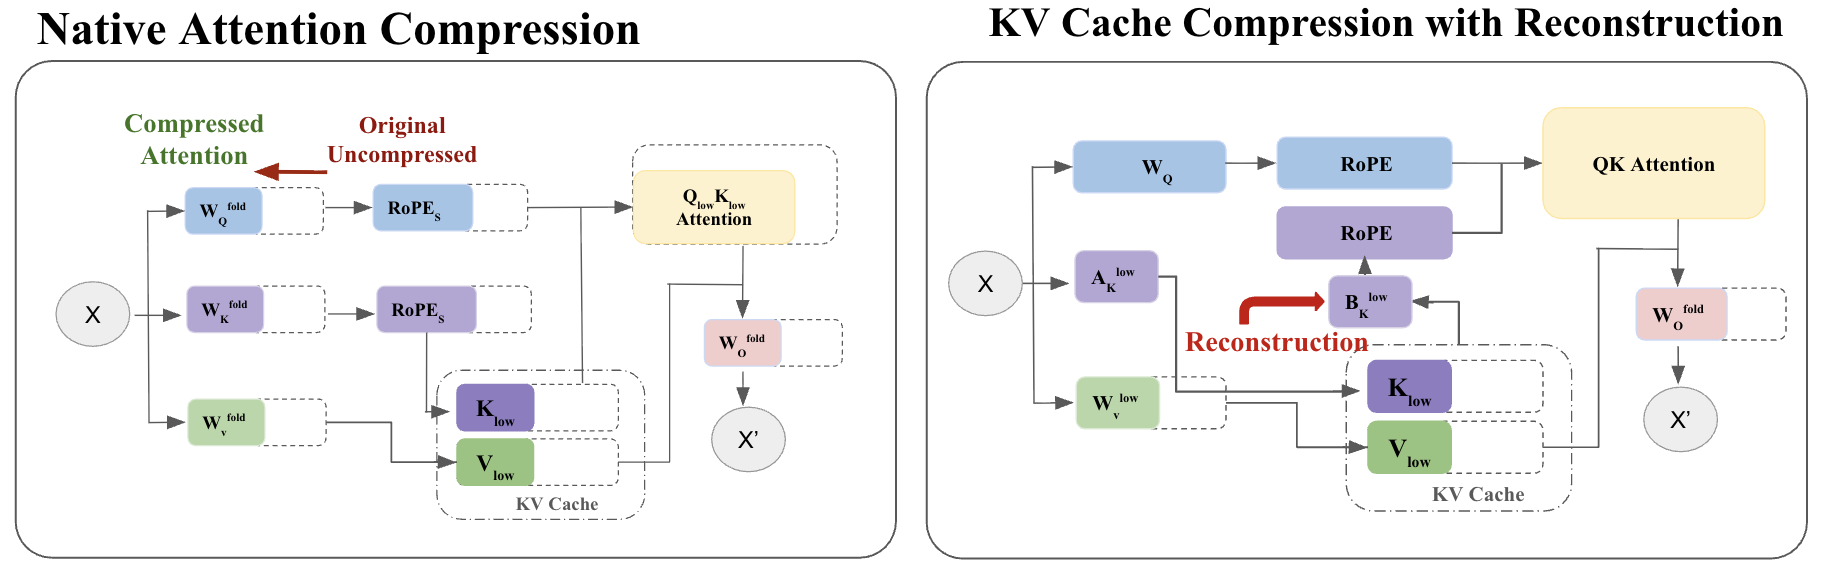
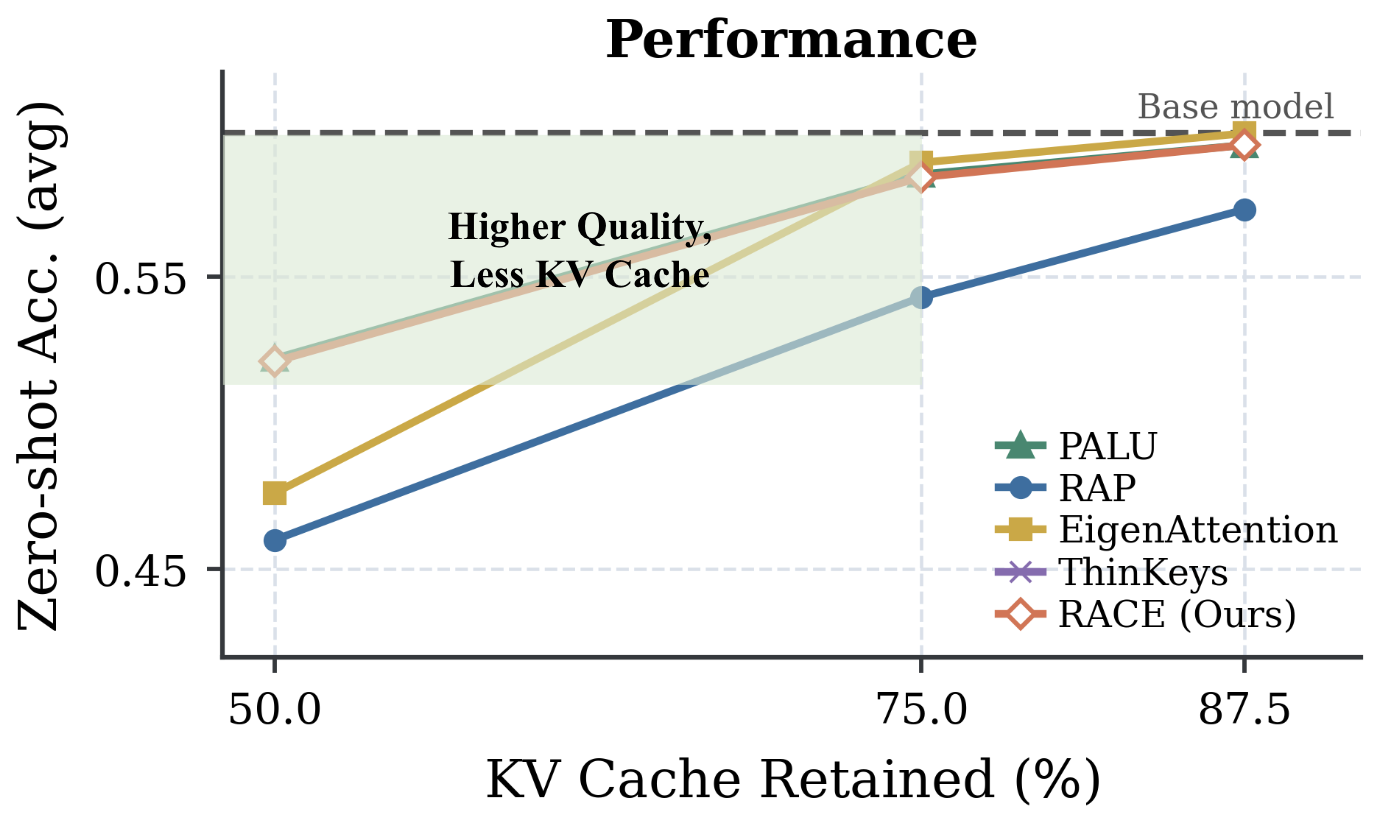
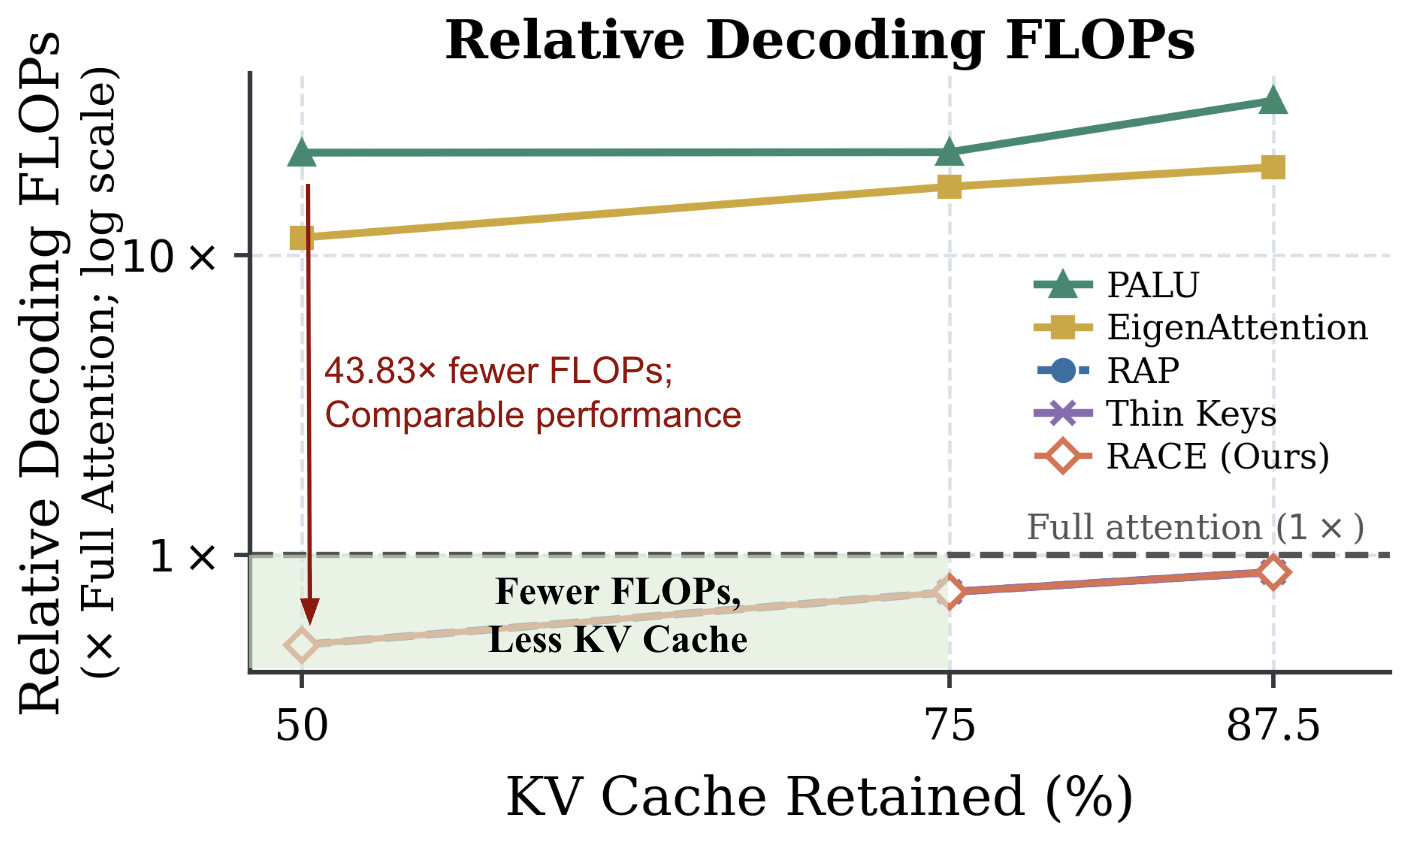
头维压缩 KV cache 常在推理时再还原全维,解码 FLOPs 反而涨。RACE 用校准集把预训练注意力改成原生降维:对 Q/K 共享投影并保持 RoPE 对齐,按 query-key 激活能量决定保留哪些能量方向,使 KV 存储与注意力算力一起降。50% KV 保留、256K 上下文时,总推理 FLOPs −47.8%,吞吐 1.79×,TTFT −43.2%,分配显存 −28.1%。相对 EigenAttention / PALU / Thin Keys / RAP,RACE 在「保留 RoPE、共享投影、降存储、降注意力 FLOPs、免推理还原」清单上全部勾选。头维压缩要原生降维,而不是推理时再拼回全维。
1. 问题
KV 变长拖垮显存与带宽;只压 token 或量化不够时,有人压头维。若解码期重建全维 K/V,省下的显存会换成 FLOPs 税。需要校准期一次性改成降维注意力。
2. 方法
共享投影把 Q/K 映到同一低维空间,旋转位置编码在低维上仍对齐;用激活能量选主方向,V 同步压缩。校准集约一次;推理不再上投影回全维。可与 token 减少、量化叠加(文中有组合实验)。
3. 核心贡献
把「压缩」从缓存格式问题提升为注意力算子本身的降维,且不破坏 RoPE 几何。省显存的同一套投影也应省注意力算力。
4. 实验
Llama/Qwen 系列在零样本、困惑度、LongBench 上对比。50% 保留 + 256K:FLOPs −47.8%,吞吐 1.79×,TTFT −43.2%,显存 −28.1%。对照表显示竞品常在「推理重建」或「不保 RoPE」上留缺口。
| 设置 | 结果 |
|---|---|
| KV 保留 | 50% |
| 上下文 | 256K |
| 总推理 FLOPs | −47.8% |
| 吞吐 | 1.79× |
| TTFT | −43.2% |
| GPU 显存 | −28.1% |
5. 局限
校准集域偏移会影响能量方向;与激进量化叠用时要重扫保留比例;超长上下文的端到端速度还受别的算子影响。
6. 实践意义
服务侧若 KV 显存紧,优先试「原生降维注意力」而非「压完再还原」;保留 50% 作为默认扫描点,看 TTFT 与 LongBench 是否可接受。