Agent 长轨迹里 KV 读写与存储成主成本;改历史前缀会让后续 cache 失效并重 prefill。本文提出缓存工程:agent 用 drop 排除选中 cache、用 repos 调整保留 key 的位置索引,从而直接控制活跃 KV,而不改写轨迹文本。相对阈值触发摘要,简单工具响应 drop 策略平均成本 −27.7%、基准分 +1.7;接 AKV 后输出吞吐约 1.2×、P95 延迟约 1.5× 改善;RSI 自改进策略在留出任务再降成本 7.1%。API 账单里 KV 读可占 82.4%。Agent 省钱的关键常是别让 cache 失效,而不只是把历史摘要得更短。
1. 问题
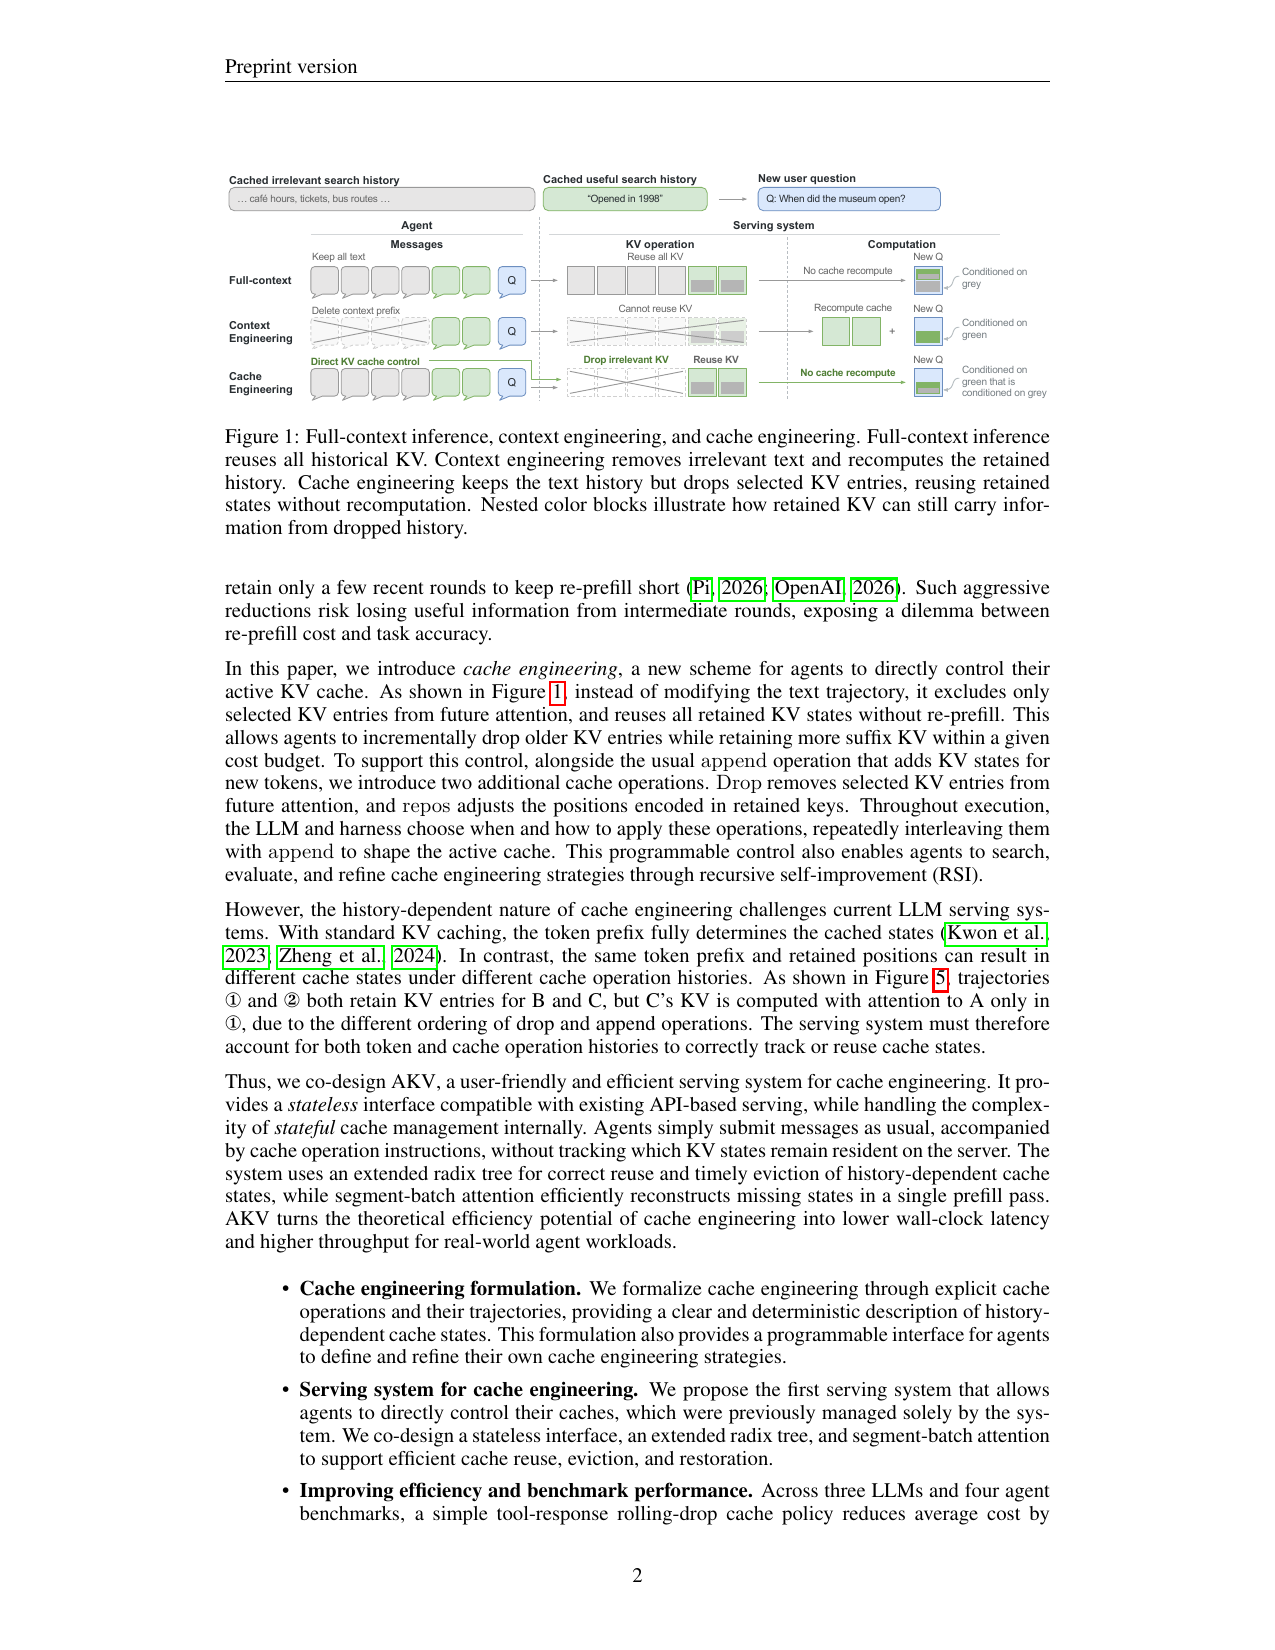
上下文工程靠修剪/摘要减长度,但改前缀使后缀 KV 作废。账单显示 KV 读可占八成以上费用。需要「动 cache、不动文本」的控制面。
2. 方法
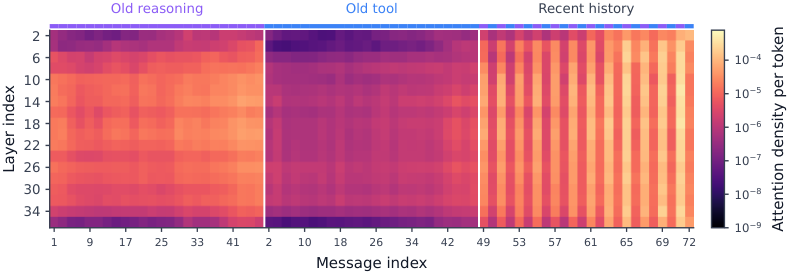
暴露 drop / repos 原语:drop 让后续注意力看不到选中段;repos 在不改内容的前提下改位置编码索引。策略可手写(如丢工具回包),也可用递归自改进(RSI)在留出任务上搜策略。
3. 核心贡献
把优化对象从「提示词字符串」换成「活跃 KV 集合」。保留前缀字节不等于保留前缀 cache——失效一次就重付 prefill。
4. 实验
三模型×四 agent 基准:工具响应 drop 相对阈值摘要,成本 −27.7%、分数 +1.7;AKV 上吞吐 ~1.18–1.2×、P95 ~1.5×;RSI +7.1% 成本再降。阈值摘要(如 48k)可降约 7% 成本但准确率掉约 5 个百分点,说明乱摘要会伤任务。
| 策略 | 成本 | 质量/系统 |
|---|---|---|
| 工具响应 drop | −27.7% | 分 +1.7 |
| +AKV | — | 吞吐 ~1.2×,P95 ~1.5× |
| +RSI | 再 −7.1% | 留出任务 |
5. 局限
依赖可写的 cache API(如 AKV);drop 策略过猛会丢关键工具结果;RSI 搜索本身有费用。
6. 实践意义
Agent 运行时优先接「可 drop 的 KV 层」;默认先丢可重建的工具回包,再考虑摘要。
补充:正文数字均摘自论文表格与实验节;配图为论文 HTML/PDF 原图或页渲染,图注说明看点而非翻译英文 caption。