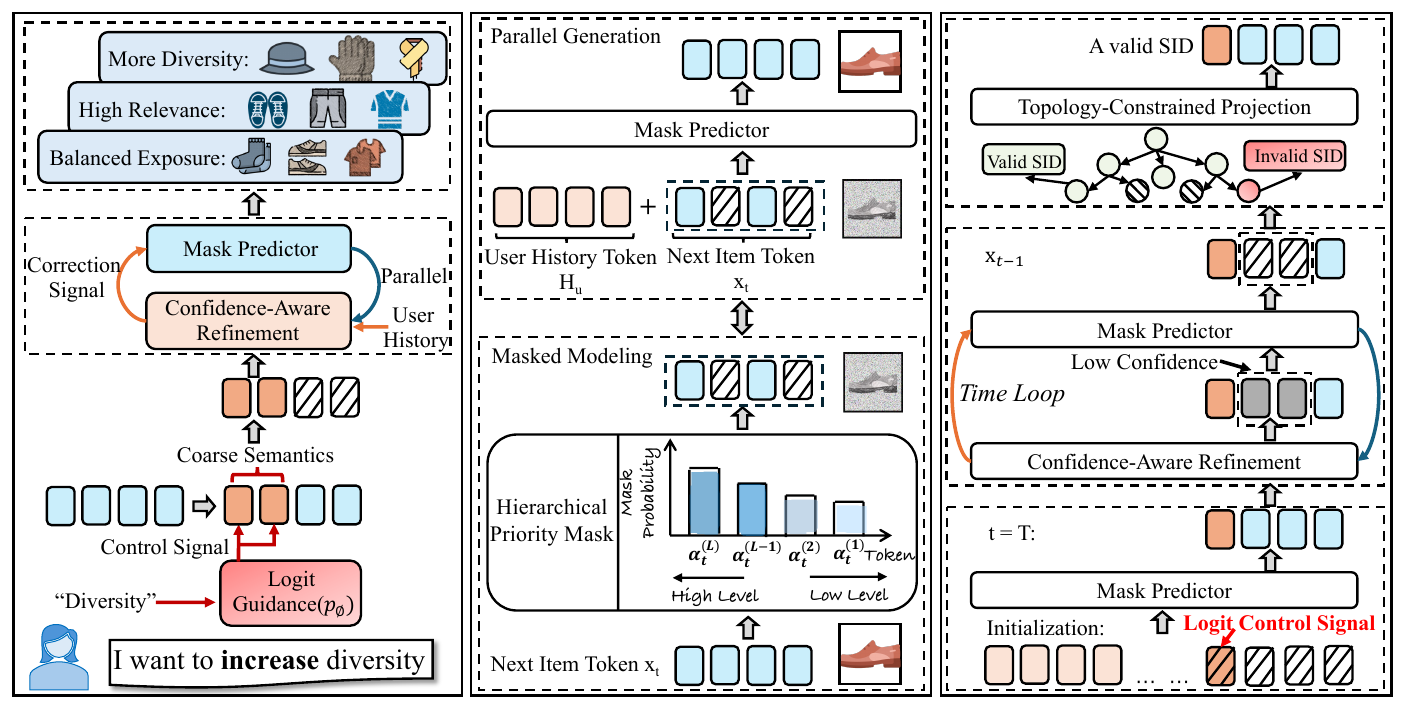
生成式推荐先把每个物品编码成一串离散 token(Semantic ID,语义 ID),再让模型根据用户历史逐个生成下一个物品的 token。业务上常有临时需求,比如大促中途想让推荐结果覆盖更多品类,这时重训模型太慢,在左到右的解码过程中强行改某个 token,又常常拼出目录里不存在的 ID。西交利物浦大学这篇 ReGen 换了解码方式:模型一次性预测一个物品 ID 的全部 4 个 token,推理时只在最粗的那几位 token 上加一个"往用户没看过的类目偏"的分数,再把置信度低的 token 遮住重新预测,并用目录里所有合法 ID 组成的前缀树把不可能补全成真实物品的 token 排除掉。整个控制过程不改模型参数。在 Amazon 2023 的 Instruments 和 Scientific 两个品类上,把 top-10 的类目覆盖率(Diversity@10)从 0.41 拉到 0.59 时,Instruments 上 Recall@10 只从 0.0427 降到 0.0394,而对比方法 TIGER-MMR 从 0.0433 掉到 0.0319。代价是纯准确率不是最好:不加多样性要求时,Recall@10 落后于 Paragon,在 Video Games 上也不如 SASRec、RPG 和 LLaDA-Rec。
1. 问题:为什么左到右生成难以在推理时加控制
这篇用 RQ-VAE 给物品编码:先用 Sentence-T5 把物品标题和文本元数据编码成向量,再用 4 层残差码本逐层量化,每层 256 个码字,于是每个物品对应 4 个 token 。残差量化的特点是第 1 位决定大方向,后面几位逐步补细节,所以前几位大致对应品类这一层的语义。
TIGER 这类模型按 的顺序生成,第 1 位一旦选定,后面每一位都只能在它下面接。作者把这个现象叫"决策锁定":想提高多样性,只能在生成中途改某一位,但后面的 token 是以原来的前缀为条件训练出来的,改完之后经常拼出目录里没有的组合。现有的另外两类办法也各有问题:训练时把控制目标写进参数(如 Paragon),目标一变就要重训;生成后再重排(如 MMR),只能在已经生成出来的候选里挑,候选本身不够多样时无能为力。
2. 方法:三步改造
2.1 一次预测全部 token
ReGen 用一个 BERT 式的双向 Transformer 编码器。输入是用户历史物品的语义 ID 序列,加上一个待填的 4 位 ID,其中一部分位置是已知 token,其余位置写成 [MASK]。模型对每个 [MASK] 位置同时输出一个 256 维的分数向量,softmax 后就是这一位取各个码字的概率。因为是双向注意力,预测 时能同时看到 、 和 。
训练时做了一个设置:粗粒度位置被遮住的概率更低()。这样模型更常见到"前几位已知、后几位要补"的情形,正好对应推理时"前几位被控制信号固定、后几位让模型补"的用法。
2.2 只在粗粒度 token 上加控制分
以多样性为例,控制目标是让推荐结果落到用户历史里少见的品类。具体操作是:统计用户历史物品在前 个粗粒度位上各个码字出现的频率,给出现多的码字一个负分,得到控制分向量 。推理时,前 位的模型输出分数加上 ,后面的位不动:
越大,模型越倾向选用户没怎么看过的大类。细粒度的几位不加偏置,交给模型在新的大类下重新补全。
2.3 低置信度重预测 + 前缀树约束
粗粒度位被推到一个新大类后,原来补好的细粒度 token 可能和它对不上。ReGen 每一轮取每一位的最大 softmax 概率作为置信度,低于阈值的位重新换成 [MASK],再交给模型预测一次,高置信度的位留着当已知条件。默认跑 $T=4$ 轮。
并行预测还有一个风险:4 位各自选最高分,组合起来可能不是任何一个真实物品。作者把目录里所有物品的 ID 建成前缀树,每一位只允许取那些和已定的位能组成至少一条完整合法路径的码字,其余码字的分数直接设为负无穷。
推理时用 beam 保留 50 条候选,每一步保留 100 个合法扩展。最后把候选 ID 映射回物品、去重、去掉用户已经交互过的物品,再贪心组出 top-10:每次选"控制后的生成分 + × 加入后新增覆盖的品类数"最大的物品。
3. 实验
数据是 Amazon 2023 Review 里的三个品类:Instruments(57,439 用户、24,587 物品)、Scientific(50,985 用户、25,848 物品)、Video Games(94,762 用户、25,612 物品),留一法评估,最后一个交互做测试。编码器在 Instruments 和 Scientific 上 4 层,Video Games 上 6 层,嵌入维度 256,从头训练。
3.1 不加控制时,准确率够不够用
这组实验检验换成并行填空式解码后,基础推荐能力有没有明显损失。设置是按验证集准确率选 ReGen 的配置,和 9 个基线比 Recall 和 NDCG。下表只摘 Recall@10:
| 数据集 | SASRec | RPG | LLaDA-Rec | Paragon | TIGER-MMR | ReGen |
|---|---|---|---|---|---|---|
| Instruments | 0.0545 | 0.0545 | 0.0535 | 0.0861 | 0.0496 | 0.0646 |
| Scientific | 0.0392 | 0.0395 | 0.0407 | 0.0715 | 0.0374 | 0.0491 |
| Video Games | 0.0916 | 0.0853 | 0.0895 | 0.0842 | 0.0648 | 0.0726 |
ReGen 在前两个品类排第二,Paragon 明显更高;Video Games 上落后于 SASRec、RPG、LLaDA-Rec。作者自己的结论是:这个结构提供了可用的准确率底子,但不是为纯准确率设计的。
3.2 同样的多样性下,谁的准确率掉得少
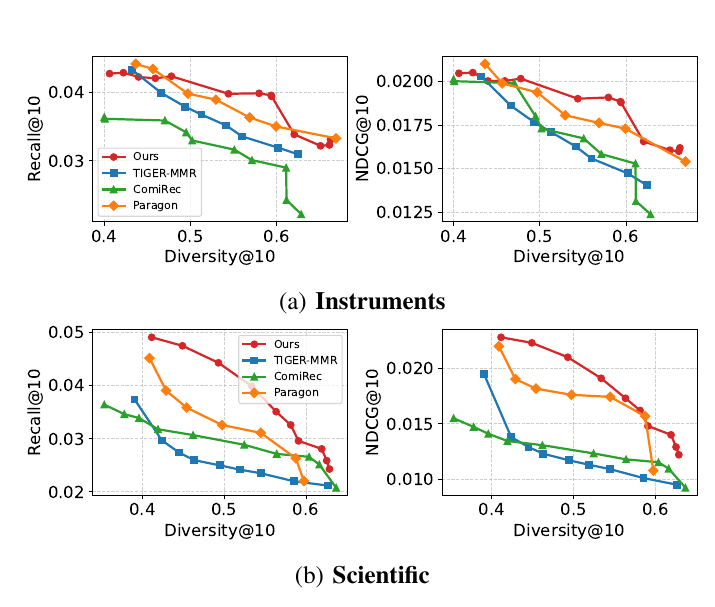
这是论文的主实验,检验推理时加控制的效果。做法是对每个方法调节各自的多样性旋钮(ReGen 调 ),画出 Diversity@10 和 Recall@10 / NDCG@10 的曲线,曲线越靠右上越好。
| 数据集 | 多样性水平 | ReGen | TIGER-MMR | ComiRec | Paragon |
|---|---|---|---|---|---|
| Instruments | 约 0.54 | 0.0398 / 0.0190 | 0.0351 / 0.0163 | 0.0316 / 0.0167 | – |
| Scientific | 约 0.56 | 0.0351 / 0.0173 | 0.0235 / 0.0109 | 0.0272 / 0.0118 | 0.0311(仅 Recall) |
表中格式为 Recall@10 / NDCG@10。Instruments 上多样性从 0.41 拉到 0.59,ReGen 的 Recall@10 从 0.0427 降到 0.0394,NDCG@10 从 0.0205 降到 0.0188;同一区间 TIGER-MMR 的 Recall@10 从 0.0433 掉到 0.0319。也就是说,ReGen 在这一段几乎是平的。Scientific 上多样性推到 0.59 左右时,ReGen 的 Recall@10 仍是最高的 0.0296。
3.3 三个部件各自管什么
消融在统一的"偏多样性"推理设置下做,每次只去掉一个部件:
| 变体 | Instruments R@10 | D@10 | 合法率 | Scientific R@10 | D@10 | 合法率 |
|---|---|---|---|---|---|---|
| ReGen 完整 | 0.0339 | 0.5606 | 99.97% | 0.0414 | 0.5051 | 99.97% |
| 去掉控制分(λ=0) | 0.0355 | 0.4851 | 99.97% | 0.0436 | 0.4644 | 99.97% |
| 去掉重预测 | 0.0130 | 0.7321 | 99.97% | 0.0267 | 0.7307 | 99.97% |
| 去掉前缀树 | 0.0136 | 0.0001 | 27.63% | 0.0315 | 0.0151 | 29.76% |
三行分别说明三件事。去掉控制分后准确率略升、多样性回落,说明多样性主要来自控制分。去掉重预测后多样性冲到 0.73,但 Instruments 的 Recall@10 从 0.0339 掉到 0.0130:粗粒度位被推到新大类后,细粒度位没有跟着调整,推出来的是品类分散但和用户无关的物品,作者称之为"虚假多样性"。去掉前缀树后,生成的 ID 只有不到 30% 能对应到真实物品,说明 4 位 token 的组合空间里绝大部分是空的。
3.4 参数和速度
在 4 到 12 之间效果稳定,超过 20 后重预测拉不回来,准确率明显下降。重预测轮数 在 4 左右收敛,更多轮基本不再提升,评估耗时却继续涨:Instruments 上 从 1 到 8,整个评估时间从 41 分钟增至 114 分钟。论文只给了全量评估的总耗时,没有给单请求延迟。
4. 局限
实验只做了品类多样性这一种控制目标,公平性、新鲜度、曝光均衡这些作者都列为后续工作。多样性指标是 top-10 的品类覆盖率,论文自己也说这是一个简化的代理指标。控制效果依赖 RQ-VAE 的前几位确实对应品类,码本学得不好时,在粗粒度位上加分未必能换来品类变化。另外三个数据集都只有两万多个物品,前缀树和 50 条 beam 在千万级物品库上的开销没有测。
5. 实践意义
如果已经在用语义 ID 做生成式召回,这篇提供了一个不重训就能加运营目标的思路:控制分只加在 ID 的前几位上,后几位交给模型重新补,再用前缀树兜住合法性。消融里"去掉重预测后多样性很高但召回崩掉"这一行提醒我们:多样性指标高可能只是推荐了和用户无关的物品,单看这个指标会误判方法有效。落地前需要自己补两样东西:线上单请求延迟(4 轮重预测加 50 条 beam),以及在自家码本上验证粗粒度位和品类的对应关系。