2026-10-23 周五 · Generative

独立报告页 · 在站内浏览(含往期切换)→
Generative生成式推荐 · 10 篇Personalization个性化推荐 · 10 篇AI SearchAI 搜索 · 10 篇Agentic智能体搜索 · 10 篇Infra系统与索引 · 10 篇

今日场景社区搜索(UGC短文本搜索):关注搜索相关性nDCG、CTR、query理解、短文本召回和LLM搜推应用。 — 评分 126 篇,入选 10 篇,分数 3.20 – 4.10

本期目录 · 10 篇
  1. 01Controllable Generative Recommendation via Guided Token Refinement
  2. 02From Habits to Discovery: Deploying LLMs for Personalized Generative Recommendations at Spotify
  3. 03Where Do LLMs Learn to Recommend AI?
  4. 04Transaction Foundation Models for Retrieval-Augmented Generation over Financial Transaction Data: A Comparative Evaluation with Text Embeddings
  5. 05A Diagnostic Study of Faithfulness in Diffusion Language Models for Table-to-Text Generation
  6. 06Don't Stop Long-Context Continual Pre-Training Too Early: An Empirical Scaling Law
  7. 07CSD: Common-Support Distillation for Cross-Tokenizer Knowledge Transfer
  8. 08DiffResearch: Accelerating Deep Research with Diffusion Language Models
  9. 09TraceForge: Distilling with Your Own Thinking
  10. 10Build more responsive apps with the Decisions API
LEAD STORY · 今日必读 · XJTLU / University of Liverpool / PolyU

Controllable Generative Recommendation via Guided Token Refinement

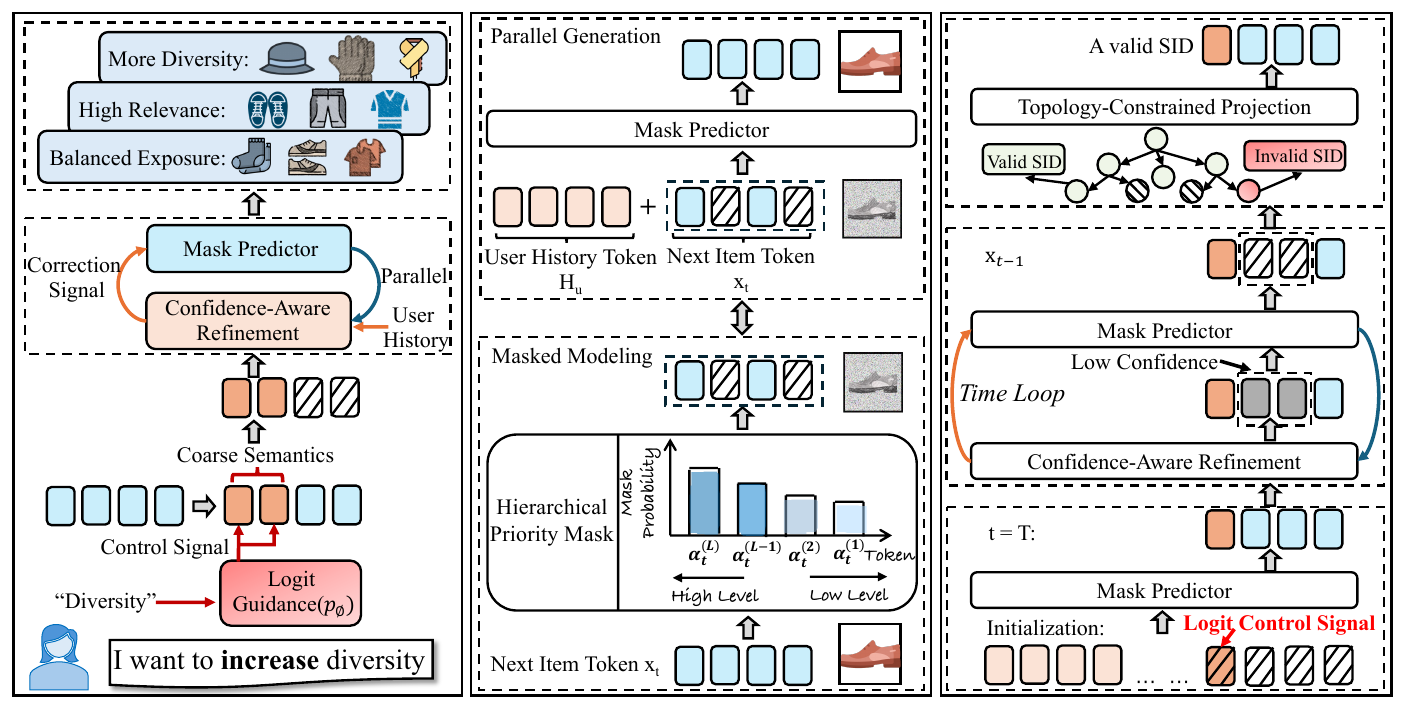
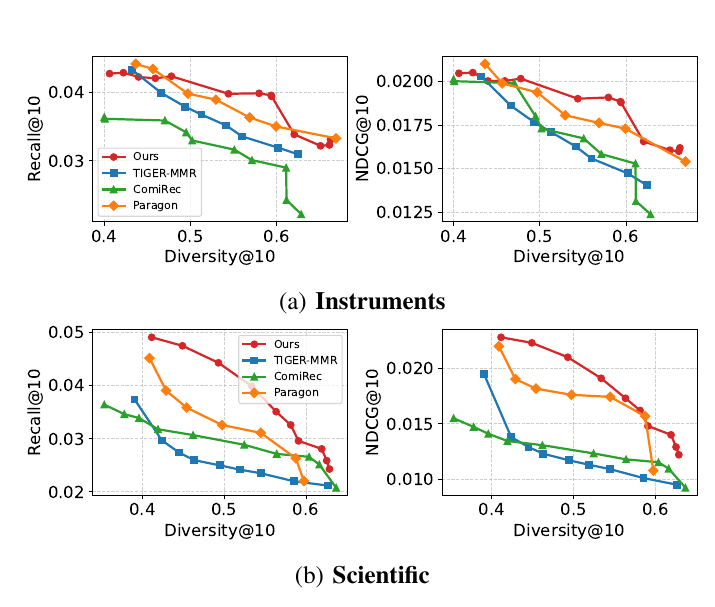
生成式推荐按左到右逐个生成物品 ID 的 token,推理时想临时提高多样性,只能中途改某一位,结果常拼出目录里不存在的 ID。ReGen 改用双向 Transformer 一次预测 ID 的全部 4 位,只在最粗的几位上给用户历史里常见的 token 值减分,再把置信度低的位遮住重新预测,并用全部合法 ID 建成的前缀树排除补不成真实物品的 token 值,全程不改模型参数。Amazon Instruments 上把 top-10 品类覆盖率从 0.41 提到 0.59,Recall@10 只从 0.0427 降到 0.0394,TIGER-MMR 同区间从 0.0433 掉到 0.0319;去掉前缀树后只有 27.63% 的 ID 对应真实物品。

相关 5新颖 4实用 4证据 4时效 2
4.10
综合分 / 5
偏好调整 4.50
Haichao Zhang, Zhixuan Liang, Chong Zhang, Zixi Chen, Wen Wang, Jia Wang · 2026-08-27 · arXiv
独立页面阅读 ↗

今日其余入选

9 篇 · 按综合排名
02 3.90

From Habits to Discovery: Deploying LLMs for Personalized Generative Recommendations at Spotify

Spotify

Spotify 想在首页多推用户还没养成习惯的播客(过去 28 天听某节目不足 10 分钟)。GLIDE 基于 Llama 3.2 1B,先学会单集语义 ID 和文字描述互译,再读入最近收听单集的语义 ID、地区等文字信息、一个由协同过滤用户向量投影出的软提示 token,以及“推熟悉的/推没听过的”指令,直接生成 30 个候选单集。离线 Recall@30 比只用语义 ID 的版本高 29.9%;线上 A/B 中非习惯性收听最多 +5.4%,新节目发现最多 +14.3%,并满足线上延迟要求。

网页来源·2026-08-11·Relevance 4 · Novelty 3 · Practical 5 · Evidence 5 · Timely 2
03 3.80

Where Do LLMs Learn to Recommend AI?

问大模型学什么、做什么职业、做什么产品时,它常推荐 AI 相关选项。作者用 20 个开放式建议问题(每题 10 种问法)统计回答里出现 AI/ML 词的比例:10 对基座/指令版模型里,基座版已有 27%,发布的指令版升到 59%。作者自己对 11 个基座模型做后训练发现,通用指令微调不改变这一比例,去掉 7% 与 AI 相关的指令样本后降 14 个百分点;奖励“有帮助”的偏好数据升 9 点,按多样模拟用户偏好排序的数据降 9 点。问法也有影响:问“最好的”升 8 点,问“现在该做什么”升 18 点。

Benaya Trabelsi, Jonathan Shaki, Sarit Kraus
arXiv·Thu, 22 Oct 2026 00:00:00 -0400·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
04 3.40

Transaction Foundation Models for Retrieval-Augmented Generation over Financial Transaction Data: A Comparative Evaluation with Text Embeddings

在金融交易数据上做 RAG,该用专门的交易基础模型还是通用文本嵌入?作者在 IBM 合成反洗钱交易数据上用模板生成 1,026 道带标准答案文档的问答题,把 NVIDIA 2,900 万参数的交易基础模型 TFM 和 5 个通用及金融文本嵌入模型在同等规模下对比。TFM 的 Recall@5 为 0.81,同规模文本嵌入只有 0.25–0.39,端到端答对率 66.7% 对 27.5%。但人工把交易汇总成摘要文本再用通用句向量编码,整体追平甚至超过 TFM,在银行、币种、支付方式这类取值少的问题上明显更好。

Snehal Pal
arXiv·2026-08-25·Relevance 4 · Novelty 4 · Practical 4 · Evidence 3 · Timely 2
05 3.30

A Diagnostic Study of Faithfulness in Diffusion Language Models for Table-to-Text Generation

扩散语言模型生成时反复去噪一整段被遮住的文本,不按左到右顺序。作者在 ToTTo 表格转文本任务上检验它是否更忠于输入表格:MDLM、LLaDA 与 GPT-2、GPT-Neo 用同样的检索式少样本提示,另加一个 QLoRA 微调的 LLaDA,分别打参考相似度(BLEU)和对源表格的 NLI 蕴含分。两项指标走向相反:LLaDA 示例从少到多,BLEU 从 11.3 升到 22.0,NLI 蕴含从 0.78 降到 0.52;QLoRA 版 BLEU 达到全文最高的 24.15,忠实度并没有更好。人工标注显示,自回归模型常写到表外内容,LLaDA 更多是在主题内替换个别实体。

Zaynab Merimi, Noussayba El Marrakchi, Arthur Satouf
arXiv·Thu, 22 Oct 2026 00:00:00 -0400·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
06 3.30

Don't Stop Long-Context Continual Pre-Training Too Early: An Empirical Scaling Law

长上下文继续预训练(LCCP)通常只在短上下文预训练后跑一小段。清华和 OpenBMB 在 5 个模型规模、100 多组短/长上下文 token 预算上拟合出一条加法幂律,把长上下文表现写成模型大小和两段 token 量的函数,并能外推到没参与拟合的规模。为了在一条训练轨迹上持续观测,作者用恒定学习率训练,每次取最近 4 个连续 checkpoint 的平均来评估(Constant-Last4);按这个方法,公式准确预测了 1.22B 模型在约 1000 亿 LCCP token 上的表现轨迹。RULER 等下游评测在评估范围内没有出现饱和,扩到 128K 和做完 SFT 后收益仍在。

Ziqing Qiao, Xiaoyue Xu, Sikui Zhang, Yinuo Xu, Bingxiang He, Chaojun Xiao, Xu Han
arXiv·Thu, 22 Oct 2026 00:00:00 -0400·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
07 3.30

CSD: Common-Support Distillation for Cross-Tokenizer Knowledge Transfer

知识蒸馏要求学生模仿教师对下一个 token 的概率分布,但两个模型分词器不同时,词表和切分位置都对不上。CSD 先把两边按相同文本片段对齐;一个 token 对一个 token 时,只在两边都有的 token 上比较概率,其余情况用链式法则算出多 token 续写的概率,再加一个“其他”项吸收剩余概率,使两边分布都归一,然后用同一个目标匹配。以 Llama-3.2-1B 和 Gemma3-1B-PT 为学生、Qwen3-4B 和 Phi-4-mini 为教师的四组设置里,CSD 平均分都是跨分词器方法中最高,比次优方法最多高 1.8 分;Llama-3.1-8B 学生上比最强基线最多高 4.2 分。

Mingyu Yang, Sharath Turuvekere Sreenivas, Adithyakrishna Venkatesh Hanasoge, Nima Tajbakhsh, Ashwat...
arXiv·Thu, 22 Oct 2026 00:00:00 -0400·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
08 3.20

DiffResearch: Accelerating Deep Research with Diffusion Language Models

已录用 EMNLP 2026

深度研究智能体要规划、检索、写长报告,自回归模型逐字生成,用户要等很久。DiffResearch 固定流程、检索代码、提示词和评测,只把骨干在扩散模型 diffusiongemma-26B-A4B 和同规模自回归模型 gemma-4-26B-A4B 之间切换。在 Deep Research Bench 的 100 个任务上,端到端平均耗时从 71.45 秒降到 11.89 秒,约快 6 倍,主要省在规划和写作。作者还让拆分子查询的步骤直接读取去噪过程中的中间状态,不等生成结束,这一步单独看中位数快 1.99 倍,报告质量没有下降。

Alan-Barsag Gazzaev, Alexey Gavrilov, Mikhail Mozikov, Sergey Muravyov
arXiv·Thu, 22 Oct 2026 00:00:00 -0400·Relevance 4 · Novelty 4 · Practical 4 · Evidence 3 · Timely 5
09 3.20

TraceForge: Distilling with Your Own Thinking

一些闭源模型只返回答案或简短摘要,不返回完整推理过程,没法直接拿来蒸馏推理链。TraceForge 训练一个生成器:输入题目和答案,按学生模型所属家族(目前是 Qwen)的风格补写推理过程,先监督训练,再用一个判别推理链真假的评判模型做对抗训练。用同样的 3,500 道题和同样的教师答案微调 Qwen3.5-9B-Base,补写的推理链比用 Fable 5 自带思考内容训练的结果在 HumanEval+ 上高 3.7 分,MBPP+ 高 7.1 分,MBPP+ 在每个 checkpoint 都领先;通用任务上几种训练数据差别不大。

Yan Wang
HuggingFace·2026-10-20·Relevance 4 · Novelty 4 · Practical 4 · Evidence 3 · Timely 5
10 3.20

Build more responsive apps with the Decisions API

OpenAI

OpenAI 的 Decisions API 正式开放,用来处理应用和智能体里大量“答案有限”的小判断,比如给输入分类、把请求路由到哪里、下一步做什么,背后是 GPT‑6 Luna。开发者写好问题和允许的答案,传入文本、图片或 JSON,接口返回三种结果之一:条件成立的概率(predicate)、从给定选项中选一个(choice)、按评分档位打分(score)。一次请求最多 400 个问题,比通过 Responses API 调同一模型最多快 10 倍;只按输入计费,每百万 token 0.10 美元,缓存命中 0.01 美元。Sierra 用它在客服对话中选下一步动作,p95 低于 280 毫秒。

技术博客·2026-10-22·Relevance 4 · Novelty 5 · Practical 3 · Evidence 3 · Timely 5

其他赛道今日

点击切换
Personalization
10
个性化推荐 · 篇入选
AI Search
10
AI 搜索 · 篇入选
Agentic
10
智能体搜索 · 篇入选
Infra
10
系统与索引 · 篇入选

开源雷达

GitHub / HuggingFace 热门 · 7 个项目
TheLastOxygen/mafdetYou type. It already knows. Local LLMs that read and think while you type.Python · ★ 21 · 2026-10-21 · GitHubtoken-gate-llms/TokenGatehttps://arxiv.org/abs/2610.26754 Process all your context faster with LLMs that can skim and read what mattersPython · ★ 16 · 2026-10-19 · GitHubdeepseek-ai/DeepSeek-V4.1-Flashpipeline: image-text-to-text; tags: transformers, safetensors, deepseek_v41, text-generation, image-text-to-text, conversational, license:mit, eval-resultsmodel · ★ 4702 · 2026-09-10 · HuggingFacedeepseek-ai/DeepSeek-V4.1-Flash-1017pipeline: image-text-to-text; tags: transformers, safetensors, deepseek_v41, text-generation, image-text-to-text, license:mit, eval-results, endpoints_compatiblemodel · ★ 2343 · 2026-10-17 · HuggingFaceinternlm/Intern-Decision-4Bpipeline: image-text-to-text; tags: transformers, safetensors, qwen3_5, image-text-to-text, decision-making, multimodal, structured-prediction, decision-modelmodel · ★ 90 · 2026-09-26 · HuggingFaceinternlm/Intern-Decision-0.8Bpipeline: image-text-to-text; tags: transformers, safetensors, qwen3_5, image-text-to-text, decision-making, multimodal, structured-prediction, conversationalmodel · ★ 37 · 2026-09-26 · HuggingFaceinternlm/Intern-Decision-2Bpipeline: image-text-to-text; tags: transformers, safetensors, qwen3_5, image-text-to-text, decision-making, multimodal, structured-prediction, conversationalmodel · ★ 18 · 2026-09-26 · HuggingFace