 KAIST
 Korea University
MAPS: Macro-Adaptive Parallel Reasoning for Regulating Search Momentum in Retrieval-Augmented Generation
 Northeastern University
 Tsinghua📖 有深读 · 8 分钟
东北大学和清华发现,边推理边检索时,后面的子查询会沿着前面子查询的移动方向继续偏离原问题,而且越往后越明显。MAPS 据此做两处改动:每轮只把提炼出的知识和一段推理摘要交给模型,不再给它看历史子查询;生成子查询前先列出几个互补方向,各写一个子查询并行检索后合并。Qwen3-32B 上六个问答集平均 Cover-EM 为 56.0,ParallelSearch 为 49.2,Search-o1 为 43.9;三个组件分别去掉后都会下降。
边推理边检索的 RAG 方法(如 Search-o1)每一步让大模型根据之前全部的推理过程和子查询,写出下一个子查询去检索。东北大学和清华的这篇论文先做了一个测量:把每个子查询编码成向量,把"相邻两步子查询向量之差"按指数加权累加起来,称为"搜索动量",然后检验它能否预测下一个子查询偏离原问题的方向。结果是越往后预测得越准,说明后面的子查询倾向于沿着前面已经走的方向继续偏下去。据此提出的 MAPS 做了两处改动:每一轮只把检索到的知识和一段压缩后的推理状态交给模型,不再给它看历史子查询和完整推理过程;每一轮先列出几个互补的检索方向,各写一个子查询并行检索,再把结果合并。在 Qwen3-32B 上,MAPS 在六个问答数据集上的平均 Cover-EM(标准答案是否出现在回答里)为 56.0,最强基线 ParallelSearch 为 49.2,Search-o1 为 43.9。
1. 问题:子查询会沿着已有方向越偏越远
多跳问题需要的证据分散在多篇文档里,所以现在的做法是让模型一边推理一边生成子查询。问题在于第 t 步的子查询是以前面全部推理和子查询为条件生成的,早期一个跑偏的子查询会影响后面所有步骤。
论文用"搜索动量"量化这一点。具体操作:
- 用 E5 模型把每一步的子查询编码成向量 q_t。
- 动量 m_t = β_t·m_{t−1} + (1−β_t)·(q_t − q_{t−1}),即把每一步子查询的移动量按权重 β_t 累加,β_t 越大越看重历史。
- 对齐分数 S_t = cos(m_t, q_{t+1} − q_0),即当前动量的方向和"下一个子查询相对原问题的偏移方向"的余弦相似度。
- 在训练集上用 L-BFGS-B 拟合每一步的 β_t 使 S_t 最大,在留出集上报告 S_t。
| 数据集 | β1 | S1 | β2 | S2 | β3 | S3 | β4 | S4 |
|---|---|---|---|---|---|---|---|---|
| 2WikiQA | 0.0000 | 0.4051 | 0.6352 | 0.5698 | 0.7552 | 0.6483 | 0.8761 | 0.6955 |
| MuSiQue | 0.0000 | 0.3105 | 0.5400 | 0.5196 | 0.7214 | 0.6489 | 0.8252 | 0.6913 |
| HotpotQA | 0.0000 | 0.4427 | 0.6161 | 0.6840 | 0.8151 | 0.7731 | 0.8836 | 0.7750 |
β_t 和 S_t 都随步数上升:越往后,历史移动的权重越大,下一个子查询的偏移方向也越贴近已有动量。作者的解读是,模型的推理过程并不会自己纠正早期的偏离。
2. 方法:MAPS
2.1 不让模型看历史子查询
普通做法每一步把完整轨迹(每一步的推理、子查询、检索结果)都交给模型。MAPS 只保留两样东西:
- 知识观察集:之前每一轮从检索结果中提炼出的知识 o_1…o_{t−1};
- 压缩推理状态:一段每轮更新的推理摘要,不包含历史子查询。
下一轮的推理只以原问题、知识观察集和压缩推理状态为输入。知识足够或达到最大轮数时,用同样三样输入生成最终答案。
2.2 每一轮并行查几个方向
每一轮分三步,由三个角色完成:
- 方向提出:根据原问题、已有知识和推理状态,列出 N 个互补的检索方向;
- 生成子查询:为每个方向写一个子查询,各自检索 top-K 文档,合并成一个文档集;
- 整理:把各方向检索到的证据合并成本轮的知识观察 o_t,并更新压缩推理状态。
3. 实验
设置。 单跳问答用 NQ、PopQA,多跳用 2WikiQA、HotpotQA、MuSiQue,推理问答用 GPQA Diamond(198 题);除 GPQA 外每个数据集随机抽 1,000 题。主干模型为 Qwen3-32B 和 Qwen3.6-35B-A3B。检索库是 2018 年 12 月的英文维基百科,检索器 E5-base-v2 + FAISS,每次返回 top-5 段落,最多 10 轮。指标是 Cover-EM(标准答案是否出现在模型回答里)。
3.1 主结果
这组实验检验 MAPS 是否在不同类型问题和两个主干模型上都比现有 RAG 方法好。
| 方法 | NQ | PopQA | 2WikiQA | HotpotQA | MuSiQue | GPQA | 平均 |
|---|---|---|---|---|---|---|---|
| Qwen3-32B | |||||||
| Vanilla RAG | 49.0 | 52.1 | 30.0 | 38.3 | 9.9 | 44.2 | 37.2 |
| Search-o1 | 53.1 | 56.5 | 43.7 | 40.0 | 23.7 | 46.4 | 43.9 |
| S3 | 59.5 | 60.6 | 37.2 | 38.3 | 19.4 | 60.7 | 45.9 |
| ParallelSearch | 57.2 | 60.4 | 53.6 | 43.5 | 30.9 | 49.8 | 49.2 |
| MAPS | 63.4 | 64.8 | 59.4 | 48.8 | 37.6 | 62.1 | 56.0 |
| Qwen3.6-35B-A3B | |||||||
| Vanilla RAG | 55.6 | 61.4 | 49.1 | 45.5 | 26.8 | 75.7 | 52.3 |
| Search-o1 | 53.0 | 62.0 | 56.3 | 44.0 | 34.1 | 76.3 | 54.3 |
| ParallelSearch | 58.4 | 56.8 | 55.9 | 53.7 | 41.5 | 77.5 | 57.3 |
| MAPS | 64.1 | 69.3 | 65.8 | 55.1 | 45.2 | 79.2 | 63.1 |
ParallelSearch 同样是并行生成多个子查询,MAPS 在所有数据集上都比它高。作者据此认为,单纯多写几个子查询不够,还需要切断子查询对历史轨迹的依赖。
3.2 消融
这组实验检验三个组件各自是否有用:去掉"先列方向"(直接并行写子查询)、去掉并行(每轮只查一个方向)、去掉解耦(保留完整历史轨迹)。
| 变体(Qwen3-32B) | 2WikiQA | MuSiQue | GPQA | 平均 |
|---|---|---|---|---|
| MAPS | 59.4 | 37.6 | 62.3 | 56.1 |
| 去掉列方向 | 55.8 | 35.6 | 46.0 | 51.9 |
| 去掉并行 | 54.1 | 33.1 | 45.3 | 49.8 |
| 去掉解耦 | 53.1 | 34.3 | 45.1 | 50.1 |
三项去掉后平均分都下降,GPQA 上下降最大。注意消融表里 MAPS 的 GPQA 是 62.3、平均 56.1,与主表的 62.1、56.0 不一致,论文没有解释。在 Qwen3.6-35B-A3B 上,去掉解耦后 2WikiQA(64.4)和 GPQA(78.1)只比完整 MAPS 略低。
3.3 动量是否真的被压住了
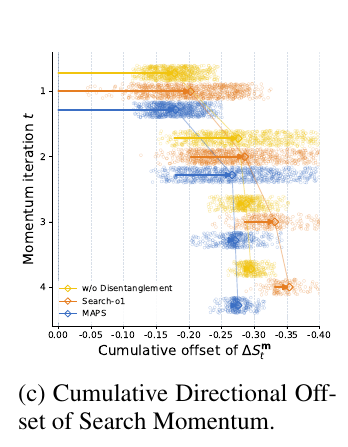
这组实验检验 MAPS 的提升是否确实来自减少偏离。从所有数据集随机抽 500 个样本,计算每一轮动量和原问题的余弦相似度变化并累加。随着轮次增加,MAPS 的累计偏移比 Search-o1 和去掉解耦的版本更小、更稳定。另一项分析计算子查询和标准证据文档的相似度:Search-o1 一路下降,MAPS 前期下降、之后回升并稳定。
3.4 停止轮次
MAPS 在第 1 轮就停止的样本占 62.7%,高于 Search-o1 的 50.4% 和 ParallelSearch 的 58.5%;同时需要 5 轮及以上的样本比例也更高(14.9%,对 12.5% 和 5.1%)。作者的解释是简单问题更早查到足够证据,复杂问题则不会过早停下。
4. 局限
论文没有报告每题的模型调用次数、token 消耗或延迟。MAPS 每轮要调用方向提出、子查询生成、整理三个角色,并做 N 次检索,成本很可能高于 Search-o1,但无法从论文得知具体多少。方向数 N 取多少、对结果有多大影响,正文也没有给出。实验使用 2018 年的维基百科和 E5-base-v2 这样较弱的检索器,换成更强的检索器后差距是否保持,没有验证。
5. 实践意义
做多跳 RAG 智能体的团队可以直接试两个低成本改动:每一轮不把历史子查询喂回给模型,只给提炼后的知识和一段推理摘要;生成子查询前先让模型列出几个互补方向。消融显示这两处改动单独去掉都会损失效果。上线前需要自己测量增加的调用成本。
 IBM
 Huawei
 Southeast University
 Sun Yat-sen University
 Shandong Normal University
 Georgetown University
 University of Glasgow
 University of Pisa
 已录用 NeurIPS 2026
 HKU
 NUS
 Beihang University
 Renmin University of China
 Microsoft
 UCLA
 NVIDIA