面向客户的大模型客服通常受几十条行为规则(policy)约束,比如"只有买了旅行险才能补偿"。每一轮对话都要判断哪几条规则和当前情况相关,再放进提示词。Parlant 引擎原来的做法是每轮对每条规则问一次大模型"现在相关吗",36 条规则每轮要 36 次调用、约 69,000 个提示词 token。Parlant 的 Signals and Queries(S&Q)把这一步换成离线训练的小分类器:对每条规则,先让大模型离线写 10 条"应当触发这条规则"的用户消息和 10 条"看起来很像、但应由相邻规则处理"的用户消息,把它们编码成向量,为这条规则单独训练一个逻辑回归;线上每轮只需一次 embedding 调用和 36 次向量点积,CPU 耗时 37 微秒。在 τ²-bench 航空客服的 254 个对话片段、36 条规则上,以大模型判定为标准,在召回率不低于 90% 时,S&Q 精确率在 Gemini embedding 上为 32%、OpenAI embedding 上为 34%,余弦阈值检索为 31%;改用真实对话中挖出的样例后,精确率升到 43.5%(Gemini)和 41.6%(OpenAI)。
1. 问题:漏一条规则是错误,多一条只是浪费
把所有规则每轮都塞进提示词,会遇到长上下文中间部分被忽视、单条指令注意力被稀释、指令越多越难全部遵守等问题,token 成本也随规则数线性增长。所以需要先筛出相关规则。
筛选的代价不对称:漏掉取消政策,客服可能做出本该拒绝的操作;多放一条无关规则,只多花几百个 token。因此 S&Q 的目标是先保证每条规则召回率至少 90%,在此前提下再提高精确率。它是一个预筛选器,筛掉的规则后面再也找不回来,留下的规则还会被客服模型自己再读一遍。
直接拿对话去和规则原文算向量相似度几乎不花钱,但对话是口语化的用户消息,规则是正式的条文,两者的向量区分度很差。
2. 方法
2.1 离线:为每条规则造正例和难负例
对每条规则,用 gemini-3.5-flash 仅根据规则原文生成:
- signals(10 条):应当触发这条规则的用户消息,例如取消政策对应"我想取消下周去芝加哥的航班";
- anti-signals(10 条):同一话题附近、但应由别的规则处理的消息,例如"我想把航班从周二改到周四"(这属于改签规则)。
生成过程不使用任何真实对话。
2.2 每条规则一个逻辑回归
对每条规则,用这 20 条消息的 embedding 训练一个逻辑回归,输出"相关"的概率。每条规则的分类器只依赖它自己的样例,所以新增或修改一条规则,只需为它重新生成样例、训练一个分类器(约 2 毫秒),其他规则不受影响。
2.3 线上:两种对话视角取最大值
第 t 轮时,对两种向量打分并取最大值:整段对话到当前为止的 embedding,以及到当前为止每一条用户消息单独的 embedding。所有向量先减去全部规则的中心再归一化。分数超过全局阈值 θ 就保留该规则。取单条用户消息的最大值是为了在对话换话题时,前面的内容不会稀释后面话题的信号。真实对话的分数整体比生成的样例低,所以 θ 取负值(Gemini −0.45,OpenAI −0.4)。
3. 实验
设置。 50 段由 Parlant 客服和 τ²-bench 用户模拟器生成的航空客服对话,每个以用户消息结尾的前缀算一个查询状态,共 254 个。规则共 36 条:τ²-bench 航空政策的 6 节,加上作者另写的 30 条(身份验证、行李索赔、无人陪伴儿童、票价规则、欺诈处理等),其中故意放了几组近义规则。标准答案由 gemini-3.1-flash-lite 用 Parlant 线上的相关性提示词对每个(对话前缀, 规则)打 1–5 分,≥4 算相关,共 9,144 个标签。指标是在 31 条至少出现过一次的规则上做宏平均。基线四种:按规则原文或按 signals 的余弦相似度取 top-K,或按余弦阈值截断。embedding 分别用 gemini-embedding-001 和 OpenAI text-embedding-3-large 各跑一遍。
3.1 召回率–精确率曲线
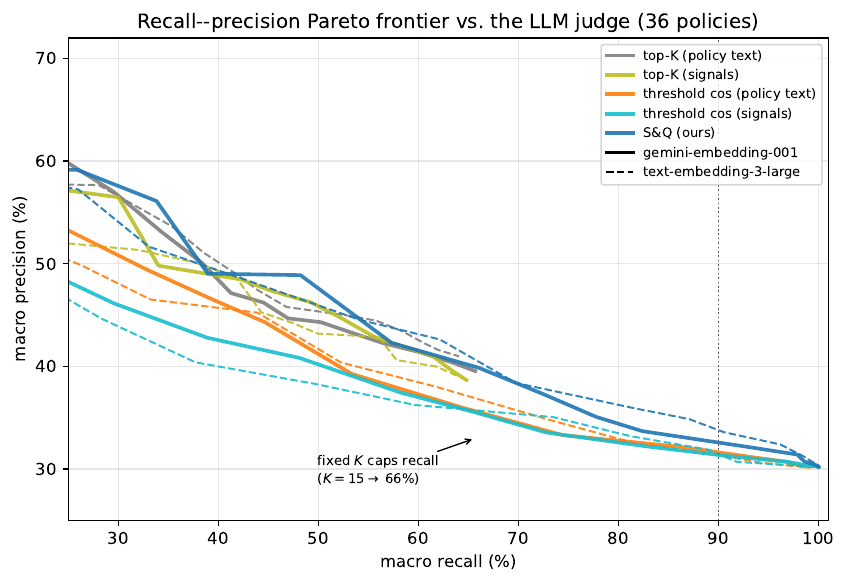
这组实验检验 S&Q 在相同召回率下是否比现有向量检索更精确。论文称 S&Q 在每个召回水平上精确率都最高,中段(60–70% 召回)领先约 4 个点,在高召回端差距缩小:OpenAI 上 +2.9 点,Gemini 上只有 +0.9 点。top-K 方法即使取 K=15(36 条中的 15 条),召回率也只有约 66%,因为每轮同时相关的规则数量变化很大。
召回率不低于 90% 时的最佳精确率:
| 方法 | Gemini 召回% | Gemini 精确% | OpenAI 召回% | OpenAI 精确% |
|---|---|---|---|---|
| top-K(规则原文,K=15) | 66 | 40 | 64 | 41 |
| top-K(signals,K=15) | 65 | 39 | 64 | 39 |
| 余弦阈值(规则原文) | 93 | 31 | 94 | 31 |
| 余弦阈值(signals) | 91 | 31 | 92 | 31 |
| S&Q | 93 | 32 | 91 | 34 |
在这个工作点上,S&Q 和余弦阈值的差距只有 1–3 个点。只用 signals 算相似度(不训练分类器)并不比用规则原文好,提升来自有负例的分类器。
3.2 消融
这组实验检验哪个组件真正起作用,指标是曲线下面积 AUPRC 和 90% 召回下的精确率。
| 变体 | AUPRC(G) | AUPRC(O) |
|---|---|---|
| 默认(anti-signals,两种视角,中心化,逻辑回归,m=10) | .471 | .475 |
| 负例换成其他规则的 signals | .501 | .498 |
| 不用负例 | .423 | .429 |
| 只用整段对话视角 | .526 | .531 |
| 线性 SVM | .463 | .473 |
| 带符号 k-NN | .399 | .396 |
| 每条规则 5+5 个样例 | .436 | .436 |
去掉负例下降最多。有两点和默认设置相反:用其他规则的 signals 当负例略好于专门生成的 anti-signals,作者保留后者是为了每条规则互不依赖;只用整段对话视角的 AUPRC 也更高,因为基准里的对话短且单一话题(中位数约 1,600 字符),逐条消息取最大值的设计在这里用不上。为此作者另做了一个合成测试:把两段不同任务的对话拼成"先 A 后 B",在 30% 误报率下,逐条取最大值比整段视角在 B 话题规则上的召回率高 12 到 19 个点。
3.3 微调编码器是否更好
用同一个本地小模型 all-MiniLM-L6-v2 对比:冻结编码器 + 逻辑回归为 91% 召回 / 32% 精确,SetFit 微调编码器为 90% / 31%。微调没有帮助,而且每条规则要部署一个约 90 MB 的模型,逻辑回归权重只有约 12 KB。
3.4 换成真实对话里的样例
这组实验检验瓶颈是否在样例质量。把对话场景对半分,从一半里挖样例:规则得分首次达到最高的那条用户消息作 signal,模型判为明显无关、且最接近该规则 signals 的用户消息作 anti-signal;在另一半上评估。
| 方法 | 90% 召回下精确率(%) | AUPRC |
|---|---|---|
| 余弦(signals,Gemini) | 32.0 → 35.3 | .459 → .501 |
| S&Q(Gemini) | 33.9 → 43.5 | .475 → .602 |
| S&Q(OpenAI) | 35.3 → 41.6 | .496 → .608 |
| S&Q(MiniLM) | 32.6 → 39.7 | .457 → .540 |
只换正例几乎没变化(Gemini +0.5,OpenAI −1.5 点),提升基本都来自挖出的负例。评估集只有 131 个对话片段,作者也说这只能看方向和大致幅度。
4. 局限
标准答案来自另一个大模型的判断,而不是人工标注。即使在 90% 召回下,S&Q 精确率也只有三成多,留下的规则里大部分仍是无关的,需要后续模型再筛。挖样例需要真实对话上的相关性标签;对半切分时 29 条出现过的规则中只有 22 条挖到了足够样例。长对话里一条规则一旦触发就会一直保留,保留集只增不减,作者指出部署时需要另设过期机制。
5. 实践意义
做带大量规则或工具说明的客服智能体时,可以把"每轮问大模型这条规则相关吗"换成每条规则一个离线训练的线性分类器,线上成本降到一次 embedding 调用。最值得投入的地方是负例:为每条规则准备和相邻规则容易混淆的反例,最好从真实对话中挖取。