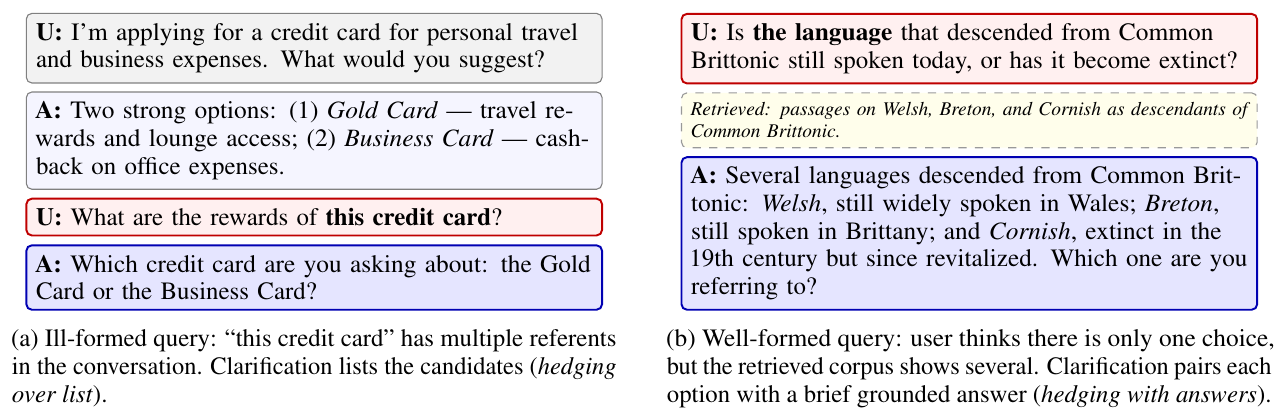
多轮 RAG 对话里,用户的问题有两种情况需要先反问再回答:一是问题本身指代不清,比如助手刚推荐了两张信用卡,用户问"这张卡有什么奖励";二是问题本身看起来明确,但检索出的文档里有几个都说得通的答案,比如问"由共同布立吞语演变来的那种语言还有人说吗",文档里有威尔士语、布列塔尼语、康沃尔语三种。IBM Research 构建了约 3,900 条样本的数据集 ClariEdge,其中专门包括"看起来含糊、但根据上文可以确定指代"的难负例,并用它对 3B 规模的 Granite 模型做 LoRA 微调,让同一个模型判断要不要反问,并在要反问时列出候选项。Granite-4.1-3B LoRA 的判断准确率为 96.6%,提示词方式下最好的 GPT-4o 为 79.4%,GPT-5.6 Sol 为 73.1%;去掉难负例训练后,难负例类的准确率从 87.3% 降到 35.4%(Granite-4.0-micro LoRA)。
1. 问题:什么时候该反问,反问时该说什么
已有数据集只覆盖了其中一部分。CLAMBER 评估的是没有对话上下文、没有检索文档的单句问题;AmbigQA 只要检索出多个事实答案就算含糊,但像"1922 年谁控制了意大利政府"这类问题,现在的模型会直接回答"墨索里尼和法西斯党",并不需要反问。真实部署需要的是对话加文档一起判断。
还有一个难点:很多问题表面含糊但其实可以确定。例如上文用户说了"我在东北分部工作",接着问"这个分部的服务什么时候开放","这个分部"是明确的。模型如果对这种问题也反问,就会过度打扰用户。
2. 方法
2.1 ClariEdge 数据集
对话覆盖 MTRAG 的四个领域:ClapNQ(维基百科)、Cloud(技术文档)、FiQA(金融)、Govt(政府)。数据分三类:
| 类别 | 说明 | 训练 | 测试 | 合计 |
|---|---|---|---|---|
| Ambiguous | 确实需要反问 | 967 | 104 | 1,071 |
| CLEAR-random | 明确的普通问题 | 1,800 | 200 | 2,000 |
| CLEAR-hard | 表面含糊、但根据上文可确定 | 742 | 79 | 821 |
难负例的构造方式:让 Mistral-Large-3 在 793 段对话上生成"针对对话中出现过多个实例的实体类型"的提问,另外对 228 段更长的对话(超过 6 轮、含多种实体类型)用逐步推理加自我验证的方式生成。然后人工逐条审核:确实含糊的归入 Ambiguous,根据上文能确定的归入 CLEAR-hard。作者还补充了几种模型容易误判的模式,例如"哪一个电池续航最好"(是在比较所有候选,不是指某一个)、"价格?"这类简短追问。难负例只出现在不带检索文档的场景中。
每条含糊样本配一条参考反问,按候选数量选三种写法:2–3 个候选时逐个列出并附简短答案;4–8 个时只列出候选;候选很多或无法枚举时直接问用户指的是哪类。参考反问由 Mistral-Large-3 生成后人工修正。两位作者对 80 条测试样本独立标注是否含糊,Cohen's Kappa 为 0.875,4 处分歧都在 CLEAR-hard 类。
2.2 模型和用法
在 3,509 条训练样本上对 Granite-4.0-micro、Granite-4.1-3B 和 GPT-OSS-20B 做 LoRA 微调。部署时同一个 LoRA 调用两次:检索前只看对话,判断要不要先反问;检索后看对话加文档,判断要不要在生成答案前反问。任何一次判为含糊就反问。
3. 实验
设置。 对比七个只用提示词的模型:GPT-5.6 Sol、GPT-4o、GPT-OSS-120B、GPT-OSS-20B、Granite-4.1-30B、Granite-4.1-3B、Granite-4.0-micro,所有模型用相同的系统提示词和输入。分别在全部测试集、检索前子集、检索后子集上评估。
3.1 要不要反问
这组实验检验微调后的小模型能否比更大的提示词模型更准确地判断是否需要反问。
| 模型 | Ambiguous | CLEAR-random | CLEAR-hard | 总体 | 检索前总体 | 检索后总体 |
|---|---|---|---|---|---|---|
| Granite-4.1-3B LoRA | 91.3 | 99.5 | 96.2 | 96.6 | 93.0 | 100.0 |
| Granite-4.0-micro LoRA | 84.6 | 98.5 | 87.3 | 92.4 | 85.6 | 99.0 |
| GPT-OSS-20B LoRA | 76.9 | 98.5 | 86.1 | 90.1 | 82.4 | 97.4 |
| GPT-4o | 48.1 | 90.5 | 92.4 | 79.4 | 81.3 | 77.6 |
| GPT-5.6 Sol | 93.3 | 72.5 | 48.1 | 73.1 | 68.4 | 77.6 |
| GPT-OSS-120B | 80.8 | 83.0 | 65.8 | 78.9 | 75.4 | 82.1 |
| Granite-4.1-3B(提示词) | 26.9 | 88.0 | 55.7 | 64.8 | 59.4 | 69.9 |
(单位 %)提示词模型分成两类错误:GPT-5.6 Sol 和 GPT-OSS-20B 倾向于什么都反问,含糊类准确率高但难负例类只有 48.1% 和 58.2%;GPT-4o 和小 Granite 倾向于不反问,含糊类准确率低。同为 Granite-4.1-3B,提示词版 64.8%,LoRA 版 96.6%,模型结构相同,差别来自训练。检索前的场景更难,LoRA 在这里的含糊类准确率(84.5%)低于检索后(100.0%)。
3.2 反问内容是否列对了候选
这组实验检验反问里列出的候选是否正确、是否齐全。只在模型正确判为含糊的样本上评估:精确率是列出的候选中正确的比例,召回率是参考候选被覆盖的比例,判断由四个大模型提示词完成。
| 模型 | 判对的含糊样本 | 精确率 | 召回率 | F1 |
|---|---|---|---|---|
| Granite-4.1-3B LoRA | 95/104 | 92.7 | 85.7 | 89.0 |
| Granite-4.0-micro LoRA | 88/104 | 91.8 | 87.7 | 89.7 |
| GPT-5.6 Sol | 97/104 | 92.6 | 73.4 | 81.9 |
| GPT-OSS-20B | 94/104 | 93.3 | 70.7 | 80.5 |
| Granite-4.1-30B | 82/104 | 88.7 | 87.1 | 87.9 |
| GPT-4o | 50/104 | 81.3 | 69.8 | 75.1 |
(单位 %)提示词模型的精确率接近,但召回率低,即列出的候选大多正确、但常漏掉同样成立的选项。检索前子集上,GPT-5.6 Sol(85.1)、GPT-OSS-20B(87.5)、Granite-4.1-30B(86.2)的 F1 和两个 LoRA(约 85%)相当,但它们的判断准确率低。
3.3 难负例的作用
这组实验检验难负例是否必要:用同样的数据训练 Granite-4.0-micro LoRA,唯一区别是去掉全部 CLEAR-hard 样本。
| 训练数据 | Ambiguous | CLEAR-random | CLEAR-hard | 总体 | F1 |
|---|---|---|---|---|---|
| 全部 | 84.6 | 98.5 | 87.3 | 92.4 | 89.5 |
| 去掉难负例 | 97.1 | 97.5 | 35.4 | 84.6 | 84.9 |
去掉难负例后,模型几乎对所有表面含糊的问题都反问,CLEAR-hard 准确率降到 35.4%。
3.4 新领域
在 MTRAG-UN 的银行和电信两个新领域上,Granite-4.0-micro LoRA 判断准确率为 92.6% 和 90.2%,提示词模型最高为 71.9%(GPT-OSS-120B,电信)。银行领域的反问质量 F1 上,GPT-4o(89.82%)和 Granite-4.1-30B(86.61%)高于 LoRA(81.56%),但它们判对的含糊样本更少(42/79 和 60/79,LoRA 为 69/79)。
4. 局限
模型只生成一次反问,不支持多轮逐步澄清;数据和评估只有英文,作者均已说明。此外,反问质量的精确率和召回率依靠大模型判断;难负例只覆盖检索前场景,检索后的"看似多个答案、其实可以合并回答"的情况没有专门的难负例;测试集含糊类只有 104 条,各模型之间几个百分点的差距不宜过度解读。
5. 实践意义
做多轮 RAG 助手时,"要不要反问"可以交给一个 3B 规模的 LoRA 小模型,在检索前后各调用一次,而不必依赖大模型的提示词。关键是训练数据里要有"看起来含糊但上文已经说清楚"的反例,否则模型会频繁反问。ClariEdge 已在 Hugging Face 公开(ibm-research/ClariEdge)。