2026-10-23 周五 · Infra

独立报告页 · 在站内浏览(含往期切换)→
Generative生成式推荐 · 10 篇Personalization个性化推荐 · 10 篇AI SearchAI 搜索 · 10 篇Agentic智能体搜索 · 10 篇Infra系统与索引 · 10 篇

今日场景社区搜索 (UGC 短文本搜索): 用户在社区平台搜索帖子、问答、评论等 UGC 内容。 核心指标是搜索相关性 (nDCG) 和点击率 (CTR)。 关注:语义匹配、query 理解、短文本召回、排序模型、LLM 在搜索中的应用。 — 评分 147 篇,入选 10 篇,分数 3.55 – 4.35

本期目录 · 10 篇
  1. 01Is 2:4 Sparsity Still Worth It? Semi-Structured Sparsity versus Quantization in LLM Inference
  2. 02SGLang Low-Latency Mode: Kernels and Runtime
  3. 03RCSD: Reinforcement and Continual Learning for Domain-Specific Speculative Decoding
  4. 04UlaCache: Unified Logical Addressing for Sparse LLM Serving
  5. 05SPARE: Sparsity Allocation via Routing Entropy for Efficient MoEs
  6. 06NormTune: Norm-Guided Parameter-Efficient Fine-Tuning for Reasoning-Intensive Tasks
  7. 07FlashNext-RL: A System Optimization Study for Long-Horizon Agentic RL of Qwen3.8-Flash-Next
  8. 08TrainBridge: Agentic NPU Training Optimization Guided by GPU Compilation Evidence
  9. 09Looped Uniform Diffusion Language Models
  10. 10Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers
LEAD STORY · 今日必读

Is 2:4 Sparsity Still Worth It? Semi-Structured Sparsity versus Quantization in LLM Inference

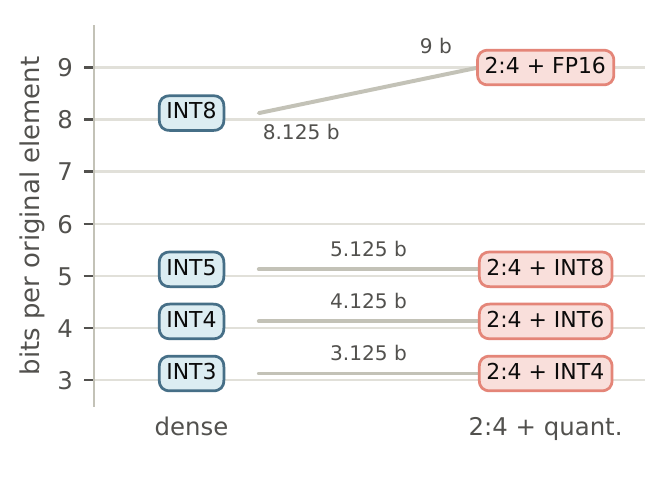
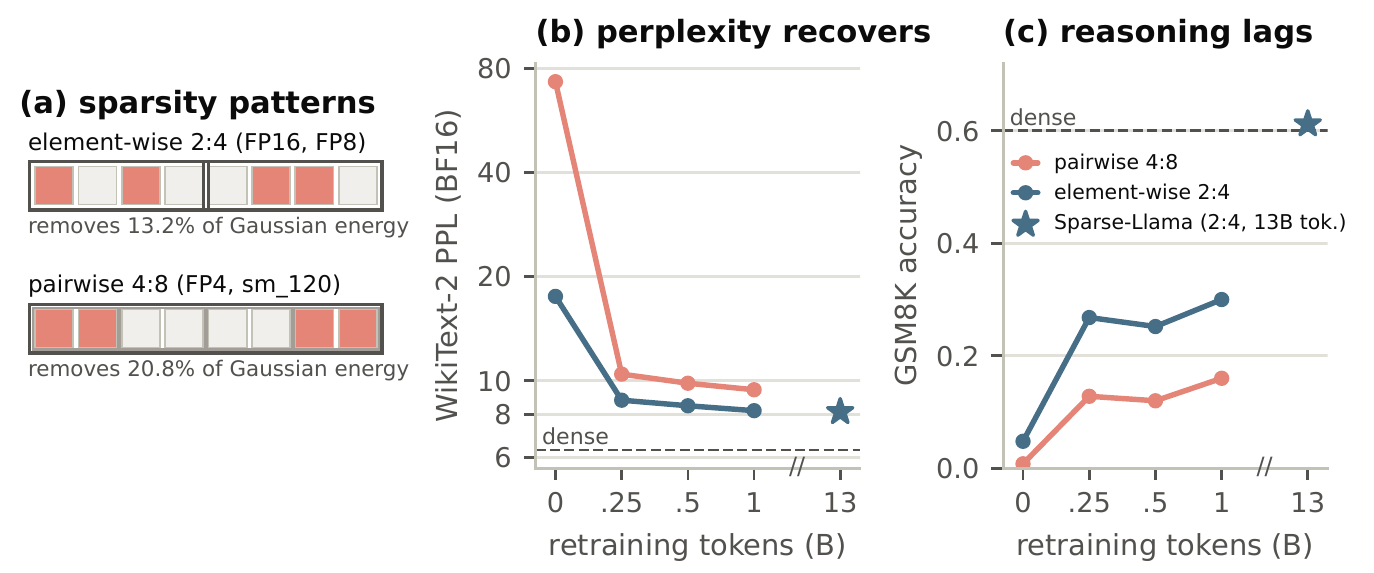
独立研究者在 Llama-3.1-8B-Instruct 和 Qwen3-8B 上,按相同存储位数(稀疏位置索引也计入)和相同标称算力档位,比较"加 2:4 稀疏"和"降一档精度",并在 L40S、H100、RTX PRO 6000 上实测。只要还能降精度,加 2:4 就既更不准也更慢:2:4 + INT8 的存储成本等于 INT5。到 FP8 底线后,H100 上 vLLM 服务的重训 2:4 模型 prefill 吞吐比稠密 FP8 高 27%,GSM8K 相当;但重训时困惑度先恢复,推理准确率恢复得慢得多。

相关 4新颖 4实用 5证据 4时效 5
4.35
综合分 / 5
偏好调整 4.40
Xiuyi Qin · 2026-10-20 · arXiv
独立页面阅读 ↗

今日其余入选

9 篇 · 按综合排名
02 4.25

SGLang Low-Latency Mode: Kernels and Runtime

SGLangAMDNVIDIA📖 有深读 · 6 分钟

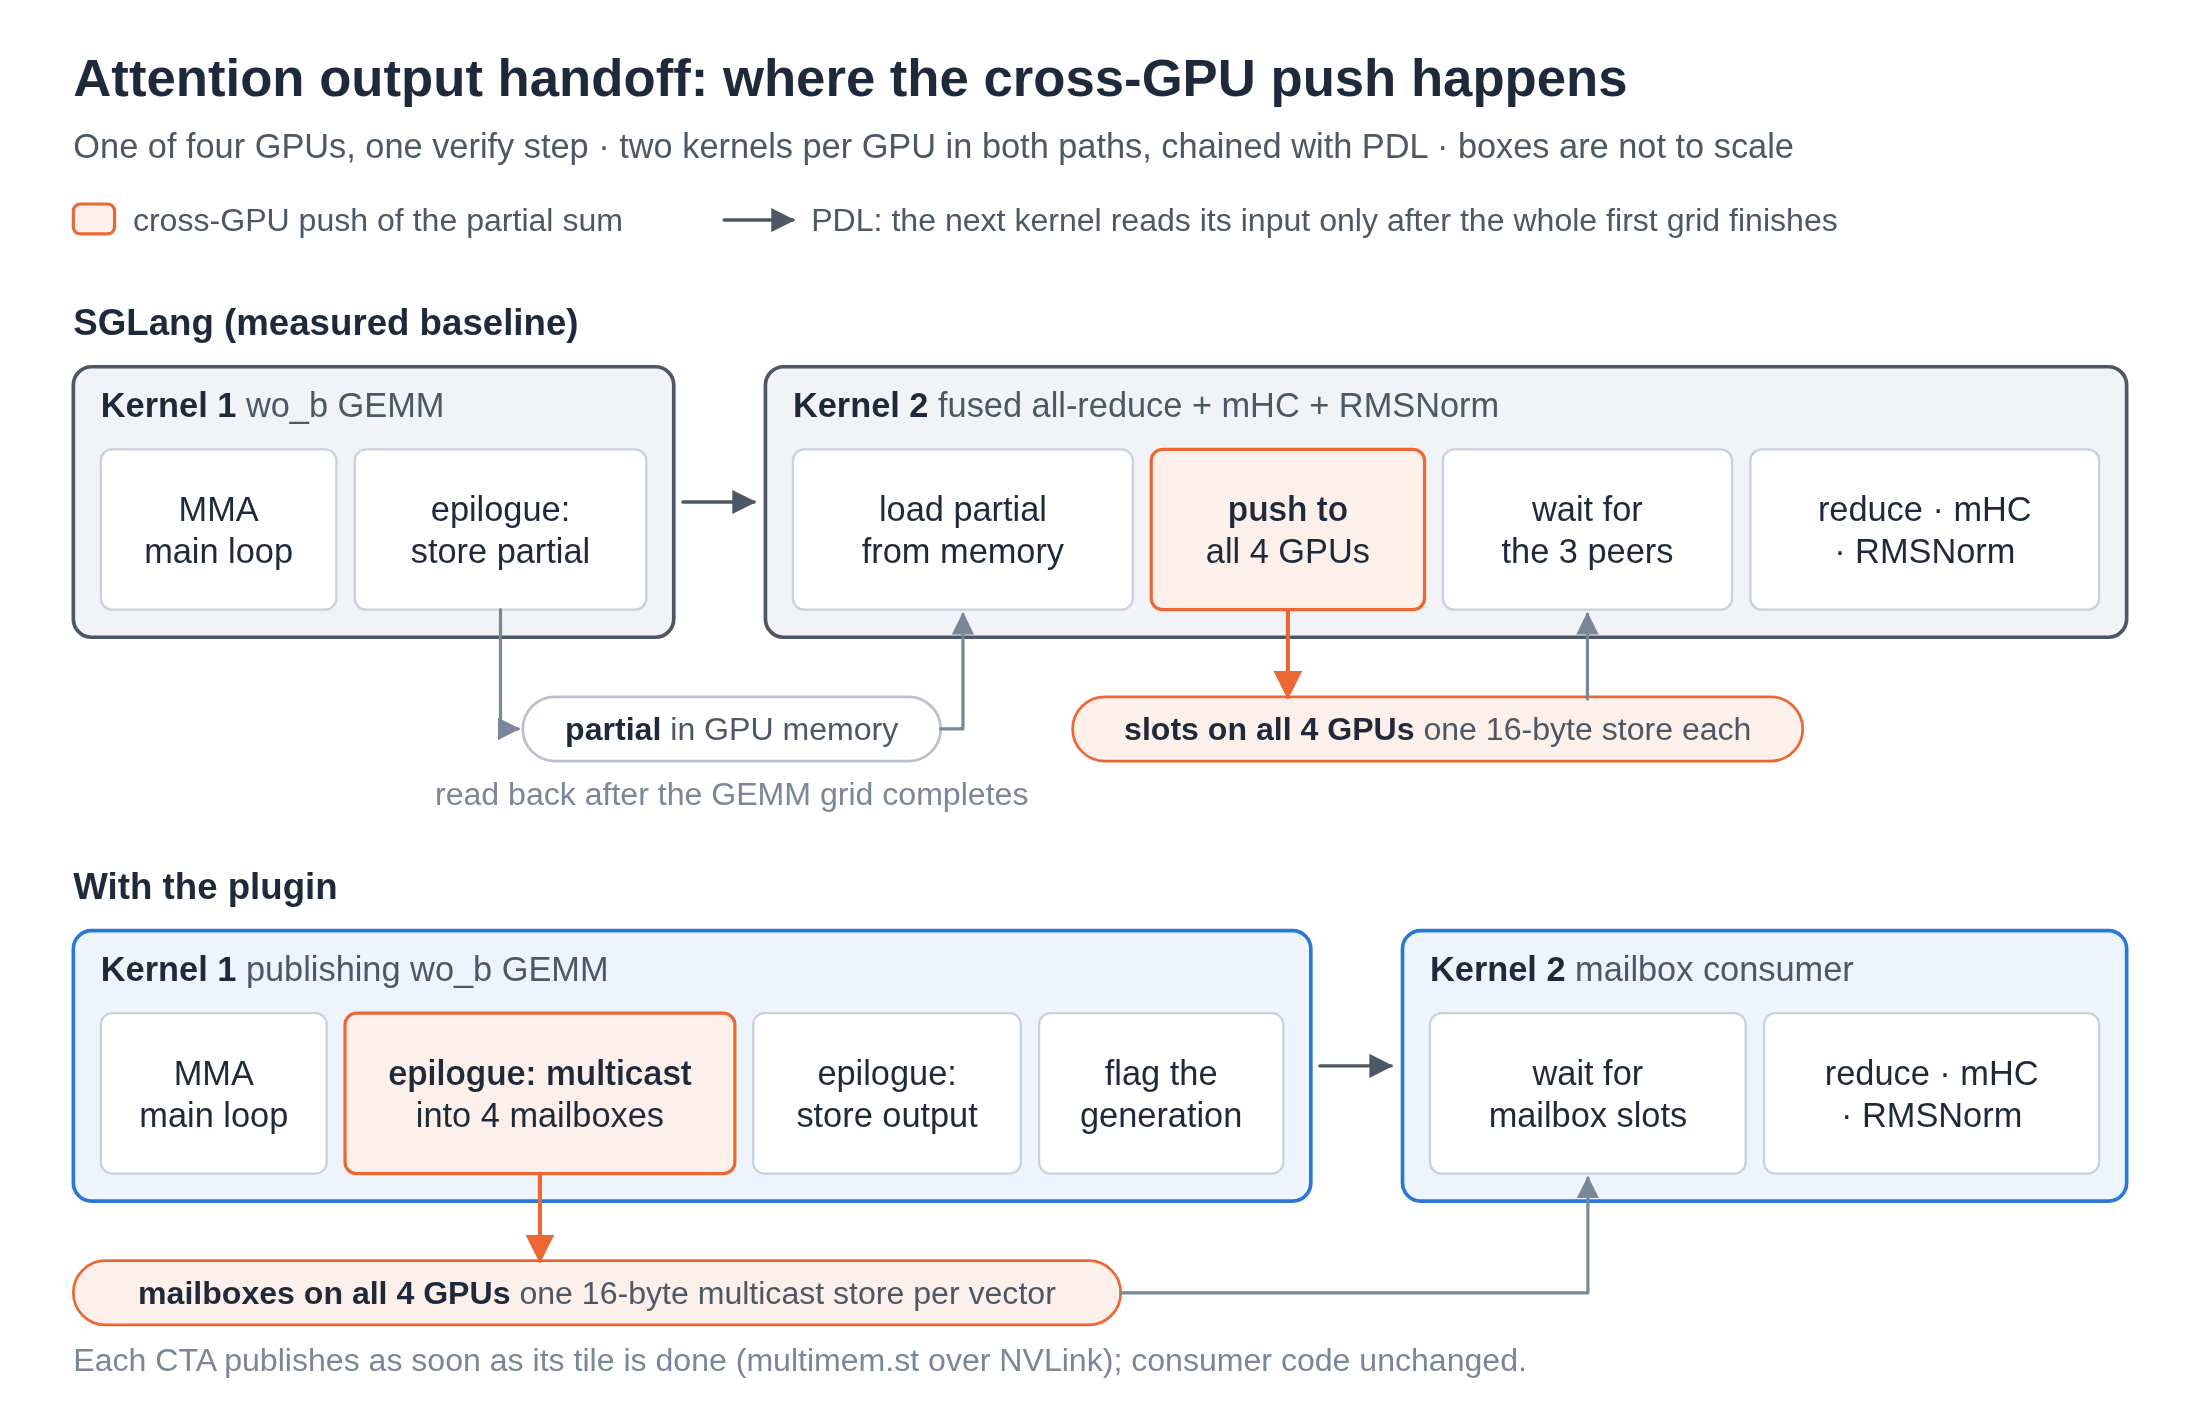
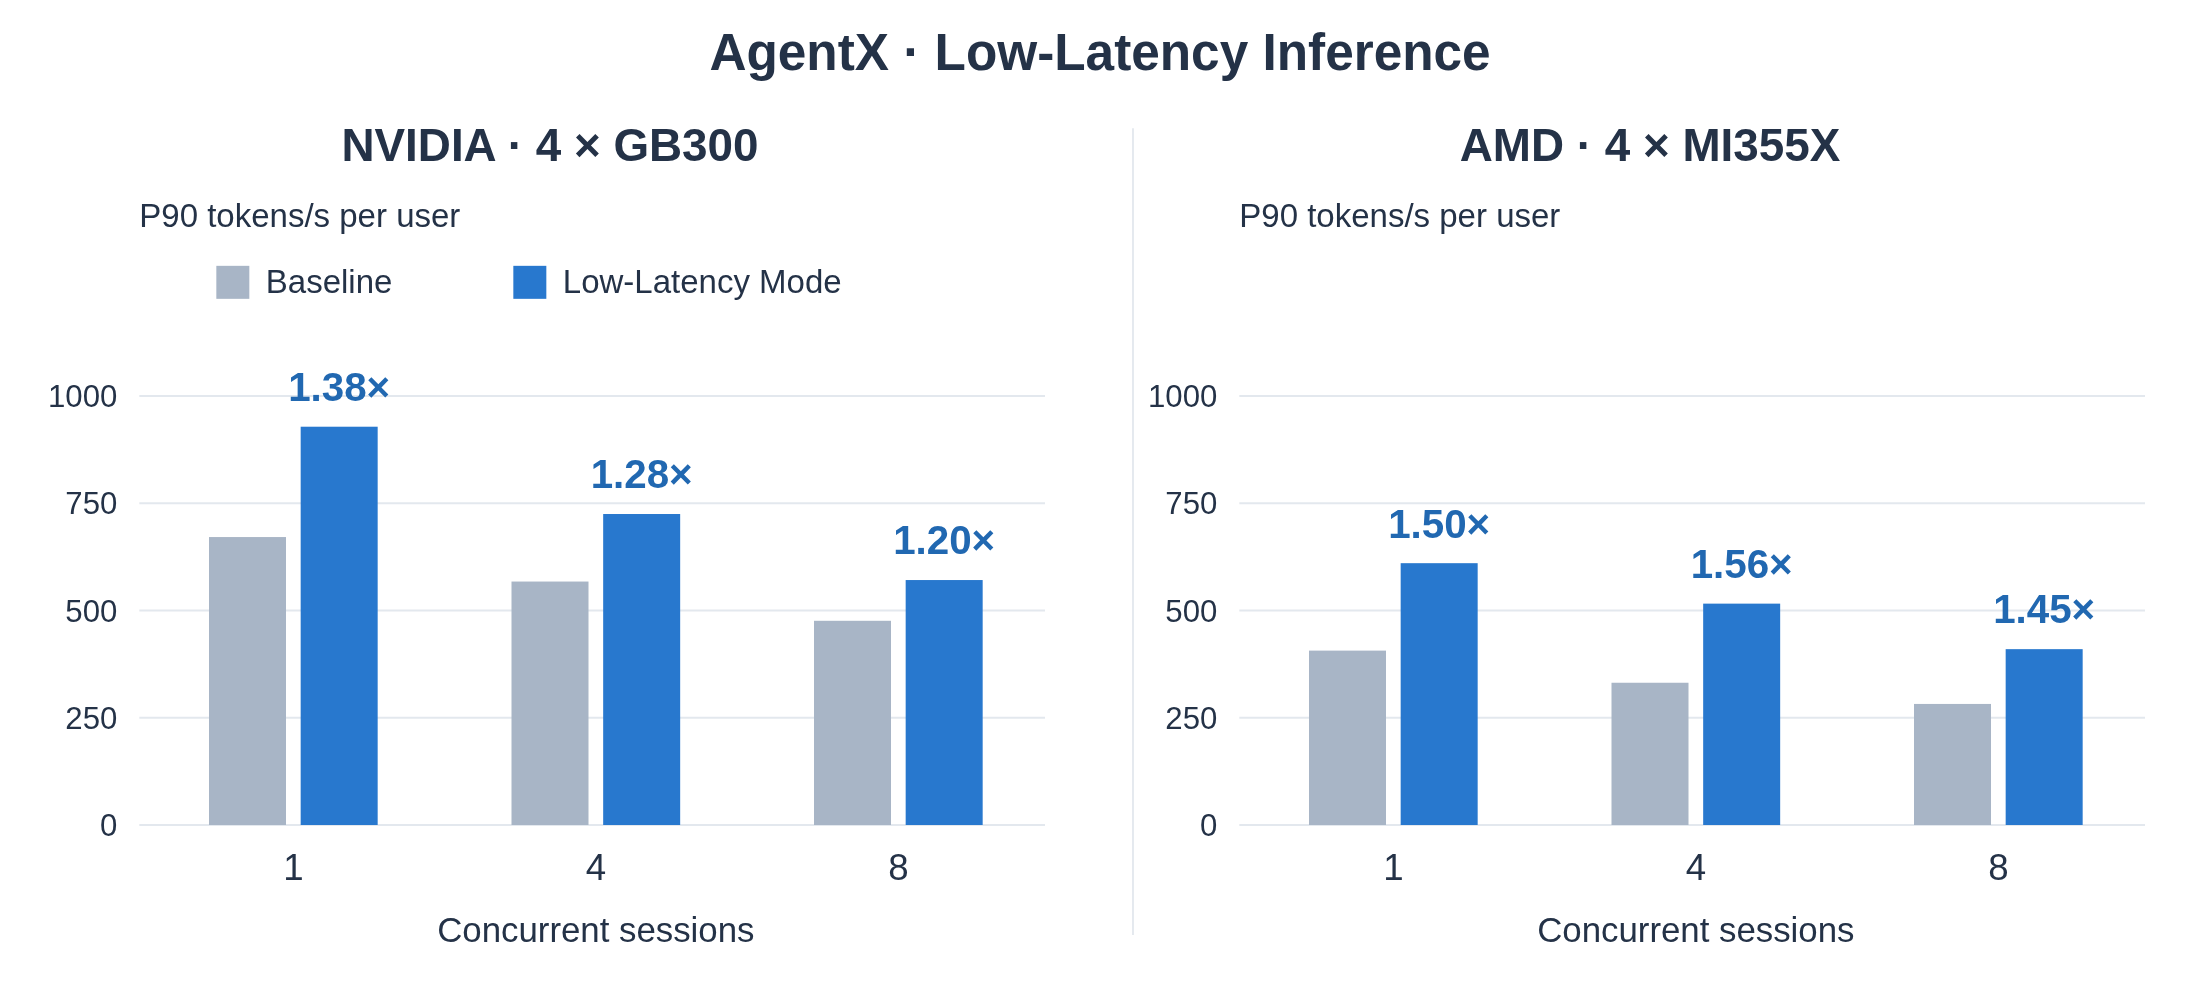
SGLang、NVIDIA 和 AMD 团队用插件框架把专用融合内核接入 SGLang,针对低并发场景减少内核间等待和跨卡通信。DeepSeek-V4.1-Flash + DSpark 的 AgentX 回放中,4×GB300、1 个会话时每用户 P90 生成速度从 671.2 提到 928.4 token/s;4×MI355X、4 个会话时从 331.6 提到 516.0 token/s。NVIDIA 上一个解码层中位耗时从 96.8 µs 降到 68.4 µs,内核数几乎不变,提速主要来自减少内核间等待和让工作重叠。

技术博客·2026-10-18·Relevance 4 · Novelty 4 · Practical 5 · Evidence 4 · Timely 4
独立页面阅读 ↗
03 4.10

RCSD: Reinforcement and Continual Learning for Domain-Specific Speculative Decoding

📖 有深读 · 7 分钟

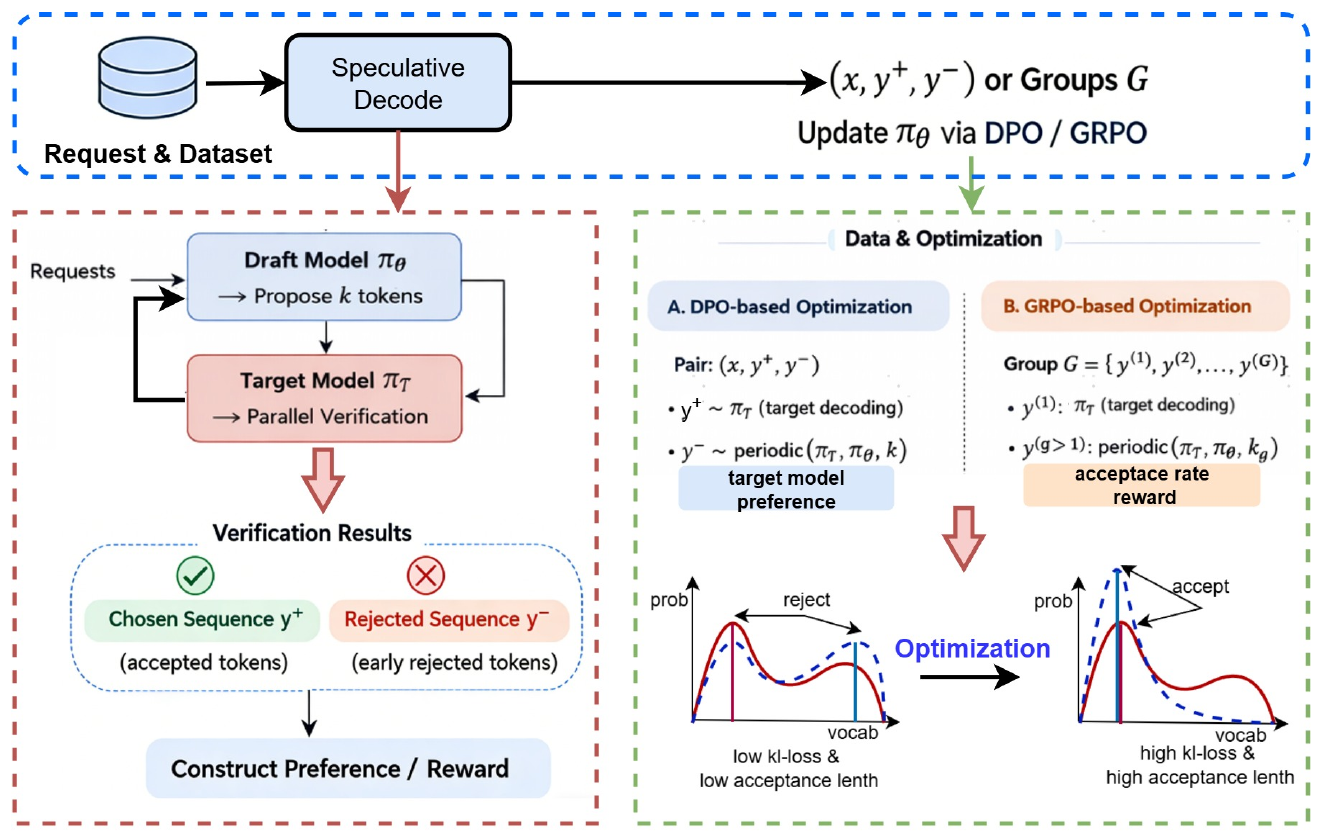
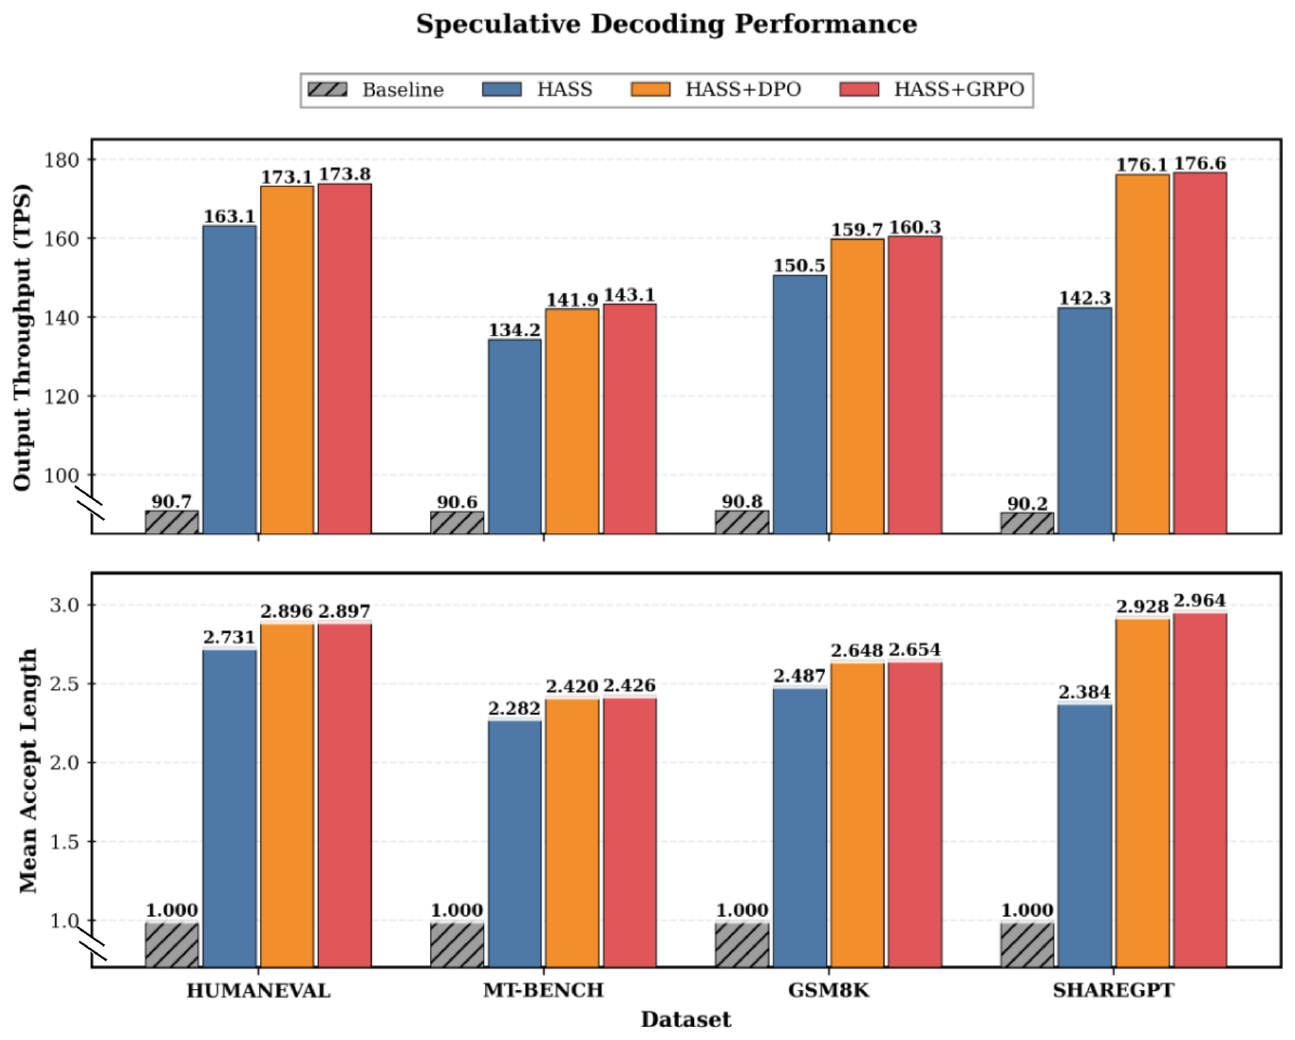
海信的 RCSD 在用 HASS 蒸馏训好的投机解码草稿模型上,再用 DPO 或 GRPO 继续训练:目标模型自己生成的序列为"好",目标与草稿交替生成的序列为"差",GRPO 版用接受率打分。Qwen3-1.7B 和 Llama-3.1-8B 上,四个数据集、草稿步数 3–6 的接受长度都高于 HASS,例如 Qwen3-1.7B 在 GSM8K、步数 6 时从 2.176 到 3.246;Llama-3.1-8B 在 ShareGPT 上吞吐从 142.3 到 176.6 token/s。论文没有给出生成质量评测。

Mingkang Liu, Weiming Meng, Peipei Jiao, Jiawei Zhang, Tianyuan Liu, Junyan Li, Lichen Pang
arXiv·2026-10-21·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
独立页面阅读 ↗
04 4.10

UlaCache: Unified Logical Addressing for Sparse LLM Serving

📖 有深读 · 7 分钟

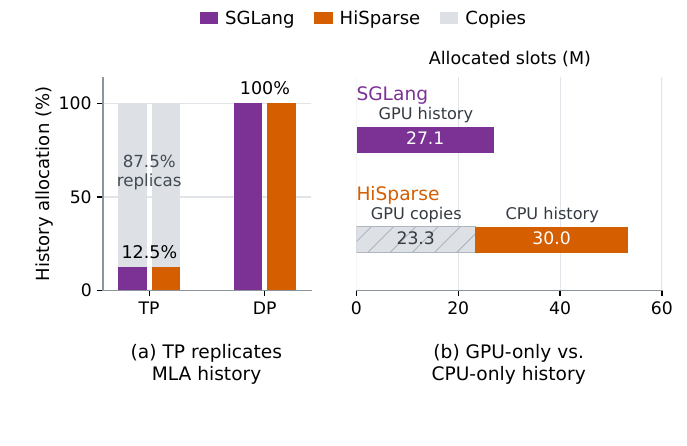
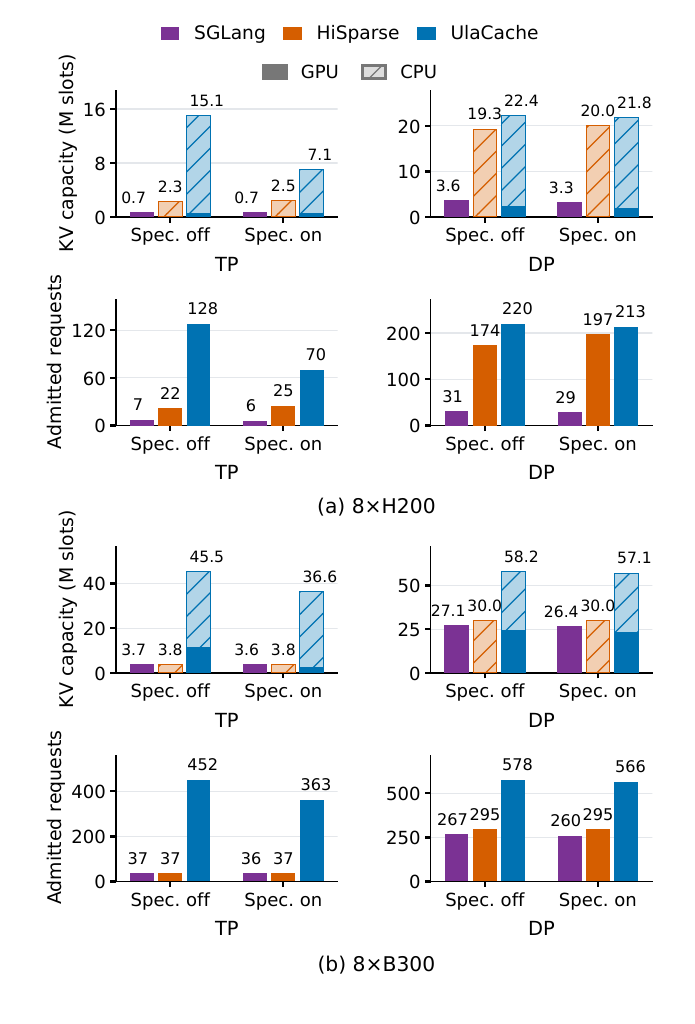
Scitix.AI 的 UlaCache 把各 GPU 的 KV 池和 CPU 内存编进统一逻辑地址空间,让 GPU 和 CPU 各存不同的历史,并消除 MLA 在 TP 下的跨卡重复;GPU 池由所有请求共享,用分桶并行 LRU 决定换出。SGLang + GLM-5.3、64K–128K 输入下,8×B300 TP 可同时解码的请求从 HiSparse 的 37 增到 452;开投机解码时峰值吞吐相对 HiSparse 为 1.16–2.51 倍。低并发时延迟比纯 GPU 的 SGLang 高。

Isaac Zhu, Alan Cao, Hugh Yin, Rocky Wang, Orion Wang, Hscos Zhang, Jack Li, Jason Zhao
arXiv·2026-10-21·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
独立页面阅读 ↗
05 4.10

SPARE: Sparsity Allocation via Routing Entropy for Efficient MoEs

Intellifusion 的 SPARE 解决 MoE 专家剪枝中"每层剪多少"的问题:在校准数据上计算每层 token 的 Top-K 门控权重熵,权重分散的层剪掉一个专家损失小,就多剪。它不训练,可与 REAP 等"剪哪些专家"的方法组合。相同选择方法和预算下,50% 专家剪枝时 Qwen3-30B-A3B 八项任务平均从 57.2% 升到 63.8%,DeepSeek-R1 数学、代码、科学平均从 80.1 升到 82.8;Mixtral 上同样优于均匀分配。

Yifan Yang, Hanling Yi, Dongquan Yang, Feng Lin, Rong Xiao, Aijun Li, Xiaotian Yu
arXiv·2026-10-21·Relevance 4 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
06 4.10

NormTune: Norm-Guided Parameter-Efficient Fine-Tuning for Reasoning-Intensive Tasks

中科院自动化所发现,在推理任务上 LoRA 等参数高效微调的权重更新范数远小于全量微调,并认为这是两者差距的主要原因。NormTune 按每层更新范数自适应放大更新不足的层。用 S1K-1.1 训练时,rank-8 的 LoRA、Bone、MoRA 在 AIME 2024、MATH 500、GPQA、AIME 2025 上平均分别提高 24.24%、11.33%、16.21%;rank-256 的三种方法都达到或略超 S1 全量微调。

Zhangming Li, Qinghao Hu, Weifan Guan, Yifan Zhang, Peisong Wang, Jian Cheng
arXiv·2026-10-21·Relevance 4 · Novelty 3 · Practical 5 · Evidence 4 · Timely 5
07 3.80

FlashNext-RL: A System Optimization Study for Long-Horizon Agentic RL of Qwen3.8-Flash-Next

Snowflake 为 Qwen3.8-Flash-Next 的长程软件工程智能体强化学习专门优化训练系统,基于 prime-rl,用 vLLM 生成轨迹,在单个 8×B200 节点上以 BF16 训练完整 48 层模型(冻结前两层等部分)。优化主机卸载、梯度累积和 MoE、稀疏注意力等内核后,每卡训练吞吐从约 395 提到 4,438 token/s,上下文从 32K 扩到 131K。配合三个推理节点,1,024 条轨迹一批的实际训练每步平均 22.4 分钟。

Zhewei Yao, Yuxiong He
arXiv·2026-10-20·Relevance 3 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
08 3.80

TrainBridge: Agentic NPU Training Optimization Guided by GPU Compilation Evidence

港中深等提出 TrainBridge,用于在昇腾 NPU 上优化训练程序:先从 GPU 编译栈(算子融合等)生成的执行结果中提取优化意图,交给智能体改写 NPU 程序,再根据 NPU 性能剖析反复修改。在覆盖大模型预训练、图像分类、视觉语言训练的四个负载上平均加速 1.7 倍;在 27 个 Modded-NanoGPT 速通记录上平均加速接近 2.0 倍。

Yupeng Chen, Kunxiang Zhao, Xingjian Wang, Yue Zhao, Yijing Wu, Ye Liu, Kai Li, Congliang Chen, Ruoy...
arXiv·2026-10-21·Relevance 3 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
09 3.80

Looped Uniform Diffusion Language Models

MBZUAI 和 Sony 研究均匀扩散语言模型(每个位置可能被替换成任意词、生成中可反复修改)中的"循环":在每个去噪步内重复使用前几层 Transformer,训练目标和采样器不变。在 OpenWebText 和 FineWeb-Edu 上,达到训练约 0.5T token 的非循环模型同等验证 NLL,所需训练算力最多少 2.8 倍和 3.3 倍;相同函数调用次数下生成困惑度最多低 9.8%。训练时多采样较小的循环次数,下游任务上可少用 12% 循环且不掉准确率。

Saiteja Utpala, Chieh-Hsin Lai, Yuki Mitsufuji, Praneeth Vepakomma
HuggingFace·2026-10-21·Relevance 3 · Novelty 4 · Practical 4 · Evidence 4 · Timely 5
10 3.55

Sparsity Should Be ALLOTted by Output: Training-Free Allocation of Block-Sparse Attention for Video Diffusion Transformers

中科院自动化所与可灵提出 ALLOT,为视频扩散 Transformer 的块稀疏注意力决定每个"层 × 去噪步"保留多少块:逐格测量对最终视频误差的影响,再在实测延迟预算下联合求解各格密度,不改原有的选块策略和内核。作者观察到最敏感的层-步组合在不同输入间几乎不变。在相同或更短耗时下,配合 XAttention 优于所有对比的分配策略,HunyuanVideo 上 PSNR 提高 11.8 dB;在 Wan2.1、Wan2.2、HunyuanVideo 的另外四条已发表流水线上,九个设置全部优于或持平默认分配。

Tianze Xia, Xiaoling Zhou, Ruya Lan, Yiqiao Liao, Chengru Song
HuggingFace·2026-10-21·Relevance 3 · Novelty 3 · Practical 4 · Evidence 4 · Timely 5

其他赛道今日

点击切换
Generative
10
生成式推荐 · 篇入选
Personalization
10
个性化推荐 · 篇入选
AI Search
10
AI 搜索 · 篇入选
Agentic
10
智能体搜索 · 篇入选

开源雷达

GitHub / HuggingFace 热门 · 5 个项目
deepseek-ai/DeepSeek-V4.1-Flash支持图文输入与文本生成的DeepSeek模型仓库。近期模型更新已被机构监控捕获,可查看权重与部署元数据。model · ★ 4702 · 2026-09-10 · HuggingFacedeepseek-ai/DeepSeek-V4.1-Flash-1017支持图文输入与文本生成的DeepSeek模型仓库。近期模型更新已被机构监控捕获,可查看权重与部署元数据。model · ★ 2344 · 2026-10-17 · HuggingFaceinternlm/Intern-Decision-4B面向多模态结构化决策的InternLM模型仓库,基于Qwen系列模型适配。近期仓库更新已被机构监控捕获,可关注低延迟决策场景。model · ★ 90 · 2026-09-26 · HuggingFaceinternlm/Intern-Decision-0.8B面向多模态结构化决策的InternLM模型仓库,基于Qwen系列模型适配。近期仓库更新已被机构监控捕获,可关注低延迟决策场景。model · ★ 37 · 2026-09-26 · HuggingFaceinternlm/Intern-Decision-2B面向多模态结构化决策的InternLM模型仓库,基于Qwen系列模型适配。近期仓库更新已被机构监控捕获,可关注低延迟决策场景。model · ★ 18 · 2026-09-26 · HuggingFace