稀疏注意力(例如 DeepSeek-V4.1-Flash、GLM-5 系列使用的按索引选取历史 token 的注意力)让每步解码只读一部分 KV cache,但没被选中的历史以后还可能被选中,所以全部历史仍要保存。长上下文、多请求时,存这些历史的显存决定了能同时解码多少请求。Scitix.AI 的 UlaCache 把所有 GPU 的 KV 池和可选的 CPU 内存编进同一个"逻辑地址空间":推理引擎只拿逻辑地址分配和选取 KV,数据实际放在哪张卡或 CPU 上由 UlaCache 负责搬运和更新映射。这样 GPU 和 CPU 各存不同的历史,而不是 CPU 存全量、GPU 存副本。在 SGLang 中用 GLM-5.3、输入 64K–128K token 的 Multi-LexSum 请求测试,开启投机解码、GPU 和 CPU 内存预算相同时,峰值解码吞吐相对 HiSparse 在 8×H200 上提高 1.16 倍(DP)和 1.70 倍(TP),在 8×B300 上提高 1.73 倍(DP)和 2.51 倍(TP)。
1. 问题:存储空间大多被副本占掉
作者用 GLM-5.3 在 8×B300 上统计了两种现有做法的 KV 分配:
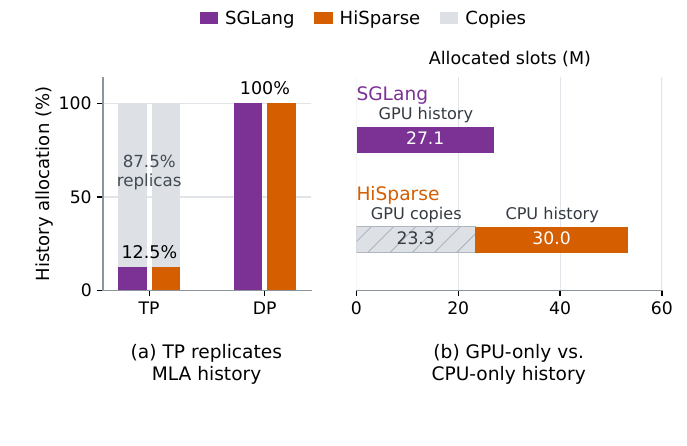
两个来源的重复:
- 跨卡重复。 模型使用 MLA(多头潜在注意力)时,按注意力头切分的 TP 让每张卡都存同一份 KV。8 卡 TP 下只有 12.5% 是不重复的历史。
- GPU 与 CPU 重复。 HiSparse 把完整历史放 CPU,把选中的部分复制到 GPU。它的 5330 万个物理槽只存了 3000 万个不重复的历史位置,GPU 那部分不增加容量。
此外,HiSparse 给每个请求固定大小的 GPU 缓存配额。请求变少时,剩下的请求也用不上空出来的显存。作者给出的例子:8×B300、DP、开投机解码、批大小 1 时,GPU 本来装得下所有历史,HiSparse 的每 token 时延(TPOT)仍比纯 GPU 的 SGLang 高 23.5%。
2. 方法
统一逻辑地址。 每个 KV 条目有一个固定的逻辑地址,映射表记录它当前在哪个 GPU 槽或 CPU 槽。KV 在 GPU 和 CPU 之间移动时,只改映射,不改逻辑地址。
- DP 模式:每张卡管理自己的 GPU 池和 CPU 池,容量是两者之和。
- TP 模式:所有卡的 GPU 池合成一个分布式地址空间,每张卡存每个请求历史的不同部分(逻辑地址 t 放在第 t mod P 张卡上)。负责计算的卡另有一个本地 GPU 缓冲区,缓存最近选中的 KV,下一步再被选中时直接复用,只从本卡或其他卡取缺失的部分。共享同一稀疏选择的层可以在当前层计算时预取后面层需要的 KV。
PB-LRU(并行分桶 LRU)。 开启 CPU 存储后,GPU 池由所有请求共享,需要决定把哪些 KV 换出到 CPU。标准 LRU 每次都要扫描整个池,PB-LRU 把 GPU 槽按最近使用时间分成若干桶,命中检测和更新并行处理,用分层位图快速找到可替换的槽,优先替换最冷的桶,并保护当前注意力计算正要用的条目。数据先搬运,搬完再更新映射,保证后续访问读到的是已就绪的数据。
3. 实验
设置:GLM-5.3,FP8 权重和 KV cache,8×H200 和 8×B300。基线是 GPU 存全部 KV 的 SGLang 和用 CPU 存历史的 HiSparse。投机解码用 MTP,草稿 2 步。三个系统的 GPU 显存分配相同,CPU 预算为每张 H200 128 GB、每张 B300 192 GB。负载是 Multi-LexSum,输入 64K–128K token,每个请求贪心生成 2,048 个 token。
3.1 容量与可同时解码的请求数
这组实验检验统一地址能否在相同内存下装下更多历史、接纳更多请求。
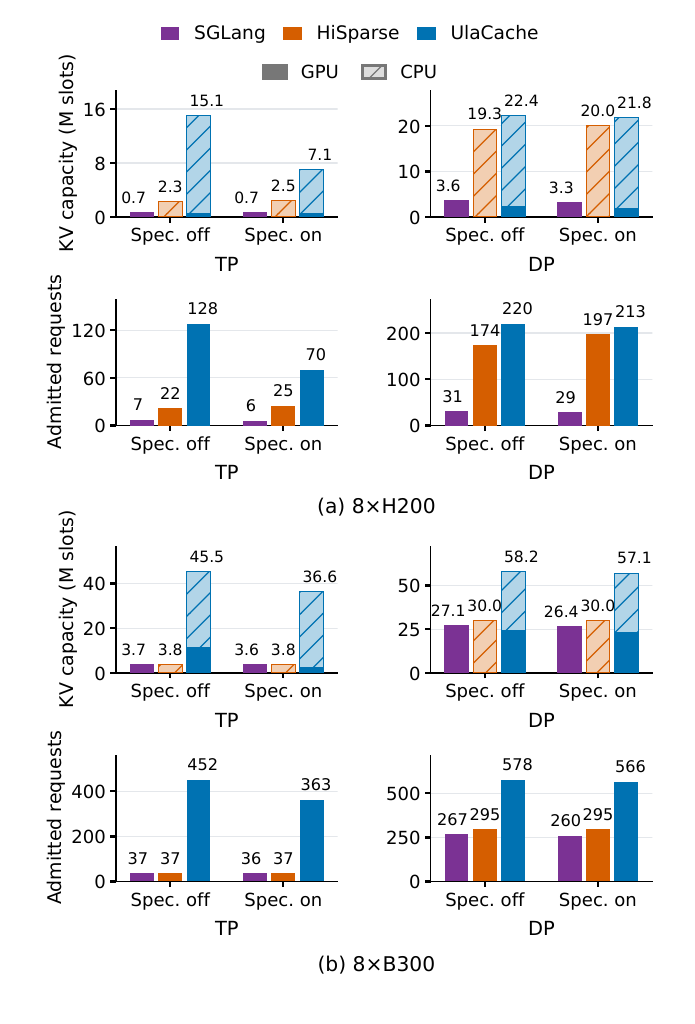
可接纳的请求数:
| 配置 | SGLang | HiSparse | UlaCache |
|---|---|---|---|
| 8×H200 TP,不开投机 | 7 | 22 | 128 |
| 8×H200 TP,开投机 | 6 | 25 | 70 |
| 8×H200 DP,不开投机 | 31 | 174 | 220 |
| 8×H200 DP,开投机 | 29 | 197 | 213 |
| 8×B300 TP,不开投机 | 37 | 37 | 452 |
| 8×B300 TP,开投机 | 36 | 37 | 363 |
| 8×B300 DP,不开投机 | 267 | 295 | 578 |
| 8×B300 DP,开投机 | 260 | 295 | 566 |
TP 模式下差距最大,因为 UlaCache 消除了 MLA 的跨卡重复。DP 模式下 HiSparse 本来就用 CPU 存历史,差距较小。
3.2 吞吐与延迟
这组实验检验容量增加能否变成吞吐提升,以及低负载时多出来的查找和调度是否拖慢单请求。
- 吞吐。 开投机解码时峰值吞吐相对 HiSparse 为 1.16×(H200 DP)、1.70×(H200 TP)、1.73×(B300 DP)、2.51×(B300 TP)。B300 TP 不开投机时,UlaCache 峰值吞吐是 SGLang 的 3.51 倍。峰值对比取各系统在所有批大小中的最高值,提升主要来自能同时解码更多请求。
- 低负载延迟。 批大小 1–8 的八种配置下,UlaCache 的 TPOT 都低于 HiSparse,但高于 SGLang。作者认为差距来自额外的查找、调度和 TP 通信。
3.3 PB-LRU 消融
这组实验检验分桶近似会不会降低缓存命中率,以及能省多少调度时间。设置:8×H200 DP,PB-LRU 和基于时间戳的普通 LRU 回放同一组访问记录,缓存容量相同。
结果:两者 GPU 命中率相差不到 0.10 个百分点;在较大批大小下,PB-LRU 调度快约 1.5–2.3 倍。批大小小、几乎不需要替换时,普通 LRU 反而更快,因为 PB-LRU 仍要维护桶的元数据。
4. 局限
只测了一个模型(GLM-5.3)和一种负载(Multi-LexSum 长文摘要)。吞吐对比取峰值,各系统峰值出现在不同的批大小上,所以数字主要反映"能装下多少请求",不是同一批大小下的单步速度。低并发时比纯 GPU 的 SGLang 慢。论文没有报告精度,因为 UlaCache 不改变注意力本身的选取。
5. 实践意义
如果你在 SGLang 上服务使用 MLA 和稀疏注意力的模型(GLM-5、DeepSeek-V4.1 一类)、请求上下文很长、瓶颈是显存装不下更多并发请求,尤其是用 TP 部署时,UlaCache 的思路值得关注:先消除跨卡和 GPU/CPU 之间的重复存储,再谈换入换出。若主要场景是低并发、对单请求延迟敏感,纯 GPU 的 SGLang 仍更快。