NVIDIA 从 Ampere 起的 GPU 都支持 2:4 稀疏:矩阵乘法里一个操作数沿累加方向每 4 个元素只保留 2 个非零值,张量核心按标称可以快一倍。它可以和量化叠加,于是部署时的实际问题是:在当前精度上,下一步是加 2:4,还是降到更低一档精度?这篇独立研究者的论文在 Llama-3.1-8B-Instruct 和 Qwen3-8B 上,按"相同存储位数(把稀疏的位置索引也算进去)"和"相同标称算力档位"两种口径,对一层 transformer 里全部六类矩阵乘法操作数做了比较,并在 L40S、H100、RTX PRO 6000 三代 GPU 上实测速度。结论是:只要还有更低一档精度可用,加 2:4 既更不准也更慢;到了硬件支持的最低精度(Ada/Hopper 上是 FP8)之后,2:4 才有价值,H100 上用 vLLM 服务的 2:4 + FP8 模型 prefill 吞吐比稠密 FP8 高 27%,GSM8K 准确率相当,但前提是要重新训练。
1. 问题:vLLM 已经删掉了 2:4 支持,它还值得用吗
一边是 NVIDIA 每一代 GPU 都保留稀疏张量核心,Blackwell 还加了稀疏 FP4;另一边,2026 年 vLLM 和 LLM Compressor 因为用户太少删除了 2:4 支持。已有的剪枝与量化对比大多按"名义压缩率"比较、主要看权重,没有把"加 2:4"和"降一档精度"在真实硬件上直接对比。
作者指出四个容易被忽略的点:
- 2:4 每个保留值旁边都要存位置索引,所以占用的位数比一半多;
- 两者都号称让吞吐翻倍,但数据手册不说实际能快多少;
- 推理时大多数操作数(激活、Q、K、V、注意力概率)是现算出来的,每次矩阵乘法前都要现场剪枝压缩,这部分时间只测矩阵乘法时看不到;
- 硬件规定了哪个操作数能稀疏、沿哪个方向分组,所以按整个张量统计的指标(如峰度)反映不出 2:4 实际删掉了什么。
2. 方法:在相同成本下比
2.1 相同位数
每种格式按每个原始元素实际存了多少位计费:值、索引、缩放因子都算。稠密 INTk 每 128 个元素一个 FP16 缩放因子,每元素 k + 0.125 位;2:4 只保留一半元素,但每个原始元素要多 1 位索引。结果是 2:4 + INT8 的成本等于稠密 INT5,2:4 + INT4 等于 INT3,2:4 + FP16 比 FP8 还贵。
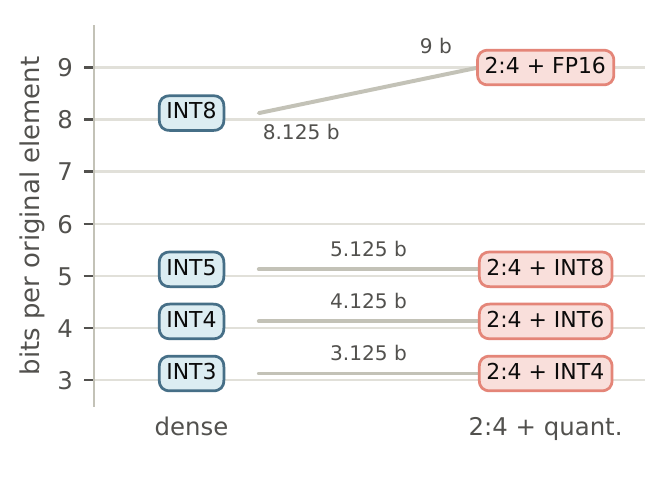
所以在相同存储下,真正的选择是"丢掉一半元素、剩下的用两倍精度存",还是"保留全部元素、每个多 1 位"。
2.2 相同算力档位
按数据手册的标称吞吐配对:2 倍档是 2:4 + FP16 对稠密 FP8/INT8;4 倍档是 2:4 + FP8 对稠密 4 位浮点(只有 Blackwell 有)。
2.3 怎么测
精度指标是算子级相对误差(和 FP32 参考输出比),用比值 R =(最好的 2:4 配置误差)/(最好的量化配置误差),R < 1 表示 2:4 更好。双方各自从同等努力程度的方法里挑最好的:2:4 一侧试幅值剪枝、Wanda、SparseGPT 等,量化一侧试四舍五入、GPTQ、AWQ,都用 C4 校准。速度用 cuSPARSELt 稀疏矩阵乘法,现算的操作数两边都要计入在线剪枝或在线量化的时间。总共超过 22 万个测量配置。
3. 实验
3.1 在最低精度之上:降一档精度总是更好
这组实验检验,在还能降精度时,加 2:4 是否有机会更准或更快。
精度。 相同位数下,2:4 在每个存储预算、两个模型上都输:8 位时误差差一个数量级以上,随位数降低差距缩小但不消失,在 3.1 位预算下,两者最接近的一组对比(Llama 的 K 对 INT3)R 仍略高于 1。2 倍档里,2:4 + FP16 的误差是稠密 FP8 的 5 到 16 倍,所有操作数都如此。
速度。 下表是"对手耗时 / 2:4 耗时",大于 1 表示 2:4 更快(Llama-3.1-8B 投影层,2K–16K token 的中位数):
| GPU | 2 倍档 W | 2 倍档 X | 4 倍档 W | 4 倍档 X | 在 FP8 上加 2:4 | 在 NVFP4 上加 2:4 |
|---|---|---|---|---|---|---|
| L40S | 0.89 | 0.89 | – | – | 1.65 | – |
| H100 | 0.74 | 0.80 | – | – | 1.42 | – |
| RTX PRO 6000 | 0.84 | 0.85 | 0.66 | 0.70 | 1.33 | 1.40 |
W 为稀疏权重,X 为稀疏激活(含在线预处理)。在同一档位上,2:4 一侧都更慢。作者对原因的解释是:2:4 每 4 个元素丢掉的那 2 个值所占的能量(平方和),不管给剩下的值多少位都补不回来;而量化误差每多 1 位就减半。高斯数据上,逐元素 2:4 会去掉 13.2% 的能量。
3.2 在最低精度上:2:4 真能提速,但要重训
这组实验检验到了 FP8 或 NVFP4 这一底线后,2:4 能带来多少收益、代价是什么。线性层权重做 2:4,注意力保持 BF16,模型是 Llama-3.1-8B 基座。
vLLM 端到端(单张 H100),2:4 模型用 Sparse-Llama(在 13B token 上重训过的 2:4 Llama):
| 配置 | 权重显存 (GiB) | prefill (k tok/s) | decode b=1 (tok/s) | decode b=64 (tok/s) | GSM8K |
|---|---|---|---|---|---|
| 稠密 BF16 | 15.0 | 41.4 | 136 | 6,424 | 0.596 |
| 2:4 BF16 | 9.3 | 40.7 | 115 | 6,477 | 0.624 |
| 稠密 FP8 | 8.5 | 58.9 | 198 | 8,556 | 0.568 |
| 2:4 FP8 | 6.1 | 74.6 | 234 | 9,914 | 0.612 |
2:4 + FP8 在 prefill 和 decode 上都快于稠密 FP8,GSM8K 差异不显著。同样的权重若用稠密内核服务,加速消失,说明收益来自稀疏内核。BF16 下 vLLM 的 2:4 路径并不比稠密快。
重训的代价。 一次性剪枝在每个底线上都不可用。下表是 WikiText-2 困惑度 / GSM8K 准确率(250 题):
| 底线 | 稠密 | 一次性 2:4 | 重训 2:4(13B token) | 作者重训(1B token) |
|---|---|---|---|---|
| BF16 | 6.31 / 0.600 | – | 8.13 / 0.612 | 8.19 / 0.300 |
| INT4 权重 | 6.90 / 0.540 | 18.61 / 0.032 | 8.45 / 0.580 | 8.53 / 0.292 |
| FP8 | 6.36 / 0.552 | 17.82 / 0.028 | 8.19 / 0.632 | 8.25 / 0.308 |
| NVFP4,成对 4:8 | 6.98 / 0.460 | 108.83 / 0.020 | – | 10.22 / 0.132 |
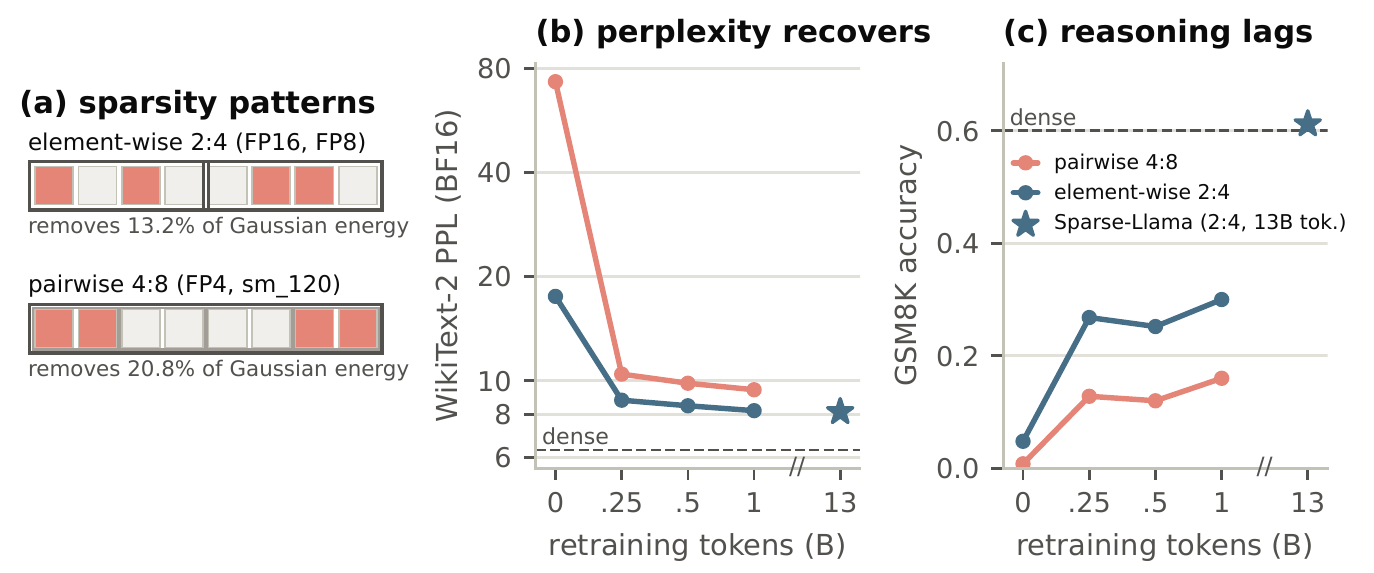
作者用 FineWeb-Edu 的 1B token 从稠密模型蒸馏重训:困惑度已接近 Sparse-Llama,GSM8K 却只有它的一半左右。困惑度会高估重训的恢复程度,判断重训是否完成需要看推理任务。
3.3 Blackwell 的稀疏 FP4
Blackwell 的稀疏 FP4 不是逐元素 2:4,而是每 8 个元素中保留 4 对相邻元素里的 2 对。内核比稠密 NVFP4 快 1.4 倍,但在高斯数据上去掉 20.8% 的能量;一次性剪枝后困惑度 108.83,是逐元素 2:4 的五倍;为逐元素 2:4 重训过的 Sparse-Llama 也不能直接转换。在作者 1B token 的重训预算内,GSM8K 只恢复到 0.132。
4. 局限
模型只有两个 8B 模型;Blackwell 上的 4:8 结论受限于 1B token、一套未调参的重训配方,更长的重训能否恢复没有验证。4 位整数权重底线(主要用于 decode)没有测速度,因为 vLLM 已删除相应稀疏内核。实际部署常在低比特量化前加 Hadamard 旋转,作者指出这会让大多数操作数上 2:4 的劣势更大,因此本文未旋转的结果对 2:4 偏乐观。
5. 实践意义
如果硬件还支持更低一档精度(例如 H100 从 BF16 到 FP8),先降精度,不要加 2:4。已经用 FP8 部署、prefill 吞吐是瓶颈、并且能拿到充分重训过的 2:4 模型时,2:4 可以带来实际提速,但 vLLM 主线已删除支持,需要自己维护。评估重训后的稀疏模型,不要只看困惑度。